
Zenodo API danh mục dataset: manifest version DOI và checksum
Zenodo API danh mục dataset là cách đọc metadata của các record trên Zenodo trước khi tải một byte dữ liệu thật. Đọc xong, mình biết đang dùng phiên bản nào, giấy phép gì, tệp nào và checksum ra sao. Bài này viết cho người gom dataset nghiên cứu vào pipeline, hay nhầm giữa DOI của cả chuỗi phiên bản với DOI của một bản cụ thể. ProxyVN gọi API công khai của Zenodo ngày 05/11/2026 ở mức nhẹ, dựng một manifest hai phiên bản và chỉ tải đúng một tệp 139 KB để đối chiếu checksum.
Zenodo API danh mục dataset: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và ranh giới với các bài gần chủ đề trên blog.
Bài toán cần giải
Một nhóm phân tích cần dùng lại dữ liệu đã công bố trên Zenodo. Ai đó dán link record vào tài liệu dự án, ai đó khác lại dán DOI. Ba tháng sau tác giả ra bản mới, link cũ vẫn mở được nhưng trỏ tới bản khác. Không ai nói được báo cáo đã chạy trên phiên bản nào, tệp nào, và tệp đó có bị sửa không.
Đầu ra nghiệm thu
Đầu ra là một manifest dạng CSV. Mỗi dòng là một tệp của một phiên bản, gồm record ID, version DOI, concept DOI, nhãn phiên bản, ngày công bố, license, quyền truy cập, tên tệp, kích thước, checksum và cột điều kiện tải. Cột cuối cho biết tệp được phép tải tự động hay cần người duyệt.
Ranh giới với bài DOI và bài CKAN
Bài Crossref API bằng Python tra metadata của một DOI bài báo. Bài CKAN API bằng Python lấy catalog dataset của cổng dữ liệu mở dùng CKAN. Bài này chỉ nói về mô hình phiên bản của Zenodo, nơi một dataset có một concept DOI và nhiều version DOI, cùng metadata tệp mà Zenodo trả về.
Giới hạn của lab
Lab gọi API thật nhưng chỉ đọc. Không có tài khoản, không tạo deposit, không dùng token. Record chọn làm mẫu là một dataset công khai có hai phiên bản, tìm được bằng truy vấn tìm kiếm thường. Kết quả có thể đổi khi tác giả ra bản mới hoặc Zenodo nâng cấp phần mềm.
Ai nên đọc
Người quản lý dữ liệu cho nhóm nghiên cứu nhỏ. Kỹ sư dữ liệu cần ghi xuất xứ cho từng tệp đầu vào. Người viết crawler thu thập danh mục dataset, cần biết khi nào được tải tệp thật và khi nào chỉ nên dừng ở metadata.
Vì sao nên dừng ở metadata trước
Tệp dữ liệu trên Zenodo có thể nặng hàng chục GB. Tải hết chỉ để xem bên trong có gì là cách tốn băng thông nhất, và làm tăng tải cho một dịch vụ phi lợi nhuận. Metadata đã cho biết kích thước, định dạng, license và checksum. Phần lớn quyết định có tải hay không đều làm được từ đó, chỉ tốn vài KB JSON cho mỗi record.
Những gì bài không làm
Bài không hướng dẫn tải lên dataset, không nói về OAI-PMH hay cách đăng ký community. Bài cũng không so sánh Zenodo với Figshare, Dryad hay các kho khác. Phạm vi chỉ là đọc metadata công khai đủ để quyết định tải hay không, và giữ bằng chứng cho quyết định đó.
Thuật ngữ dùng trong bài
Record là một mục trên Zenodo, có số ID riêng. Version DOI là DOI gắn với record đó. Concept là nhóm các record cùng một dataset qua nhiều lần cập nhật, có concept ID và concept DOI. File là tệp đính kèm record. Bài giữ nguyên tên trường tiếng Anh như trong JSON để dễ đối chiếu với code.
Thu metadata record Zenodo và phân biệt concept DOI/version DOI với Zenodo API danh mục dataset
Phần này đi qua các lời gọi API đã chạy và những gì response trả về.
Endpoint đã dùng
Tài liệu Zenodo cho nhà phát triển mô tả REST API dưới đường dẫn /api. Lab dùng bốn endpoint đọc: tìm kiếm /api/records, chi tiết /api/records/{id}, danh sách phiên bản /api/records/{id}/versions và danh sách tệp /api/records/{id}/files. Tất cả đều trả JSON, không cần token với record công khai.
Truy vấn tìm kiếm đầu tiên
Lab tìm với q là "air quality Vietnam", type là dataset, size 5, sắp xếp mới nhất. API trả HTTP 200, tổng 33053 kết quả. Con số này lớn vì tìm kiếm toàn văn khớp rộng, nhiều record không liên quan Việt Nam. Danh mục thật nên lọc thêm bằng từ khóa chặt hơn hoặc theo community.
Rate limit nhìn thấy trong header
Mỗi response có X-RateLimit-Limit và X-RateLimit-Remaining. Endpoint tìm kiếm báo giới hạn 30, còn endpoint chi tiết record báo 133. Hai con số khác nhau cho thấy Zenodo đặt hạn mức riêng cho từng nhóm endpoint. Lab nghỉ 2,5 giây giữa các lời gọi nên không chạm ngưỡng.
Trường ID trong một hit
Mỗi hit có id, recid, conceptrecid, doi, conceptdoi và doi_url. Record mẫu mới nhất có id 23973301, doi 10.5281/zenodo.23973301, conceptrecid 23552334, conceptdoi 10.5281/zenodo.23552334. Hai cặp số này là chìa khóa cho toàn bộ bài.
Ví dụ request bằng Python
Đoạn dưới là phần lõi đã chạy, chỉ giữ những dòng cần đọc.
import requests, time
UA = {"User-Agent": "ProxyVN-docs-lab/1.0 (+https://proxy.vn/; low-volume documentation test)"}
s = requests.Session(); s.headers.update(UA)

def get(url, **kw):
    r = s.get(url, timeout=(10, 60), **kw)
    time.sleep(2.5)
    return r

r = get("https://zenodo.org/api/records",
        params={"q": "air quality Vietnam", "type": "dataset", "size": 5, "sort": "mostrecent"})
for h in r.json()["hits"]["hits"]:
    print(h["id"], h["doi"], h["conceptdoi"], h["metadata"].get("version"))
Kết quả tìm kiếm cho thấy gì
Năm hit đầu đều có license cc-by-4.0 và access_right là open. Chỉ một hit có nhãn version 0.1.2, bốn hit còn lại để trống trường này. Số tệp mỗi record dao động từ 1 tới 10. Những con số này cho thấy không nên đoán trước cấu trúc metadata, phải đọc từng record.
Phân trang của tìm kiếm
Object links trong kết quả có self và next. Lấy danh mục dài thì đi theo next thay vì tự tăng số trang. Với hạn mức 30 lần cho tìm kiếm, mỗi trang nên lấy size lớn hơn mức mẫu 5, ví dụ 25 hoặc 50, để giảm số lời gọi.
Đặt User-Agent rõ ràng
Zenodo không bắt buộc một định dạng User-Agent riêng, nhưng một tên client có đường dẫn liên hệ giúp phía vận hành nhận ra traffic. Lab dùng tên chung của dự án tài liệu, không dùng địa chỉ email cá nhân. Đừng giả User-Agent trình duyệt để lách giới hạn.
Phân biệt record ID, version DOI và concept DOI trong Zenodo API danh mục dataset
Đây là chỗ hay nhầm nhất, nên lab kiểm từng đường đi.
Concept DOI đại diện cho cả chuỗi
Concept DOI trỏ tới dataset như một thực thể có nhiều phiên bản. Ai trích concept DOI là đang nói "dataset này nói chung", và link sẽ luôn đưa về bản mới nhất. Trong lab, conceptdoi 10.5281/zenodo.23552334 gom hai bản: 23552335 và 23973301.
Version DOI đại diện cho một bản cố định
Version DOI gắn với đúng một phiên bản. Bản 1.1 có DOI 10.5281/zenodo.23552335, công bố 22/10/2026. Bản mới có DOI 10.5281/zenodo.23973301, công bố 05/11/2026. Phân tích cần tái lập được thì phải ghi version DOI, không ghi concept DOI.
Concept record ID chuyển hướng tới bản mới
Gọi /api/records/23552334 với allow_redirects bằng False, API trả 302 và Location là /api/records/23973301. Nghĩa là concept ID không phải một record có tệp riêng. Nó chỉ là con trỏ tới bản mới nhất tại thời điểm gọi.
Đi theo chuyển hướng không ổn định
Lần đầu cho requests tự đi theo chuyển hướng đó, lời gọi treo tới khi hết thời gian đọc 30 giây. Lần chạy lại, cùng URL trả HTTP 500. Trong khi đó gọi thẳng /api/records/23973301 trả 200 ngay. Lab không kết luận nguyên nhân phía Zenodo, chỉ ghi hành vi quan sát được trong ngày.
Cách lấy bản mới nhất an toàn hơn
Record chi tiết có links.latest là /api/records/23973301/versions/latest. Gọi đường này trả 301 về đúng record mới nhất. Cách ổn hơn là gọi /versions rồi tự chọn theo ngày công bố, vì khi đó mình có trong tay danh sách đầy đủ và biết vì sao chọn bản đó.
Vì sao điều này quan trọng với pipeline
Pipeline chạy hôm nay với concept ID sẽ lấy bản 23973301. Pipeline chạy lại sau khi tác giả ra bản thứ ba sẽ lấy bản khác, dù code không đổi một dòng. Kết quả phân tích lệch mà không ai sửa gì. Ghi record ID cụ thể vào cấu hình là cách chặn lệch này.
DOI resolver cũng tách hai loại
HEAD tới doi.org cho concept DOI trả 302 về zenodo.org/doi/10.5281/zenodo.23552334. HEAD cho version DOI trả 302 về zenodo.org/doi/10.5281/zenodo.23973301. Hai đường khác nhau từ tầng DOI, nên ghi nhầm loại DOI sẽ dẫn người đọc tới trang khác.
Endpoint versions trả gì
Gọi /api/records/23973301/versions với size 20 trả total 2, gồm cả 23973301 và 23552335. Mỗi phần tử là một record đầy đủ, có doi, conceptdoi, metadata và files. Lab không thấy trường versions.is_latest hay versions.index trong JSON trả về, nên tự xác định bản mới nhất bằng publication_date.
Tìm kiếm mặc định chỉ trả bản mới nhất
Truy vấn q là conceptrecid:23552334 không kèm tham số khác trả total 1, chỉ có 23973301. Thêm allversions bằng true thì total lên 2, có cả bản 1.1. Ai dựng danh mục từ tìm kiếm mà quên tham số này sẽ không thấy các bản cũ.
Lấy metadata tệp, license và checksum của record bằng Zenodo API danh mục dataset
Phần này đọc mảng files và các trường quyền của từng phiên bản.
Mảng files trong record
Mảng files của record
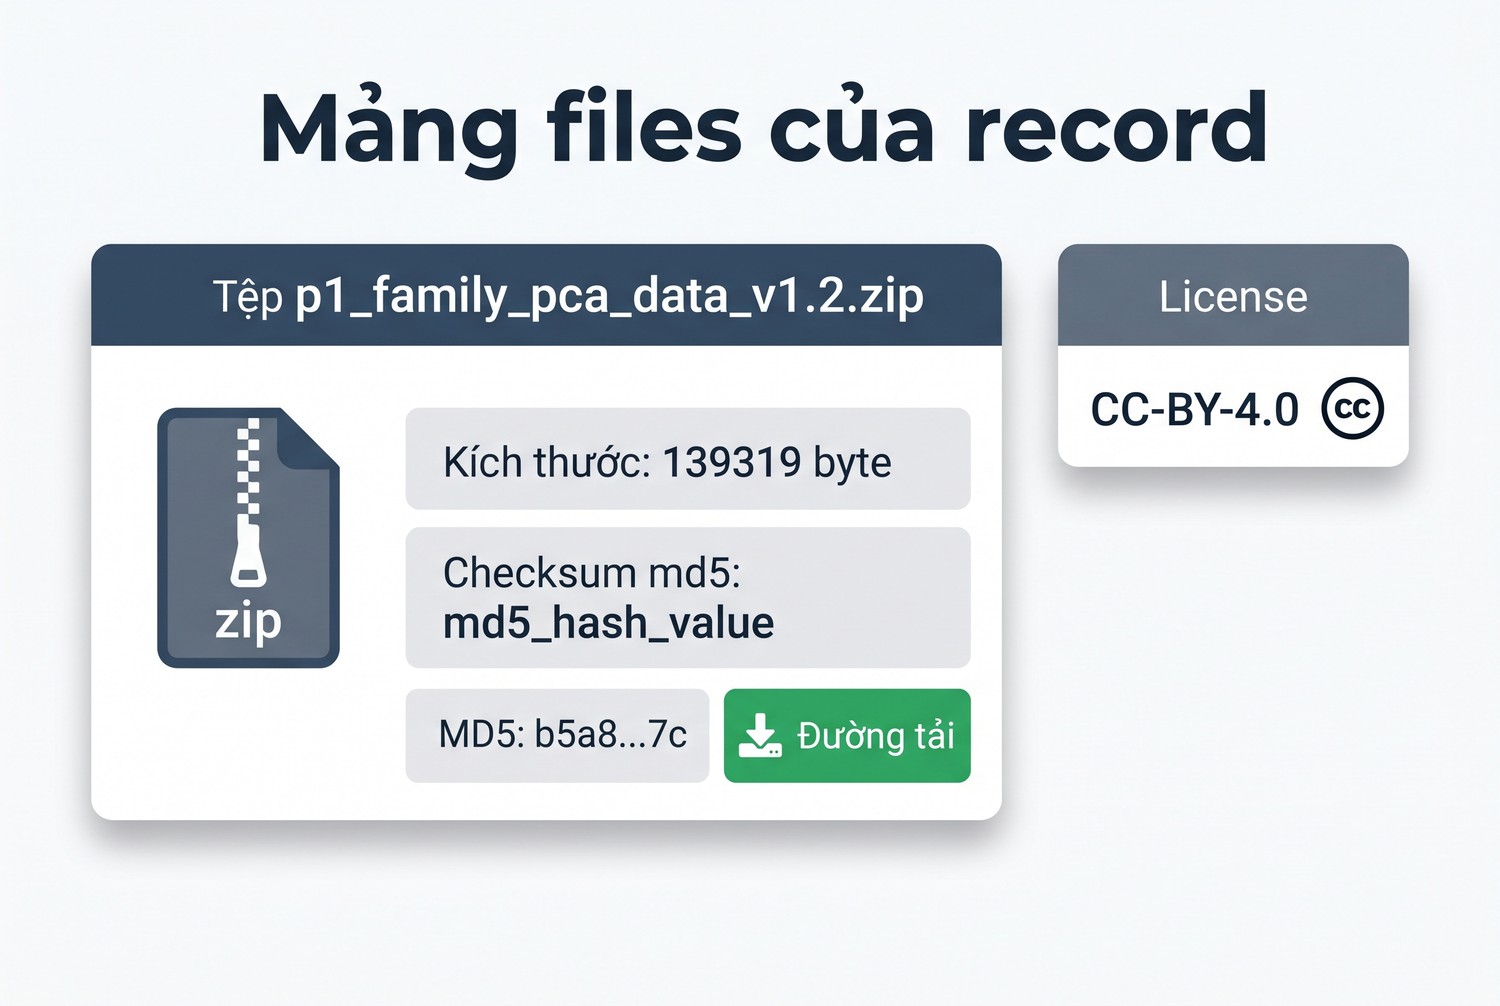
Record chi tiết có mảng files. Mỗi phần tử gồm id, key là tên tệp, size tính bằng byte, checksum dạng "md5:..." và links.self tới đường tải nội dung. Bản mới có một tệp p1_family_pca_data_v1.2.zip, 139319 byte, checksum md5:565f0c7fcd5a5c6bad74acc7d87b272e.
Endpoint files riêng
Gọi /api/records/23973301/files trả object có enabled, links, entries, default_preview và order. Dữ liệu tệp nằm trong entries. Hai nguồn này cho cùng thông tin với record công khai, nhưng endpoint riêng tiện khi chỉ cần danh sách tệp mà không muốn kéo cả mô tả dài.
License nằm trong metadata
Trường metadata.license trả object có id, ví dụ cc-by-4.0. Cả hai phiên bản trong lab đều là cc-by-4.0. License là thuộc tính của từng phiên bản, nên vẫn phải đọc lại ở mỗi bản, đừng giả định bản mới giữ license của bản cũ.
Access right và record bị hạn chế
Trường metadata.access_right của hai bản mẫu là open. Lab tìm thêm hai record restricted và hai record embargoed. Cả bốn đều có mảng files rỗng trong kết quả tìm kiếm, và gọi /files trả 403 với thông điệp Permission denied. Hai record embargoed có embargo_date là 2029-12-31 và 2027-04-01.
Nhãn version có thể vắng
Bản 1.1 có metadata.version là "1.1". Bản mới lại không có trường version, dù phần mô tả viết rõ "v1.2". Đừng dựng manifest dựa vào nhãn version. Khóa chính phải là record ID và version DOI, nhãn chỉ để người đọc dễ nhìn.
Mô tả nói dữ liệu không đổi nhưng checksum đổi
Mô tả bản mới ghi tệp dữ liệu giống từng byte với v1.1. Nhưng tệp zip của hai bản có tên khác, kích thước 139319 và 138798 byte, checksum khác nhau. Có thể README trong gói đã sửa. Với pipeline, hai tệp khác checksum là hai đầu vào khác nhau, dù tác giả nói gì trong mô tả.
Ngày tạo, ngày sửa và revision
Record mới có created và modified cùng ngày 05/11/2026, revision là 4, status published. Revision tăng khi metadata của chính record được sửa, không phải khi có phiên bản mới. Ghi trường updated vào manifest giúp phát hiện metadata bị sửa sau khi mình đã đọc.
Mô tả là HTML
Trường metadata.description chứa HTML với thẻ p và br. Nếu đưa mô tả vào danh mục cho người đọc, nên làm sạch HTML. Không nên lấy thông tin quan trọng như phiên bản hay license từ mô tả, vì đó là văn bản tự do của tác giả.
Creators và affiliation
Mảng creators có name, affiliation và có thể có orcid. Manifest không cần các trường này để quyết định tải, nhưng phần trích dẫn trong báo cáo thì cần. Lưu chúng trong JSON gốc là đủ, không nhất thiết đưa vào CSV.
Bảng trường cần giữ
Bảng dưới gom các trường lab đọc và lý do giữ.
Trường |
Nguồn trong JSON |
Lý do giữ |
|---|---|---|
record_id |
id |
Khóa gọi lại API đúng bản |
version_doi |
doi |
Trích dẫn cố định cho một bản |
concept_doi |
conceptdoi |
Gom các bản cùng dataset |
version |
metadata.version |
Nhãn cho người đọc, có thể vắng |
license |
metadata.license.id |
Quyết định được dùng tới đâu |
access_right |
metadata.access_right |
Biết có tải được không |
file_key, size |
files[].key, size |
Ước lượng dung lượng |
checksum |
files[].checksum |
Kiểm tệp sau khi tải |
Tạo manifest phiên bản dữ liệu dự định dùng với Zenodo API danh mục dataset
Manifest là tài sản chính của bài, nên phần này đi kỹ quy tắc dựng.
Một dòng cho mỗi tệp của mỗi phiên bản
Manifest không gộp theo dataset. Mỗi dòng là cặp phiên bản và tệp. Dataset có ba phiên bản, mỗi bản bốn tệp thì manifest có mười hai dòng. Cách này cho phép so cùng tên tệp qua các bản và thấy ngay tệp nào đổi checksum.
Mã dựng manifest
Đoạn dưới là phần dựng manifest đã chạy trong lab.
LIMIT = 5_000_000
OK_LICENSE = {"cc-by-4.0", "cc0-1.0", "cc-by-sa-4.0"}
rows = []
for rec in (latest, old):
    m = rec["metadata"]
    lic = (m.get("license") or {}).get("id")
    for f in rec["files"]:
        algo, val = f["checksum"].split(":", 1)
        cond = []
        if m.get("access_right") != "open": cond.append("access_khong_open")
        if lic not in OK_LICENSE: cond.append("license_can_duyet")
        if f["size"] > LIMIT: cond.append("vuot_tran_kich_thuoc")
        rows.append({"record_id": rec["id"], "version_doi": rec["doi"],
                     "concept_doi": rec["conceptdoi"], "version": m.get("version") or "",
                     "publication_date": m.get("publication_date"), "license": lic,
                     "access_right": m.get("access_right"), "file_key": f["key"],
                     "size": f["size"], "checksum_algo": algo, "checksum": val,
                     "download_url": f["links"]["self"],
                     "dieu_kien_tai": "duoc_tai" if not cond else ";".join(cond)})
Kết quả manifest của lab
Manifest hai phiên bản
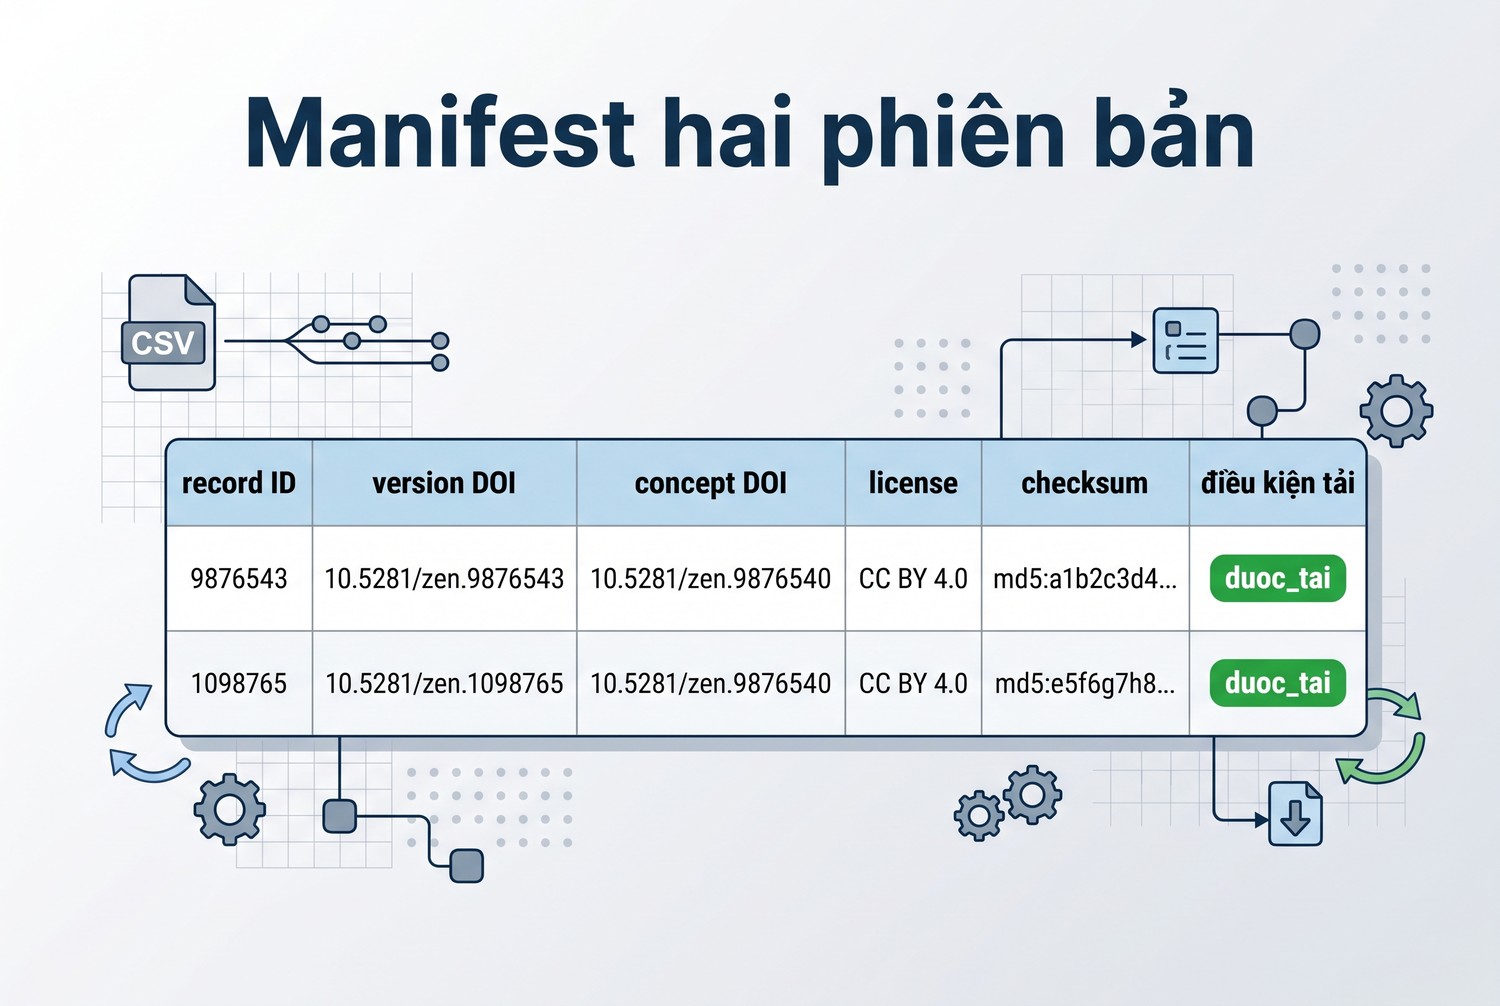
Manifest có hai dòng. Dòng một là record 23973301, version để trống, công bố 05/11/2026, cc-by-4.0, open, tệp v1.2.zip 139319 byte, md5 565f0c7f..., điều kiện duoc_tai. Dòng hai là record 23552335, version 1.1, công bố 22/10/2026, cùng license, tệp v1.1.zip 138798 byte, md5 91810c8c..., cũng duoc_tai.
Tách thuật toán và giá trị checksum
Checksum trả về dạng "md5:giá_trị". Lab tách thành hai cột checksum_algo và checksum. Nếu sau này Zenodo trả thuật toán khác, cột algo cho biết phải dùng hàm băm nào, thay vì mặc định MD5 và báo lệch sai.
Trần kích thước là quyết định của dự án
Lab đặt trần 5 MB cho tải tự động. Con số này không đến từ Zenodo. Mỗi dự án tự chọn theo băng thông, ổ đĩa và mức cần thiết. Tệp vượt trần vẫn nằm trong manifest, chỉ là cột điều kiện ghi vuot_tran_kich_thuoc để người duyệt quyết.
Danh sách license được phép
Tập license tự động duyệt trong lab gồm cc-by-4.0, cc0-1.0 và cc-by-sa-4.0. Đây là ví dụ, không phải tư vấn pháp lý. License có điều kiện phi thương mại hay không phái sinh nên đi qua người hiểu mục đích sử dụng của dự án trước khi tải.
Thêm cột cho người duyệt
Manifest có thể thêm cột nguoi_duyet và ngay_duyet cho các dòng cần duyệt. Khi license là cc-by-nc hoặc tệp lớn hơn trần, người phụ trách ghi quyết định vào đó. Lần quét sau, dòng đã duyệt không bị hỏi lại.
Kiểm trùng trước khi ghi
Trước khi ghi manifest, gom theo cặp record_id và file_key. Nếu có hai dòng trùng cặp, nghĩa là vòng lặp đọc cùng record hai lần, thường do vừa đọc từ tìm kiếm vừa đọc từ versions. Lab không gặp trùng vì chỉ đọc hai record chi tiết.
Ghi ngày gọi API vào manifest
Concept DOI trỏ tới bản mới nhất tại thời điểm gọi. Thêm một cột ngày gọi, hoặc ghi ngày vào tên tệp manifest, giúp giải thích vì sao bản "mới nhất" hôm nay khác với bản trong báo cáo cũ.
Đối soát link download và quyền trước khi tải tệp thật trong Zenodo API danh mục dataset
Phần này kiểm đường tải mà chưa tải, rồi tải đúng một tệp nhỏ để đóng vòng kiểm.
HEAD trước khi GET
HEAD trước khi tải
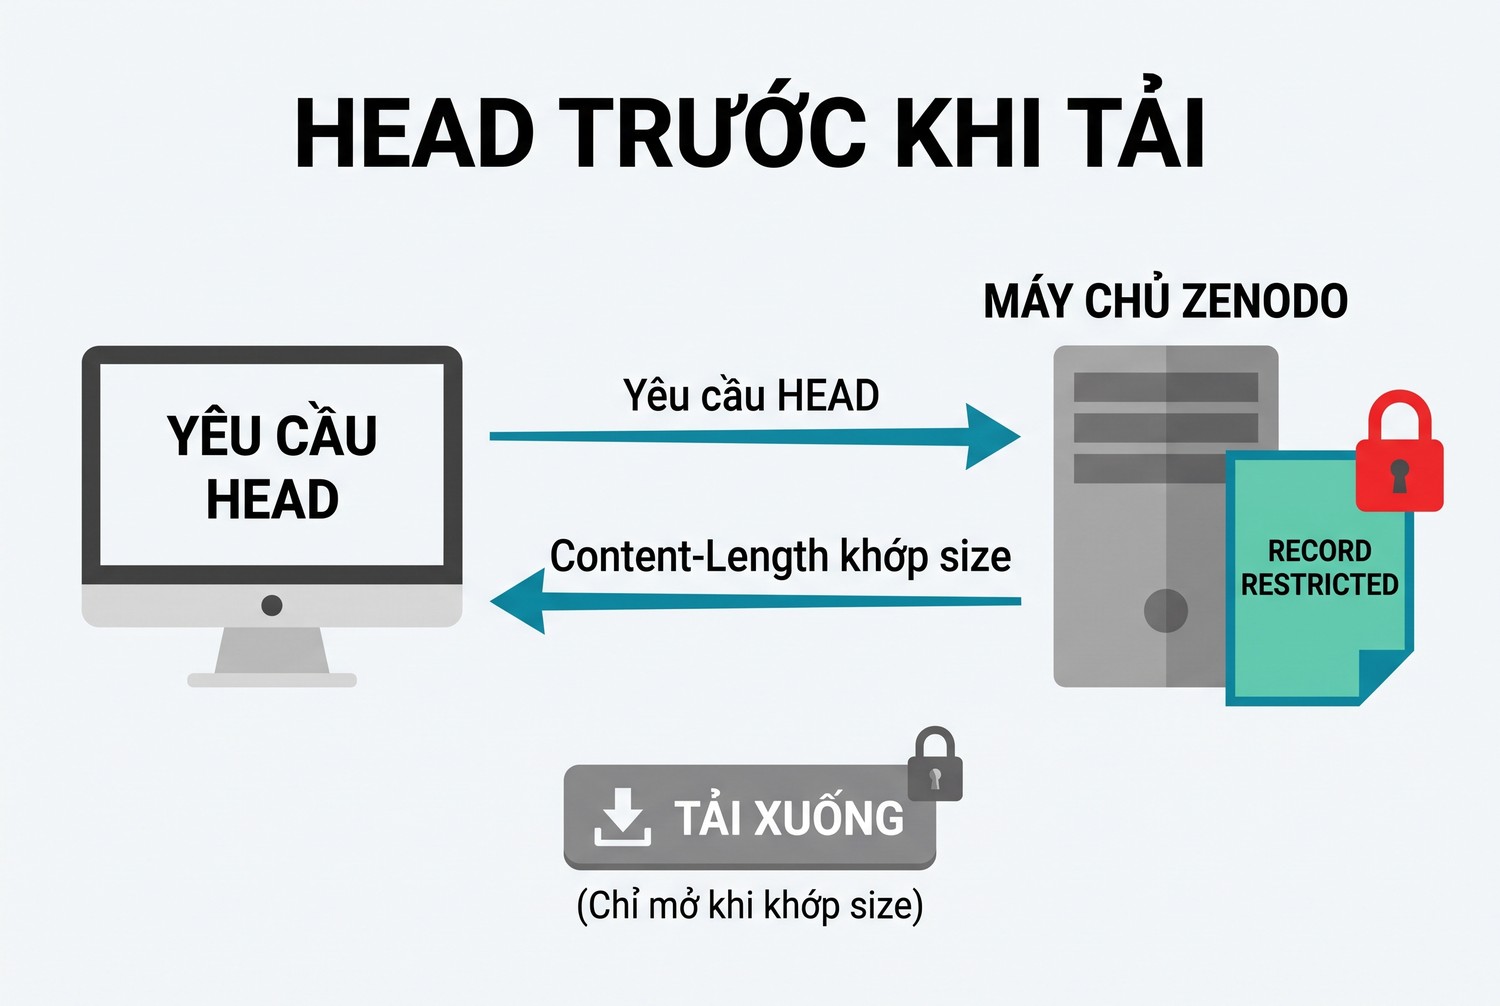
Lab gửi HEAD tới links.self của tệp ở cả hai bản. Cả hai trả 200, Content-Type application/octet-stream, Content-Length lần lượt 139319 và 138798, khớp với size trong metadata. Không có chuyển hướng. HEAD xác nhận đường tải còn sống mà không tốn băng thông.
Khi Content-Length lệch size
Lab không gặp ca lệch. Nếu Content-Length khác size trong metadata, nên dừng tải và ghi cảnh báo. Có thể tệp đã bị thay, có thể một proxy trung gian chèn trang lỗi. Tải tiếp rồi mới phát hiện checksum lệch là phí công.
Tải một tệp và kiểm MD5
Bản mới nằm dưới trần, license nằm trong tập cho phép, nên lab tải tệp v1.2.zip. Nhận về 139319 byte, MD5 tính lại là 565f0c7fcd5a5c6bad74acc7d87b272e, khớp với metadata. Đây là tệp duy nhất lab tải trong cả bài.
Mã kiểm checksum
import hashlib
f = latest["files"][0]
r = get(f["links"]["self"])
md5 = hashlib.md5(r.content).hexdigest()
print(len(r.content), md5, "khop" if "md5:" + md5 == f["checksum"] else "LECH")
Tệp lớn thì băm theo khối
Với tệp vài GB, đừng đọc r.content vào bộ nhớ. Dùng stream bằng True, đọc từng khối 1 MB, cập nhật hàm băm và ghi ra đĩa cùng lúc. Lab không chạy nhánh này vì tệp mẫu nhỏ.
Record bị hạn chế thì dừng ở metadata
Bốn record restricted và embargoed trả 403 ở /files. Pipeline không nên thử lại với IP khác hay User-Agent khác. 403 ở đây là quyết định quyền truy cập của chủ dữ liệu, không phải lỗi mạng. Ghi dòng manifest với điều kiện access_khong_open và để đó.
Ghi bằng chứng tải
Sau khi tải, lab ghi tên tệp, số byte và MD5 vào downloaded_check.txt. Tệp này cùng manifest cho thấy tệp trên đĩa đúng là tệp Zenodo công bố. Khi ai đó hỏi dữ liệu lấy từ đâu, câu trả lời có sẵn kèm số liệu.
Không tải lại tệp đã có
Trước khi tải, so checksum trong manifest với tệp đã có trên đĩa. Khớp thì bỏ qua. Cách này quan trọng khi một concept có nhiều bản giữ nguyên vài tệp lớn. Chỉ tệp đổi checksum mới cần tải lại.
Khi nào proxy có ích
Proxy chỉ đáng dùng ở tầng tải khi mạng nội bộ chặn hoặc đi quốc tế chập chờn. Proxy không cấp quyền vào record restricted, không tăng hạn mức của Zenodo. Vai trò của proxy trong pipeline thu thập có ở bài Web Scraping proxy là gì.
Đầu ra nghiệm thu: Manifest record version DOI license file checksum với điều kiện tải của Zenodo API danh mục dataset
Phần này liệt kê những gì phải có để coi danh mục là xong.
Tệp manifest.csv
Tệp có đủ cột record_id, version_doi, concept_doi, version, publication_date, license, access_right, file_key, size, checksum_algo, checksum, download_url, dieu_kien_tai. Mỗi tệp của mỗi phiên bản một dòng. Không có dòng nào thiếu version_doi hoặc checksum.
Kiểm concept và version không lẫn
Mọi dòng cùng dataset phải có cùng concept_doi. Không có hai dòng cùng version_doi mà khác record_id. Lab kiểm bằng cách gom theo concept_doi, ra một nhóm hai bản, version_doi khác nhau.
Kiểm tải đúng thứ đã duyệt
Chỉ dòng có điều kiện duoc_tai mới được tải tự động. Sau khi tải, MD5 tính lại phải khớp checksum trong manifest. Lab có một dòng tải thật, khớp. Dòng còn lại để làm đối chứng, không tải.
Bảng nghiệm thu của lab
Bảng nghiệm thu
Hạng mục |
Kết quả 05/11/2026 |
|---|---|
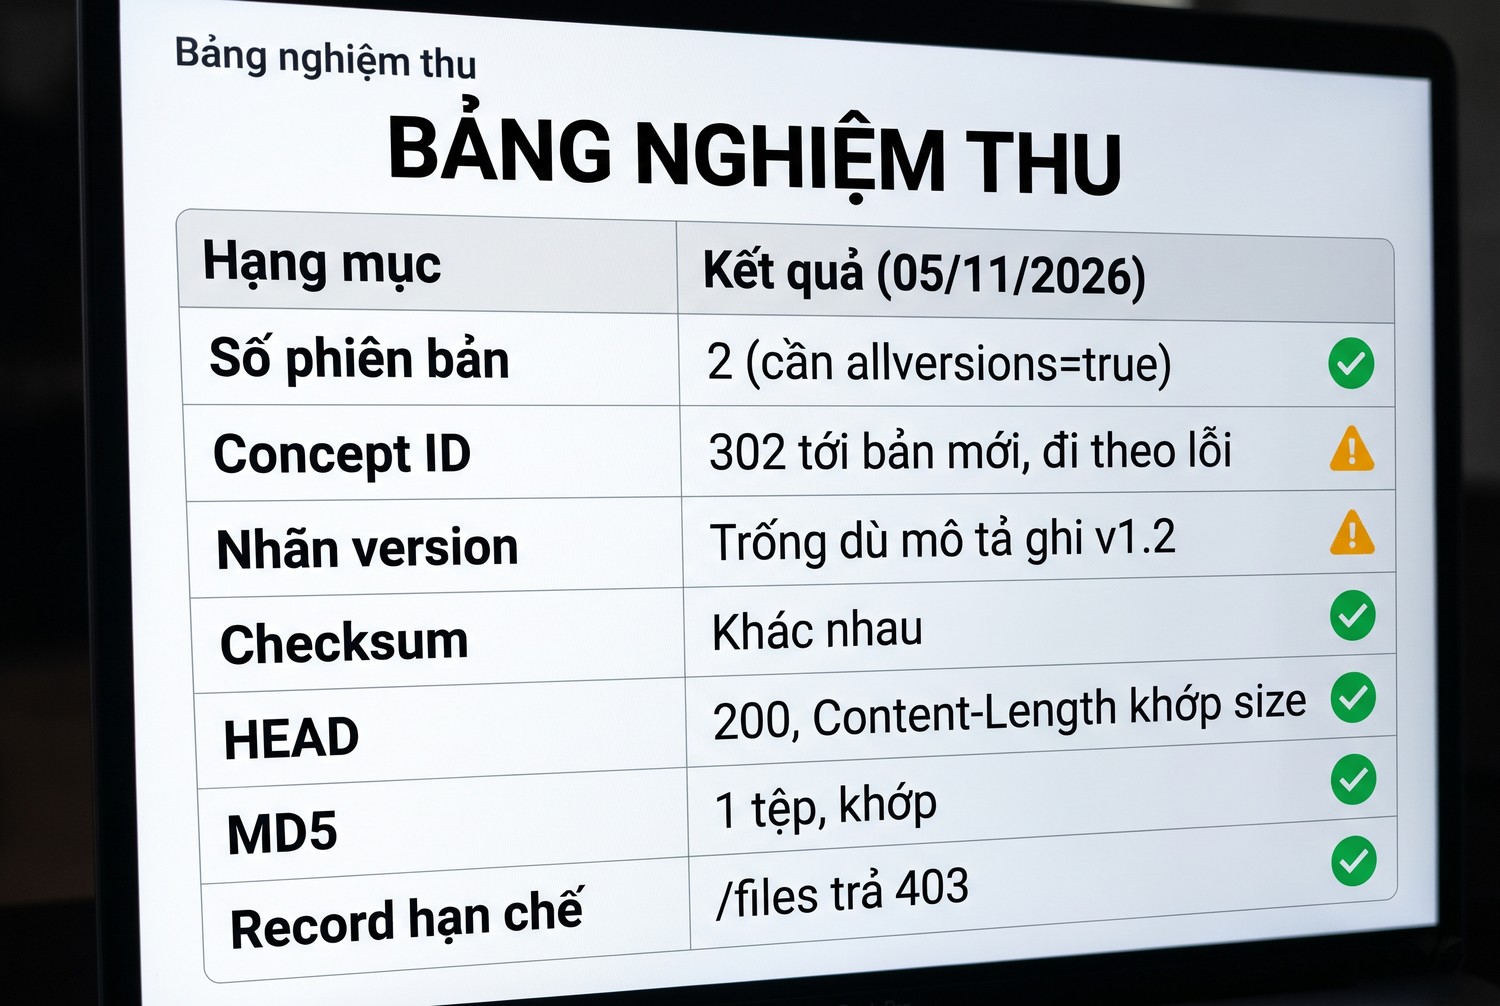
Số phiên bản tìm thấy |
2 (cần allversions=true) |
Concept ID gọi trực tiếp |
302 tới bản mới, đi theo lỗi |
Nhãn version bản mới |
Trống dù mô tả ghi v1.2 |
Checksum hai bản |
Khác nhau |
HEAD hai tệp |
200, Content-Length khớp size |
Tải và kiểm MD5 |
1 tệp, khớp |
Record restricted/embargoed |
/files trả 403 |
Những gì lab chưa chạy
Lab chưa thử record có nhiều tệp lớn, chưa thử tải theo stream, chưa thử OAI-PMH, chưa thử record thuộc community có yêu cầu riêng. Lab cũng chưa đo hạn mức khi gọi dồn dập, vì làm vậy trái với mục đích đọc nhẹ. Các phần đó cần chạy lại trước khi đưa vào sản xuất.
Lưu bản JSON gốc
Ngoài CSV, lab lưu record_latest.json, record_old.json, versions.json và files_latest.json. Khi có tranh cãi về một cột trong manifest, JSON gốc là bằng chứng. Nên lưu kèm ngày gọi trong tên thư mục.
Vận hành Zenodo API danh mục dataset trong pipeline định kỳ
Danh mục chỉ có ích khi được cập nhật đều mà không làm hỏng lịch sử.
Lịch quét
Dataset nghiên cứu ít khi đổi theo giờ. Quét mỗi ngày hoặc mỗi tuần là đủ. Mỗi lượt chỉ cần gọi /versions cho các concept đã theo dõi, so với manifest cũ, thêm dòng cho phiên bản mới.
Không sửa dòng cũ
Khi có bản mới, giữ nguyên các dòng của bản cũ. Thêm cột is_latest tính lại mỗi lượt quét nếu cần. Phân tích đã chạy trên bản 1.1 vẫn tra được bằng version_doi của nó.
Xử lý lỗi tạm thời
Lab gặp một lần treo 30 giây và một lần 500 ở cùng URL concept. Hàm get trong lab thử tối đa ba lần, nghỉ 10 giây giữa các lần. Lỗi 403 không thử lại. Lỗi 429 nên đọc header và chờ cho tới khi hạn mức hồi.
Ghi log theo record
Log mỗi lời gọi nên có URL, mã trạng thái, X-RateLimit-Remaining và thời gian phản hồi. Khi một dataset bỗng không cập nhật, log cho biết do API lỗi, do hết hạn mức hay do tác giả chưa ra bản mới.
Cấu hình proxy nếu cần
Nếu tầng tải phải đi qua proxy, ghi chuỗi proxy theo một định dạng thống nhất trong biến môi trường. Cách đọc các kiểu chuỗi khác nhau có ở bài định dạng proxy. Khi cần IP tại Việt Nam cho các tác vụ thu thập trong nước, anh em có thể mua proxy tại trang chủ ProxyVN. Với Zenodo, phần lớn thời gian kết nối thẳng là đủ.
Khóa phiên bản thư viện
Lab chạy Python 3.12.10 trên Windows với requests mới nhất từ PyPI ngày 05/11/2026. Ghi phiên bản vào tệp requirements của dự án. Schema JSON của Zenodo có thể đổi khi nền tảng nâng cấp, nên giữ một bộ test đọc JSON đã lưu để phát hiện sớm.
Báo cáo thay đổi
Mỗi lượt quét nên sinh một báo cáo ngắn: concept nào có bản mới, tệp nào đổi checksum, license nào đổi, record nào chuyển sang restricted. Người dùng dữ liệu đọc báo cáo này để biết có cần chạy lại phân tích không.
Theo dõi nhiều concept cùng lúc
Danh sách concept cần theo dõi nên nằm trong một tệp cấu hình riêng, mỗi dòng một concept ID kèm ghi chú dùng cho dự án nào. Vòng quét đọc tệp này, gọi /versions cho từng concept, nghỉ vài giây giữa các lời gọi. Với vài chục concept, một lượt quét xong trong vài phút.
Tôn trọng điều khoản
Zenodo là dịch vụ công do CERN vận hành. Đọc metadata ở nhịp vài giây một lần không gây tải đáng kể. Tải hàng loạt tệp lớn thì nên có lý do rõ, làm ngoài giờ cao điểm và giữ đúng license của từng dataset khi dùng lại.
Ghi version DOI cho phân tích, concept DOI cho trích dẫn chung, checksum cho từng tệp. Thiếu một trong ba thì danh mục chưa xong.
Zenodo API danh mục dataset: câu hỏi thường gặp
Các câu dưới đây gom những điểm hay bị hỏi khi dựng danh mục.
Nên trích concept DOI hay version DOI?
Trích version DOI khi cần tái lập kết quả. Trích concept DOI khi chỉ nói tới dataset nói chung. Manifest giữ cả hai.
Có cần token để đọc metadata không?
Không với record công khai. Lab không dùng token. Token chỉ cần khi tạo hoặc sửa deposit, hoặc đọc record của chính mình.
Vì sao tìm kiếm chỉ ra một bản?
Mặc định API chỉ trả bản mới nhất. Thêm allversions bằng true để thấy cả các bản cũ.
Có nên dựa vào metadata.version không?
Không nên. Bản mới trong lab không có trường này. Dùng record ID và version DOI làm khóa.
Record restricted có tải được qua proxy không?
Không. 403 là quyết định quyền của chủ dữ liệu. Đổi IP không thay đổi quyền.
Checksum khác thì có phải dữ liệu đổi không?
Tệp đã khác. Nội dung bên trong có thể chỉ đổi README, nhưng pipeline vẫn phải coi đó là đầu vào mới.
Có nên tải hết tệp của mọi phiên bản không?
Không cần. Chỉ tải bản mà phân tích thật sự dùng. Các bản khác giữ dòng metadata trong manifest để đối chiếu checksum và lịch sử.
Zenodo đổi schema JSON thì sao?
Giữ JSON gốc của mỗi lượt quét và một bộ test đọc các tệp đó. Khi test hỏng sau một lần nâng cấp nền tảng, sửa hàm đọc trước khi chạy quét tiếp, đừng để manifest ghi cột trống.
Một record có nhiều tệp thì tải tệp nào?
Đọc key và size của từng tệp trước. Thường chỉ cần tệp dữ liệu chính và README. Tệp phụ như hình hay mã nguồn để người duyệt quyết định.
Zenodo API danh mục dataset và những điều cần nhớ
Zenodo API danh mục dataset chỉ đáng tin khi tách rõ concept DOI và version DOI, đọc lại license ở từng bản, ghi checksum cho từng tệp và kiểm điều kiện trước khi tải. Gọi /versions thay vì đi theo chuyển hướng của concept ID, thêm allversions khi tìm kiếm, và dừng ở metadata với record bị hạn chế. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em giữ manifest như một tài sản của dự án khi làm Zenodo API danh mục dataset.


