
Web scraping dữ liệu AI bằng proxy: Hướng dẫn chi tiết
Web scraping dữ liệu AI bằng proxy là việc dùng một lớp proxy xoay IP để thu thập khối lượng lớn nội dung web làm dữ liệu huấn luyện hoặc đánh giá mô hình, mà không bị nguồn chặn. Bài viết này của ProxyVN trình bày quy trình từ chọn proxy, dựng pipeline, xoay IP đến làm sạch dữ liệu.
Nếu anh em cần phần công cụ trình duyệt tự động, xem proxy Playwright, cách sử dụng proxy trong Puppeteer và proxy cho n8n.
Vì sao web scraping dữ liệu AI bằng proxy cần lớp proxy
Thu thập dữ liệu cho AI khác thu thập vài trang lẻ ở quy mô. Một dự án dữ liệu huấn luyện thường cần hàng trăm nghìn tới hàng triệu trang từ nhiều nguồn, chạy liên tục nhiều ngày.
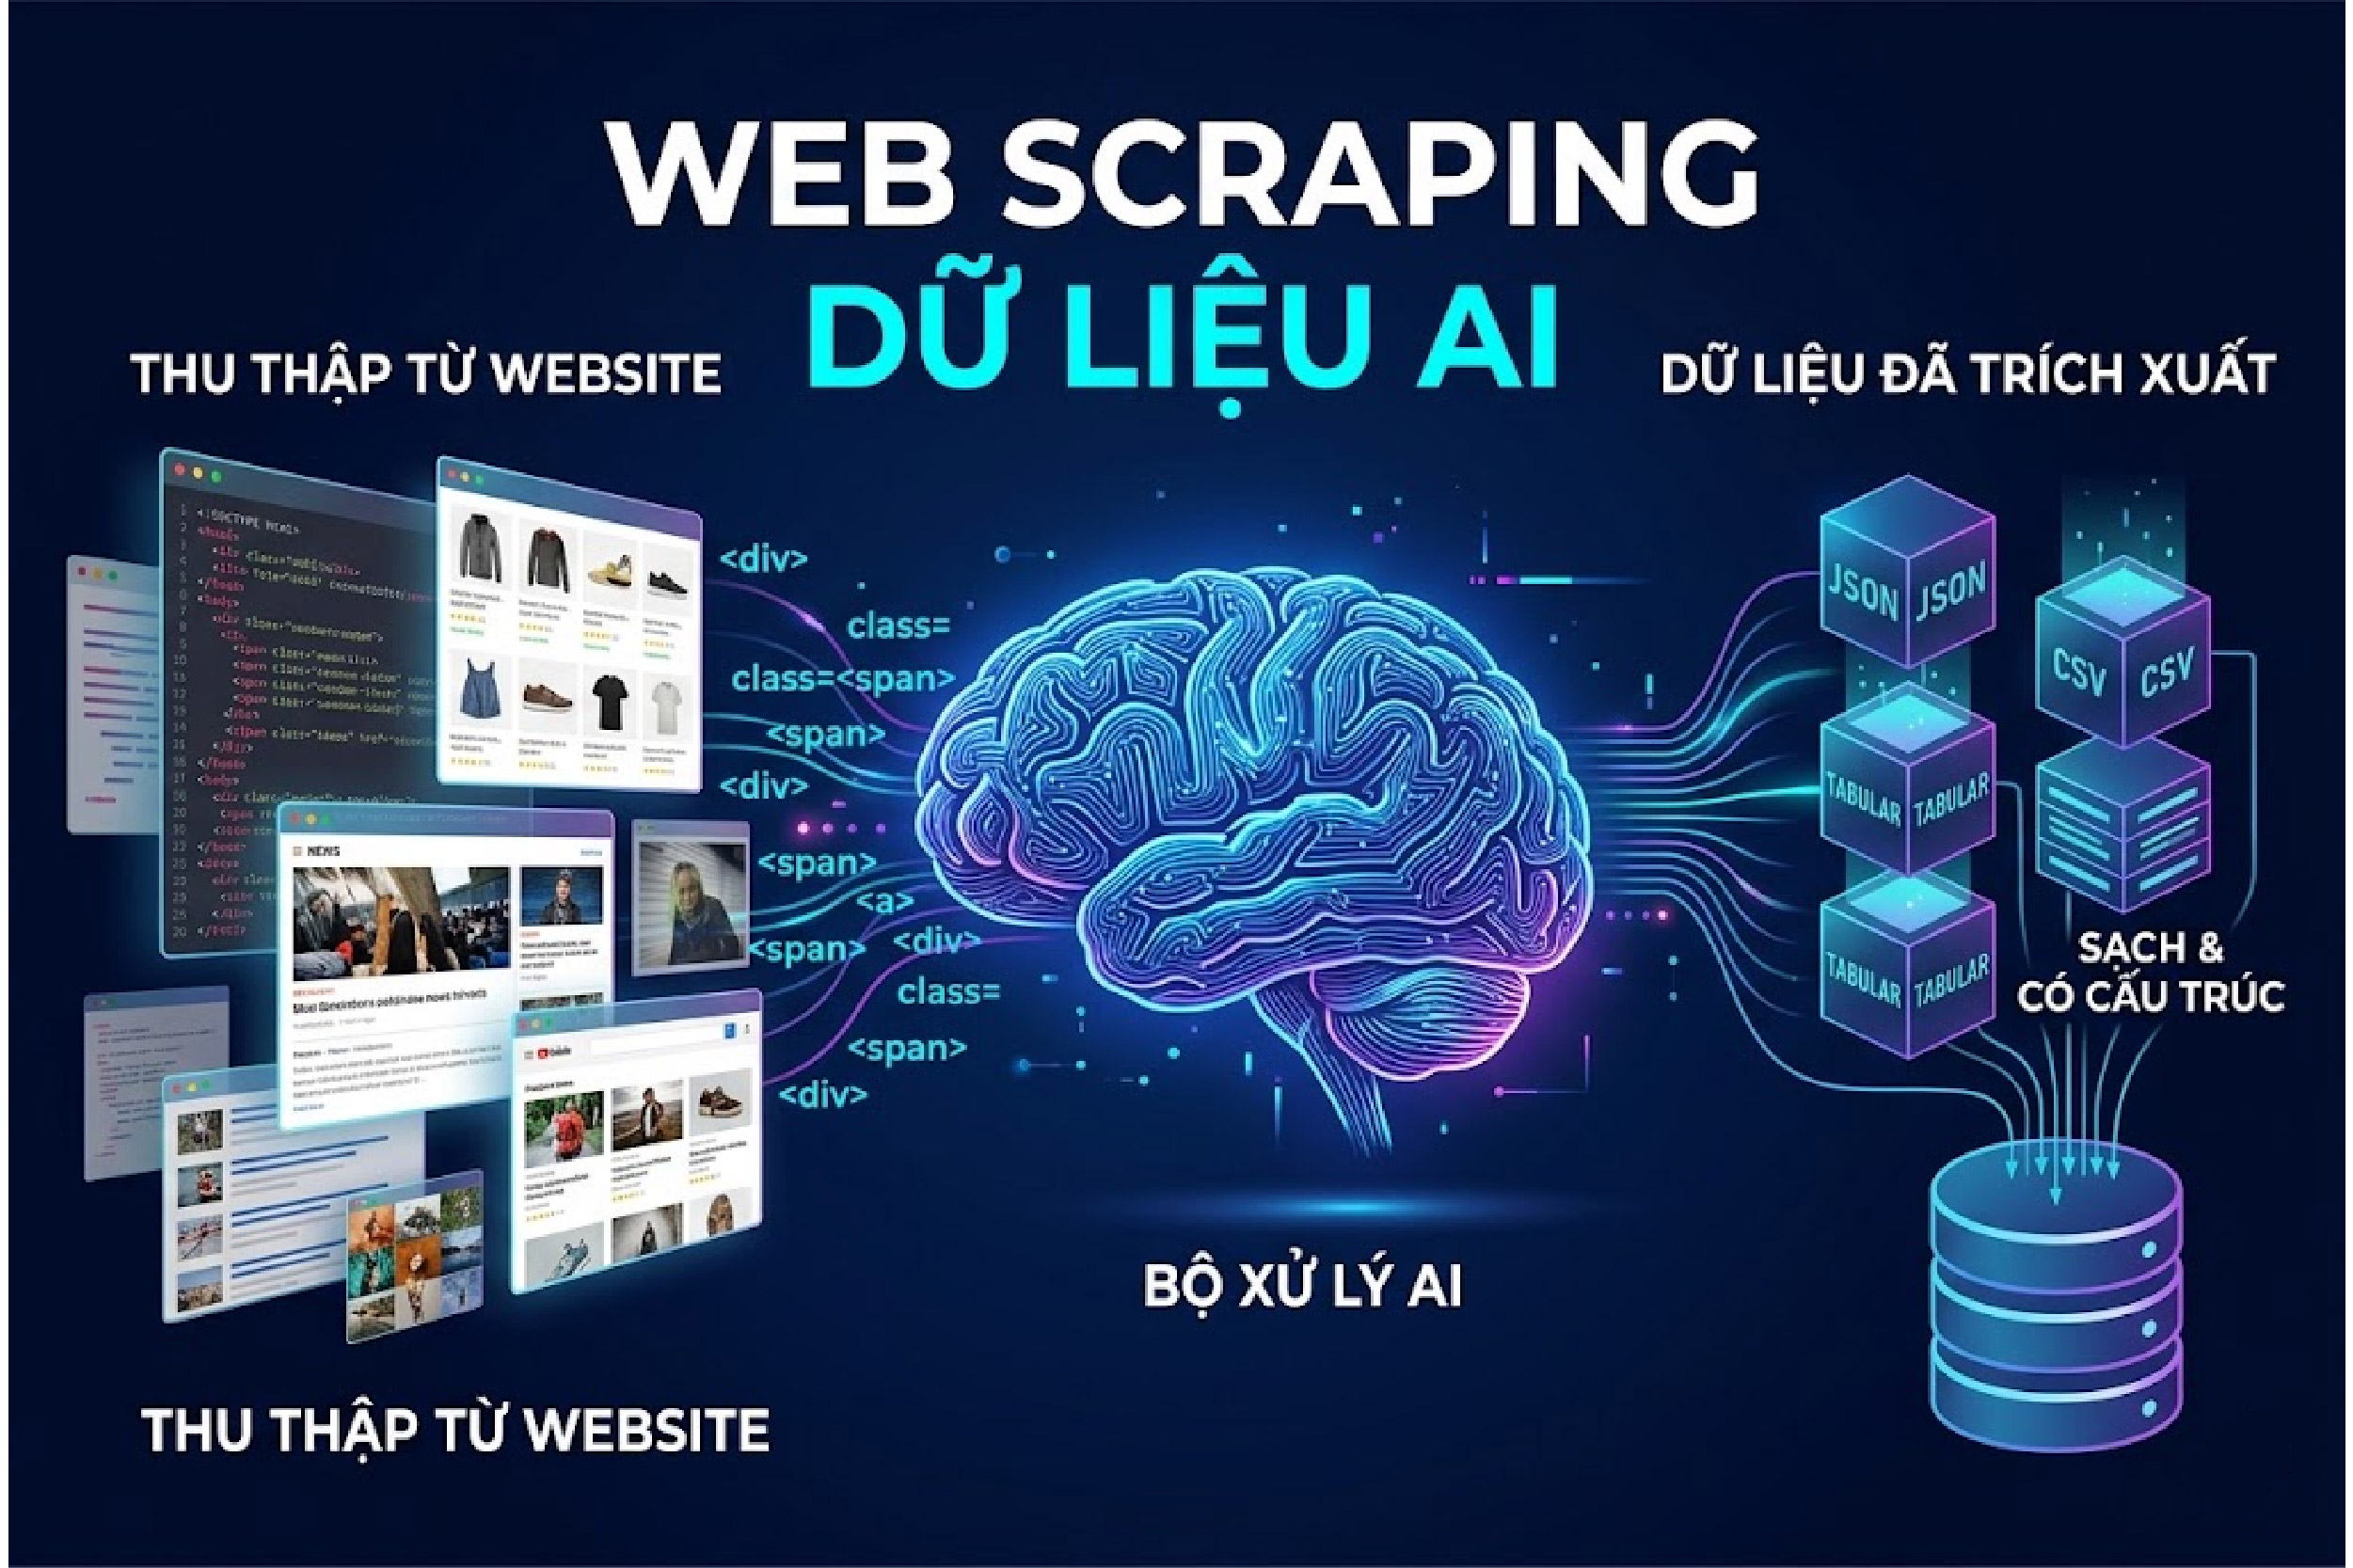
Web scraping dữ liệu AI
Đi bằng một địa chỉ IP, nguồn sẽ nhận ra mẫu truy cập bất thường trong vài phút và chặn. Lớp proxy phân tán request qua nhiều IP, giữ tần suất mỗi IP ở mức người thật, nhờ vậy pipeline chạy được tới hết mà không gãy giữa chừng.
Các rào cản proxy giúp vượt qua
Giới hạn tần suất theo IP, chặn theo dải IP máy chủ, tường chặn theo vùng địa lý, và các kiểm tra hành vi nhẹ. Proxy không vượt được captcha nặng hay đăng nhập bắt buộc; những nguồn đó cần cách tiếp cận khác hoặc nên bỏ qua.
Giới hạn truy cập
Đạo đức và pháp lý khi thu thập
Chỉ thu thập nội dung công khai, tôn trọng file robots và điều khoản sử dụng của nguồn, không thu thập dữ liệu cá nhân hay nội dung có bản quyền vào tập huấn luyện nếu không có quyền. Proxy là công cụ kỹ thuật, không miễn trừ trách nhiệm về nội dung.
Quy mô thay đổi bài toán ra sao
Thu thập vài chục trang, anh em có thể chạy tay và không cần proxy. Nhưng dữ liệu huấn luyện AI thường cần đa dạng nguồn và số lượng lớn để mô hình học được nhiều biến thể ngôn ngữ và chủ đề. Khi số trang lên tới hàng chục nghìn, quy trình thủ công không còn khả thi, buộc phải tự động hóa, và tự động hóa ở quy mô đó luôn kéo theo rủi ro bị chặn nếu không có lớp proxy đứng giữa.
Khác biệt với scraping cho các mục đích khác
Cào giá sản phẩm hay theo dõi đối thủ thường nhắm một số ít nguồn cố định và cần độ chính xác cao theo thời gian thực. Thu thập dữ liệu AI ngược lại: nhắm rất nhiều nguồn khác nhau, chấp nhận độ trễ, nhưng cần độ đa dạng và khối lượng lớn. Sự khác biệt này ảnh hưởng tới cách chọn proxy: đa dạng nguồn cần đa dạng vùng IP hơn là cần tốc độ cực cao.
Chọn loại proxy cho web scraping dữ liệu AI bằng proxy
Chọn theo mức kiểm tra của nguồn, không chọn theo giá.
IP trung tâm dữ liệu
Loại nguồn |
Đặc điểm |
Loại proxy nên dùng |
|---|---|---|
Trang tài liệu, blog mở |
Không kiểm tra, ít giới hạn |
Datacenter xoay |
Diễn đàn, trang tin lớn |
Có giới hạn tần suất |
Datacenter hoặc dân cư |
Sàn thương mại, mạng xã hội |
Kiểm tra hành vi gắt |
Dân cư xoay theo request |
Nguồn chặn theo vùng |
Chỉ mở cho một số nước |
Dân cư đúng quốc gia |
Vì sao dân cư hợp với nguồn khó
IP dân cư trông như của người dùng gia đình thật, nên nguồn ngại chặn vì sợ chặn nhầm khách thật. Datacenter nhanh và rẻ hơn nhưng dải IP dễ bị nhận diện. Với pipeline lớn, thường trộn cả hai theo từng nhóm nguồn. Xem web scraping proxy là gì.
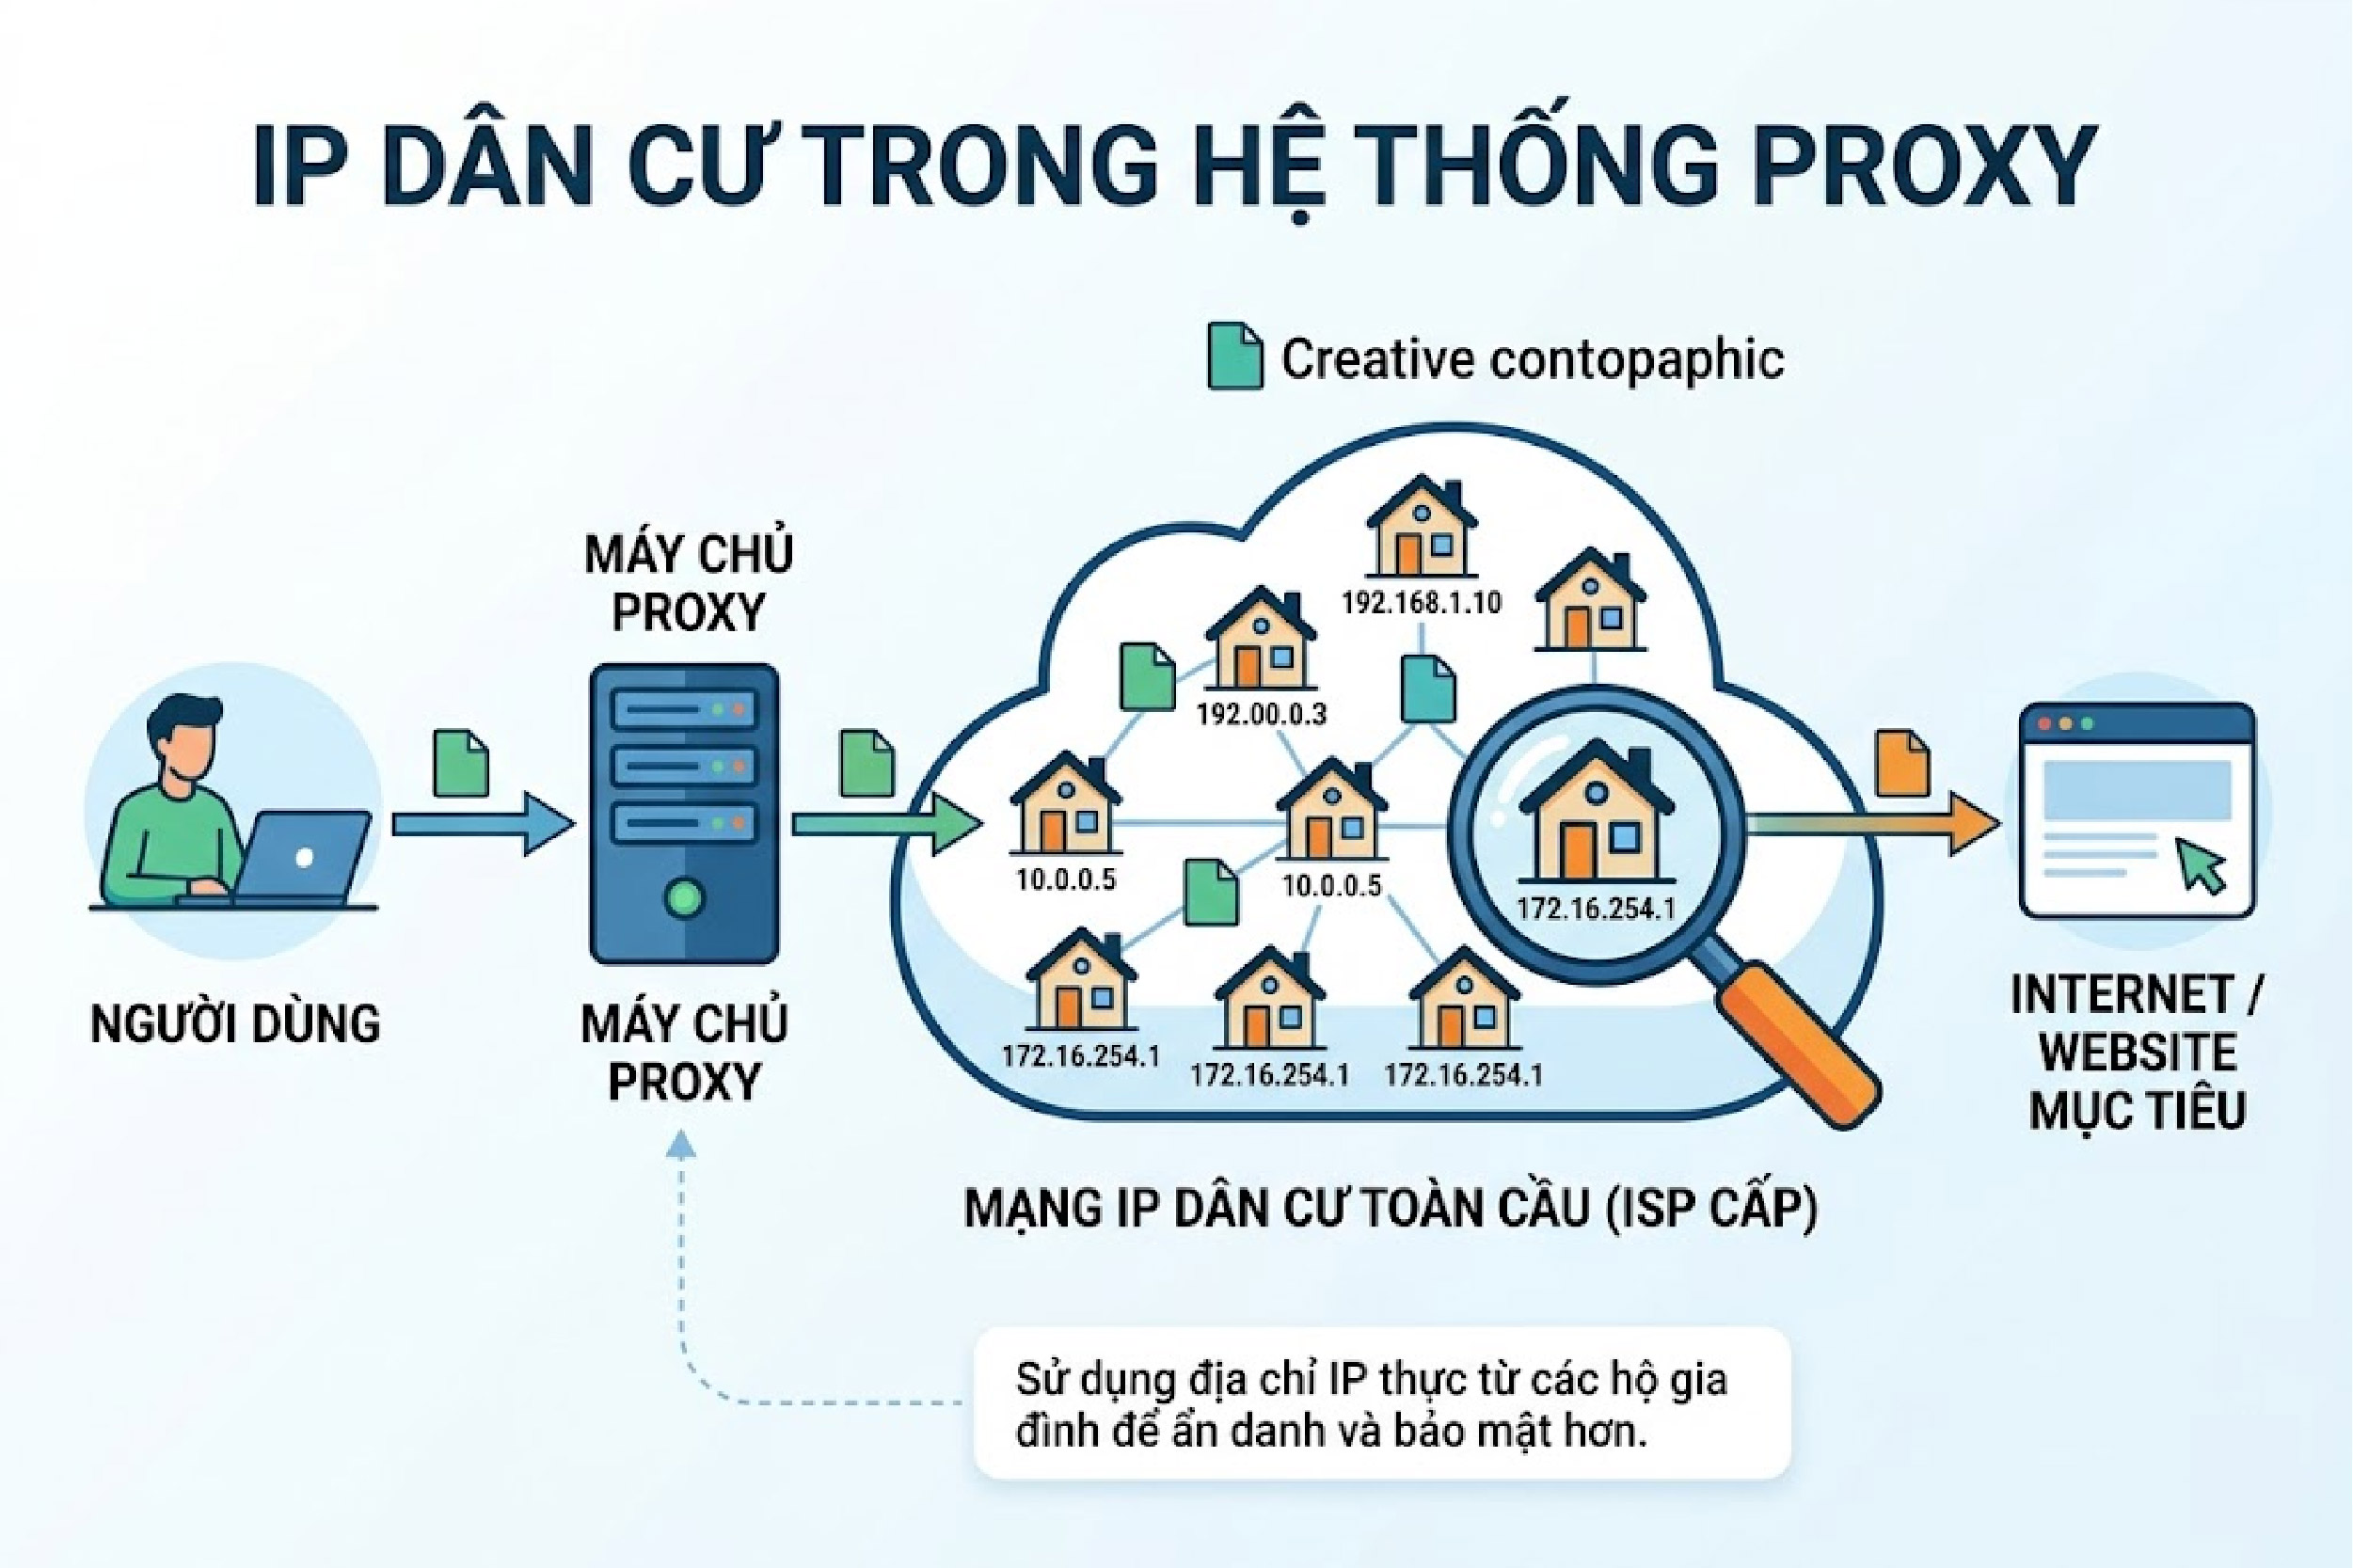
IP Dân cư
Xoay theo request hay theo phiên
Đọc dữ liệu tĩnh không cần đăng nhập thì xoay mỗi request để phân tán tối đa. Nguồn cần giữ phiên, ví dụ trang phân trang có trạng thái, thì xoay theo phiên để cùng một IP đi hết một luồng.
Ước lượng số lượng IP cần thiết
Một cách tính thô: lấy tổng số request dự kiến trong một ngày chia cho số request an toàn mỗi IP có thể gửi trong ngày đó tới cùng một nguồn. Với nguồn dễ tính, mỗi IP có thể gửi vài trăm request an toàn; với nguồn khó, con số này có thể chỉ vài chục. Nhân thêm hệ số dự phòng khoảng ba mươi phần trăm cho các IP bị loại giữa chừng vì dính chặn, anh em sẽ có con số dải cần thuê gần sát thực tế thay vì đoán mò.
Dựng pipeline web scraping dữ liệu AI bằng proxy
Một pipeline tối giản gồm năm khối: danh sách nguồn, lớp proxy, bộ thu thập, bộ làm sạch, kho lưu.
Khối thu thập với proxy xoay
import random
import time
import requests

PROXY = "http://user:pass@gateway-host:port"
proxies = {"http": PROXY, "https": PROXY}

def fetch(url):
    r = requests.get(url, proxies=proxies, timeout=20)
    r.raise_for_status()
    return r.text

for url in urls:
    html = fetch(url)
    time.sleep(random.uniform(2, 6))
Endpoint cổng xoay của nhà cung cấp tự đổi IP cho mỗi request, nên code không phải tự quản lý danh sách. Khoảng nghỉ ngẫu nhiên hai tới sáu giây làm nhịp truy cập bớt giống máy.
Với trang cần JavaScript để dựng nội dung, requests thuần không đủ vì nó không chạy JavaScript. Lúc đó cần trình duyệt tự động như Playwright hoặc Puppeteer, cũng gán proxy tương tự nhưng nặng tài nguyên hơn nhiều. Chỉ dùng trình duyệt tự động cho các nguồn thực sự cần, còn lại ưu tiên requests thuần vì nhanh và rẻ hơn đáng kể khi chạy quy mô lớn.
Tách lấy nội dung khỏi HTML
Sau khi có HTML, dùng thư viện phân tích để lấy phần văn bản chính, bỏ menu, quảng cáo, chân trang. Với dữ liệu AI, phần thân bài sạch mới có giá trị; giữ nguyên HTML thô làm tập huấn luyện nhiễu và tốn dung lượng.
Chạy song song có kiểm soát
Dùng hàng đợi công việc và một nhóm luồng hoặc tiến trình, mỗi đơn vị lấy một URL và một IP. Giới hạn số luồng theo số IP thực có và theo mức nguồn chịu được, đừng mở quá nhiều luồng trên một IP. Với luồng phức tạp, xem proxy cho n8n.
Xoay IP và giữ nhịp trong web scraping dữ liệu AI bằng proxy
Đây là phần quyết định pipeline sống được bao lâu.
Chia lô và phân bổ IP
Chia danh sách URL thành các lô nhỏ, mỗi lô gán một nhóm IP. Theo dõi số request và tỷ lệ lỗi của từng IP; IP nào lỗi nhiều thì rút khỏi vòng và báo nhà cung cấp thay.
Nhịp truy cập giống người thật
Không gửi request đều tăm tắp. Thêm khoảng nghỉ ngẫu nhiên, thỉnh thoảng chèn quãng dừng dài, và giảm tốc vào giờ nguồn tải cao. Mục tiêu là mẫu lưu lượng không có chu kỳ máy móc.
Giả lập thông số thiết bị người dùng
Xử lý mã trạng thái
- 200: lưu nội dung.
- 403 hoặc 429: IP bị nghi, đổi IP và giảm tần suất, không thử lại ngay.
- 5xx: nguồn quá tải, chờ rồi thử lại sau.
- 301, 302: theo chuyển hướng nhưng ghi lại URL cuối.
Tôn trọng robots và giới hạn
Đọc file robots của nguồn, bỏ các đường dẫn bị cấm, và giữ tần suất dưới ngưỡng nguồn nêu nếu có. Điều này vừa đúng đạo đức vừa giảm rủi ro bị chặn dải IP.
Theo dõi sức khỏe pipeline theo thời gian thực
Dựng một bảng đếm đơn giản ghi số request thành công, số lỗi theo loại, và số IP còn sống trong mỗi khung giờ. Khi tỷ lệ lỗi vượt một ngưỡng, ví dụ hai mươi phần trăm trong mười phút, tự động tạm dừng lô đó và cảnh báo thay vì để pipeline tiếp tục đốt IP vào một nguồn đang chặn gắt. Phát hiện sớm giúp anh em giữ được phần lớn dải IP cho các lô sau thay vì mất trắng.
Làm sạch dữ liệu sau web scraping dữ liệu AI bằng proxy
Dữ liệu thô chưa dùng được ngay cho huấn luyện. Các bước làm sạch cần thiết.
Loại trùng lặp
Nhiều trang có nội dung gần giống nhau. Dùng băm nội dung hoặc so khớp gần đúng để loại bản trùng, giữ lại một bản đại diện. Trùng lặp nhiều làm mô hình học lệch.
Lọc nội dung rác
Bỏ trang lỗi, trang chỉ có menu, trang quá ngắn, nội dung sinh tự động chất lượng thấp. Đặt ngưỡng độ dài tối thiểu và vài quy tắc lọc theo tỷ lệ ký tự lạ.
Gỡ thông tin cá nhân
Quét và che số điện thoại, email, số tài khoản, địa chỉ trước khi đưa vào tập huấn luyện. Đây là bước bắt buộc về mặt tuân thủ, không nên bỏ qua.
Chuẩn hóa định dạng
Đưa về một định dạng thống nhất: văn bản thuần hoặc markdown gọn, mã hóa UTF-8, gắn siêu dữ liệu nguồn và thời điểm thu thập để về sau truy vết được.
Ghi lại nguồn gốc
Mỗi bản ghi nên kèm URL gốc, thời điểm thu thập và giấy phép nếu biết. Khi cần loại một nguồn khỏi tập dữ liệu về sau, anh em lọc theo siêu dữ liệu này thay vì làm lại từ đầu.
Đánh giá chất lượng trước khi đưa vào huấn luyện
Ngoài lọc rác, nên lấy mẫu ngẫu nhiên một phần nhỏ dữ liệu đã làm sạch để đọc tay, kiểm tra xem có đúng chủ đề mong muốn không, có lẫn nội dung sai lệch hay quảng cáo trá hình không. Bước kiểm tra thủ công này tốn thời gian nhưng phát hiện được những lỗi mà quy tắc tự động bỏ sót, và nên lặp lại mỗi khi thêm một nguồn mới vào pipeline.
Sai lầm thường gặp khi web scraping dữ liệu AI bằng proxy
Vài lỗi khiến pipeline gãy hoặc dữ liệu kém.
- Dùng datacenter cho nguồn kiểm tra gắt, dẫn tới tỷ lệ chặn cao ngay từ đầu.
- Không đặt timeout, một proxy treo làm đứng cả tiến trình.
- Xoay IP nhưng quên đổi hoặc chuẩn hóa header, nguồn vẫn nhận ra một client.
- Bỏ bước loại trùng, tập dữ liệu phình to mà giá trị không tăng.
- Không ghi siêu dữ liệu nguồn, về sau không truy vết hay lọc lại được.
Khắc phục chủ yếu nằm ở việc chọn đúng loại proxy từ đầu và xây bước làm sạch song song với bước thu thập, không để dồn về cuối.
Một lỗi khác ít được nhắc tới là quên xử lý mã hóa ký tự. Trang tiếng Việt đôi khi khai sai bảng mã trong header, khiến văn bản lấy về lẫn ký tự lỗi. Luôn kiểm tra encoding thực tế của response thay vì chỉ tin vào header Content-Type, và log lại các trang có dấu hiệu lỗi mã hóa để xử lý riêng thay vì đưa thẳng vào tập huấn luyện.
Cuối cùng, nhiều đội đánh giá thấp thời gian cần cho bước làm sạch so với bước thu thập. Trên thực tế, làm sạch và kiểm tra chất lượng thường tốn thời gian tương đương hoặc hơn cả việc cào dữ liệu, vì đây là nơi quyết định tập dữ liệu có dùng được hay không. Lên kế hoạch đủ thời gian cho bước này ngay từ đầu, đừng coi nó là việc phụ làm sau cùng.
Proxy của ProxyVN cho web scraping dữ liệu AI bằng proxy
ProxyVN cung cấp proxy datacenter, dân cư và 4G có xác thực, endpoint cổng xoay sẵn để cắm thẳng vào pipeline, xoay IP theo request hoặc theo phiên, và nguồn IP minh bạch kiểm chứng được độ sạch.
Với dự án dữ liệu lớn, anh em phối hợp datacenter cho các nguồn mở và dân cư cho các nguồn khó, bắt đầu bằng một dải nhỏ để đo tỷ lệ chặn trên từng nhóm nguồn rồi mở rộng. Đội hỗ trợ tiếng Việt trực 24/7 khi cần đổi IP hoặc mở rộng gấp.
Một quy trình thực tế nhiều đội áp dụng: tuần đầu chạy thử với vài chục IP để hoàn thiện bước làm sạch và phát hiện các nguồn khó cần đổi loại proxy, tuần sau mới mở rộng lên quy mô đầy đủ. Cách làm tuần tự này rẻ hơn nhiều so với mua cả dải lớn ngay từ đầu rồi phát hiện pipeline có lỗi sau khi đã tiêu tốn phần lớn ngân sách proxy.
Xem thêm: Proxy Scraping Google Là Gì? Giải đáp chi tiết
Với các dự án thu thập dữ liệu cho AI, anh em có thể mua proxy xoay có API tại ProxyVN để chia tải yêu cầu qua nhiều IP và giảm tỷ lệ bị chặn.
Giải đáp nhanh về web scraping dữ liệu AI bằng proxy
Vài câu hỏi hay gặp khi anh em web scraping dữ liệu AI bằng proxy.
Có bắt buộc dùng proxy dân cư không?
Không. Nguồn mở dùng datacenter là đủ và rẻ hơn. Chỉ nâng lên dân cư cho các nguồn kiểm tra hành vi gắt.
Bao nhiêu IP là đủ cho một dự án?
Phụ thuộc tổng số trang, tần suất chấp nhận của nguồn và thời gian cho phép. Bắt đầu nhỏ, đo tỷ lệ chặn, rồi tăng dần thay vì mua lớn ngay.
Proxy có vượt được captcha không?
Không. Proxy chỉ đổi IP. Captcha nặng cần cách khác; thường nên bỏ qua nguồn đó hoặc tìm nguồn dữ liệu thay thế.
Làm sao biết IP proxy còn sạch?
Theo dõi tỷ lệ mã 403 và 429 theo từng IP. Tỷ lệ tăng đột biến là dấu hiệu IP bị đánh dấu, cần thay.
Dữ liệu thu thập có dùng được cho mọi loại mô hình không?
Không hẳn. Mô hình phân loại cần dữ liệu gán nhãn rõ ràng, mô hình sinh văn bản cần văn bản mạch lạc và đa dạng chủ đề. Xác định trước loại mô hình sẽ dùng giúp anh em đặt tiêu chí làm sạch và chọn nguồn phù hợp ngay từ đầu.
Có nên lưu HTML thô không?
Lưu tạm để xử lý lại nếu bước tách nội dung có lỗi, nhưng tập huấn luyện cuối chỉ nên chứa văn bản đã làm sạch.
Dữ liệu tiếng Việt có cần xử lý gì riêng không?
Có. Kiểm tra kỹ bảng mã, chuẩn hóa dấu tiếng Việt về cùng một dạng Unicode, và chú ý các nguồn hay lẫn văn bản không dấu hoặc gõ tắt, vì chúng làm nhiễu tập dữ liệu nếu không được lọc riêng.
Nên chạy pipeline trên máy cá nhân hay máy chủ?
Thử nghiệm ban đầu trên máy cá nhân là được, nhưng chạy quy mô lớn và dài ngày nên đưa lên một máy chủ chạy liên tục, có giám sát và tự khởi động lại khi tiến trình gặp lỗi.
Tóm lại, web scraping dữ liệu AI bằng proxy gồm bốn phần: chọn loại proxy theo độ khó của nguồn, dựng pipeline thu thập với cổng xoay, giữ nhịp truy cập giống người thật và làm sạch dữ liệu trước khi huấn luyện. Cần nguồn proxy sạch và xoay được để chạy bền, hãy liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


