
Temporal workflow cho crawl dài: tải trong activity, replay sạch
Temporal workflow cho crawl dài tách crawl thành hai phần: workflow chỉ quyết định làm gì tiếp theo, còn activity mới được đụng tới mạng. Nhờ vậy khi worker chết, workflow chạy lại từ history mà không tải lại trang đã xong. ProxyVN chạy Replayer thật của SDK Python trên history dựng tay, đo số HTTP phát sinh khi replay, và ghi rõ phần chưa có Temporal Service.
Temporal workflow cho crawl dài: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và giới hạn.
Bài toán cần giải
Một lượt crawl kéo dài vài giờ, gồm hàng nghìn URL và nhiều bước phụ thuộc nhau. Worker khởi động lại giữa chừng thì lượt đó phải đi tiếp, không tải lại từ đầu. Nhóm chọn Temporal, nhưng lần đầu viết đã gọi requests ngay trong workflow, và thấy website nhận thêm request mỗi lần worker phục hồi.
Đầu ra nghiệm thu
Đầu ra là workflow history và kết quả replay cho thấy không có HTTP request nào ngoài activity. Kèm theo là bảng các thay đổi mã nguồn nào làm replay vỡ, thay đổi nào không. Đây là bằng chứng thật, vì kết quả đến từ SDK chạy trên máy lab.
Ranh giới với bài Prefect
Bài Prefect retry task nói về thử lại một task bị lỗi. Bài này nói về replay: cả hàm workflow được chạy lại từ đầu theo history. Hai khái niệm khác nhau về bản chất, và lỗi hay gặp với Temporal không có mặt ở Prefect. Ảnh dashboard hay đoạn code gọi HTTP đều không đủ, bằng chứng ở đây là history.
Giới hạn của lab
Nói rõ ngay từ đầu. Lab không có Temporal Service. Máy lab không tải được máy chủ dev, nên không có worker thật nhận task qua hàng đợi, không có retry do server điều phối, không có Web UI. Lần gọi Client.connect tới cổng 7233 báo RuntimeError không kết nối được, đúng như dự kiến.
Phần nào thật, phần nào dựng tay
Replayer trong temporalio 1.35.0 là mã thật, gồm cả lõi Rust của SDK. Nó thực thi hàm workflow và so lệnh với history. Activity fetch chạy thật qua ActivityEnvironment, gọi HTTP tới máy chủ fixture cục bộ. Riêng history do ProxyVN dựng bằng protobuf của SDK, theo đúng thứ tự sự kiện trong tài liệu.
Bẫy khi dựng history tay
Lần chạy đầu, đổi tên activity mà replay vẫn báo sạch. Tài liệu lại nói đổi tên là không an toàn. Nguyên nhân: lõi SDK chỉ bật kiểm tra loại và mã activity khi history có cờ core_used_flags trong sự kiện WorkflowTaskCompleted. History dựng tay thiếu cờ này. Thêm cờ vào, lỗi xuất hiện đúng tài liệu. Bài ghi lại vì history rất cũ cũng có thể gặp đúng hiện tượng đó.
Ai nên đọc bài này
Người đang đưa crawler chạy dài lên Temporal. Người gặp lỗi nondeterminism sau khi sửa mã. Người muốn biết phải đặt lệnh gọi proxy, gọi HTTP ở đâu trong kiến trúc này.
Tách workflow deterministic và activity tải web trong Temporal workflow cho crawl dài
Phần này tóm tắt tài liệu chính thức, chỗ quyết định cách viết mã.
Workflow Execution và Workflow Function
Tài liệu về Workflow Definition phân biệt rất rõ. Một Workflow Execution chạy một lần tới khi xong. Hàm workflow thì được thực thi nhiều lần trong suốt vòng đời đó. Đây là câu cần hiểu đầu tiên, vì nó giải thích mọi quy tắc phía sau.
Replay là gì
Trang Workflow Execution mô tả replay là cách một Workflow Execution tiếp tục chạy. Trong lúc replay, các command được sinh ra sẽ được so với Event History đã có. Khi có sự cố, execution đi tiếp từ sự kiện cuối cùng đã ghi.
Determinism nghĩa là gì ở đây
Tài liệu định nghĩa: mỗi lần chạy mã workflow phải gọi cùng các API của workflow, theo cùng thứ tự, với cùng đầu vào. Mã có thể tính toán tùy ý, miễn chuỗi command giống nhau. Giờ hệ thống, số ngẫu nhiên, trạng thái mạng đều đổi theo lần chạy, nên không được quyết định luồng trong workflow.
Câu nói thẳng của tài liệu
Tài liệu ghi các thao tác không deterministic như gọi API, gọi mô hình AI, truy vấn cơ sở dữ liệu phải đặt trong Activity, vì Activity chạy ngoài đường replay. Với crawl, mọi thứ chạm vào mạng đều thuộc nhóm này. Workflow chỉ quyết định, activity mới làm.
Command và Event
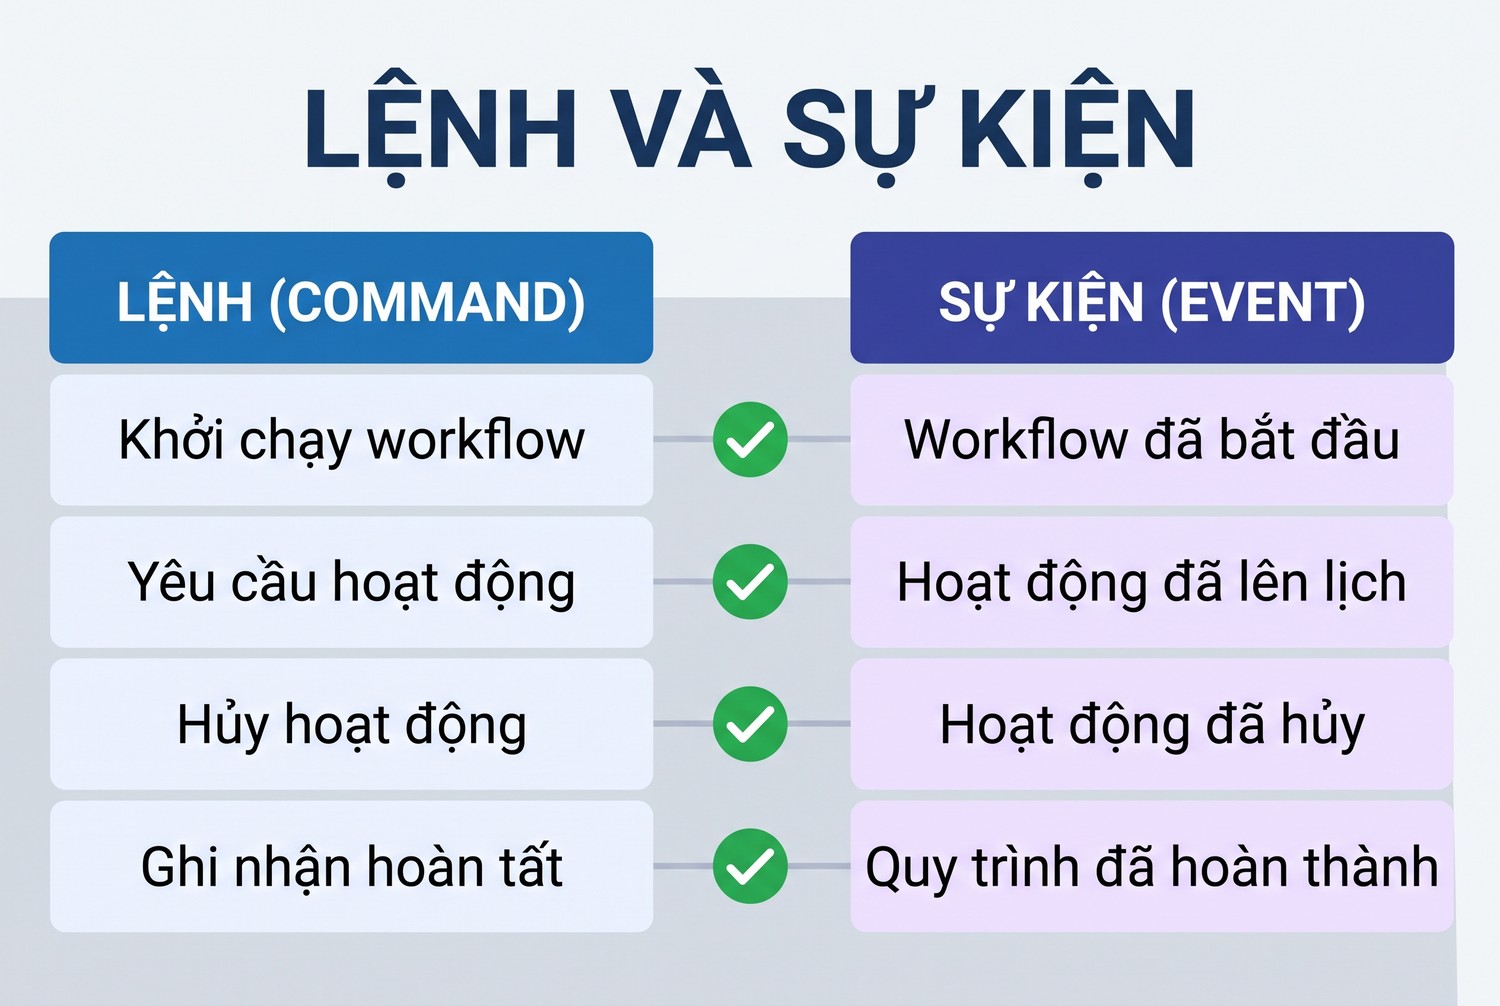
Lệnh và sự kiện
Khi gọi execute_activity, SDK sinh command ScheduleActivityTask. Temporal Service ghi sự kiện ActivityTaskScheduled. Khi replay, command được so với sự kiện ở cùng vị trí, tên activity phải khớp. Không khớp, execution trả lỗi non-deterministic. Đây là cơ chế mà lab kiểm tra trực tiếp.
Khái niệm |
Ai tạo |
Vai trò trong crawl |
|---|---|---|
Command |
Mã workflow qua SDK |
Yêu cầu chạy activity, đặt timer |
Event |
Temporal Service |
Ghi lại chuyện đã xảy ra |
Workflow Task |
Service giao cho worker |
Một lượt chạy hàm workflow |
Activity Task |
Service giao cho worker |
Một lượt tải trang |
Activity được phép gì
Activity là hàm bình thường: gọi HTTP, đọc tệp, ghi kho, dùng proxy, tất cả đều được. Kết quả của activity được ghi vào history. Lần replay sau, SDK trả lại kết quả đã ghi, không gọi hàm nữa. Vì vậy kết quả nên gọn: đừng nhét cả HTML vào history.
Retry của activity
Trang Activity Execution mô tả activity được thử lại theo Retry Policy khi lỗi hoặc hết thời gian, có Start-To-Close Timeout và Heartbeat. Thử lại do service điều phối, nên activity có thể chạy nhiều lần cho một lần gọi. Hàm tải và lưu phải chịu được việc đó.
Start-To-Close Timeout và Heartbeat
Tài liệu đưa ví dụ rất rõ: đặt timeout một tuần thì worker chết sẽ phải chờ một tuần mới thử lại. Task dài nên đặt timeout ngắn hơn và dùng heartbeat. Với crawl, mỗi activity nên chỉ tải một trang hoặc một lô nhỏ, để timeout ngắn là đủ.
Giới hạn history
Tài liệu nêu một Workflow Execution bị giới hạn về kích thước và thông lượng, và có thể mở rộng bằng Continue-As-New. Crawl hàng trăm nghìn URL trong một execution sẽ chạm giới hạn đó. Lab không chạm tới đây, nên bài chỉ nêu hướng ở phần sau.
Đặt tải web trong activity của Temporal workflow cho crawl dài
Phần này là mã nguồn, chạy thật với SDK Python.
Activity tải trang
Activity dưới đây tải từ một máy chủ fixture cục bộ. Lab gọi nó qua ActivityEnvironment, nên không cần worker hay server.
from temporalio import activity
import urllib.request

FIX = "http://127.0.0.1:9474/page/"

@activity.defn
async def fetch(url: str) -> dict:
    body = urllib.request.urlopen(FIX + url, timeout=5).read().decode()
    return {"url": url, "len": len(body), "body": body}
Chạy thật trả về nội dung trang và fixture đếm được đúng một request. Mã thực tế nên trả về đường dẫn tệp đã lưu, không trả về body.
Workflow đúng
Workflow chỉ lặp qua URL và gọi activity. Không có mạng, không có giờ hệ thống.
from datetime import timedelta
from temporalio import workflow

@workflow.defn(name="Crawl")
class CrawlGood:
    @workflow.run
    async def run(self, urls: list) -> list:
        out = []
        for u in urls:
            r = await workflow.execute_activity(
                fetch, u, start_to_close_timeout=timedelta(seconds=30))
            out.append(r["body"])
        return out
Lab giữ vòng lặp tuần tự để history dễ đọc. Crawl thật sẽ chạy nhiều activity song song theo lô.
Workflow sai
Bản dưới gọi urlopen ngay trong workflow. Để lỗi lộ ra, lab phải tắt sandbox bằng sandboxed=False.
@workflow.defn(name="Crawl", sandboxed=False)
class CrawlBadIO:
    @workflow.run
    async def run(self, urls: list) -> list:
        out = []
        for u in urls:
            urllib.request.urlopen(FIX + u + "?from=workflow", timeout=5).read()
            r = await workflow.execute_activity(
                fetch, u, start_to_close_timeout=timedelta(seconds=30))
            out.append(r["body"])
        return out
Tham số from=workflow để fixture phân biệt request phát sinh từ workflow với request từ activity.
Sandbox của SDK Python
Mặc định SDK Python chạy workflow trong sandbox. Lab thử gọi socket.create_connection trong workflow có sandbox, nhận RestrictedWorkflowAccessError với thông báo không được truy cập từ bên trong workflow. Gọi datetime.now cũng bị chặn tương tự. Đây là lớp bảo vệ rất có ích, đừng tắt nó nếu không có lý do rõ ràng.
Sandbox không phải lưới vạn năng
Thông báo lỗi có gợi ý đánh dấu import là pass through. Nhiều người làm theo để hết lỗi, rồi đưa thẳng thư viện HTTP vào workflow. Lab cũng dùng imports_passed_through cho urllib, và sandbox vẫn chặn được vài lời gọi, nhưng anh em không nên coi đó là bảo đảm. Mã review vẫn phải tìm các lời gọi mạng trong workflow.
Lấy giờ đúng cách
Khi cần thời điểm trong workflow, dùng workflow.now(). Khi cần số ngẫu nhiên, dùng workflow.random(). Hai hàm này cho cùng giá trị trong mọi lần replay. Giờ tải thật của trang thì activity tự lấy và trả về cùng kết quả, vì nó là dữ liệu chứ không phải quyết định luồng.
Đặt proxy ở đâu
Proxy chỉ được cấu hình trong activity. Danh sách proxy, xoay IP, chọn theo quốc gia đều là chuyện của activity. Với website được phép thu thập, có lúc cần IP tại Việt Nam để nhận đúng nội dung trong nước. Khi đó anh em có thể mua proxy Việt Nam tại trang chủ ProxyVN. Proxy không liên quan tới replay và không làm workflow bền hơn. Vai trò của nó có ở bài Web Scraping proxy là gì, cách ghi chuỗi cấu hình ở bài định dạng proxy.
Đặt workflow ID theo lượt crawl
Workflow ID nên mang nghĩa, ví dụ tên nguồn ghép ngày chạy. Lịch khởi động hai lần cùng ngày thì lần sau đụng ID đang chạy, thay vì tạo một lượt crawl thứ hai song song. Cách đặt tên này là chốt chặn rẻ nhất chống chạy trùng cả lượt. Lab không có service nên chưa thử hành vi này, anh em đọc chính sách Workflow ID trong tài liệu.
Xem tiến độ mà không đụng mạng
Crawl dài cần biết đã xong bao nhiêu. Workflow có thể giữ bộ đếm trong biến thường, cộng sau mỗi activity, và trả ra qua Query. Bộ đếm được dựng lại khi replay vì nó chỉ phụ thuộc history. Đừng ghi tiến độ ra cơ sở dữ liệu từ trong workflow, đó lại là I/O. Muốn ghi, tạo một activity nhỏ.
Danh sách URL lấy từ đâu
Lab truyền danh sách URL làm đầu vào workflow, nên nó nằm trong sự kiện đầu tiên của history. Với vài chục nghìn URL, đầu vào đó quá nặng. Hãy truyền khóa của tệp danh sách, rồi để một activity đọc từng lô. Kết quả mỗi lô được ghi vào history, nên replay nhận đúng lô cũ dù tệp đã đổi.
Không đưa mật khẩu proxy vào tham số
Tham số và kết quả của activity đều nằm trong history, ai xem được history là thấy. Anh em đừng truyền chuỗi user:pass làm đối số activity. Activity tự đọc từ biến môi trường hoặc kho bí mật. Lab không dùng proxy, nên đây là lưu ý thiết kế.
Ghi workflow execution history với task tải và parse trong Temporal workflow cho crawl dài
Phần này đọc history, tài sản chính của bài.
Dựng history thế nào
Với ba URL, history có 23 sự kiện. Lab dựng bằng các lớp protobuf trong temporalio.api, đặt attribute đúng tên, rồi đưa vào WorkflowHistory. Tệp JSON xuất ra nặng khoảng 8,7 KB. Khi có Temporal Service, anh em lấy history thật bằng lệnh temporal workflow show hoặc từ client.
Chuỗi sự kiện
Thứ tự dưới đây lặp lại cho mỗi URL. Mỗi lần activity xong, service tạo một Workflow Task mới để hàm workflow chạy tiếp.
Sự kiện |
Vai trò |
|---|---|
WorkflowExecutionStarted |
Lưu đầu vào, ở đây là danh sách URL |
WorkflowTaskScheduled, Started, Completed |
Một lượt chạy hàm workflow |
ActivityTaskScheduled |
Yêu cầu tải URL thứ nhất |
ActivityTaskStarted |
Worker nhận tải |
ActivityTaskCompleted |
Kết quả được ghi vào history |
WorkflowExecutionCompleted |
Kết quả cuối |
Đọc đoạn history như thế nào
Sự kiện ActivityTaskCompleted chứa đầu ra đã mã hóa của lần tải. Đó là lý do replay không cần mạng: giá trị đã ở sẵn trong history. Khi hàm workflow chạy lại và tới dòng await, SDK lấy giá trị từ history và đi tiếp ngay.
Thử nghiệm A: replay history đầy đủ
Lab đưa history 23 sự kiện vào Replayer với lớp CrawlGood. Kết quả không có lỗi, và fixture không nhận request nào.
from temporalio.worker import Replayer

r = await Replayer(workflows=[CrawlGood]).replay_workflow(
    hist, raise_on_replay_failure=False)
print(r.replay_failure)
Output của lab: 23 sự kiện, HTTP phát sinh 0, lỗi None.
Thử nghiệm A2: trang đã đổi nội dung
Lab đổi nội dung fixture sang phiên bản 2 rồi replay lại. Vẫn 0 request, vẫn sạch. Giá trị trong history là chuỗi tu history, không phải nội dung mới. Replay trả về quá khứ đã ghi, không đọc lại thế giới hiện tại. Đây chính là thứ giữ cho workflow nhất quán.
Vì sao điều này quan trọng với crawl
Nếu replay gọi lại website, hai chuyện xấu xảy ra. Website nhận thêm tải một cách vô lý. Nội dung mới có thể đổi luồng rẽ nhánh, làm workflow đi đường khác với lần đầu. Đặt tải trong activity loại bỏ cả hai.
Kích thước kết quả
Lab trả về chuỗi rất ngắn nên history chỉ vài KB. Trả về HTML thật, mỗi trang vài trăm KB, history sẽ phình rất nhanh. Tài liệu đề cập giới hạn kích thước của execution. Cách đúng: activity lưu HTML vào kho tệp, chỉ trả về đường dẫn, mã băm, mã trạng thái.
@activity.defn
async def fetch_to_store(url: str) -> dict:
    body = download(url)              # tai qua proxy neu can
    key = store.put(url, body)        # luu kho tep
    return {"url": url, "key": key, "sha256": sha256(body), "status": 200}
Đoạn này là ví dụ triển khai, các hàm download và store là của anh em, chưa chạy trong lab.
Tách tải và parse thành hai activity
Parse có thể lỗi vì mã phân tích sai, sửa xong muốn chạy lại mà không tải lại trang. Hai activity riêng cho phép điều đó. Activity tải trả về khóa tệp, activity parse nhận khóa đó. Khi sửa mã parse, phần tải trong history vẫn nguyên.
Ngắt worker rồi khôi phục execution trong Temporal workflow cho crawl dài
Phần này mô phỏng worker chết bằng history dang dở.
Worker chết thì chuyện gì xảy ra
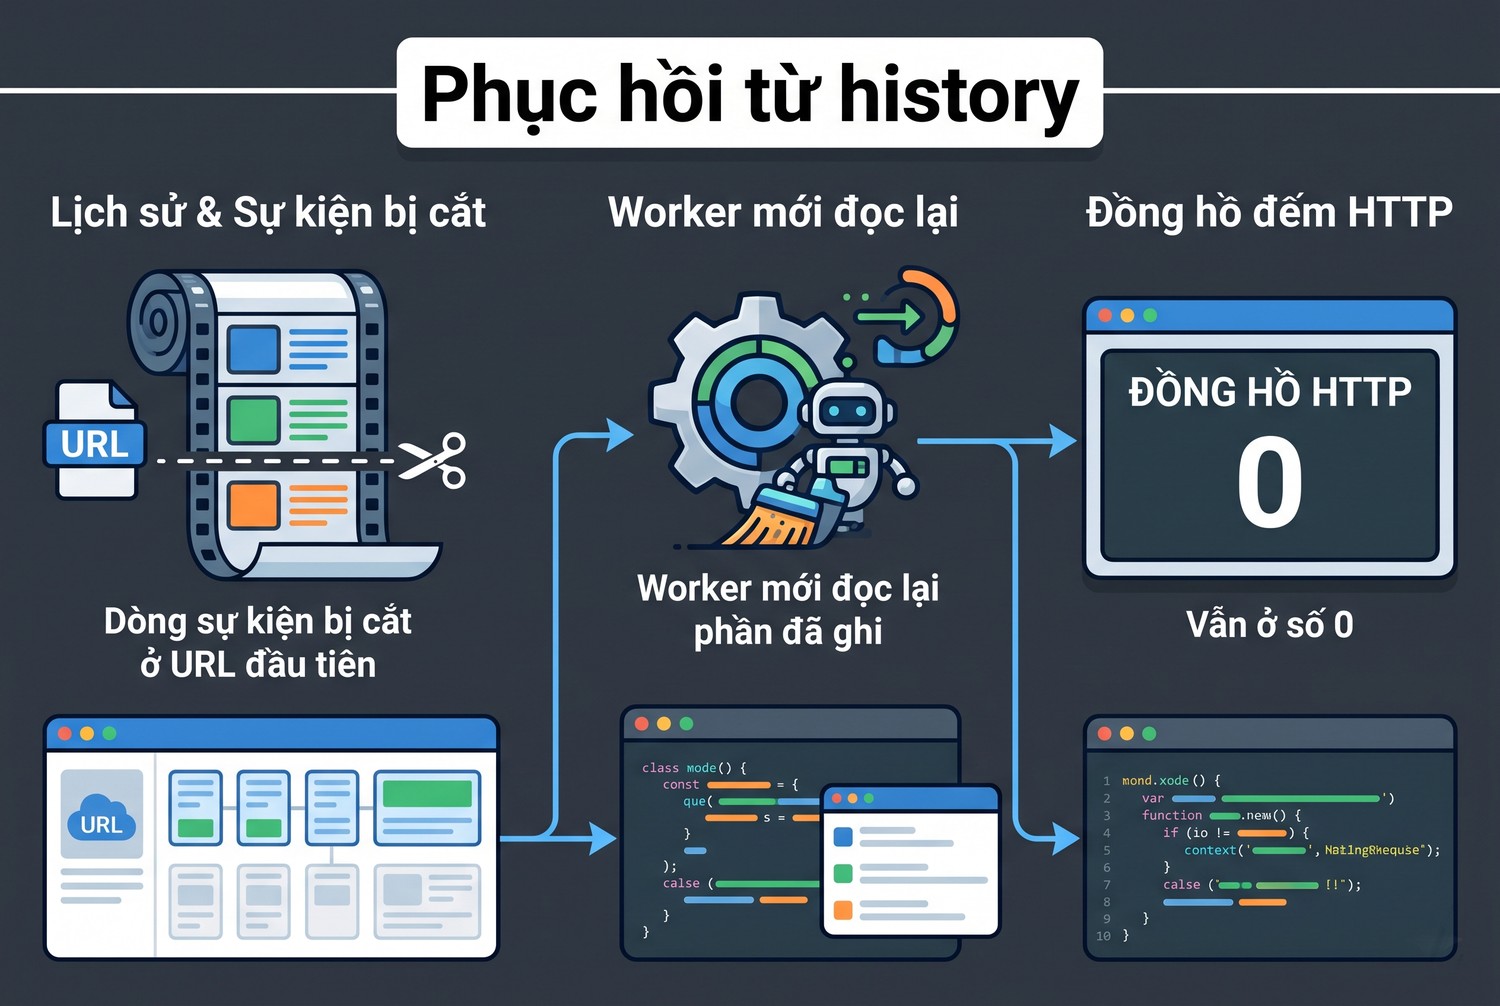
Theo tài liệu, khi có lỗi, execution đi tiếp từ sự kiện cuối đã ghi. Worker mới nhận Workflow Task, chạy lại hàm từ đầu, SDK cấp giá trị từ history cho tới hết phần đã có. Sau đó workflow đi vào vùng chưa từng chạy và sinh command mới.
Thử nghiệm B: history dang dở
Phục hồi từ history
Không có service, nên lab tái hiện thời điểm phục hồi bằng history cắt sau URL đầu tiên: 10 sự kiện, chưa có WorkflowExecutionCompleted. Replayer chạy sạch, 0 HTTP. Nghĩa là phần replay của quá trình phục hồi không đụng tới mạng.
Phần lab không làm được
Sau đoạn replay, worker thật sẽ gửi command chạy URL thứ hai, service ghi sự kiện, activity chạy. Chuỗi đó cần service nên lab không chạy. Lab cũng không kiểm tra được việc tái phân phối task, sticky queue hay thời gian phát hiện worker mất. Anh em phải thử trên cụm thật.
Activity đang chạy khi worker chết
Đây là ca khác. Activity đã có sự kiện Scheduled và Started nhưng chưa có Completed. Tài liệu nói Activity Task sẽ hết giờ theo Start-To-Close Timeout, rồi được thử lại theo Retry Policy. Nghĩa là trang đó có thể được tải hai lần. Replay không gây ra việc này, retry mới gây ra.
Replay sạch không có nghĩa tải đúng một lần
Hai khái niệm này dễ nhầm, nên cần tách bạch. Replay không phát sinh HTTP. Nhưng activity vẫn có thể chạy nhiều lần do retry. Tài liệu Temporal mô tả activity theo hướng thử lại, nên hàm tải và ghi kho phải idempotent. Khóa theo URL đã chuẩn hóa cộng mã lượt crawl là cách đơn giản nhất.
Heartbeat cho lô URL
Nếu một activity xử lý một lô URL, nó có thể gửi heartbeat kèm vị trí đã làm. Lần thử lại đọc lại chi tiết heartbeat để không làm lại từ đầu. Lab không chạy phần này vì cần service.
@activity.defn
async def fetch_batch(urls: list) -> int:
    start = activity.info().heartbeat_details[0] if activity.info().heartbeat_details else 0
    for i in range(start, len(urls)):
        fetch_one(urls[i])
        activity.heartbeat(i + 1)
    return len(urls)
Đoạn trên là ví dụ triển khai chưa chạy. Với crawl, mỗi activity một trang vẫn đơn giản hơn, chỉ dùng lô khi số sự kiện đáng lo.
Trang chậm và timeout
Activity tải cần timeout ở hai tầng: timeout của thư viện HTTP và Start-To-Close Timeout. Tầng HTTP phải ngắn hơn. Nếu không, Temporal coi activity hết giờ trong khi tiến trình vẫn đang chờ mạng, rồi chạy thêm một bản song song, và cùng trang bị tải hai lần.
Lỗi không nên thử lại
Website trả 404 không nên retry mãi. Trong Python SDK, activity ném ApplicationError với non_retryable bằng True để dừng. Khi đó workflow nhận lỗi và tự quyết định: ghi nhận URL hỏng, đi tiếp. Một URL hỏng không được làm hỏng cả lượt crawl.
from temporalio.exceptions import ApplicationError

if status == 404:
    raise ApplicationError("not found", type="HttpNotFound", non_retryable=True)
Đoạn này là ví dụ triển khai. Với 404, cũng có thể trả kết quả bình thường có trường status, tùy cách anh em muốn xử lý ở workflow.
Đối soát replay với HTTP request và activity retry trong Temporal workflow cho crawl dài
Phần này là bảng kết quả, lý do chính để đọc bài.
Thử nghiệm C: I/O trong workflow
Cùng history 23 sự kiện, chạy với CrawlBadIO đã tắt sandbox. Fixture nhận đúng 3 request có from=workflow. Replayer không báo lỗi gì. Đây là kết quả đáng sợ nhất của lab: mã sai vẫn replay sạch, chỉ có website bên kia biết.
A dung, history day du: su kien 23 | HTTP phat sinh 0 | loi None
C I/O trong workflow, tat sandbox: su kien 23 | HTTP phat sinh 3 | loi None
tong HTTP 4 ['/page/a', '/page/a?from=workflow', '/page/b?from=workflow', '/page/c?from=workflow']
Tổng 4 gồm 1 request từ lần chạy activity thật, và 3 request từ workflow sai.
Bài học từ thử nghiệm C
Lỗi nondeterminism chỉ bắt được khi chuỗi command khác đi. Một lời gọi HTTP không sinh command, nên replay không thấy gì. Muốn phát hiện, phải có fixture đếm request, hoặc giữ sandbox bật. Với crawl chạy lâu, mỗi lần phục hồi đều bắn thêm toàn bộ request cũ, nhân với độ dài history.
Bảng thay đổi mã nguồn
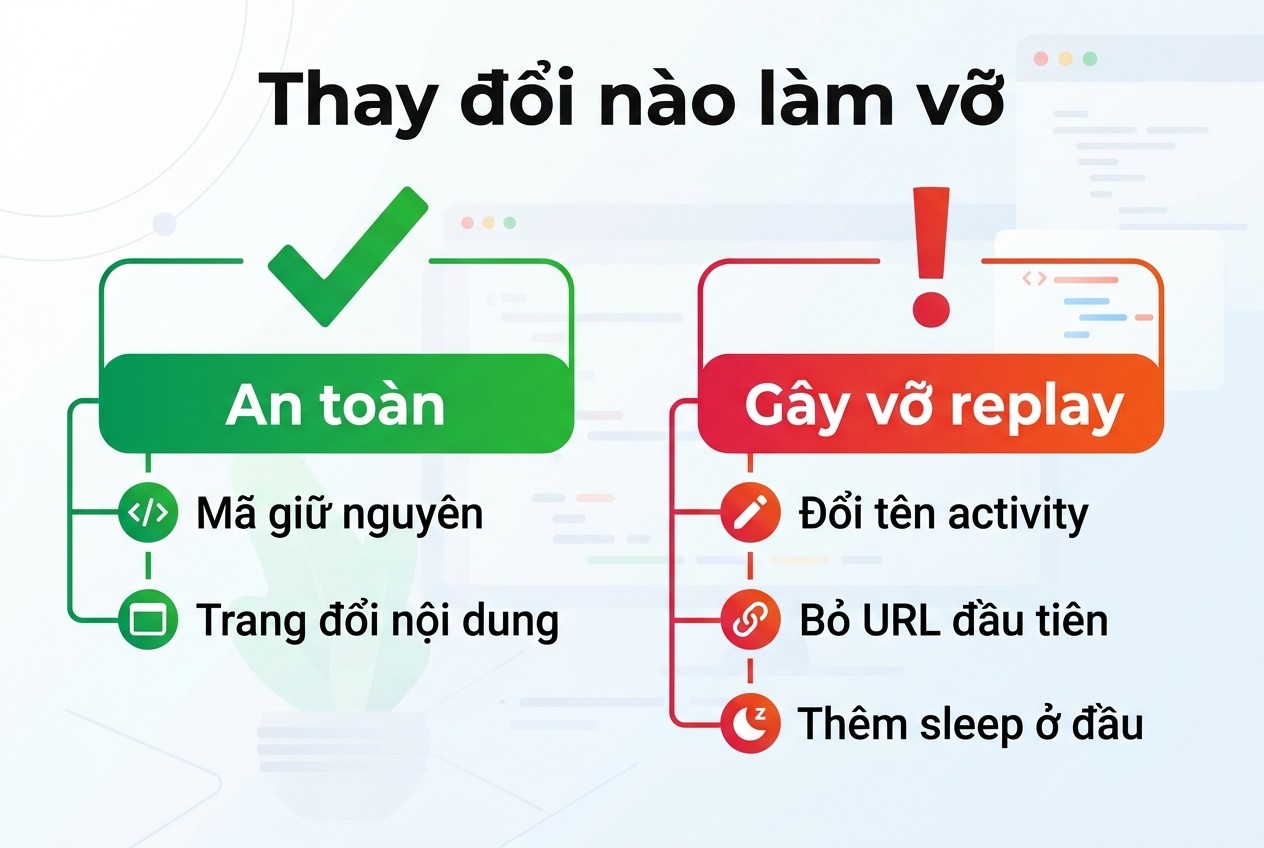
Thay đổi nào làm vỡ
Lab chạy nhiều biến thể trên cùng history. Mọi dòng dưới đây là kết quả thật của Replayer.
Thay đổi |
Kết quả replay |
Lỗi |
|---|---|---|
Mã giữ nguyên |
Sạch |
Không |
Trang đã đổi nội dung |
Sạch |
Không |
I/O trong workflow, tắt sandbox |
Sạch, phát sinh 3 HTTP |
Không |
Đảo thứ tự URL, cùng tên activity |
Sạch |
Không |
Đổi tên activity |
Vỡ |
NondeterminismError TMPRL1100 |
Đảo thứ tự kèm đổi tên |
Vỡ |
NondeterminismError TMPRL1100 |
Bỏ URL đầu tiên |
Vỡ |
NondeterminismError TMPRL1100 |
Thêm sleep ở đầu |
Vỡ |
NondeterminismError TMPRL1100 |
datetime.now trong workflow |
Vỡ |
Sandbox chặn |
socket trong workflow |
Vỡ |
Sandbox chặn |
Đảo thứ tự vẫn sạch là sao
Dòng này đáng lưu ý. Đổi thứ tự URL thì tham số activity khác, nhưng tên và mã activity giống. Tài liệu ghi rõ có thể đổi tham số đầu vào của activity mà không gây lỗi. Nhưng về nghĩa thì sai: kết quả trong history gắn với URL khác. Replay sạch không đồng nghĩa logic đúng.
Đổi tên activity
Thông báo lỗi bắt đầu bằng Activity type of scheduled event, cho biết loại activity trong sự kiện không khớp command. Đúng như tài liệu: không an toàn khi đổi loại hoặc mã của activity. Với crawl, đừng đổi tên hàm activity khi còn execution đang chạy.
Thêm sleep
Lỗi nói Timer machine không xử lý được sự kiện gặp phải. Bản mới sinh command StartTimer, trong khi history có ActivityTaskScheduled ở vị trí đó. Tài liệu đưa đúng ví dụ này, chỉ ngược chiều. Thêm một bước vào đầu workflow là thay đổi nguy hiểm nhất.
Sửa mã khi đã có execution đang chạy
Tài liệu khuyên dùng Workflow Versioning. Trong Python SDK là hàm workflow.patched. Nhánh cũ chạy cho execution cũ, nhánh mới cho execution mới.
if workflow.patched("add-delay-v2"):
    await workflow.sleep(1)
Đoạn này minh họa cách dùng, chưa chạy trong lab. Với crawl ngắn hơn một ngày, nhiều nhóm chọn cách dễ hơn: chờ execution cũ xong rồi mới triển khai.
Đưa replay vào kiểm thử
Bài học lớn nhất là biến Replayer thành test. Lưu vài history thật vào kho mã, mỗi lần sửa workflow thì replay lại. Lab chạy lệnh này không cần server. Nó chặn được nhóm lỗi đổi tên, thêm bước, bỏ bước trước khi lên môi trường chạy.
async def test_replay():
    h = WorkflowHistory.from_json("crawl-1", open("history.json").read())
    await Replayer(workflows=[CrawlGood]).replay_workflow(h)
Lab đã kiểm tra đường này: xuất history ra JSON, nạp lại, replay sạch. Tài liệu testing suite của Python SDK có mục hướng dẫn replay.
Thêm fixture đếm HTTP vào test
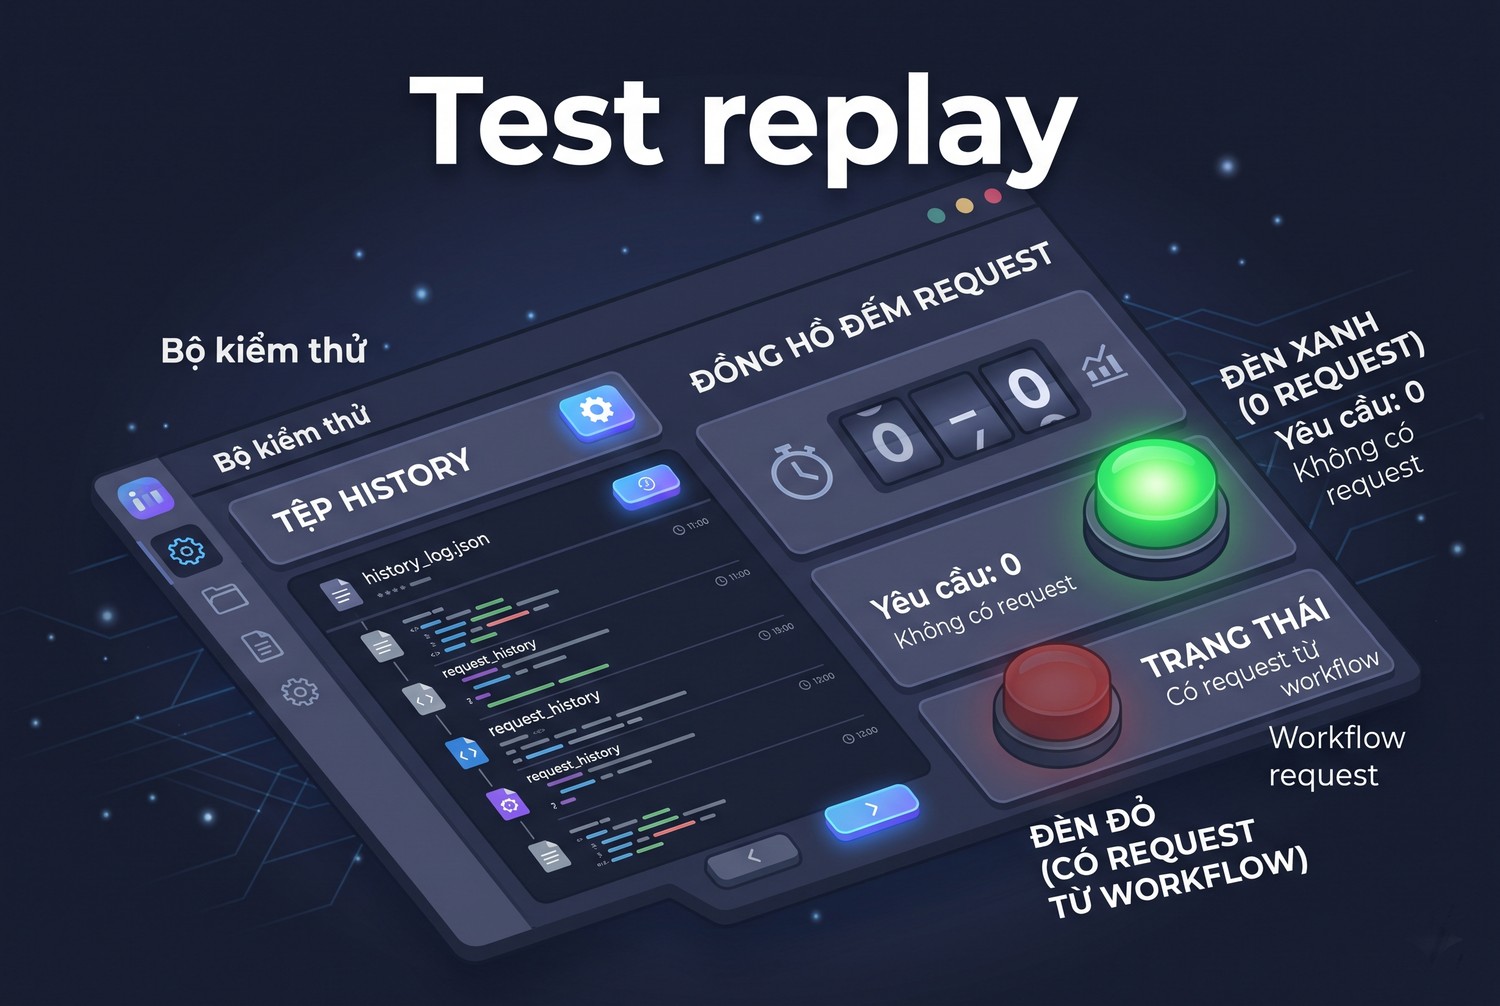
Test replay
Test replay chỉ bắt được lệch command. Để bắt lỗi kiểu C, thêm một fixture đếm request, chạy replay rồi khẳng định số request bằng 0. Một test nhỏ như vậy chặn đúng lỗi nguy hiểm nhất của crawler trên Temporal, và không tốn gì khi chạy.
Rà mã workflow bằng mắt
Trước khi merge, người review tìm trong tệp workflow các từ requests, httpx, open, time.time, datetime.now, random, uuid. Việc này mất vài phút và bắt được phần lớn lỗi. Tách tệp workflow khỏi tệp activity cũng giúp ích: tệp workflow không import thư viện mạng thì khó gọi nhầm hơn hẳn.
Đầu ra nghiệm thu của Temporal workflow cho crawl dài
Phần này gom tiêu chí và phần chưa thử.
Danh sách kiểm tra
Một workflow crawl đạt khi mọi dòng dưới đây đúng.
- Không có lời gọi mạng, đọc tệp hay giờ hệ thống trong hàm workflow.
- Sandbox của SDK vẫn bật.
- Activity tải có timeout HTTP ngắn hơn Start-To-Close Timeout.
- Kết quả activity gọn, không chứa HTML.
- Ghi kho idempotent theo khóa URL và lượt crawl.
- Có Retry Policy và lỗi không thử lại.
- Có test replay với history lưu sẵn và fixture đếm HTTP.
- Có kế hoạch cho history dài.
History dài và Continue-As-New
Crawl nhiều URL thì mỗi URL tốn nhiều sự kiện, lab đo được 6 sự kiện mỗi URL khi chạy tuần tự. Tới một ngưỡng, nên gọi Continue-As-New để bắt đầu execution mới với phần URL còn lại. Thực tế nhiều nhóm tách workflow con theo lô. Lab không chạy phần này, số liệu ngưỡng anh em xem tài liệu giới hạn của Temporal.
Song song có kiểm soát
Workflow có thể khởi chạy nhiều activity cùng lúc rồi gom kết quả. Giới hạn tốc độ thật nằm ở worker: số activity đồng thời, hoặc hàng đợi riêng cho từng host. Đừng để workflow mở hàng nghìn activity một lúc, vì website đích sẽ gánh hết.
Khi nào không nên dùng Temporal cho crawl
Không phải crawl nào cũng cần tầng này. Lượt chạy vài phút, không có bước phụ thuộc, thì một hàng đợi và vài worker là đủ. Temporal đáng dùng khi lượt crawl kéo dài nhiều giờ, có nhiều bước nối nhau, cần chờ người duyệt hay chờ một hệ thống khác. Thêm một cụm dịch vụ phải vận hành là cái giá thật, cần cân nhắc trước khi chọn.
Quan sát qua history
Khi một URL có vấn đề, history cho biết nó được gọi lúc nào, thử mấy lần, kết quả gì. Đó là lý do nên trả mã trạng thái và mã băm trong kết quả activity. Về sau anh em tra được trang nào đổi nội dung mà không cần tải lại.
Những gì lab chưa chạy
Chưa có Temporal Service. Chưa chạy worker thật, chưa có retry do service điều phối, chưa có Continue-As-New, chưa có heartbeat, chưa có patched, chưa có Web UI. History do ProxyVN dựng tay theo protobuf, chưa so với history thật từ service. Kết quả replay là thật trên history đó.
Cách tái lập trên service thật
Khi có service, chạy CrawlGood một lần với worker thật. Xuất history, đưa vào cùng script replay. Sau đó kill worker giữa chừng, đếm request ở fixture: mỗi URL chỉ nên có một request, trừ trường hợp retry. Con số lệch nghĩa là có I/O nằm sai chỗ.
Temporal workflow cho crawl dài: câu hỏi thường gặp
Các câu dưới đây gom những điểm anh em hay hỏi.
Có được gọi requests trong workflow không?
Không. Tài liệu yêu cầu mọi lời gọi ngoài đặt trong activity. Lab thấy khi tắt sandbox, mỗi lần replay đều bắn lại toàn bộ request mà không có lỗi nào báo.
Replay có tải lại trang không?
Không, nếu tải nằm trong activity. Lab đo 0 request khi replay 23 sự kiện, kể cả khi nội dung trang đã đổi.
Activity có thể chạy hai lần không?
Có. Retry khi lỗi hoặc hết giờ làm cùng activity chạy lại. Vì vậy ghi kho phải idempotent. Replay và retry là hai chuyện khác nhau.
Sửa mã workflow khi còn execution đang chạy có sao không?
Có thể vỡ. Lab bắt được NondeterminismError khi đổi tên activity, bỏ bước hoặc thêm sleep. Dùng versioning, hoặc chờ execution cũ xong.
Replay sạch có nghĩa là mã đúng không?
Không. Lab có hai ca replay sạch mà mã sai: gọi HTTP trong workflow và đảo thứ tự URL. Cần thêm test đếm HTTP và rà soát logic.
Bài có chạy trên Temporal Service thật không?
Không. Replayer và activity là thật, history dựng tay, chưa có service. Phần phục hồi qua worker và retry được viết theo tài liệu.
Temporal workflow cho crawl dài và những điều cần nhớ
Temporal workflow cho crawl dài chỉ an toàn khi mọi lời gọi mạng nằm trong activity. Lab với Replayer đo được 0 HTTP khi replay đúng, 3 HTTP khi đặt sai chỗ mà không có lỗi nào. Hãy đưa replay kèm đếm request vào test. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam sẽ chạy lại Temporal workflow cho crawl dài trên service thật.


