
Tavily API bằng Python: tìm kiếm, trích dẫn và ngân sách credit
Tavily API bằng Python là cách gọi thẳng endpoint /search của Tavily để lấy danh sách kết quả có tiêu đề, URL, đoạn trích và điểm liên quan. Các kết quả đó được lưu làm nguồn trích dẫn cho ứng dụng AI. Mỗi lần gọi tốn credit, nên bài coi ngân sách là một phần của thiết kế chứ không phải chuyện tính sau. ProxyVN chạy thử ngày 29/10/2026: gọi thật Tavily không khóa và với khóa giả để ghi nhận mã lỗi. Phần còn lại chạy trên máy chủ giả lập dựng theo đúng schema trong tài liệu, vì lab không đăng ký tài khoản.
Tavily API bằng Python: mục tiêu dữ liệu, quyền và phạm vi truy cập
Phần đầu chốt Tavily trả về gì, đầu ra cần lưu thế nào, và ranh giới với cách dùng Tavily qua framework.
Tavily là gì
Tavily là dịch vụ tìm kiếm web được thiết kế cho ứng dụng dùng mô hình ngôn ngữ. Thay vì trả trang kết quả HTML như công cụ tìm kiếm thông thường, Tavily trả JSON gồm danh sách nguồn, mỗi nguồn có đoạn nội dung đã được chọn lọc liên quan tới câu hỏi. Có tùy chọn trả thêm câu trả lời tóm tắt.
Theo tài liệu endpoint Search của Tavily, request là POST tới https://api.tavily.com/search với khóa trong header Authorization dạng Bearer và thân JSON chứa query cùng các tùy chọn.
Đầu ra mà bài này hướng tới
Đầu ra là tệp JSONL, mỗi dòng là một nguồn: câu hỏi, URL gốc, URL đã chuẩn hóa, tiêu đề, đoạn trích, điểm, thứ hạng, request_id, thời điểm gọi và credit đã tốn. Kèm theo là nhãn liên quan do người gán tay cho một mẫu kết quả.
Nhãn tay là phần nhiều người bỏ qua. Điểm score của Tavily là điểm của Tavily. Muốn biết kết quả có thật sự trả lời được câu hỏi của mình không, phải có người đọc và chấm.
Ranh giới với LangChain
Bài LangChain web search bàn việc nối công cụ tìm kiếm vào agent của LangChain, với ví dụ chính dùng Brave. Ở đó, framework quyết định khi nào gọi tìm kiếm và gọi bao nhiêu lần.
Bài này gọi Tavily trực tiếp bằng requests, không qua framework. Anh em kiểm soát từng request, từng credit, từng trường trong response. Đây là cách cần thiết khi muốn biết chính xác ngân sách đi đâu.
Ranh giới với SERP API
Bài SERP API bàn các dịch vụ trả kết quả của công cụ tìm kiếm thông thường dạng JSON, giữ thứ hạng như người dùng nhìn thấy. Tavily không cam kết thứ hạng giống bất kỳ công cụ nào. Nó chọn nguồn và đoạn trích theo cách riêng, tối ưu cho việc đưa vào mô hình ngôn ngữ.
Chọn SERP API khi cần biết trang nào đứng đầu trên một công cụ cụ thể. Chọn Tavily khi cần nguồn đọc được để mô hình trả lời câu hỏi.
Quyền và điều khoản
Dùng Tavily cần tài khoản và khóa API, kèm điều khoản của dịch vụ. Nội dung trong đoạn trích vẫn thuộc các website nguồn. Khi hiển thị cho người dùng cuối, giữ URL nguồn để họ mở trang gốc, không trình bày đoạn trích như nội dung của mình.
Lab không đăng ký tài khoản, không dùng khóa thật. Mọi số liệu về kết quả tìm kiếm trong bài đến từ máy chủ giả lập, không phải từ Tavily.
Câu hỏi gửi đi cũng là dữ liệu
Câu hỏi gửi tới Tavily đi qua máy chủ của bên thứ ba. Đừng đưa thông tin khách hàng, mã nội bộ hay dữ liệu cá nhân vào câu hỏi. Với ứng dụng nhận câu hỏi từ người dùng, lọc thông tin nhạy cảm trước khi gửi.
Ai cần gọi Tavily trực tiếp
Nhóm xây ứng dụng hỏi đáp cần nguồn trích dẫn có kiểm soát. Nhóm làm nghiên cứu cần gom nguồn cho một danh sách câu hỏi cố định. Nhóm vận hành cần biết chi phí tìm kiếm mỗi ngày.
Cả ba đều cần ba thứ: khử trùng nguồn, giữ trích dẫn, và không vượt ngân sách. Phần còn lại của bài xoay quanh ba thứ đó.
Dùng Search API Tavily với nguồn trích dẫn và ngân sách request trong Tavily API bằng Python
Phần này đi qua tham số chính, cách tính credit và khuôn response theo tài liệu.
Tham số chính của /search
query là câu hỏi. search_depth chọn mức độ tìm: advanced, basic, fast, ultra-fast. max_results đặt số nguồn tối đa, mặc định 10, trong khoảng 0 tới 20. topic chọn general, news hoặc finance. include_domains và exclude_domains giới hạn hay loại tên miền.
Các tham số còn lại gồm chunks_per_source để đặt số đoạn trích mỗi nguồn, include_answer để nhận câu trả lời tóm tắt, include_raw_content để nhận nội dung trang đầy đủ, time_range và các mốc ngày để giới hạn thời gian. include_usage bằng true thêm trường usage vào response.
Topic news và mốc thời gian
topic bằng news dành cho tin tức thời sự, kèm time_range hoặc start_date và end_date để giới hạn khoảng thời gian. Với câu hỏi về sự kiện mới, thiếu bộ lọc thời gian dễ nhận nguồn cũ có điểm cao.
Ghi rõ khoảng thời gian vào mỗi dòng kết quả. Khi so hai lần chạy cùng câu hỏi tin tức cách nhau một tuần, khác biệt nguồn là bình thường, không phải lỗi.
Câu trả lời tóm tắt có cần không
include_answer cho Tavily tự viết một câu trả lời từ các nguồn. Tiện cho prototype, nhưng ứng dụng đã có mô hình ngôn ngữ riêng thường không cần. Câu trả lời của Tavily khó kiểm soát giọng văn và khó trích dẫn từng ý về đúng nguồn.
Với pipeline có mô hình riêng, lấy nguồn và đoạn trích từ Tavily, để mô hình của mình viết câu trả lời với trích dẫn rõ ràng. Lab không bật include_answer.
Cách tính credit
basic 1, advanced 2
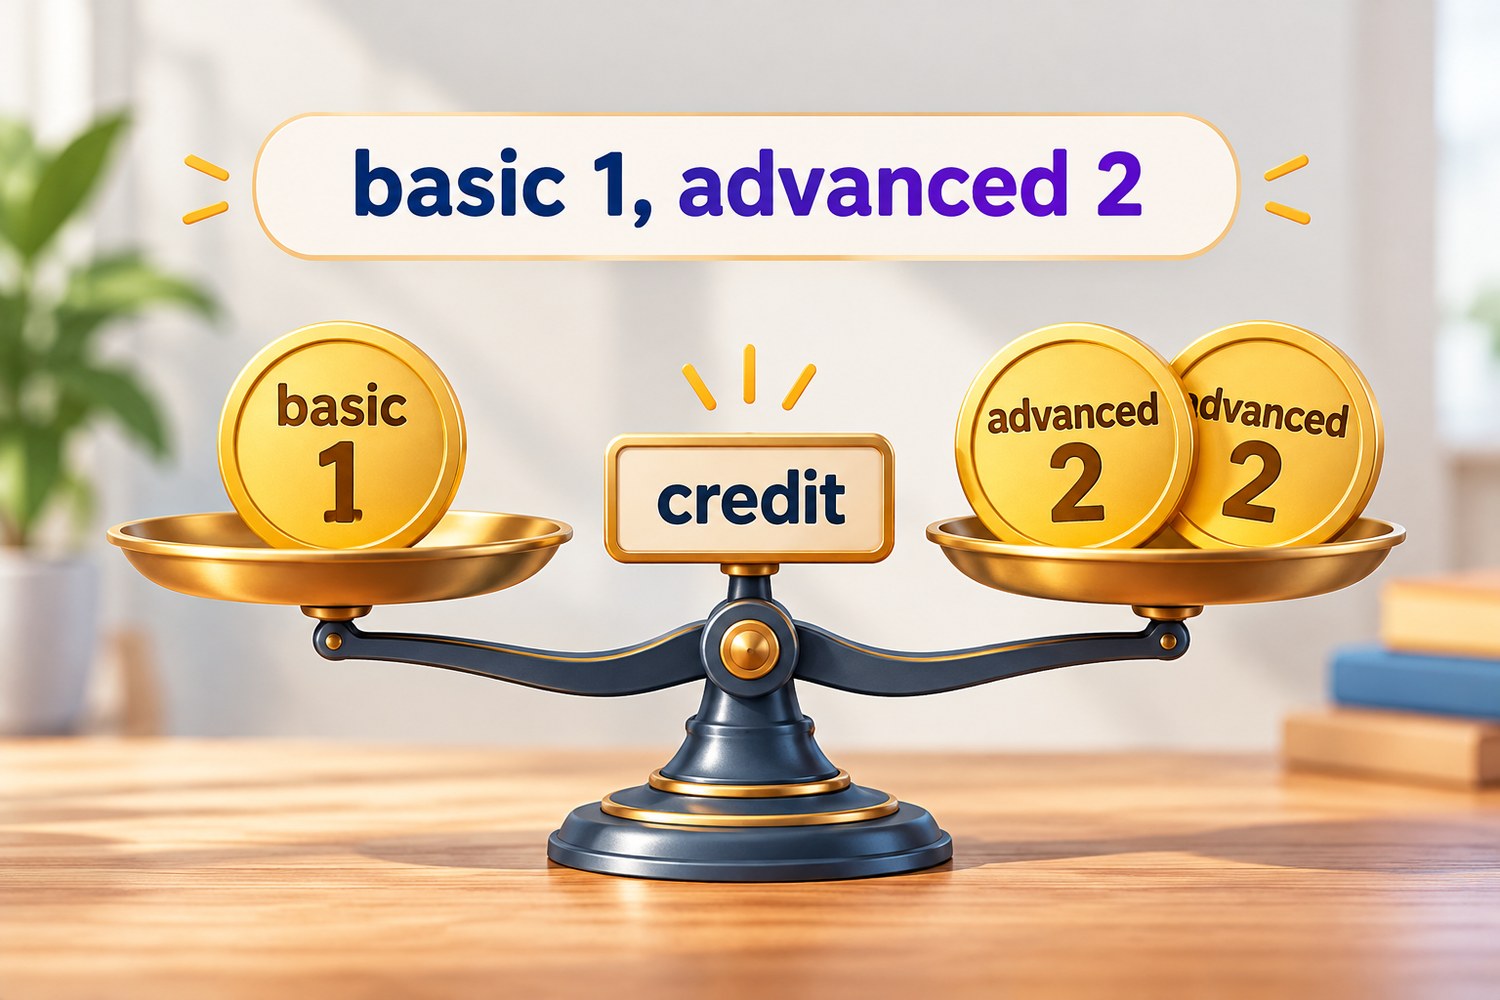
Tài liệu ghi rõ chi phí theo search_depth. basic, fast và ultra-fast tốn 1 credit mỗi request. advanced tốn 2 credit. Đây là con số quan trọng nhất cho ngân sách: chạy toàn bộ bằng advanced là gấp đôi chi phí.
Với include_usage, response có usage.credits cho biết request vừa rồi tốn bao nhiêu. Dùng con số này để cộng dồn, không tự tính theo bảng, vì chính sách có thể đổi.
Đoạn trích theo chunks
Tài liệu mô tả chunks là đoạn nội dung ngắn lấy thẳng từ nguồn, khoảng 500 ký tự với basic và fast, khoảng 800 ký tự với advanced. chunks_per_source mặc định 3. Các chunk nằm trong trường content, cách nhau bằng dấu ba chấm trong ngoặc vuông.
Chunk liền nhau có thể được nối thành đoạn dài hơn, nên độ dài là mục tiêu chứ không phải giới hạn cứng. Khi tính số token đưa vào mô hình, đo trên content thật thay vì nhân số chunk với 500.
Khuôn response
Response có query, answer, images, results, response_time, usage nếu yêu cầu, và request_id. Mỗi phần tử của results có title, url, content, score, raw_content, và tùy chọn published_date, favicon, images.
request_id là mã của request phía Tavily. Lưu nó cạnh mỗi kết quả. Khi cần hỏi hỗ trợ về một kết quả lạ, mã này là thứ đầu tiên họ cần.
Khung code gọi trực tiếp
import os, requests
H = {"Authorization": f"Bearer {os.environ['TAVILY_API_KEY']}",
     "Content-Type": "application/json"}
def tavily(q, depth="basic", **kw):
    body = {"query": q, "search_depth": depth, "include_usage": True, **kw}
    r = requests.post("https://api.tavily.com/search", headers=H,
                      json=body, timeout=30)
    return r.status_code, r.json()
code, j = tavily("proxy https connect", max_results=10)
for i, it in enumerate(j.get("results", []), 1):
    print(i, it["score"], it["url"])
print(j.get("usage"), j.get("request_id"))
Khóa đọc từ biến môi trường. Hàm trả cả mã trạng thái và JSON, để code phía sau xử lý lỗi theo mã chứ không chỉ dựa vào việc có results hay không.
SDK chính thức
Tavily có SDK Python tavily-python với lớp TavilyClient và hàm search. SDK tiện cho ví dụ ngắn. Gọi bằng requests như trên cho thấy rõ từng trường, dễ cộng credit và dễ chèn proxy. Chọn một cách và dùng thống nhất.
Kết quả gọi thật không có khóa hợp lệ
Request |
Mã |
Giây |
Thân response |
|---|---|---|---|
Không có header Authorization |
401 |
26,62 |
Unauthorized: missing or invalid API key |
Khóa giả tvly-khoa-gia-lab-000 |
401 |
2,22 |
Unauthorized: missing or invalid API key |
Khóa giả, query là mảng rỗng |
422 |
2,02 |
Input should be a valid string |
Lần gọi đầu mất 26,62 giây, các lần sau khoảng 2 giây. Lab không biết lý do lần đầu chậm, có thể do bước thiết lập kết nối hay phân giải DNS. Đặt timeout phía client đủ rộng để không cắt nhầm những lần như vậy. Đáng chú ý là request có thân sai trả 422 trước cả bước kiểm khóa: máy chủ kiểm khuôn dữ liệu trước, xác thực sau.
Chuẩn bị truy vấn, khóa và phiên bản API khi dùng Tavily API bằng Python
Phần này gom các quyết định trước khi chạy: khóa, bộ câu hỏi, độ sâu, bộ lọc tên miền và máy chủ giả lập.
Giữ khóa ngoài code
Khóa Tavily bắt đầu bằng tvly-. Đọc từ biến môi trường hoặc kho bí mật, không ghi vào code, không in ra log. Khi in cấu hình để gỡ lỗi, che khóa. Khóa lộ là người khác tiêu credit của anh em.
Bộ câu hỏi cố định
Viết bộ câu hỏi ra tệp, mỗi câu một dòng, có mã câu hỏi. Chạy cùng bộ câu hỏi trong các lần khác nhau cho phép so sánh kết quả theo thời gian và so sánh các cấu hình search_depth. Câu hỏi sinh ngẫu nhiên trong lúc chạy thì không so sánh được.
Chọn độ sâu theo câu hỏi
Không phải câu hỏi nào cũng cần advanced. Câu hỏi định nghĩa ngắn dùng basic là đủ. Câu hỏi kỹ thuật cần độ chính xác cao mới dùng advanced. Phân loại câu hỏi trước, rồi gán độ sâu, thay vì đặt advanced cho tất cả.
Với ngân sách cố định, mỗi câu advanced bằng hai câu basic. Ghi rõ lý do chọn advanced cho từng nhóm câu hỏi.
Bộ lọc tên miền
include_domains tối đa 300 tên miền, exclude_domains tối đa 150, theo tài liệu. include_domains_mode bằng restrict chỉ trả kết quả trong danh sách, bằng prefer thì ưu tiên nhưng vẫn cho kết quả ngoài danh sách.
Với câu hỏi kỹ thuật, giới hạn vào tài liệu chính thức giúp nguồn đáng tin hơn. Với câu hỏi tin tức, loại trang bán hàng và trang video giúp đoạn trích có nội dung hơn.
Máy chủ giả lập theo schema
Vì không có khóa thật, lab dựng máy chủ HTTP cục bộ ở cổng 9790, nhận POST /search theo đúng khuôn tài liệu. Máy chủ kiểm Authorization, trả 422 khi query không phải chuỗi, 401 khi khóa sai, 429 khi quá năm request trong hai giây, 432 khi vượt hạn mức credit.
Kho tài liệu của máy chủ là 12 trang giả lập trên các tên miền example, trong đó cố ý có bản trùng khác nhau ở tham số utm_source và ở mảnh neo. Điểm score do máy chủ tự tính theo số từ khớp, không phải thuật toán của Tavily.
Phiên bản và môi trường
Python 3.12.10, requests 2.34.2. Tavily không có số phiên bản trên URL. Ghi ngày đọc tài liệu và danh sách tham số đã dùng vào cấu hình. Khi tài liệu đổi tham số, cập nhật một chỗ.
Thu dữ liệu và trạng thái hạn mức theo đúng nguồn với Tavily API bằng Python
Phần này ghi kết quả chạy trên máy chủ giả lập: một truy vấn, bộ lọc tên miền, ngân sách và hạn mức.
Một truy vấn, mười nguồn
Nguồn trùng URL
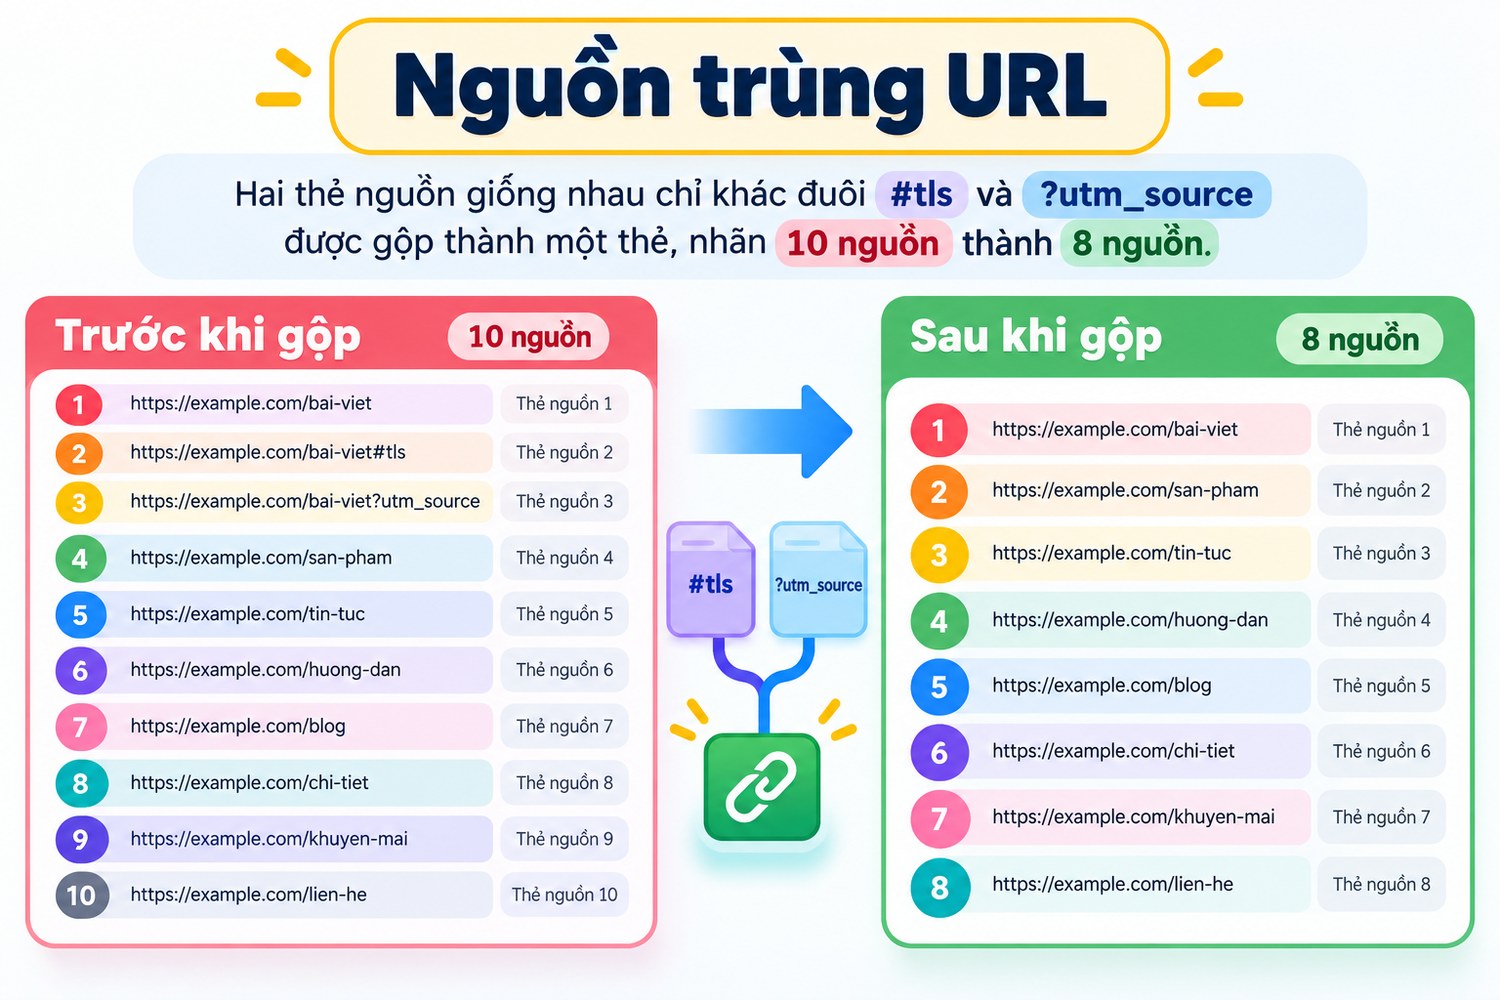
Câu hỏi proxy https connect với max_results bằng 10 trả 10 nguồn. Hai nguồn đầu có cùng điểm 0,75: trang http-connect và cùng trang đó với mảnh neo tls. Tám nguồn còn lại có điểm 0,45, gồm cả hai bản của trang proxy-la-gi, một bản có utm_source.
Sau khi chuẩn hóa URL bằng cách bỏ mảnh neo, bỏ tham số utm, viết thường tên máy, mười nguồn còn tám nguồn khác nhau.
Hàm chuẩn hóa URL
from urllib.parse import urlsplit, urlunsplit, parse_qsl, urlencode
def norm(u):
    p = urlsplit(u)
    q = [(k, v) for k, v in parse_qsl(p.query) if not k.startswith("utm_")]
    return urlunsplit((p.scheme, p.netloc.lower(),
                       p.path.rstrip("/") or "/", urlencode(q), ""))
Hàm giữ tham số có nghĩa như v trong URL video, chỉ bỏ tham số theo dõi. Quy tắc này phải điều chỉnh theo nguồn: một số trang dùng tham số để chọn nội dung, bỏ đi là thành trang khác.
Bộ lọc tên miền trên máy chủ giả lập
Câu hỏi proxy |
Số nguồn |
|---|---|
Không lọc |
10 |
include_domains docs.example.org |
5 |
exclude_domains video và shop |
9 |
Với include, mọi nguồn trả về đều thuộc docs.example.org. Với exclude, nguồn video bị loại. Trang shop không khớp câu hỏi proxy nên vốn không có trong 10 nguồn ban đầu.
Bộ chặn ngân sách phía client
Lab đặt ngân sách 10 credit cho cả lượt chạy. Bốn câu basic đầu tốn 4 credit. Tiếp theo là sáu câu advanced. Ba câu đầu chạy, tốn 6 credit, tổng 10. Ba câu sau bị bộ chặn bỏ qua trước khi gửi request, ghi lý do là hết ngân sách.
Máy chủ giả lập ghi tổng 10 credit, khớp con số client tự cộng từ usage.credits. Không request nào bị gửi rồi mới bị từ chối.
Khi không có bộ chặn
Lab đặt bộ đếm của máy chủ ở 11 trên hạn mức 12, rồi gửi một câu advanced cần 2 credit. Máy chủ trả 432 với thông báo vượt hạn mức gói. Theo tài liệu, 432 là mã lỗi riêng của Tavily cho vượt hạn mức, 433 cho vượt giới hạn trả theo dùng.
Dựa vào 432 từ máy chủ để dừng là cách thô. Job đã gửi request, đã mất thời gian chờ, và có thể đã chạy dở một nhóm câu hỏi. Bộ chặn phía client dừng sớm hơn và sạch hơn.
Hạn mức tần suất và 429
Lab gửi liên tiếp 8 request basic. Máy chủ giả lập giới hạn năm request trong hai giây. Request thứ sáu nhận 429, client chờ và thử lại, thành công ở lần thử thứ ba. Các request còn lại thành công ngay.
Ngưỡng năm request trong hai giây là của máy chủ giả lập. Tavily có giới hạn tần suất riêng theo gói. Đọc tài liệu về giới hạn của gói đang dùng và đặt nhịp gửi thấp hơn.
Không có phân trang
/search không có tham số trang. max_results tối đa 20 là tất cả những gì một request trả về. Muốn nhiều nguồn hơn, đổi cách đặt câu hỏi hoặc dùng bộ lọc tên miền khác, mỗi cách là một request và một khoản credit.
Đối soát ID, kiểu dữ liệu, giá trị thiếu và xuất xứ từng kết quả Tavily API bằng Python
Phần này bàn cách chấm liên quan bằng tay và những trường cần kiểm.
Nhãn tay cho câu hỏi đầu
Câu hỏi proxy https connect có ý định rõ: tìm tài liệu giải thích phương thức CONNECT khi đi qua proxy HTTPS. Lab gán nhãn liên quan bằng 1 cho trang http-connect, bằng 0 cho các trang còn lại, vì chúng nói về SOCKS5, NO_PROXY, PAC, lỗi 407 hay giới thiệu chung.
Nhãn do người viết bài gán trên dữ liệu giả lập. Mục đích là cho thấy cách chấm, không phải đánh giá chất lượng Tavily.
Trùng URL làm đẹp số liệu
0,67 thành 0,33
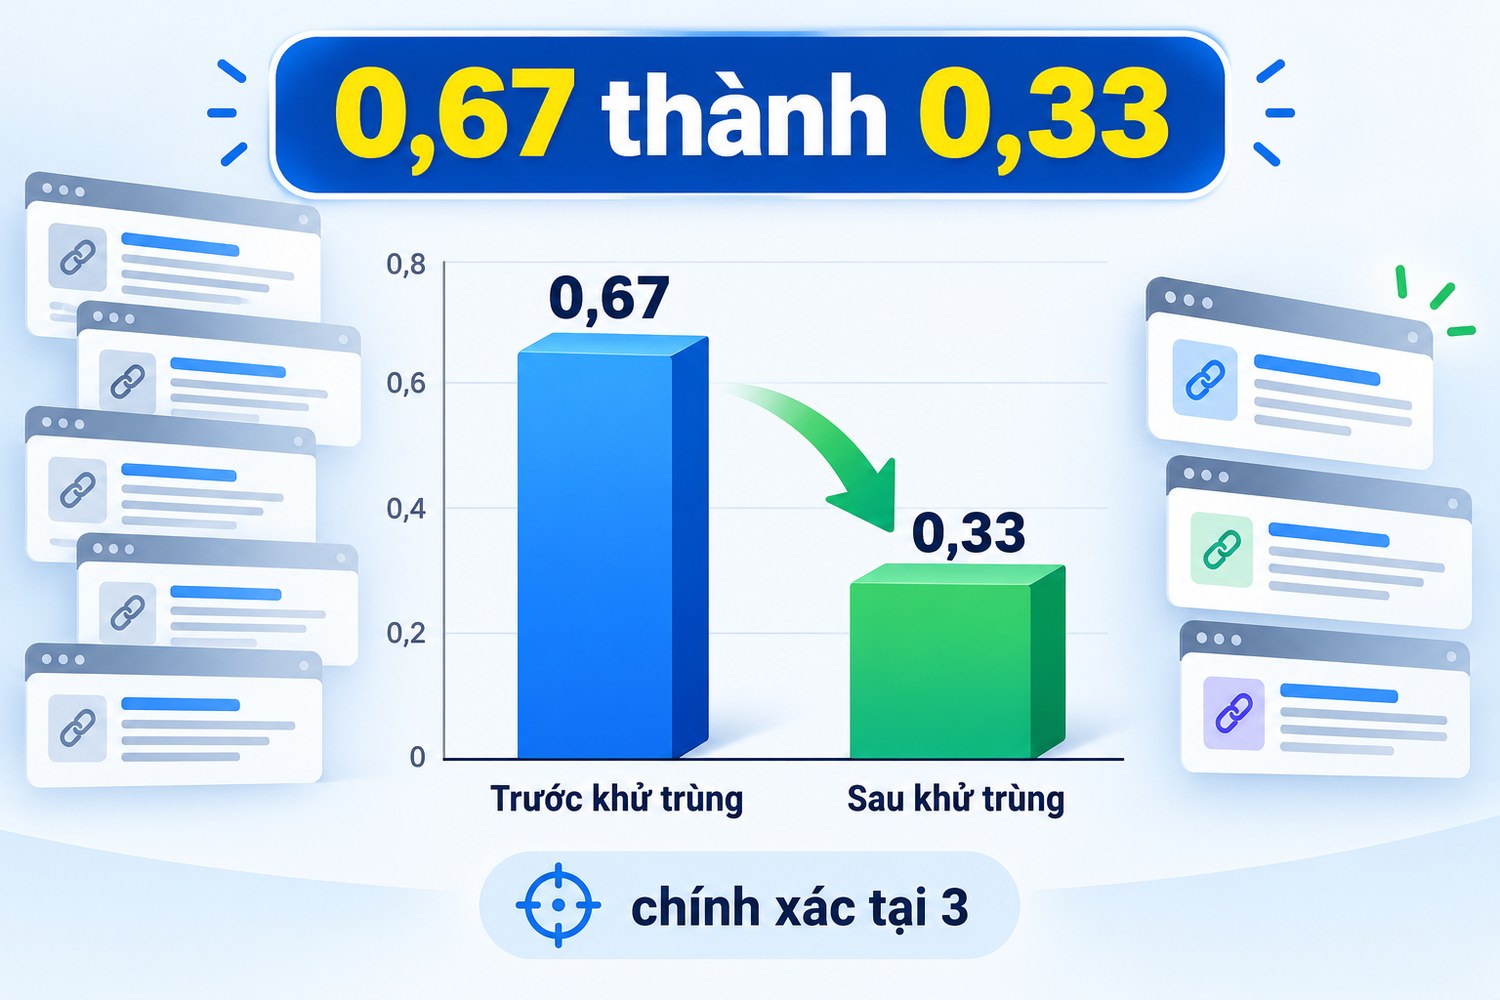
Trên danh sách gốc, ba nguồn đầu có hai nguồn liên quan, tỷ lệ chính xác tại 3 là 0,67. Nhưng hai nguồn đó là cùng một trang, khác mảnh neo. Sau khi khử trùng, ba nguồn đầu là http-connect, socks5, proxy-la-gi, chỉ một nguồn liên quan, tỷ lệ còn 0,33.
Đánh giá trên danh sách chưa khử trùng cho con số gấp đôi thực tế. Luôn khử trùng trước khi chấm, và trước khi đưa nguồn vào mô hình.
Điểm score không so được giữa các câu hỏi
score là điểm liên quan trong một response. Điểm 0,75 ở câu hỏi này không có nghĩa tốt hơn điểm 0,6 ở câu hỏi khác. Dùng score để sắp thứ tự trong một danh sách, không dùng làm ngưỡng cố định cho mọi câu hỏi.
Với máy chủ giả lập, score là số từ khớp. Với Tavily thật, score do thuật toán của họ tính. Cả hai trường hợp đều không nên đặt một ngưỡng chung mà không kiểm trên mẫu nhãn tay.
Trường có thể thiếu
answer là null khi không bật include_answer. raw_content là null khi không bật include_raw_content. published_date chỉ có với một số nguồn và một số cấu hình. usage chỉ có khi bật include_usage.
Ghi null thay vì chuỗi rỗng, và đếm tỷ lệ có giá trị cho từng trường. Ứng dụng hiển thị ngày đăng phải chịu được nguồn không có ngày.
Giữ xuất xứ cho từng nguồn
Mỗi dòng JSONL giữ câu hỏi, request_id, thời điểm, search_depth, tham số lọc, thứ hạng gốc, URL gốc, URL chuẩn hóa và credit. Khi mô hình trả lời dựa trên một đoạn trích, ứng dụng tra ngược được đoạn đó đến từ request nào, nguồn nào.
Bài JSON và CSV khi crawl dữ liệu bàn vì sao JSONL hợp với loại dữ liệu này.
Kiểm nguồn trước khi trích dẫn
Đoạn trích là phần Tavily chọn từ trang. Trước khi hiển thị trích dẫn cho người dùng cuối, có thể gửi HEAD tới URL nguồn để chắc trang còn tồn tại. Trang đã đổi nội dung thì đoạn trích có thể không còn trên trang, nên ghi rõ thời điểm lấy.
Lưu kết quả, giới hạn request và khi nào Tavily API bằng Python cần proxy
Phần cuối bàn chuyện cache, nhịp gọi và vị trí của proxy khi dịch vụ tìm kiếm đứng giữa.
Cache theo câu hỏi và cấu hình
Khóa cache là câu hỏi cùng toàn bộ tham số: search_depth, max_results, bộ lọc tên miền, topic. Cùng câu hỏi, cùng tham số trong vòng một ngày thì dùng lại kết quả. Mỗi lần dùng cache là một credit không phải tiêu.
Với câu hỏi tin tức, đặt thời hạn cache ngắn. Với câu hỏi định nghĩa kỹ thuật, thời hạn có thể là một tuần.
Ngân sách theo ngày và theo job
Đặt hai tầng ngân sách: hạn mức tổng mỗi ngày cho cả tổ chức, và hạn mức riêng cho từng job. Job vượt hạn mức riêng thì dừng, không ăn vào phần của job khác. Bài rate limit API khi dùng proxy có mẫu bộ đếm có thể dùng chung.
Ước lượng chi phí trước khi chạy
Với bộ câu hỏi cố định, chi phí ước lượng là số câu basic cộng hai lần số câu advanced. Một bộ 200 câu, trong đó 50 câu advanced, tốn 250 credit mỗi lượt chạy. Chạy hằng ngày trong một tháng là khoảng 7.500 credit, chưa tính cache.
Đặt con số này cạnh hạn mức gói trước khi lên lịch job. Phát hiện job vượt gói khi đang chạy tức là đã muộn.
Xử lý mã lỗi
401 là khóa sai hoặc thiếu, dừng ngay và báo người vận hành. 422 là thân request sai, sửa code. 429 là quá nhanh, chờ và thử lại với nhịp chậm hơn. 432 và 433 là vượt hạn mức, dừng job. 500 là lỗi phía Tavily, thử lại sau.
Không thử lại mù quáng với mọi mã lỗi. Thử lại 401 hay 422 chỉ tốn thời gian.
Proxy trong lab kiểm ở đâu
Lab gửi một câu hỏi tới máy chủ giả lập qua proxy HTTP có xác thực cục bộ. Kết quả 200 với 10 nguồn, giống gọi thẳng. Log proxy ghi POST tới http://127.0.0.1:9790/search, vì máy chủ giả lập chạy HTTP thường nên proxy thấy cả đường dẫn.
Với Tavily thật qua HTTPS, proxy chỉ thấy CONNECT tới api.tavily.com cổng 443. Khóa trong header Authorization và câu hỏi trong thân request nằm trong kênh mã hóa.
Proxy không đổi nguồn Tavily tìm thấy
Tavily tự tìm và tự tải nguồn từ hạ tầng của họ. IP của proxy anh em dùng không ảnh hưởng tới kết quả. Dùng proxy Việt Nam không làm Tavily trả nguồn tiếng Việt, tham số ngôn ngữ và quốc gia trong request mới làm việc đó.
Proxy cũng không tăng hạn mức. Hạn mức gắn với khóa, không gắn với IP. Đổi IP không giúp vượt 429 hay 432.
Khi nào cần proxy thật
Proxy cần khi máy chạy ứng dụng nằm trong mạng nội bộ chỉ được ra Internet qua proxy. Trường hợp thứ hai là tổ chức yêu cầu mọi lưu lượng tới dịch vụ AI bên ngoài đi qua một IP cố định để giám sát và ghi log. Cấu hình và mã hóa mật khẩu có ký tự đặc biệt có trong bài định dạng proxy.
Bài Web Scraping proxy là gì phân biệt các vai trò của proxy. Bài proxy cho AI agent tự động bàn trường hợp agent vừa gọi dịch vụ tìm kiếm vừa tự tải trang.
Khi máy chủ của nhóm đặt tại Việt Nam và cần IP thoát ổn định cho các dịch vụ AI bên ngoài, proxy tĩnh dễ quản lý hơn proxy xoay. ProxyVN có proxy dân cư tĩnh, datacenter, 4G và proxy xoay qua HTTP hoặc SOCKS5. Anh em có thể mua proxy Việt Nam tại trang chủ ProxyVN rồi khai báo vào requests theo tham số proxies.
Giới hạn suy luận của bài
Lab chỉ gọi Tavily thật ba lần ngày 29/10/2026, không có khóa hợp lệ, để ghi mã 401 và 422. Mọi số liệu về nguồn, điểm, bộ lọc, ngân sách, 429 và 432 đến từ máy chủ giả lập tự viết theo schema tài liệu, với 12 trang giả lập. Điểm score của máy chủ giả lập không phản ánh thuật toán của Tavily.
Lab không có tài khoản, không thử include_answer hay include_raw_content với dữ liệu thật, không đo độ trễ thật của các mức search_depth, không thử proxy thương mại.
Checklist Tavily API bằng Python
Checklist Tavily API
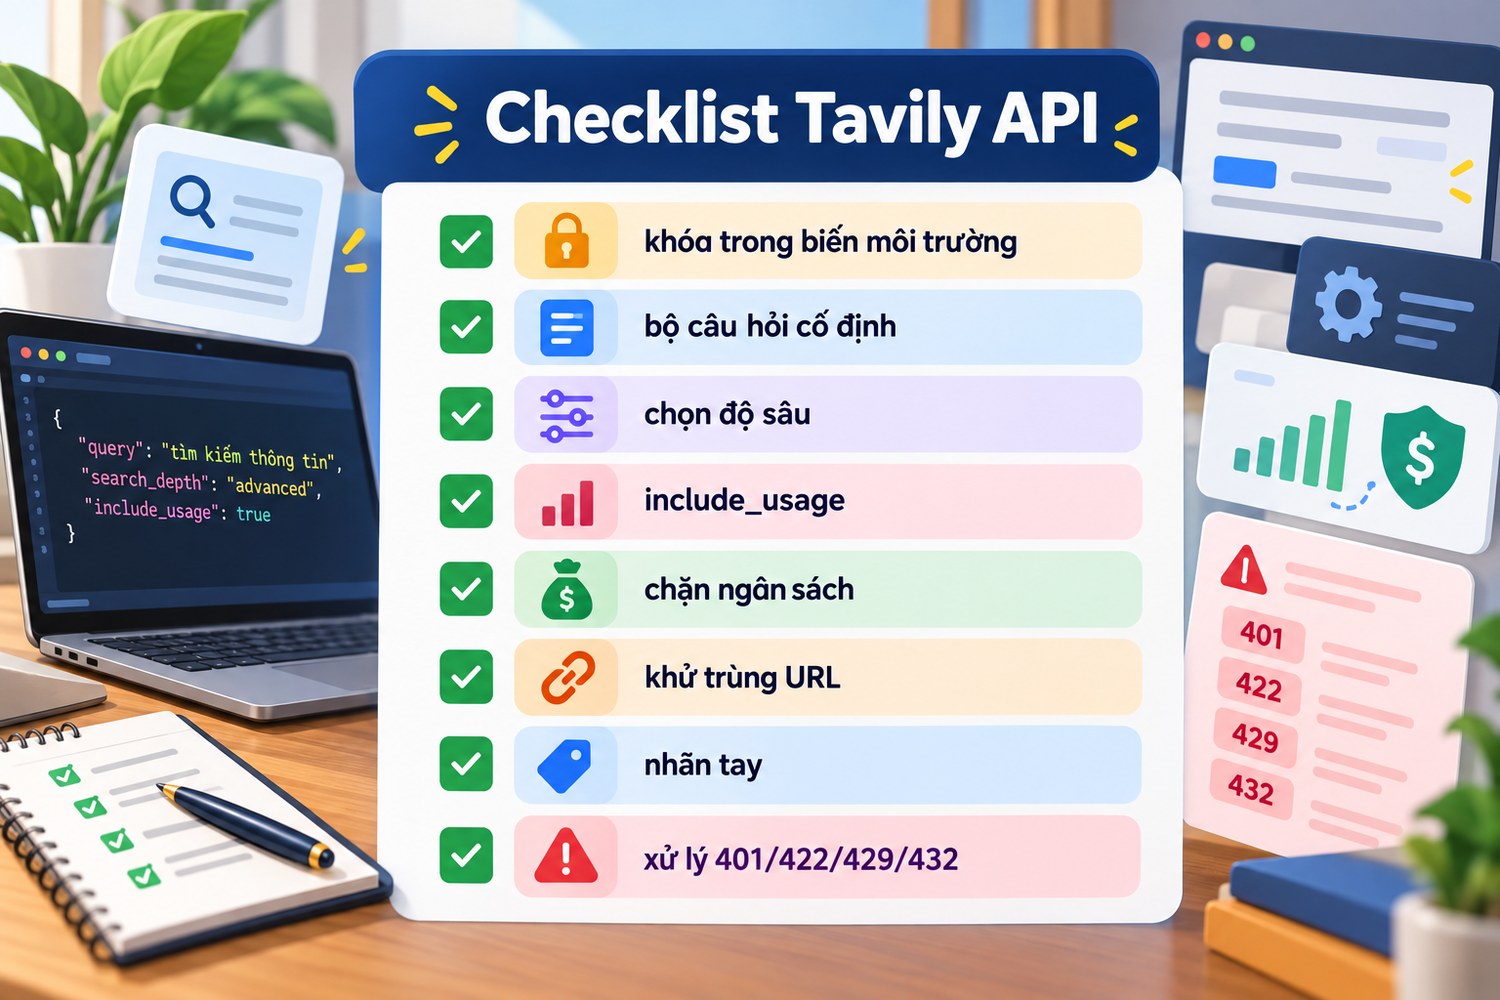
- Giữ khóa trong biến môi trường, che khi in log.
- Viết bộ câu hỏi cố định có mã.
- Chọn search_depth theo nhóm câu hỏi, advanced tốn 2 credit.
- Bật include_usage, cộng credit từ response.
- Chặn ngân sách phía client trước khi gửi.
- Chuẩn hóa và khử trùng URL trước khi chấm hay trích dẫn.
- Chấm liên quan bằng nhãn tay trên mẫu.
- Xử lý 401, 422, 429, 432 theo từng mã.
Câu hỏi thường gặp về Tavily API bằng Python
Một request Tavily tốn bao nhiêu credit?
Theo tài liệu, basic, fast và ultra-fast tốn 1 credit, advanced tốn 2 credit.
Tavily có phân trang không?
Không. Một request trả tối đa 20 nguồn theo max_results.
Vì sao số liệu chính xác trông cao bất thường?
Có thể do nguồn trùng khác mảnh neo hay tham số utm. Lab thấy tỷ lệ chính xác tại 3 từ 0,67 còn 0,33 sau khi khử trùng.
Mã 432 nghĩa là gì?
Vượt hạn mức sử dụng của gói theo tài liệu Tavily. Dừng job, không thử lại.
Dùng proxy có tăng hạn mức Tavily không?
Không. Hạn mức gắn với khóa API, không gắn với IP.
Gọi trực tiếp khác dùng qua LangChain thế nào?
Gọi trực tiếp cho anh em kiểm soát từng request và credit. LangChain để agent quyết định khi nào gọi.
Tavily API bằng Python và những điều cần nhớ
Tavily API bằng Python cho anh em nguồn trích dẫn có đoạn trích sẵn, đổi lại mỗi request là một khoản credit cần quản lý. Lab ngày 29/10/2026 ghi mã 401 và 422 từ Tavily thật, rồi trên máy chủ giả lập cho thấy bộ chặn ngân sách dừng đúng 10 credit và nguồn trùng làm số liệu chính xác cao gấp đôi. Khử trùng, chấm tay, cộng credit từ response. Cần IP thoát cố định cho máy chủ gọi Tavily API bằng Python, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


