
Search Console API bằng Python: Search Analytics theo property
Search Console API bằng Python là cách lấy số lượt nhấp, lượt hiển thị, CTR và vị trí trung bình của một website theo truy vấn, trang và ngày, thay cho việc xuất file thủ công từ giao diện. API chỉ trả dữ liệu của property mà tài khoản được cấp quyền, và không có cách nào dùng proxy để xem số liệu của website khác hay đổi quốc gia trong báo cáo. ProxyVN đã gọi thật điểm cuối Search Console không kèm khóa ngày 29/10/2026 để ghi mã lỗi, rồi dựng server giả lập theo tài liệu chính thức để chạy phân trang và xuất CSV.
Search Console API bằng Python: mục tiêu dữ liệu, quyền và phạm vi truy cập
Trước khi viết code, anh em cần chốt property nào, khoảng ngày nào, những chiều nào và loại tìm kiếm nào. Mỗi lựa chọn này thay đổi số dòng trả về và cả ý nghĩa của các con số.
Search Analytics là gì
Search Analytics là phần dữ liệu hiệu suất trong Search Console: một truy vấn tìm kiếm, một trang, một ngày, một quốc gia, một thiết bị thì có bao nhiêu lượt hiển thị và lượt nhấp. Đây là dữ liệu Google đo từ phía người tìm kiếm thật, không phải dữ liệu mô phỏng.
Trang API Reference của Search Console liệt kê các nhóm tài nguyên: searchanalytics, sitemaps, sites và urlInspection. Bài này chỉ dùng searchanalytics.query, thao tác chỉ đọc.
Quyền đi theo property
API chỉ trả dữ liệu cho property mà tài khoản được thêm vào với quyền phù hợp. Property có thể là tiền tố URL như https://example.com/ hoặc property miền dạng sc-domain:example.com. Hai loại có cách viết siteUrl khác nhau trong đường dẫn API.
Không có quyền thì không có dữ liệu. Không có điểm cuối công khai nào cho phép xem số liệu của website người khác. Đây là điểm khác cơ bản với việc theo dõi thứ hạng bằng cách tra kết quả tìm kiếm.
Search Console API đọc dữ liệu của website mình quản lý, không phải công cụ dò số liệu đối thủ.
Proxy không đổi quốc gia trong báo cáo
Chiều country trong Search Analytics là quốc gia của người tìm kiếm, do Google ghi nhận lúc họ tìm. Gọi API từ Việt Nam hay qua proxy ở Mỹ, báo cáo vẫn trả cùng số liệu theo quốc gia của người tìm kiếm.
Lab gọi điểm cuối /sites qua proxy cục bộ và nhận đúng phản hồi như khi gọi trực tiếp. IP người gọi API không phải một chiều dữ liệu và không lọc dữ liệu.
Khác theo dõi SERP qua proxy
Bài proxy cho SERP tracking nói về việc tra kết quả tìm kiếm từ nhiều vị trí để xem thứ hạng hiển thị. Đó là dữ liệu từ phía trang kết quả. Search Analytics là dữ liệu từ phía Google về chính website của anh em.
Hai nguồn trả lời hai câu hỏi khác nhau. SERP tracking cho biết người ở Hà Nội thấy trang mình ở vị trí nào lúc kiểm tra. Search Analytics cho biết trong cả tuần, trang mình được hiển thị bao nhiêu lần và vị trí trung bình bao nhiêu.
Phần chạy thật và phần giả lập
Lab không dùng tài khoản hay khóa Search Console thật nào. Phần chạy thật là các request tới searchconsole.googleapis.com không xác thực, với token giả và với khóa API giả, để ghi mã trạng thái và thông báo lỗi.
Phân trang, chiều dữ liệu, xuất CSV, lỗi 403 và 429 chạy trên server giả lập ở cổng 9750, dựng theo mô tả trong tài liệu chính thức. Dữ liệu giả lập là số ngẫu nhiên có hạt giống cố định, không phải số liệu của website nào.
Đầu ra của bài này
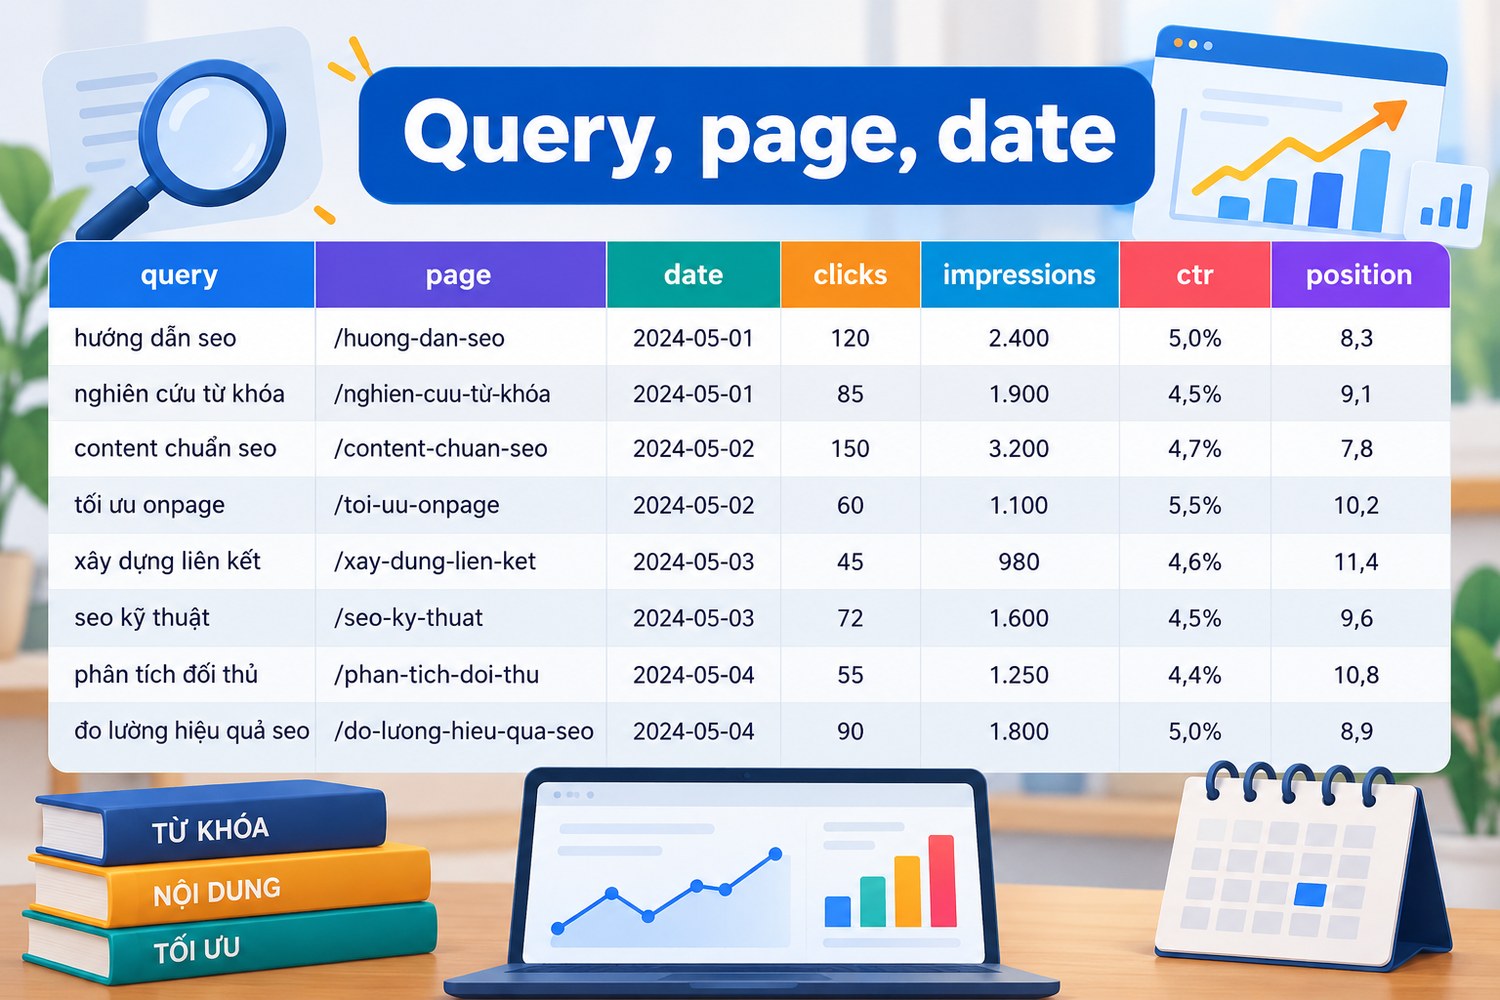
Bài hướng tới ba đầu ra. Thứ nhất là một truy vấn chỉ đọc cho property lab. Thứ hai là file CSV với các cột query, page, date, clicks, impressions, ctr và position. Thứ ba là phần ghi nhận các giới hạn dữ liệu cần nói rõ khi trình bày báo cáo.
Search Console API bằng Python: lấy Search Analytics cho property được cấp quyền, hiểu dimensions và giới hạn kết quả
Phần này giải thích thân request, các chiều dữ liệu và những giới hạn mà tài liệu ghi rõ.
Thân request
Trang searchanalytics.query mô tả thân request gồm startDate, endDate, dimensions, type, dimensionFilterGroups, aggregationType, rowLimit, startRow và dataState. Chỉ startDate và endDate là bắt buộc.
Ngày viết dạng YYYY-MM-DD theo giờ Thái Bình Dương, tức UTC trừ 7 hoặc 8 tiếng. Một ngày trong báo cáo không trùng với một ngày theo giờ Việt Nam. Khi đối chiếu với dữ liệu khác theo giờ Việt Nam, cần ghi rõ lệch múi giờ này.
Chiều dữ liệu
Các chiều thường dùng là query, page, date, country và device. Mỗi chiều thêm vào làm số dòng tăng lên, vì mỗi tổ hợp giá trị là một dòng. Lab chọn ba chiều query, page và date.
Thứ tự trong mảng dimensions quyết định thứ tự trong mảng keys của mỗi dòng trả về. Dòng có keys gồm truy vấn, trang, ngày theo đúng thứ tự đã gửi. Code đọc keys phải dùng cùng thứ tự.
rowLimit và startRow
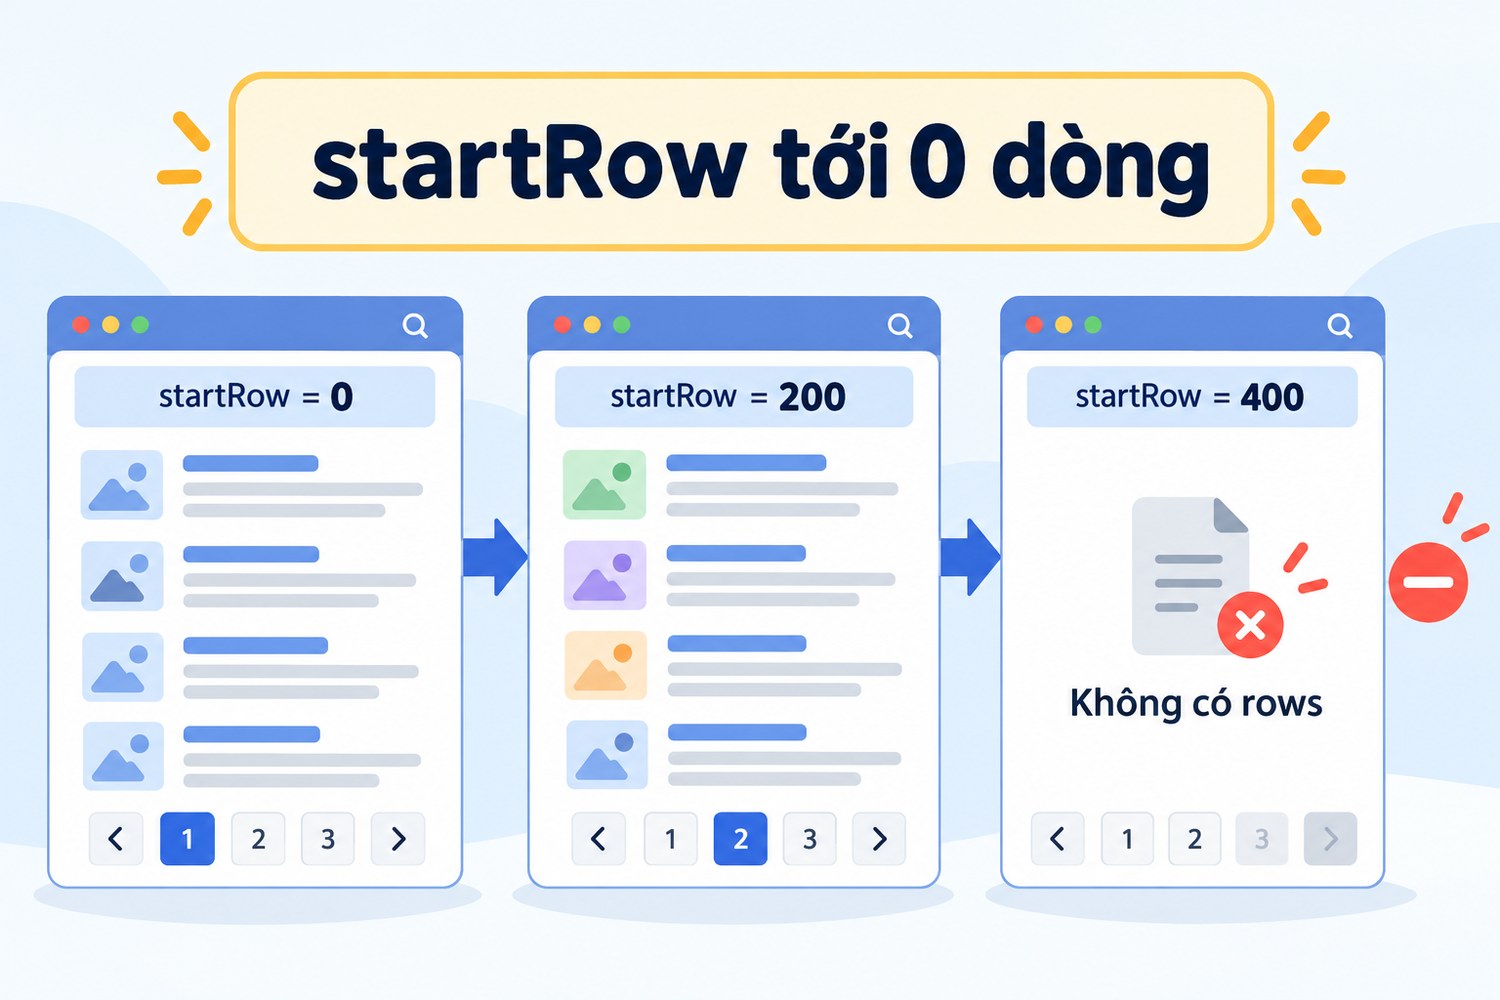
Tài liệu ghi rowLimit nhận từ 1 tới 25.000, mặc định 1.000. Muốn lấy thêm, tăng startRow. Khi startRow vượt quá số kết quả, API trả thành công với 0 dòng.
Đây là điều kiện dừng duy nhất. Phản hồi không có tổng số dòng hay token trang sau. Vòng lặp phải gọi tới khi nhận phản hồi không có dòng nào.
Giới hạn 50 nghìn dòng mỗi ngày
Trang lấy toàn bộ dữ liệu của Search Console ghi Search Analytics chỉ lộ tối đa 50 nghìn dòng dữ liệu mỗi ngày cho mỗi loại tìm kiếm, sắp theo lượt nhấp. Với website lớn, phần đuôi dài các truy vấn ít nhấp sẽ không có trong API.
Trang này cũng hướng dẫn truy vấn từng ngày một, mỗi ngày chạy riêng cho từng loại tìm kiếm. Chia theo ngày giúp không chạm giới hạn 50 nghìn dòng sớm khi chọn khoảng thời gian dài.
Tổng theo chiều chi tiết nhỏ hơn tổng thật
Tài liệu ghi muốn có số đếm chính xác thì bỏ chiều page và query, chỉ giữ country hoặc device với aggregationType byPage. Thêm page và query cho nhiều chi tiết hơn nhưng mất một phần dữ liệu.
Lý do là một số truy vấn bị ẩn để bảo vệ quyền riêng tư người tìm kiếm, và giới hạn dòng cắt bớt phần đuôi. Tổng lượt nhấp tính từ bảng query cộng lại thường nhỏ hơn tổng lượt nhấp theo ngày. Server giả lập không có truy vấn ẩn, nên hai tổng trong lab bằng nhau. Website thật sẽ khác.
dataState và dữ liệu mới
Tham số dataState để trống hoặc final chỉ trả dữ liệu đã chốt. Giá trị all trả cả dữ liệu mới chưa chốt. Giá trị hourly_all trả dữ liệu theo giờ, dùng với chiều HOUR.
Báo cáo định kỳ nên dùng final để số liệu không đổi giữa hai lần chạy. Bảng theo dõi nhanh trong ngày có thể dùng all, nhưng phải ghi rõ số liệu còn thay đổi.
Chuẩn bị truy vấn, property ID, token và phiên bản cho Search Console API bằng Python
Phần này đi qua cách viết siteUrl, cách xác thực và các mã lỗi thật lab ghi được.
Viết siteUrl trong đường dẫn
Property miền viết là sc-domain:example.com, dấu hai chấm mã hóa thành %3A trong đường dẫn. Property tiền tố URL viết đầy đủ https://example.com/, cũng phải mã hóa URL. Sai một dấu gạch chéo cuối cũng là một property khác.
Gọi /webmasters/v3/sites với tài khoản đã xác thực trả danh sách property kèm mức quyền. Dùng đúng chuỗi siteUrl trong danh sách này thay vì tự gõ.
Xác thực bằng OAuth hoặc tài khoản dịch vụ
Search Console API yêu cầu OAuth 2.0. Với script cá nhân, dùng luồng OAuth cho ứng dụng cài đặt. Với tác vụ chạy định kỳ trên máy chủ, dùng tài khoản dịch vụ rồi thêm email của tài khoản dịch vụ vào property với quyền phù hợp.
Phạm vi chỉ đọc là webmasters.readonly. Script báo cáo không cần phạm vi ghi. Lab không tạo tài khoản dịch vụ, không dùng khóa thật nào.
Khóa API không được chấp nhận
Lab gửi truy vấn với một khóa API giả trong tham số key. Máy chủ trả 401 với thông báo API này không hỗ trợ khóa API, yêu cầu token OAuth 2 hoặc thông tin xác thực xác định danh tính. Nhiều người quen dùng khóa API với các dịch vụ Google khác sẽ gặp lỗi này.
Ba thông báo 401 khác nhau
Không gửi xác thực, cả /sites lẫn searchAnalytics.query đều trả 401 với thông báo thiếu thông tin xác thực, reason là required. Header WWW-Authenticate ghi realm của accounts.google.com.
Gửi token Bearer giả, máy chủ trả 401 với thông báo thông tin xác thực không hợp lệ, reason là authError, và header WWW-Authenticate có thêm error="invalid_token". Phân biệt ba thông báo giúp biết code quên gửi token, gửi token hỏng hay dùng nhầm khóa API.
Tình huống |
Mã |
reason |
Dấu hiệu |
|---|---|---|---|
Không có xác thực |
401 |
required |
Thông báo thiếu credential |
Token Bearer giả |
401 |
authError |
error="invalid_token" trong header |
Khóa API giả |
401 |
required |
Thông báo API không hỗ trợ khóa API |
URL Inspection không xác thực |
401 |
UNAUTHENTICATED |
Định dạng lỗi kiểu mới có details |
Máy chủ cũ và máy chủ mới
Lab gọi /webmasters/v3/sites trên cả www.googleapis.com và searchconsole.googleapis.com. Cả hai đều trả 401 cùng thông báo, tức cả hai tên máy chủ còn nhận request. Tài liệu hiện hành dùng searchconsole.googleapis.com, nên code mới nên dùng tên này.
Điểm cuối URL Inspection nằm ở /v1/urlInspection/index:inspect trên searchconsole.googleapis.com, định dạng lỗi khác, có trường status là UNAUTHENTICATED và details. Một script gọi cả hai nhóm điểm cuối cần đọc lỗi theo hai định dạng.
Kiểm tra quyền trước khi chạy
Trước khi chạy truy vấn lớn, gọi /webmasters/v3/sites một lần. Phản hồi liệt kê các property kèm permissionLevel. Nếu property cần báo cáo không có trong danh sách, dừng lại và nhờ chủ property thêm tài khoản, thay vì để script chạy rồi nhận 403 ở từng truy vấn.
Bước này cũng giúp lấy đúng chuỗi siteUrl. Property miền và property tiền tố URL của cùng một website là hai property khác nhau, có thể khác cả số liệu vì phạm vi khác nhau.
Thư viện Python
Có thể dùng google-api-python-client với google-auth, hoặc gọi REST trực tiếp bằng requests kèm AuthorizedSession. Lab gọi REST trực tiếp để thấy rõ thân request và mã lỗi.
from google.oauth2 import service_account
from google.auth.transport.requests import AuthorizedSession
cred = service_account.Credentials.from_service_account_file(
    "sa.json", scopes=["https://www.googleapis.com/auth/webmasters.readonly"])
S = AuthorizedSession(cred)
Đoạn mã trên chưa chạy với khóa thật. Tên file sa.json là ví dụ, file khóa phải nằm ngoài kho mã nguồn.
Thu dữ liệu Search Console API bằng Python có phân trang theo đúng nguồn
Phần này đưa vòng lặp startRow chạy trên server giả lập, cách xử lý 0 dòng, 403 và 429.
Vòng lặp startRow
Hàm query của lab gửi cùng thân request, mỗi lần tăng startRow thêm số dòng vừa nhận, dừng khi phản hồi không có trường rows.
def query(site, body, page=200):
    rows = []; start = 0
    while True:
        r = S.post(f"{B}/sites/{site}/searchAnalytics/query",
                   json=dict(body, rowLimit=page, startRow=start), timeout=30)
        if r.status_code == 429: time.sleep(float(r.headers.get("Retry-After", "5"))); continue
        r.raise_for_status(); got = r.json().get("rows", [])
        if not got: return rows
        rows += got; start += len(got)
Lab dùng rowLimit 200 để thấy phân trang với dữ liệu nhỏ. Với website thật, đặt rowLimit 25.000 để giảm số request.
Kết quả trên server giả lập
Truy vấn ba chiều query, page, date cho 7 ngày từ 1/10 tới 7/10/2026 trả 155 dòng sau 2 lần gọi. Lần thứ hai không có rows, chỉ có responseAggregationType là byPage. Số dòng khớp với dữ liệu nguồn của server giả lập.
Server giả lập trả 429 kèm Retry-After 1 ở request thứ ba, rơi vào truy vấn theo ngày chạy ngay sau đó. Hàm chờ 1 giây rồi gửi lại, truy vấn theo ngày hoàn tất với 7 dòng.
Phản hồi 0 dòng không có trường rows
startRow tới 0 dòng
Khi hết dữ liệu, phản hồi không có trường rows thay vì rows là mảng rỗng. Code viết d["rows"] sẽ báo lỗi KeyError đúng lúc vòng lặp lẽ ra phải dừng. Dùng d.get("rows", []) là cách an toàn.
Lab gửi startRow 999999. Server giả lập trả 200 với phản hồi chỉ có responseAggregationType, đúng mô tả trong tài liệu về startRow vượt quá số kết quả.
Lỗi 403 khi không có quyền property
Server giả lập trả 403 với status PERMISSION_DENIED khi gọi một property khác property lab. Thông báo này do lab đặt theo dạng lỗi chung của Google, chưa đối chiếu nguyên văn với Search Console thật.
Gặp 403 thì không retry. Kiểm tra siteUrl có đúng chuỗi trong danh sách /sites không, và tài khoản dịch vụ đã được thêm vào property chưa.
Giới hạn quota
Trang giới hạn sử dụng của Search Console API ghi Search Analytics bị giới hạn bởi tải ngắn hạn 10 phút và tải dài hạn 1 ngày. Ngoài tải còn có giới hạn số truy vấn mỗi giây, mỗi phút, mỗi ngày theo site, theo người dùng và theo project. Mức truy vấn là 1.200 mỗi phút cho mỗi site hoặc người dùng.
Tải là tài nguyên nội bộ mà một truy vấn tiêu tốn. Truy vấn nhóm theo query và page trong khoảng thời gian dài tốn tải nhiều nhất. Truy vấn từng ngày một và chỉ chọn chiều cần thiết là cách giữ trong giới hạn.
rowLimit vượt giới hạn
Server giả lập trả 400 khi rowLimit bằng 30.000, vì tài liệu ghi khoảng hợp lệ là 1 tới 25.000. Mã 400 ở đây là hành vi lab tự đặt, chưa đối chiếu với máy chủ thật. Code an toàn nên tự giới hạn rowLimit trước khi gửi.
Đối soát ID, kiểu dữ liệu, giá trị thiếu và xuất xứ trong Search Console API bằng Python
Thu dữ liệu xong, phần này kiểm tra tổng, cách tính vị trí trung bình và ghi xuất xứ.
Kiểm tra tổng giữa hai truy vấn
Lab so tổng của truy vấn ba chiều với tổng của truy vấn chỉ theo ngày. Cả hai đều là 1035 lượt nhấp và 33.398 lượt hiển thị trên server giả lập. Hai tổng bằng nhau vì dữ liệu giả lập không có truy vấn ẩn.
Với website thật, tổng theo ngày thường lớn hơn tổng cộng từ bảng query. Báo cáo nên ghi cả hai con số và giải thích chênh lệch, thay vì chỉ trình bày tổng từ bảng chi tiết như thể đó là toàn bộ lượt nhấp.
Khi báo cáo có chiều query, tổng lượt nhấp không bằng tổng thật của website.
Vị trí trung bình không cộng trung bình được
Trung bình có trọng số
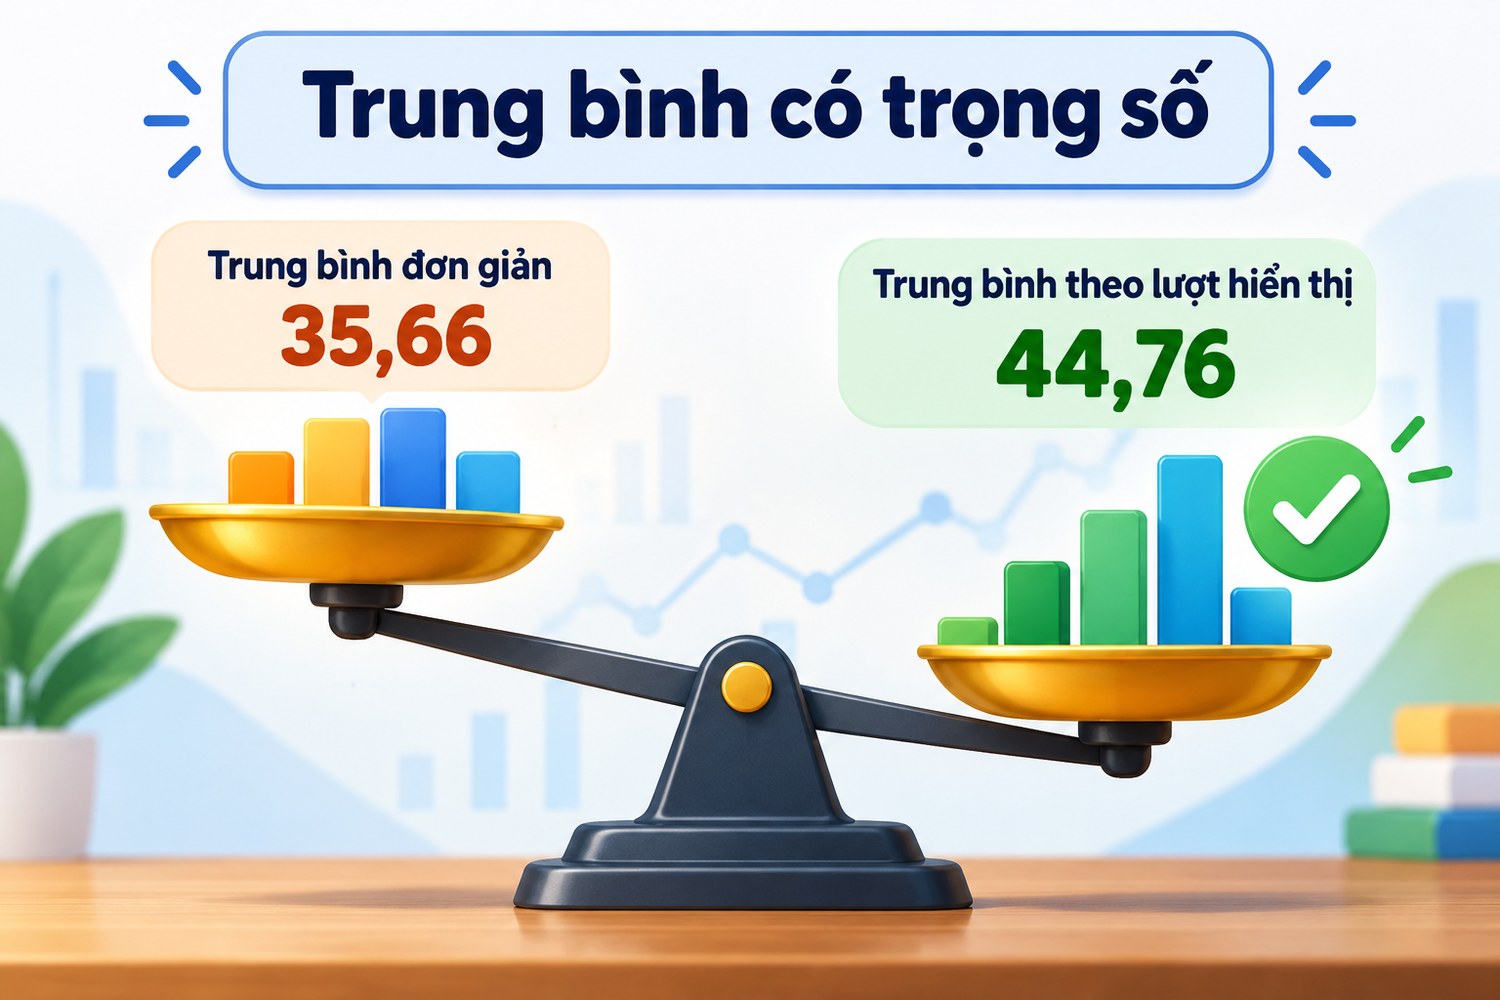
Mỗi dòng có position là vị trí trung bình. Lab lấy truy vấn "tu khoa 1" có 7 dòng theo từng ngày. Lấy trung bình đơn giản của 7 giá trị position cho 35,66. Lấy trung bình có trọng số theo lượt hiển thị cho 44,76.
Hai con số chênh nhau gần 10 bậc. Khi gộp nhiều dòng thành một, phải tính trung bình có trọng số theo impressions, hoặc gọi lại API với chiều ít hơn để Google tính sẵn. Trung bình của trung bình cho con số sai.
CTR tính lại khi gộp
Tương tự, CTR của dòng gộp phải là tổng clicks chia tổng impressions, không phải trung bình các CTR. Lab xuất ctr làm tròn 6 chữ số thập phân để không mất độ chính xác khi tính lại.
Kiểu dữ liệu
Clicks và impressions là số nguyên. Ctr là số thực từ 0 tới 1, không phải phần trăm. Position là số thực, số càng nhỏ càng gần đầu trang. Date trong keys là chuỗi YYYY-MM-DD theo giờ Thái Bình Dương.
Truy vấn có thể chứa ký tự tiếng Việt có dấu. Ghi CSV bằng UTF-8, và nếu mở bằng Excel thì nên thêm BOM hoặc nhập qua chức năng nhập dữ liệu. Bài JSON và CSV khi crawl dữ liệu bàn thêm về mã hóa khi xuất.
Chiều country và device
Khi thêm chiều country, mỗi dòng có thêm mã quốc gia ba chữ cái viết thường, ví dụ vnm cho Việt Nam. Chiều device có các giá trị như DESKTOP, MOBILE và TABLET. Hai chiều này giúp tách báo cáo theo thị trường và thiết bị mà vẫn giữ tổng gần với thực tế hơn so với chiều query.
Lab không đưa hai chiều này vào server giả lập. Phần mô tả dựa trên tài liệu. Khi lọc theo quốc gia, dùng dimensionFilterGroups với chiều country, không dùng proxy ở quốc gia đó.
Lọc truy vấn có thương hiệu
Báo cáo SEO hay tách truy vấn chứa tên thương hiệu khỏi truy vấn chung. dimensionFilterGroups hỗ trợ toán tử contains, notContains, equals và một số toán tử khác trên chiều query. Một truy vấn lọc contains tên thương hiệu và một truy vấn lọc notContains cho hai nhóm số liệu riêng.
Hai nhóm cộng lại vẫn chịu giới hạn truy vấn ẩn như mọi truy vấn có chiều query. Báo cáo nên ghi rõ tổng của hai nhóm không bằng tổng thật của website.
File CSV query, page, date
Query, page, date
Lab xuất 155 dòng ra file CSV với các cột query, page, date, clicks, impressions, ctr và position. Mỗi dòng là một tổ hợp duy nhất của ba chiều. Lab kiểm tra không có tổ hợp trùng.
Xuất xứ của báo cáo
Phần đầu báo cáo nên ghi property, khoảng ngày, múi giờ của ngày, type, dataState, danh sách chiều và thời điểm chạy. Thiếu một trong các thông tin này, người đọc không thể so sánh với báo cáo khác.
Lưu kết quả, giới hạn request và khi nào Search Console API bằng Python thực sự cần proxy
Phần cuối nói về lưu trữ lâu dài, nhịp gọi và vai trò thật của proxy.
Lưu từng ngày một
Search Console giữ dữ liệu trong một khoảng thời gian giới hạn. Muốn có lịch sử dài, phải tự lưu. Cách gọn là mỗi ngày chạy một truy vấn cho ngày đã chốt gần nhất, lưu thành file theo ngày, rồi gộp khi cần phân tích.
Lưu theo ngày còn giúp chạy lại một ngày bị lỗi mà không ảnh hưởng các ngày khác. Tên file nên có property, ngày dữ liệu và type.
Bảo vệ file khóa và file kết quả
File khóa của tài khoản dịch vụ cho phép đọc mọi property mà tài khoản đó được thêm vào. Để file khóa ngoài thư mục mã nguồn, không gửi qua chat, và thu hồi ngay khi nghi ngờ bị lộ. Mỗi dự án nên dùng tài khoản dịch vụ riêng để thu hồi một khóa không ảnh hưởng dự án khác.
File kết quả chứa truy vấn tìm kiếm thật của người dùng tới website. Dù đã ẩn danh ở phía Google, danh sách truy vấn vẫn là dữ liệu kinh doanh nhạy cảm. Chỉ chia sẻ bản tổng hợp cần thiết, không chia sẻ toàn bộ file thô.
Nhịp gọi hợp lý
Với một property và vài loại tìm kiếm, mỗi ngày chỉ cần vài truy vấn. Giới hạn 1.200 truy vấn mỗi phút cho mỗi site dư sức cho báo cáo. Giới hạn dễ chạm nhất là tải, khi truy vấn nhiều chiều trên khoảng thời gian dài.
Bài rate limit API khi dùng proxy giải thích vì sao quota tính theo site, người dùng và project không thay đổi khi đổi IP.
Thử qua proxy lab
Lab gọi /webmasters/v3/sites không xác thực qua proxy HTTP cục bộ có xác thực ở cổng 9702. Kết quả là 401 với cùng thông báo thiếu thông tin xác thực, mất 0,482 giây. Proxy không thay đổi kết quả xác thực.
px = {"https": "http://user1:p%40ss%232026@127.0.0.1:9702"}
r = requests.get("https://searchconsole.googleapis.com/webmasters/v3/sites", proxies=px, timeout=30)
Proxy không cấp quyền vào property, không tăng quota và không đổi chiều country.
Khi nào proxy thực sự cần
Proxy cần khi máy chạy script nằm trong mạng chỉ cho ra Internet qua proxy, ví dụ máy chủ báo cáo trong mạng nội bộ công ty. Khi đó thư viện Google cần biết proxy qua biến môi trường HTTPS_PROXY hoặc cấu hình phiên. Bài định dạng proxy có cách viết URL proxy có mật khẩu.
Nếu mục tiêu là xem kết quả tìm kiếm từ một quốc gia khác, đó là bài toán SERP, không phải Search Console. Bài SERP API bàn hướng đó.
Chọn loại proxy khi cần
Khi máy chủ báo cáo cần một đường ra Internet ổn định, proxy datacenter hoặc proxy dân cư tĩnh là đủ. ProxyVN có proxy dân cư tĩnh, proxy datacenter, proxy 4G và proxy xoay, hỗ trợ HTTP và SOCKS5. Anh em có thể mua proxy tốc độ cao tại ProxyVN rồi khai báo qua HTTPS_PROXY cho tiến trình chạy báo cáo.
Giới hạn suy luận của bài
Phần gọi thật gồm các request không xác thực, token giả và khóa API giả tới searchconsole.googleapis.com và www.googleapis.com ngày 29/10/2026, Python 3.12.10, requests 2.34.2. Lab không dùng tài khoản dịch vụ hay token thật, không đọc dữ liệu của property nào.
Phân trang, tổng, vị trí trung bình, 403, 429 và lỗi rowLimit chạy trên server giả lập với dữ liệu ngẫu nhiên. Server giả lập không có truy vấn ẩn và giới hạn 50 nghìn dòng, nên không tái hiện chênh lệch tổng của website thật. Proxy trong lab là proxy cục bộ.
Checklist Search Console API bằng Python
Checklist Search Console API
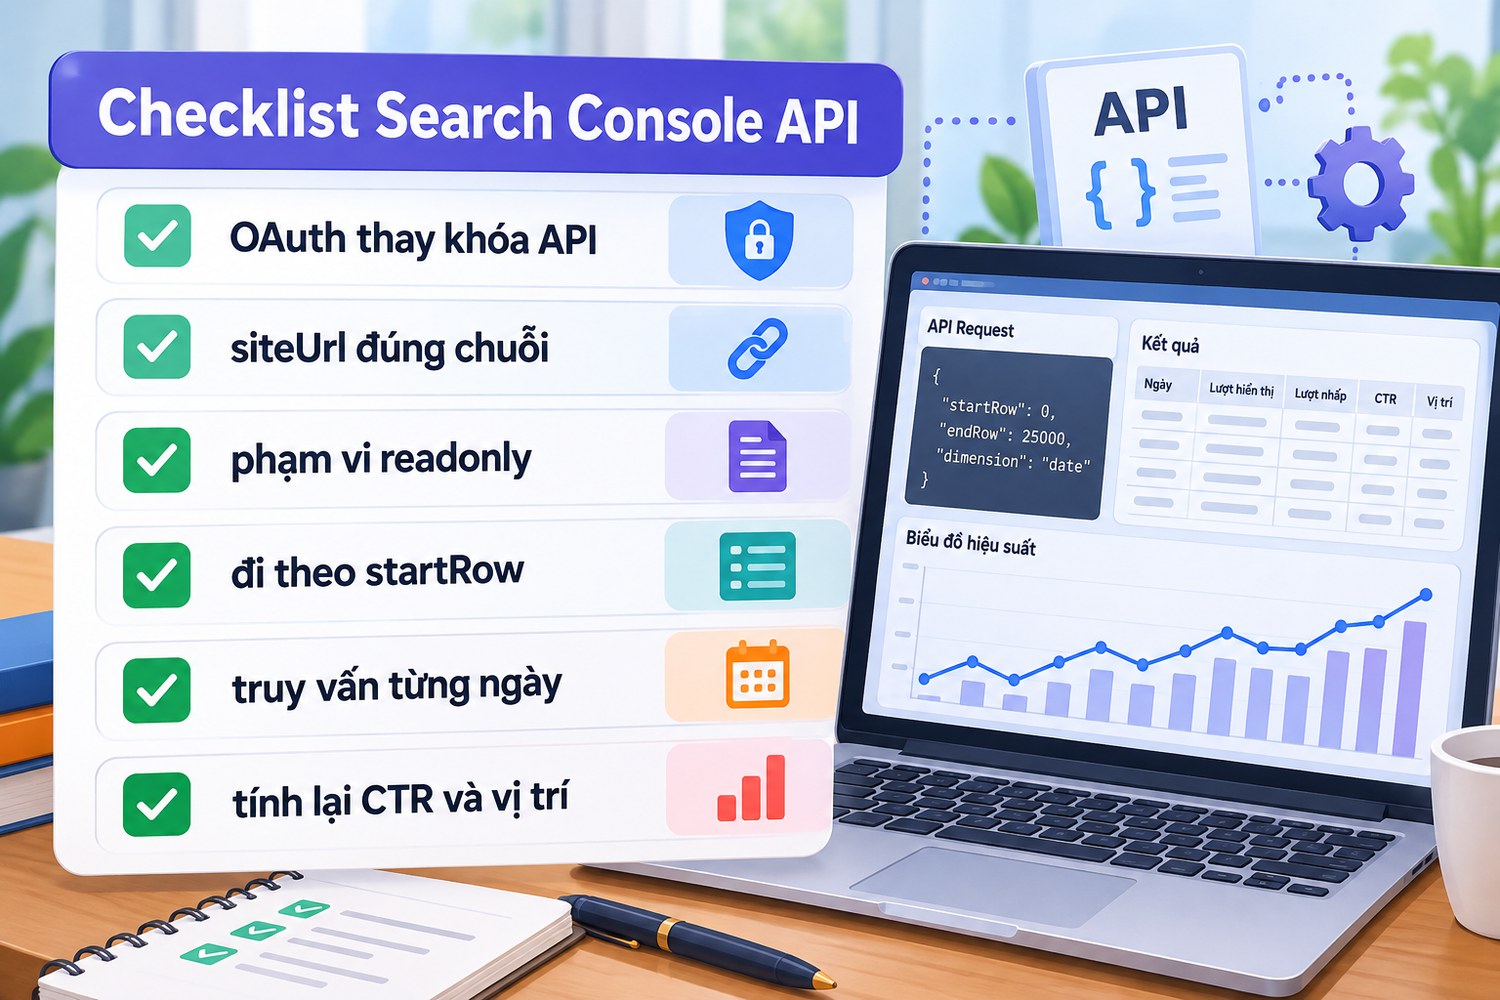
- Dùng OAuth hoặc tài khoản dịch vụ, khóa API không được chấp nhận.
- Lấy siteUrl đúng chuỗi từ danh sách /sites, mã hóa URL.
- Chọn phạm vi webmasters.readonly cho script báo cáo.
- Tăng startRow tới khi phản hồi không có rows.
- Truy vấn từng ngày để tránh giới hạn 50 nghìn dòng và tải.
- Tính lại CTR và vị trí trung bình có trọng số khi gộp dòng.
- Ghi múi giờ Thái Bình Dương và dataState trong báo cáo.
- Không dùng proxy để đổi quốc gia, chiều country là của người tìm.
Câu hỏi thường gặp về Search Console API bằng Python
Có dùng khóa API được không?
Không. Lab gửi khóa API giả và nhận 401 với thông báo API không hỗ trợ khóa API. Cần OAuth hoặc tài khoản dịch vụ.
Vì sao tổng lượt nhấp trong API nhỏ hơn giao diện?
Khi truy vấn có chiều query hoặc page, một phần dữ liệu bị ẩn hoặc bị cắt. Truy vấn chỉ theo ngày hoặc theo quốc gia cho tổng gần với giao diện hơn.
Làm sao biết đã lấy hết dữ liệu?
Tăng startRow tới khi phản hồi không có trường rows. API không trả tổng số dòng.
Có lấy được dữ liệu website đối thủ không?
Không. API chỉ trả dữ liệu property mà tài khoản được cấp quyền.
Dùng proxy Mỹ có thấy số liệu thị trường Mỹ khác đi không?
Không. Chiều country là quốc gia của người tìm kiếm. Muốn xem riêng thị trường Mỹ, lọc theo country bằng dimensionFilterGroups.
Ngày trong API có khớp ngày Việt Nam không?
Không khớp, vì ngày tính theo giờ Thái Bình Dương. Bài web scraping proxy là gì có nói về khác biệt giữa dữ liệu thu từ trang và dữ liệu từ nền tảng.
Search Console API bằng Python và những điều cần nhớ
Search Console API bằng Python đọc đúng dữ liệu hiệu suất của property mình quản lý, với điều kiện hiểu chiều, rowLimit, startRow và giới hạn dữ liệu. Lab ngày 29/10/2026 ghi ba thông báo 401 khác nhau, xác nhận khóa API bị từ chối và proxy không đổi kết quả. Trên server giả lập, lab chạy phân trang 155 dòng và cho thấy trung bình vị trí đơn giản lệch gần 10 bậc so với trung bình có trọng số. Cần đường ra mạng ổn định cho máy chủ báo cáo khi làm Search Console API bằng Python, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


