
Screaming Frog custom extraction: XPath, CSS, regex và DOM render
Screaming Frog custom extraction là tính năng của SEO Spider cho phép khai báo tới 100 extractor bằng XPath, CSSPath hoặc regex để lấy dữ liệu từ từng trang trong lúc crawl, rồi xuất ra bảng tính. Phần khó không nằm ở cú pháp, mà ở chỗ biểu thức chạy trên HTML nguồn hay HTML đã render, và nó còn đúng không khi website đổi giao diện. ProxyVN dựng ba mẫu DOM của cùng một trang sản phẩm ngày 03/11/2026, chạy mười biểu thức trên cả HTML nguồn lẫn DOM render bằng Chrome headless, để biết biểu thức nào bền, biểu thức nào hỏng âm thầm.
Screaming Frog custom extraction: mục tiêu và phạm vi không lặp
Phần đầu chốt bài làm gì, giao gì và giới hạn của phép thử.
Bài toán
Đội SEO hay đội nội dung cần lấy một vài trường trên hàng nghìn trang: giá, mã sản phẩm, ngày cập nhật, tác giả, số tiêu đề H2. Họ đã quen SEO Spider để audit, nên muốn dùng luôn công cụ này thay vì viết crawler riêng. Custom Extraction đáp ứng đúng nhu cầu đó.
Vấn đề thường gặp là biểu thức chạy tốt trên trang mẫu, rồi trả ô trống hay giá trị sai trên một phần website. Nguyên nhân hay nằm ở cấu trúc DOM khác nhau giữa các trang, hoặc ở dữ liệu chỉ xuất hiện sau khi JavaScript chạy.
Đầu ra nghiệm thu
Đầu ra gồm ba phần. Một là tệp cấu hình mô tả từng extractor: tên cột, loại biểu thức, thuộc tính, chế độ lấy dữ liệu. Hai là ba mẫu DOM đại diện cho các tình huống: trang chuẩn, trang đổi giao diện, trang render bằng JavaScript. Ba là bảng CSV kết quả trên cả HTML nguồn và DOM render, có đánh dấu ô nào sai.
Phạm vi không lặp
Website đã có bài proxy Screaming Frog hướng dẫn đặt proxy và xác thực cho SEO Spider. Bài này không nhắc lại phần đó. Bài cũng không phải hướng dẫn audit SEO tổng quan. Trọng tâm duy nhất là cách viết và kiểm extractor.
Giới hạn của phép thử
Theo hướng dẫn web scraping của Screaming Frog, cần có licence mới dùng được Custom Extraction. Lab không có licence nên không chạy SEO Spider. Mọi biểu thức được kiểm bằng thư viện parsel 1.12.1 trên lxml 6.1.3 với HTML nguồn, và trên DOM do Chrome headless xuất ra sau khi chạy JavaScript.
parsel và SEO Spider đều hiểu XPath 1.0 và CSS selector tiêu chuẩn, nên phần lớn kết luận áp dụng được. Chỗ nào có thể khác giữa hai công cụ, bài sẽ ghi rõ.
Ai nên đọc
Người dùng SEO Spider có licence, muốn lấy dữ liệu ổn định qua nhiều lần crawl. Người phải bàn giao bảng dữ liệu cho khách và cần chứng minh từng cột đúng. Người đang chép XPath từ công cụ kiểm tra phần tử của trình duyệt và thấy kết quả lúc có lúc không.
Lấy thuộc tính DOM bằng Screaming Frog custom extraction và so kết quả sau render
Phần này giải thích bốn chế độ lấy dữ liệu và hai nguồn HTML.
Ba loại biểu thức
XPath chọn nút trong cây tài liệu, kể cả thuộc tính. CSSPath dùng selector CSS, có ô thuộc tính riêng nếu muốn lấy thuộc tính thay vì chữ. Regex áp lên chuỗi HTML, dùng cho thứ không nằm trong phần tử HTML, như JSON trong thẻ script hay chú thích HTML.
Tài liệu Screaming Frog khuyên dùng XPath hoặc CSSPath cho phần lớn trường hợp, và chỉ dùng regex khi dữ liệu nằm ngoài phần tử, ví dụ JSON nhúng trong mã.
Bốn chế độ lấy dữ liệu
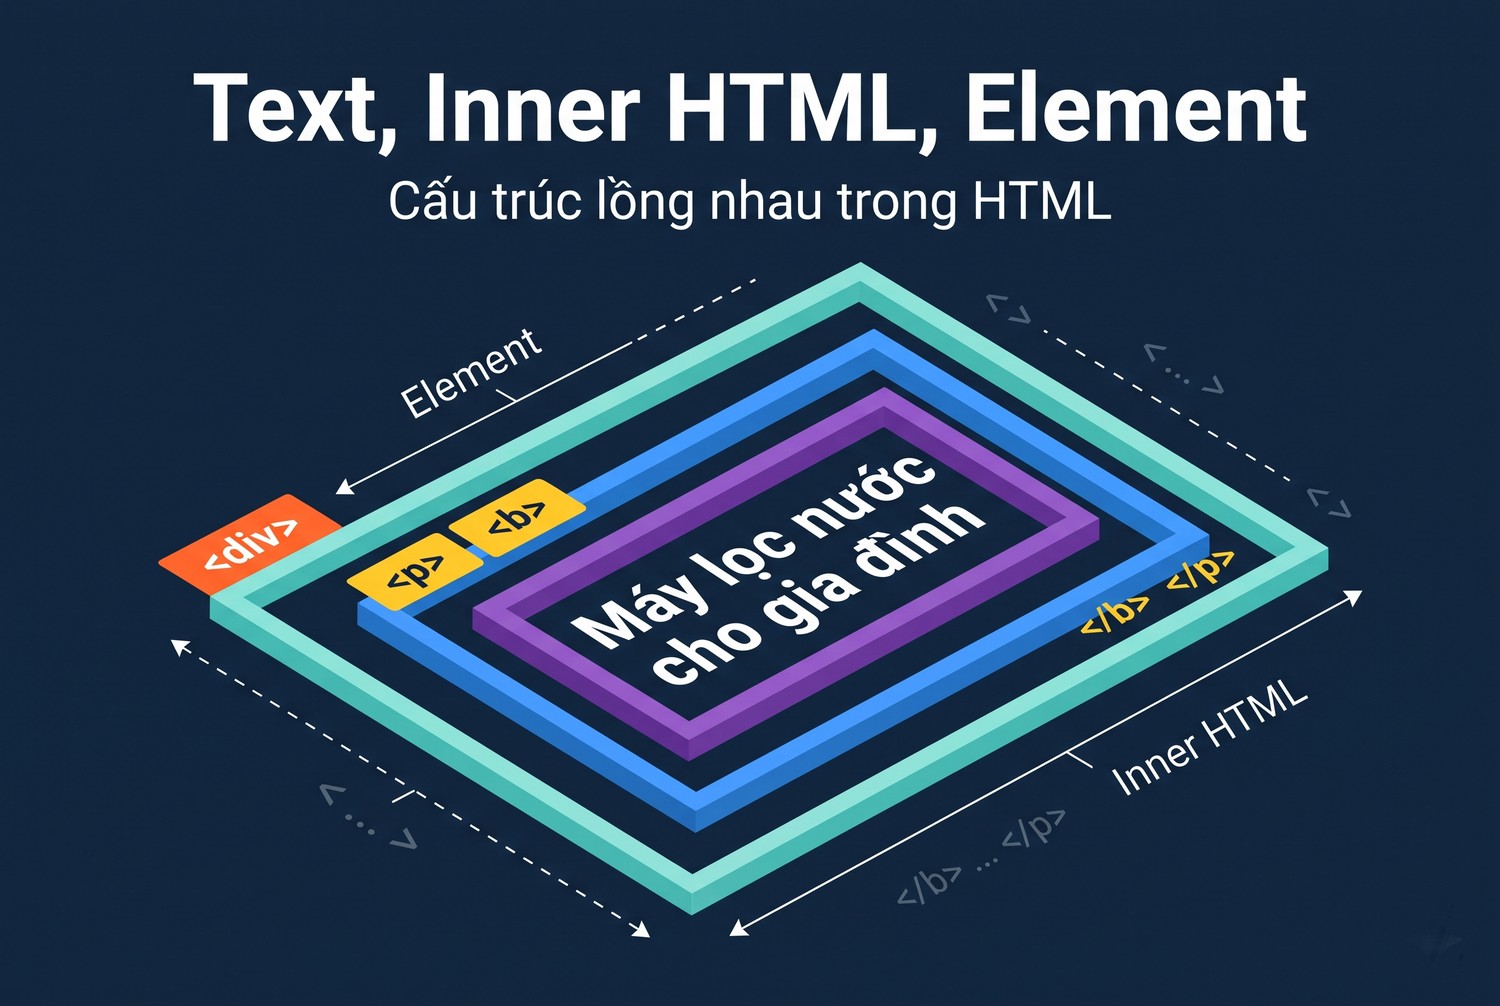
Text, Inner HTML, Element
Với XPath và CSSPath, ô data có bốn lựa chọn. Extract HTML Element lấy cả phần tử và nội dung bên trong. Extract Inner HTML lấy phần bên trong, không có thẻ bao ngoài. Extract Text lấy chữ của phần tử và mọi phần tử con. Function Value trả kết quả của một hàm XPath như count(//h1).
Lab dùng cùng một biểu thức //div[@class='mota'] với ba chế độ đầu. Extract Text cho Máy lọc nước cho gia đình. Inner HTML cho đoạn p có thẻ b bên trong. HTML Element cho thêm cả thẻ div bao ngoài.
Chọn chế độ theo việc dùng sau
Lấy giá, mã, ngày thì dùng Extract Text hoặc thuộc tính. Lấy đoạn mô tả để kiểm định dạng như số thẻ b, số link, thì dùng Inner HTML. HTML Element ít khi cần, trừ khi muốn kiểm class hay thuộc tính của chính phần tử bao.
Extract Text gộp chữ của mọi phần tử con. Nếu phần tử có cả giá cũ và giá mới trong hai thẻ con, Extract Text sẽ nối hai giá thành một chuỗi. Khi đó nên chọn phần tử con cụ thể.
HTML nguồn và HTML render
Mặc định SEO Spider lấy dữ liệu từ HTML máy chủ trả về. Khi bật chế độ JavaScript rendering, nó có thể lấy từ HTML sau khi trình duyệt chạy script. Hai nguồn này giống nhau với trang tĩnh và khác nhau với trang dựng nội dung bằng JavaScript.
Công cụ chọn phần tử trực quan của SEO Spider hiển thị cả bản xem trước nguồn và bản render. Tài liệu chỉ ra: nếu phần tử chỉ có ở bản render, cần bật chế độ JavaScript rendering mới lấy được.
Thuộc tính thường bền hơn chữ
Giá hiển thị cho người đọc là chuỗi có định dạng: dấu chấm, ký hiệu tiền, đôi khi chữ liên hệ. Nhiều trang có thêm giá dạng số trong thuộc tính, như meta itemprop price hay data-price, hoặc trong JSON-LD. Các giá trị này dành cho máy đọc nên ít đổi theo giao diện.
Lab cho thấy rõ điều này: biểu thức lấy thuộc tính content của meta itemprop price đúng ở cả ba mẫu, trong khi biểu thức lấy chữ của span giá hỏng ở hai mẫu.
Tạo Screaming Frog custom extraction với XPath hoặc CSS theo DOM fixture
Phần này mô tả ba mẫu DOM và mười extractor.
Ba mẫu DOM
Mẫu v1 là trang sản phẩm chuẩn: h1, span class price với giá 1.250.000₫, meta itemprop price, danh sách ul class specs ba dòng, khối mô tả, hai h2, meta og:updated_time và JSON-LD có sku. Mẫu v2 là cùng trang sau khi đổi giao diện: thêm một banner khuyến mãi ở đầu body, đổi class price thành gia-ban, thêm một dòng thông số và một h2.
Mẫu v3 là trang dựng bằng JavaScript: span giá rỗng, ul thông số rỗng, chỉ có một h2. Script cuối trang điền giá 1.150.000₫, ba dòng thông số và thêm h2 thứ hai. meta itemprop price và JSON-LD vẫn có sẵn trong HTML nguồn.
Mười extractor
Tên cột |
Loại |
Biểu thức |
Chế độ |
|---|---|---|---|
Gia (XPath copy tu trinh duyet) |
XPath |
/html/body/div[2]/div[1]/span |
Text |
Gia (span.price) |
CSSPath |
span.price |
Text |
Gia (itemprop) |
XPath |
//meta[@itemprop='price'] |
Thuộc tính content |
Thong so |
CSSPath |
ul.specs li |
Text, nhiều giá trị |
Cap nhat |
CSSPath |
meta[property='og:updated_time'] |
Thuộc tính content |
SKU JSON-LD |
Regex |
"sku" theo sau là chuỗi trong nháy |
Nhóm bắt 1 |
So H2 |
XPath |
count(//h2) |
Function Value |
Mo ta |
XPath |
//div[@class='mota'] |
Text, Inner HTML, HTML Element |
XPath chép từ trình duyệt
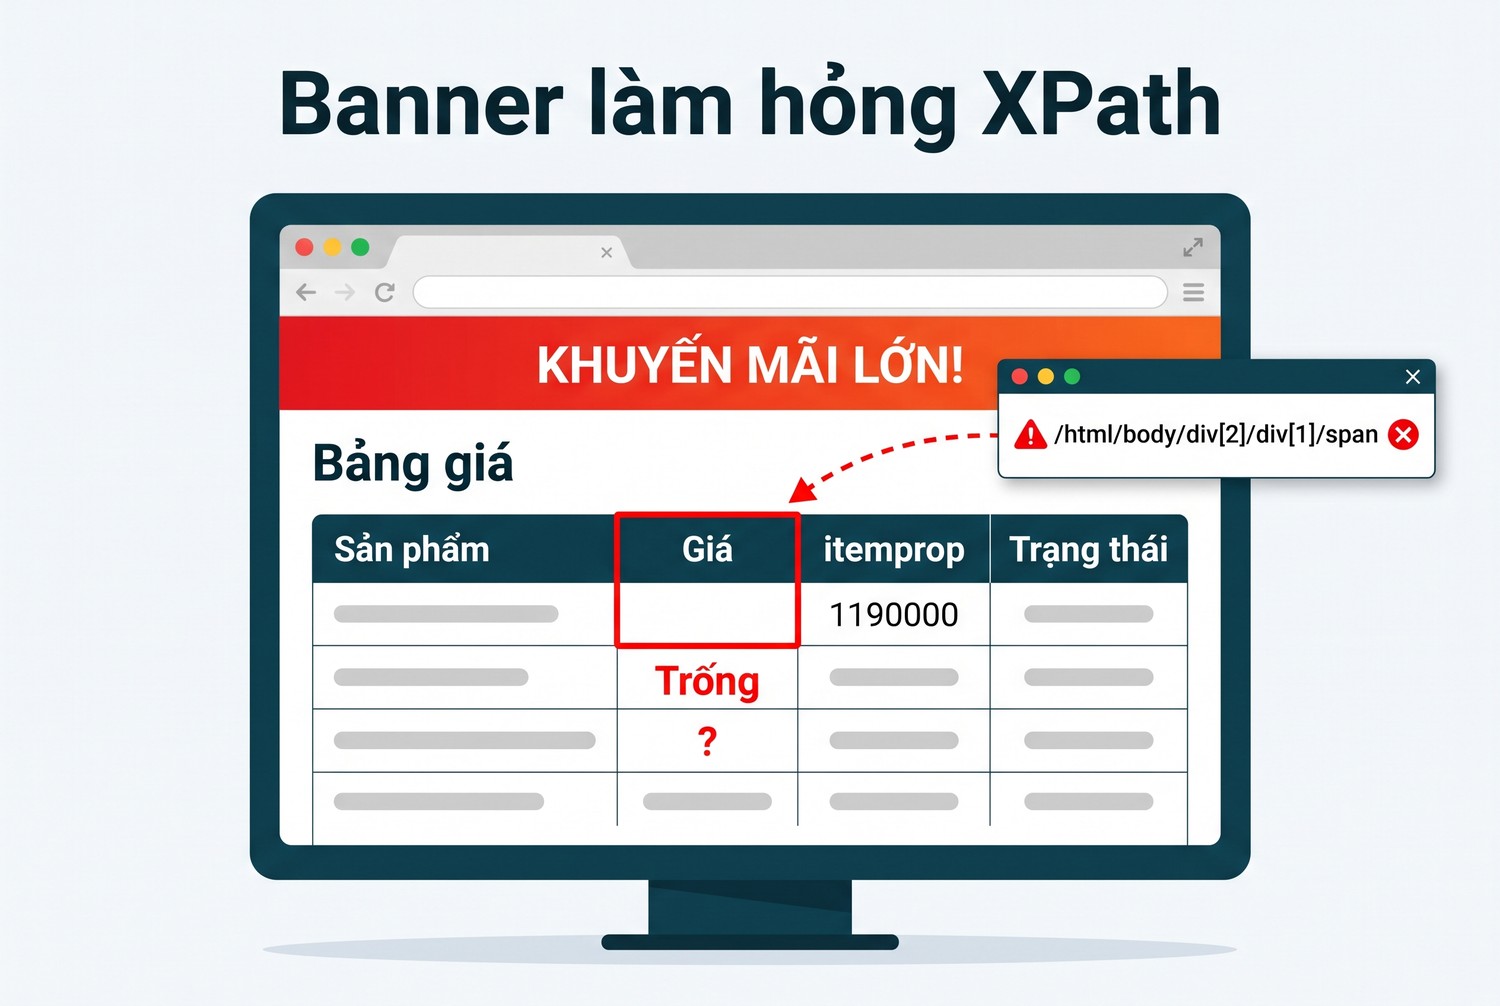
Banner làm hỏng XPath
Extractor đầu tiên là thứ nhiều người làm: bấm chuột phải vào giá trong công cụ kiểm tra phần tử, chọn Copy XPath đầy đủ. Kết quả là đường dẫn theo vị trí: div thứ hai trong body, div đầu tiên trong đó, rồi span. Tài liệu Screaming Frog cũng cảnh báo cách này không bền vì phụ thuộc vị trí và lấy từ bản đã render.
Lab giữ extractor này để đo nó hỏng thế nào.
XPath tương đối và bám theo nhãn
//span[contains(@class,'price') or contains(@class,'gia')]
//*[normalize-space(text())='Bảo hành']/following-sibling::*[1]
//h1/following::span[1]
Ba biểu thức trên đều tương đối, không bắt đầu từ html hay body. Dòng một chấp nhận cả class cũ lẫn class mới. Dòng hai bám theo nhãn chữ Bảo hành rồi lấy phần tử ngay sau, hợp với bảng thông số dạng nhãn và giá trị. Dòng ba lấy span đầu tiên sau h1, bền với banner chèn trước nhưng vỡ nếu có span khác chen giữa.
Không có biểu thức nào chịu được mọi kiểu thay đổi. Mục tiêu là chọn biểu thức gắn với ý nghĩa của dữ liệu thay vì vị trí của nó.
Dấu tích và dấu chéo trong công cụ
Theo tài liệu, SEO Spider hiện dấu tích cạnh extractor khi cú pháp hợp lệ và dấu chéo đỏ khi không hợp lệ. Dấu tích chỉ nói biểu thức đọc được, không nói nó khớp đúng phần tử. Cả hai biểu thức giá chữ trong lab đều hợp lệ về cú pháp và đều trả ô trống ở v2.
Regex cho JSON-LD
Biểu thức regex trong lab tìm chuỗi "sku", dấu hai chấm, rồi bắt chuỗi trong nháy kép tiếp theo. Regex cho phép khoảng trắng tùy ý quanh dấu hai chấm để không vỡ khi website định dạng lại JSON. Nhóm bắt đầu tiên là giá trị được ghi vào cột.
Regex không hiểu cấu trúc JSON. Nếu trang có hai khối JSON-LD với hai sku, regex bắt cả hai. Nếu giá trị có dấu nháy được thoát bên trong, regex có thể cắt sai.
Đặt tên cột rõ nghĩa
Tên extractor trở thành tên cột trong bảng xuất. Đặt tên nói rõ nguồn và cách lấy, ví dụ Gia (itemprop) thay vì Extractor 3. Khi bàn giao, người nhận biết ngay cột nào đáng tin hơn mà không phải mở cấu hình.
Lưu cấu hình để tái sử dụng
SEO Spider cho lưu cấu hình thành tệp để dùng lại cho lần crawl sau. Lab không có licence nên không xuất được tệp cấu hình gốc của công cụ. Thay vào đó, lab lưu tệp extractors.json mô tả đúng các trường cần nhập: tên, loại, biểu thức, thuộc tính, chế độ. Tệp này làm tài liệu đối chiếu khi nhập lại tay hay kiểm tra cấu hình của người khác.
Chọn nguồn HTML hay rendered HTML cho Screaming Frog custom extraction và kiểm bằng mắt
Đây là kết quả chính, so từng extractor trên ba mẫu và hai nguồn.
Bảng kết quả
Extractor |
v1 nguồn |
v1 render |
v2 nguồn |
v2 render |
v3 nguồn |
v3 render |
|---|---|---|---|---|---|---|
Gia (XPath copy) |
1.250.000₫ |
1.250.000₫ |
Trống |
Trống |
Chuỗi rỗng |
1.150.000₫ |
Gia (span.price) |
1.250.000₫ |
1.250.000₫ |
Trống |
Trống |
Chuỗi rỗng |
1.150.000₫ |
Gia (itemprop) |
1250000 |
1250000 |
1190000 |
1190000 |
1150000 |
1150000 |
Thong so |
3 giá trị |
3 giá trị |
4 giá trị |
4 giá trị |
Trống |
3 giá trị |
Cap nhat |
2026-10-28 |
2026-10-28 |
2026-11-02 |
2026-11-02 |
2026-11-03 |
2026-11-03 |
SKU JSON-LD |
MLN-A1-2026 |
như nguồn |
như nguồn |
như nguồn |
như nguồn |
như nguồn |
So H2 |
2 |
2 |
3 |
3 |
1 |
2 |
v1: mọi thứ đều đúng
Với trang chuẩn, cả mười extractor cho kết quả đúng trên cả hai nguồn. Đây chính là cái bẫy: kiểm trên một trang mẫu đẹp không nói gì về độ bền của biểu thức.
v2: đổi giao diện làm mất giá
Thêm một banner ở đầu body làm div thứ hai trong body trở thành khối top, không còn là khối sản phẩm. XPath chép từ trình duyệt không khớp phần tử nào. CSS span.price cũng không khớp vì class đã đổi thành gia-ban.
Cả hai cột giá chữ đều trống. Chỉ có Gia (itemprop) vẫn ra 1190000. Nếu bảng chỉ có hai cột giá chữ, người đọc sẽ tưởng sản phẩm hết hàng hay ngừng bán.
v3: nguồn và render khác nhau
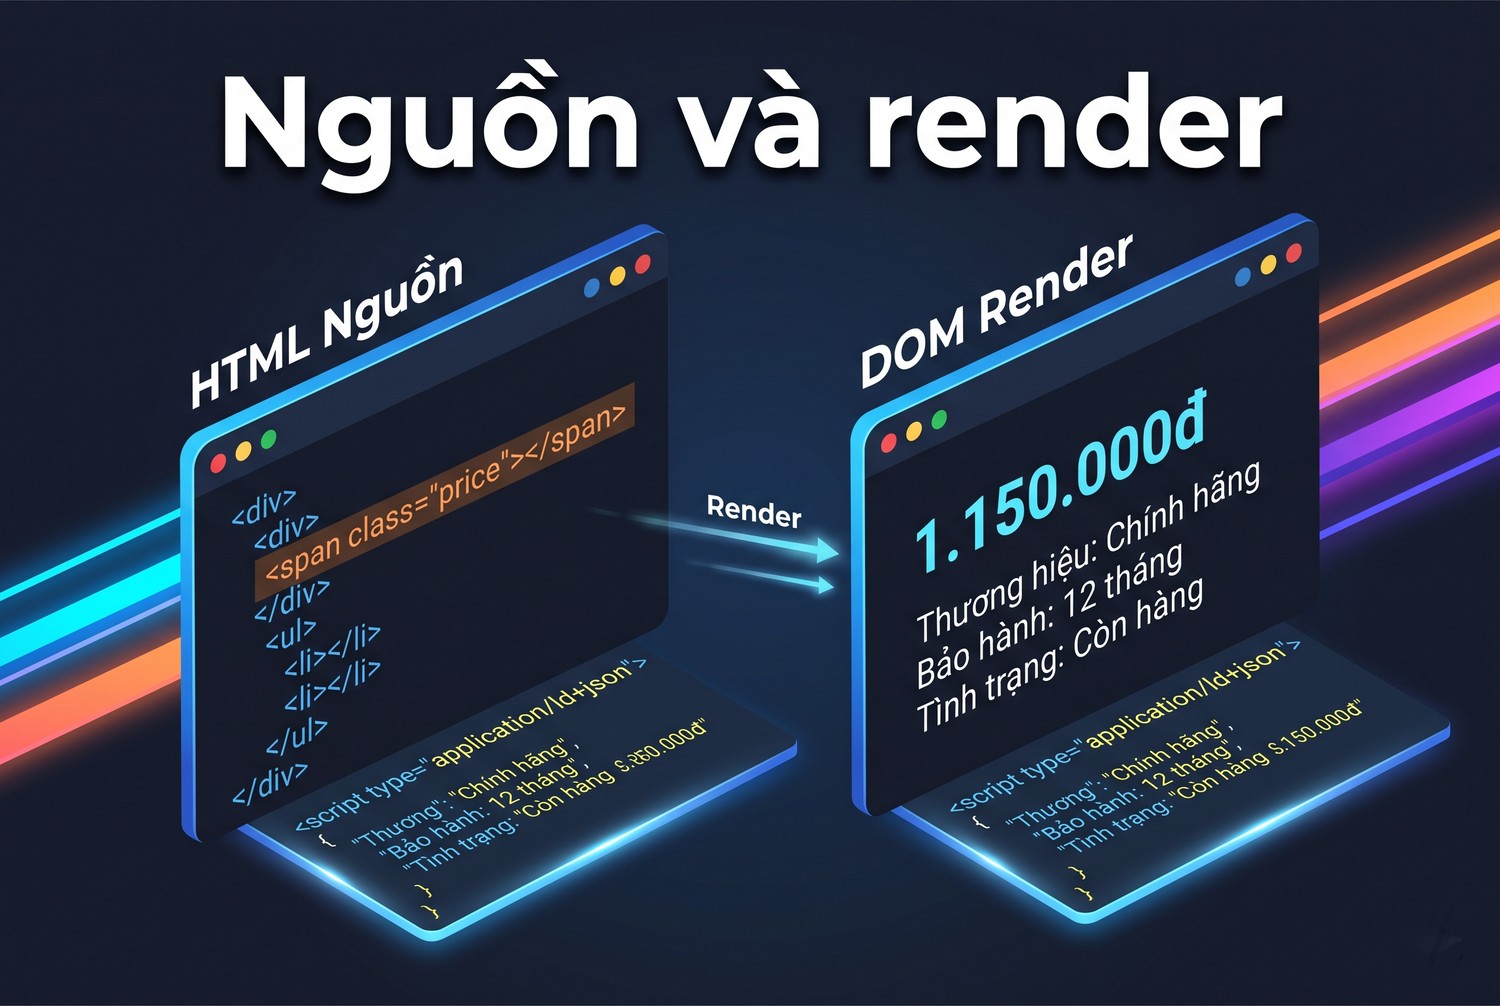
Nguồn và render
Trên HTML nguồn, span giá tồn tại nhưng rỗng, nên hai cột giá chữ cho chuỗi rỗng chứ không phải không có phần tử. ul thông số rỗng nên cột Thong so trống. count(//h2) cho 1. Trên DOM render, giá, ba dòng thông số và h2 thứ hai đều hiện ra.
Hai trường hợp trống và rỗng nhìn giống nhau trong bảng tính, nhưng ý nghĩa khác nhau. Trống là biểu thức không khớp, cần sửa biểu thức. Rỗng là phần tử có nhưng chưa có dữ liệu, thường cần bật render.
Thời gian chờ render
Trong lab, script của v3 chạy ngay khi trang tải nên DOM render luôn đủ dữ liệu. Website thật thường gọi API rồi mới điền dữ liệu, mất vài trăm mili giây tới vài giây. Nếu công cụ chụp DOM trước khi API trả về, kết quả render cũng rỗng như HTML nguồn.
SEO Spider có thiết lập thời gian chờ cho chế độ render. Khi thấy cột render lúc có lúc không trên cùng loại trang, tăng thời gian chờ trước khi nghi ngờ biểu thức. Nếu dữ liệu đến từ một API JSON công khai, gọi thẳng API đó thường đơn giản hơn render.
Dữ liệu nằm trong iframe
Phần tử trong iframe thuộc một tài liệu khác. XPath và CSS chạy trên trang cha không thấy nội dung iframe, dù trình duyệt hiển thị liền mạch. Trường hợp hay gặp là bảng giá, bản đồ, form đặt lịch nhúng từ dịch vụ ngoài.
Cách xử lý là lấy URL của iframe từ thuộc tính src, rồi crawl URL đó như một trang riêng với extractor riêng. Nhớ rằng URL iframe có thể thuộc tên miền khác với điều khoản sử dụng khác.
Dữ liệu cho máy đọc không cần render
meta itemprop price, meta og:updated_time và JSON-LD đều có trong HTML nguồn của v3. Ba cột này cho cùng kết quả trên cả hai nguồn. Lấy được dữ liệu từ đây thì không cần bật render, crawl nhanh hơn nhiều và tốn ít tài nguyên hơn.
Function Value có thể khác định dạng
Trong lab, count(//h2) qua lxml trả số thực 2.0. SEO Spider có thể hiển thị khác. Khi so số liệu giữa hai công cụ, ép về số nguyên trước khi so, đừng so chuỗi.
Kiểm bằng mắt trên mẫu
Sau khi chạy, mở ngẫu nhiên vài trang, đặt cạnh dòng tương ứng trong bảng. Tài liệu Screaming Frog cũng gợi ý xem bản xem trước nguồn và render trong công cụ chọn phần tử. Một phút kiểm bằng mắt trên mười trang thường phát hiện được loại lỗi mà kiểm cú pháp không thấy. Nên chọn mẫu kiểm từ nhiều nhóm trang khác nhau, không chỉ trang đầu danh sách. Trang cũ, trang hết hàng và trang mới đăng thường có cấu trúc khác nhau nhiều nhất.
Xuất CSV nhiều trường, xử lý phần tử thiếu hoặc nhiều giá trị trong Screaming Frog custom extraction
Phần này nói về bảng xuất.
Nhiều giá trị trên một trang
ul.specs li khớp ba phần tử ở v1 và bốn ở v2. Lab ghi mỗi giá trị vào một cột đánh số: Thong so 1, Thong so 2, Thong so 3, Thong so 4. Trang có ít giá trị hơn để trống các cột cuối.
Cách SEO Spider đặt tên và tách cột khi có nhiều giá trị cần kiểm trên bản có licence, lab không xác nhận được. Dù công cụ tách thế nào, nguyên tắc vẫn giống: số cột thay đổi theo trang có nhiều giá trị nhất, và cột cuối chỉ có dữ liệu ở vài trang.
Gộp nhiều giá trị khi cần
Nếu muốn mỗi trang một ô, dùng XPath có hàm gộp, hoặc chọn phần tử cha ul với Extract Text. Cách thứ hai gộp chữ không có dấu phân cách, ba dòng dính liền nhau. Với dữ liệu cần tách lại sau, tốt hơn là giữ nhiều cột rồi gộp có dấu phân cách trong bảng tính.
Trang có nhiều biến thể
Sản phẩm có nhiều màu hay dung tích thường hiển thị một giá mặc định và đổi giá bằng JavaScript khi chọn biến thể. HTML nguồn chỉ có giá mặc định, DOM render sau khi tải trang cũng vậy. Giá của các biến thể khác thường nằm trong JSON nhúng trong script hoặc trong mảng offers của JSON-LD.
Muốn lấy đủ, dùng regex hay XPath trên JSON-LD với nhiều giá trị, mỗi offer một cột. Render không giúp được vì trình duyệt headless không bấm chọn biến thể.
Phân biệt trống, rỗng và không áp dụng
Bảng xuất chỉ có ô. Nên thêm một cột kiểm tra riêng: đếm số phần tử khớp bằng Function Value, ví dụ count(//span[contains(@class,'price')]). Cột này bằng 0 nghĩa là không có phần tử, lớn hơn 0 mà cột giá rỗng nghĩa là phần tử có nhưng chưa có chữ.
Mã hóa tiếng Việt
CSV của lab ghi UTF-8 có BOM để Excel mở đúng dấu tiếng Việt và ký hiệu ₫. Khi đưa vào công cụ khác như Python hay Google Sheets, BOM không gây hại. Bài sửa lỗi encoding tiếng Việt khi crawl có thêm các trường hợp hay gặp.
Chuẩn hóa sau khi xuất
Giá chữ 1.250.000₫ cần bỏ dấu chấm và ký hiệu trước khi so với giá số. Ngày dạng ISO có múi giờ nên giữ nguyên chuỗi khi lưu, chỉ chuyển kiểu khi phân tích. Chuẩn hóa ở bước sau giúp extractor đơn giản, dễ đọc và dễ sửa.
So extractor trước/sau thay DOM và lưu cấu hình tái sử dụng với Screaming Frog custom extraction
Phần này biến kết quả lab thành quy trình.
Bộ mẫu DOM là tài sản
Ba tệp v1, v2, v3 trong lab là bộ thử nhỏ, mỗi tệp đại diện một tình huống. Với website thật, lưu lại HTML của vài trang tiêu biểu: trang chuẩn, trang thiếu dữ liệu, trang có nhiều giá trị, trang dựng bằng JavaScript. Mỗi lần sửa extractor, chạy lại trên bộ mẫu trước khi crawl cả website.
Ưu tiên theo độ bền
Thứ tự ưu tiên rút ra từ lab như sau. Dữ liệu có cấu trúc như JSON-LD và microdata đứng đầu, thuộc tính data hay meta đứng sau. Tiếp theo là selector theo class có ý nghĩa, cuối cùng mới là đường dẫn theo vị trí. Mỗi bậc xuống là một bậc dễ vỡ hơn.
Bài Pydantic chuẩn hóa dữ liệu crawl có cách kiểm kiểu và giá trị sau khi lấy, phù hợp làm bước tiếp theo sau bảng xuất.
Giữ hai cột cho trường quan trọng
Với trường như giá, giữ hai extractor từ hai nguồn khác nhau: chữ hiển thị và thuộc tính máy đọc. Hai cột khớp nhau là dấu hiệu tốt. Lệch nhau là dấu hiệu website đổi giao diện, hiển thị khuyến mãi, hay dữ liệu có cấu trúc chưa cập nhật.
So kết quả giữa hai lần crawl
Sau mỗi lần crawl, đếm tỷ lệ ô trống của từng cột. Cột giá chữ từ 0 phần trăm trống tăng lên 40 phần trăm trống chỉ sau một tuần là dấu hiệu rõ website đổi giao diện ở một nhóm trang. So tỷ lệ này dễ hơn đọc hàng nghìn dòng.
Chia extractor theo nhóm trang
Website thường có nhiều loại trang: sản phẩm, danh mục, bài viết. Extractor viết cho trang sản phẩm chạy trên trang bài viết chỉ cho ô trống, làm tỷ lệ trống tăng vô nghĩa. Tách lần crawl theo nhóm URL, hoặc lọc bảng xuất theo mẫu URL trước khi tính tỷ lệ trống.
Cột count phần tử ở trên cũng giúp nhận ra loại trang. Trang không có h1 sản phẩm hay không có meta itemprop price thì nhiều khả năng không phải trang sản phẩm.
Dữ liệu cá nhân trong bảng xuất
Extractor có thể vô tình lấy tên, số điện thoại hay email nằm trong phần đánh giá, bình luận hay thông tin người bán. Trước khi crawl lớn, xem các cột Inner HTML và Text trên bộ mẫu để chắc không có dữ liệu cá nhân ngoài ý muốn. Nếu có, thu hẹp biểu thức thay vì lọc sau.
Khi nào bật JavaScript rendering
Chỉ bật khi dữ liệu cần lấy không có trong HTML nguồn dưới bất cứ dạng nào. Render tốn tài nguyên và thời gian hơn nhiều, và kết quả có thể phụ thuộc thời gian chờ. Với v3, ba trường quan trọng nhất đã có trong nguồn, nên không cần render nếu chấp nhận lấy giá số thay vì giá chữ.
Đầu ra nghiệm thu: tệp cấu hình extraction, 3 mẫu DOM và CSV đã kiểm cho Screaming Frog custom extraction
Phần cuối gom lại bộ bàn giao và vai trò của proxy.
Bộ bàn giao
Bộ bàn giao gồm tệp cấu hình SEO Spider đã lưu, kèm bản mô tả dạng văn bản như extractors.json để đọc mà không cần mở công cụ. Thêm bộ mẫu DOM, bảng kết quả trên bộ mẫu cho cả nguồn và render, và bảng tỷ lệ ô trống của lần crawl thật.
Ghi rõ chế độ render đã dùng và lý do. Người nhận cần biết vì sao cột giá chữ trống ở một số trang, và cột nào nên tin khi hai cột lệch nhau.
Giới hạn của lab
Lab không chạy SEO Spider vì không có licence. Biểu thức được kiểm bằng parsel trên lxml và Chrome headless bản đang cài trên máy lab. Cách SEO Spider đặt tên cột nhiều giá trị, định dạng kết quả Function Value và thời gian chờ render có thể khác. Ba mẫu DOM là trang tự viết, không phải website thật.
Tốc độ crawl và quyền
Custom Extraction chạy trong lúc crawl, nên mọi giới hạn tốc độ của SEO Spider vẫn áp dụng. Với website không thuộc quyền quản lý của mình, giảm số luồng, tôn trọng robots.txt và điều khoản sử dụng. Bài robots.txt khi crawl website nói cách đọc các quy tắc.
Khi nào cần proxy với Screaming Frog custom extraction
Extractor không phụ thuộc proxy: cùng HTML cho cùng kết quả dù đi đường nào. Proxy cần khi máy chạy SEO Spider nằm trong mạng bắt buộc đi qua proxy, hoặc khi cần xem website như người dùng tại một quốc gia cụ thể vì nội dung và giá khác theo vùng.
Trường hợp thứ hai ảnh hưởng trực tiếp tới bảng dữ liệu: cùng trang có thể trả giá khác nhau theo IP. Khi đó ghi rõ vị trí IP trong bàn giao. Cách đặt proxy cho SEO Spider có trong bài proxy Screaming Frog. Với nội dung cho người dùng Việt Nam, anh em có thể mua proxy Việt Nam tại trang chủ ProxyVN. Proxy không thay quyền truy cập, như bài Web Scraping proxy là gì đã nói.
Checklist Screaming Frog custom extraction
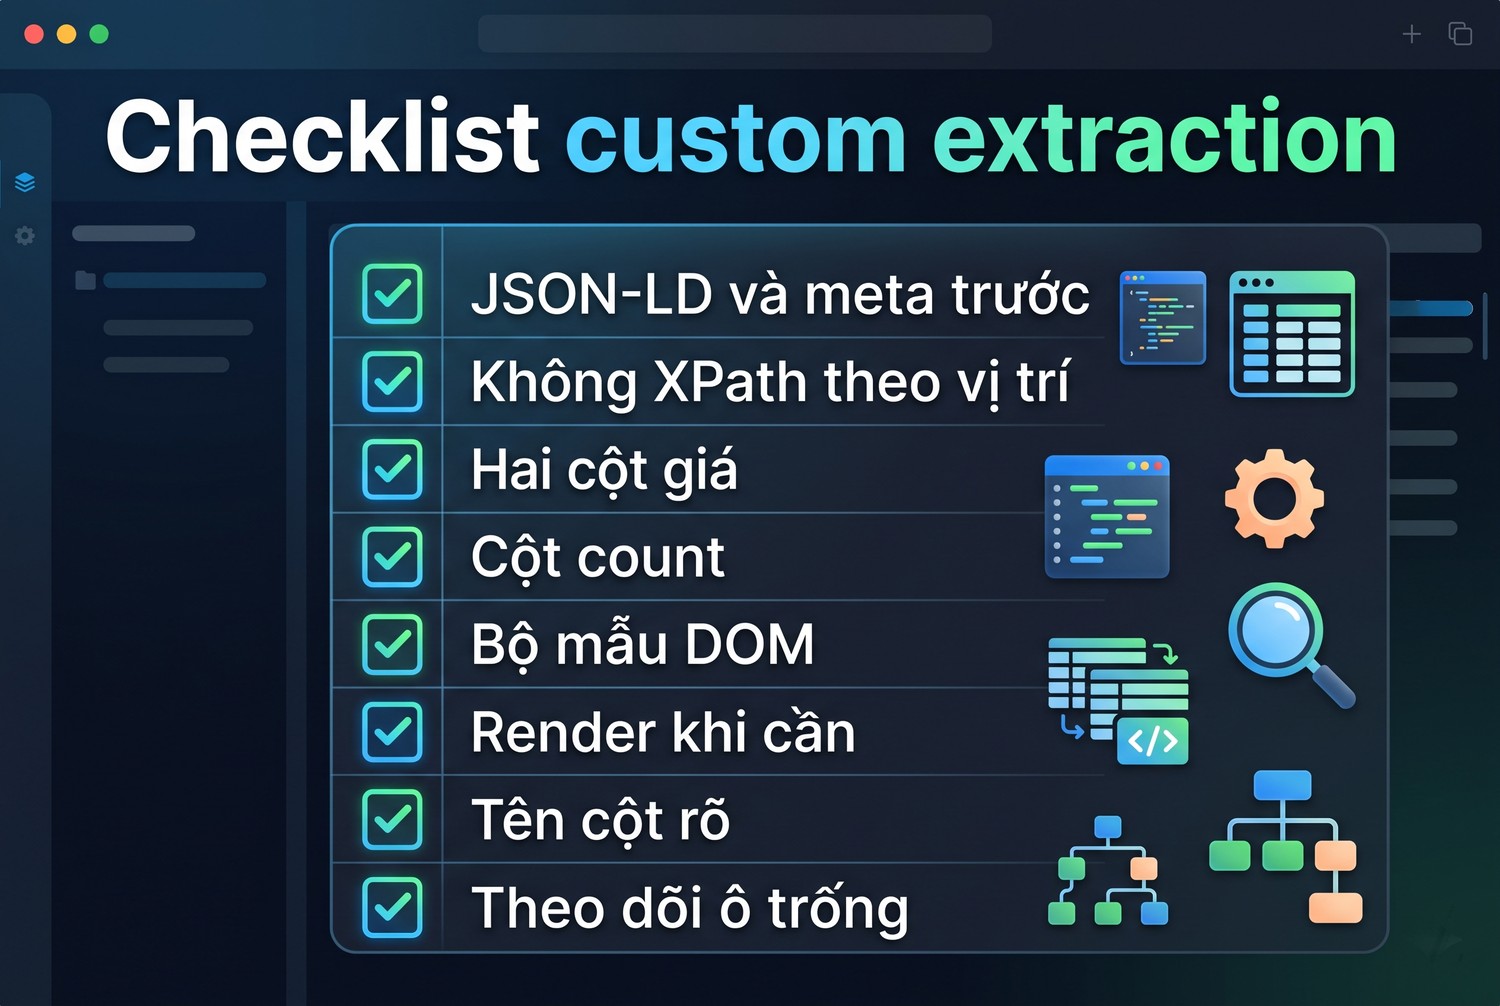
Checklist custom extraction
- Ưu tiên JSON-LD, microdata, thuộc tính data trước chữ hiển thị.
- Không dùng XPath đầy đủ chép từ trình duyệt.
- Giữ hai cột cho trường quan trọng: chữ và thuộc tính.
- Thêm cột count để phân biệt không có phần tử với phần tử rỗng.
- Kiểm trên bộ mẫu DOM trước khi crawl cả website.
- Chỉ bật render khi dữ liệu không có trong HTML nguồn.
- Đặt tên cột rõ nguồn và cách lấy.
- Theo dõi tỷ lệ ô trống qua các lần crawl.
Câu hỏi thường gặp về Screaming Frog custom extraction
Có cần licence để dùng Custom Extraction không?
Có. Tài liệu Screaming Frog nói cần licence để truy cập tính năng này.
Vì sao XPath chép từ trình duyệt hay hỏng?
Nó dựa vào vị trí phần tử và lấy từ DOM đã render. Lab thêm một banner là đủ làm nó không khớp.
Khi nào cần bật JavaScript rendering?
Khi dữ liệu chỉ xuất hiện sau khi script chạy. Kiểm HTML nguồn trước, nhiều trường đã có trong meta hay JSON-LD.
Extract Text khác Inner HTML thế nào?
Extract Text lấy chữ của phần tử và phần tử con. Inner HTML giữ cả thẻ con như b hay a.
Regex có dùng cho JSON-LD được không?
Được, và tài liệu khuyên dùng regex cho dữ liệu ngoài phần tử HTML. Cẩn thận khi trang có nhiều khối JSON-LD.
Proxy có làm đổi kết quả extraction không?
Biểu thức thì không, nhưng nội dung trang có thể khác theo vị trí IP, như giá theo vùng.
Screaming Frog custom extraction và những điều cần nhớ
Screaming Frog custom extraction cho kết quả đúng trên trang mẫu đẹp, nhưng lab ngày 03/11/2026 cho thấy một banner hay một lần đổi class là đủ làm cột giá chữ trống. Thuộc tính meta và JSON-LD đúng ở cả ba mẫu, kể cả trang dựng bằng JavaScript. Kiểm trên bộ mẫu DOM, giữ hai cột cho trường quan trọng. Cần IP Việt Nam cho Screaming Frog custom extraction, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


