
Scrapy FilesPipeline tải tệp: manifest, tên lưu, checksum
Scrapy FilesPipeline tải tệp là pipeline có sẵn trong Scrapy: nó nhận danh sách URL trong trường file_urls của item và tải từng tệp về kho lưu trữ. Kết quả được ghi vào trường files gồm URL, đường dẫn lưu, checksum và trạng thái. Nghe gọn, nhưng khi một tệp dùng chung cho nhiều item, khi tệp lỗi hay khi tên lưu tự đặt bị trùng, kết quả có thể sai mà không có dòng lỗi nào. ProxyVN chạy Scrapy 2.19.0 ngày 03/11/2026 trên một máy chủ tệp giả lập, đối chiếu từng tệp trên đĩa với checksum trong item để dựng một manifest đáng tin.
Scrapy FilesPipeline tải tệp: mục tiêu và phạm vi không lặp
Phần đầu nói rõ bài làm gì, giao gì và dừng ở đâu.
Bài toán
Website catalog, cổng văn bản, trang tài liệu kỹ thuật thường có tệp đính kèm: bảng giá PDF, hướng dẫn sử dụng, ảnh sản phẩm, tệp nén. Đội dữ liệu cần tải các tệp đó và giữ được quan hệ: tệp này thuộc item nào, lấy từ URL nào, nội dung có đổi so với lần trước không.
FilesPipeline lo phần tải và lưu. Phần quan hệ và kiểm chứng phải tự làm, vì pipeline chỉ ghi lại những gì nó tải thành công.
Đầu ra nghiệm thu
Đầu ra là một manifest dạng bảng, mỗi dòng một cặp item và URL. Các cột gồm id item, URL gốc, đường dẫn lưu, checksum, trạng thái pipeline và kết quả kiểm tra trên đĩa. Dòng nào thiếu tệp phải hiện rõ là thiếu, không được biến mất khỏi bảng.
Manifest là thứ người nhận dữ liệu cần. Họ không đọc log Scrapy, họ đọc bảng.
Ranh giới với bài trích văn bản PDF
Bài trích văn bản PDF sau web crawl xử lý bước sau: mở PDF và lấy chữ. Bài này dừng ở việc tải tệp, đặt tên và xác nhận đúng nội dung. Không có bước parse nào ở đây.
Bài cũng không nhắc cấu hình proxy cho Scrapy, phần đó đã có trong bài Scrapy proxy.
Nguồn kiểm chứng
Hành vi được đối chiếu với trang Downloading and processing files and images trong tài liệu Scrapy. Các điểm tài liệu không nêu được kiểm bằng lab và ghi rõ là quan sát trong lab.
Ai nên đọc
Người viết spider có trường file_urls và thấy số tệp trong kho ít hơn số URL. Người phải giao dữ liệu kèm tệp cho khách và cần chứng minh tệp nào ứng với bản ghi nào. Người chạy crawler định kỳ và muốn biết tệp nào đã đổi nội dung.
Theo dõi tệp tải từ item qua Scrapy FilesPipeline tải tệp, tên lưu và checksum
Phần này giải thích pipeline làm gì với một item.
Vòng đời của một item
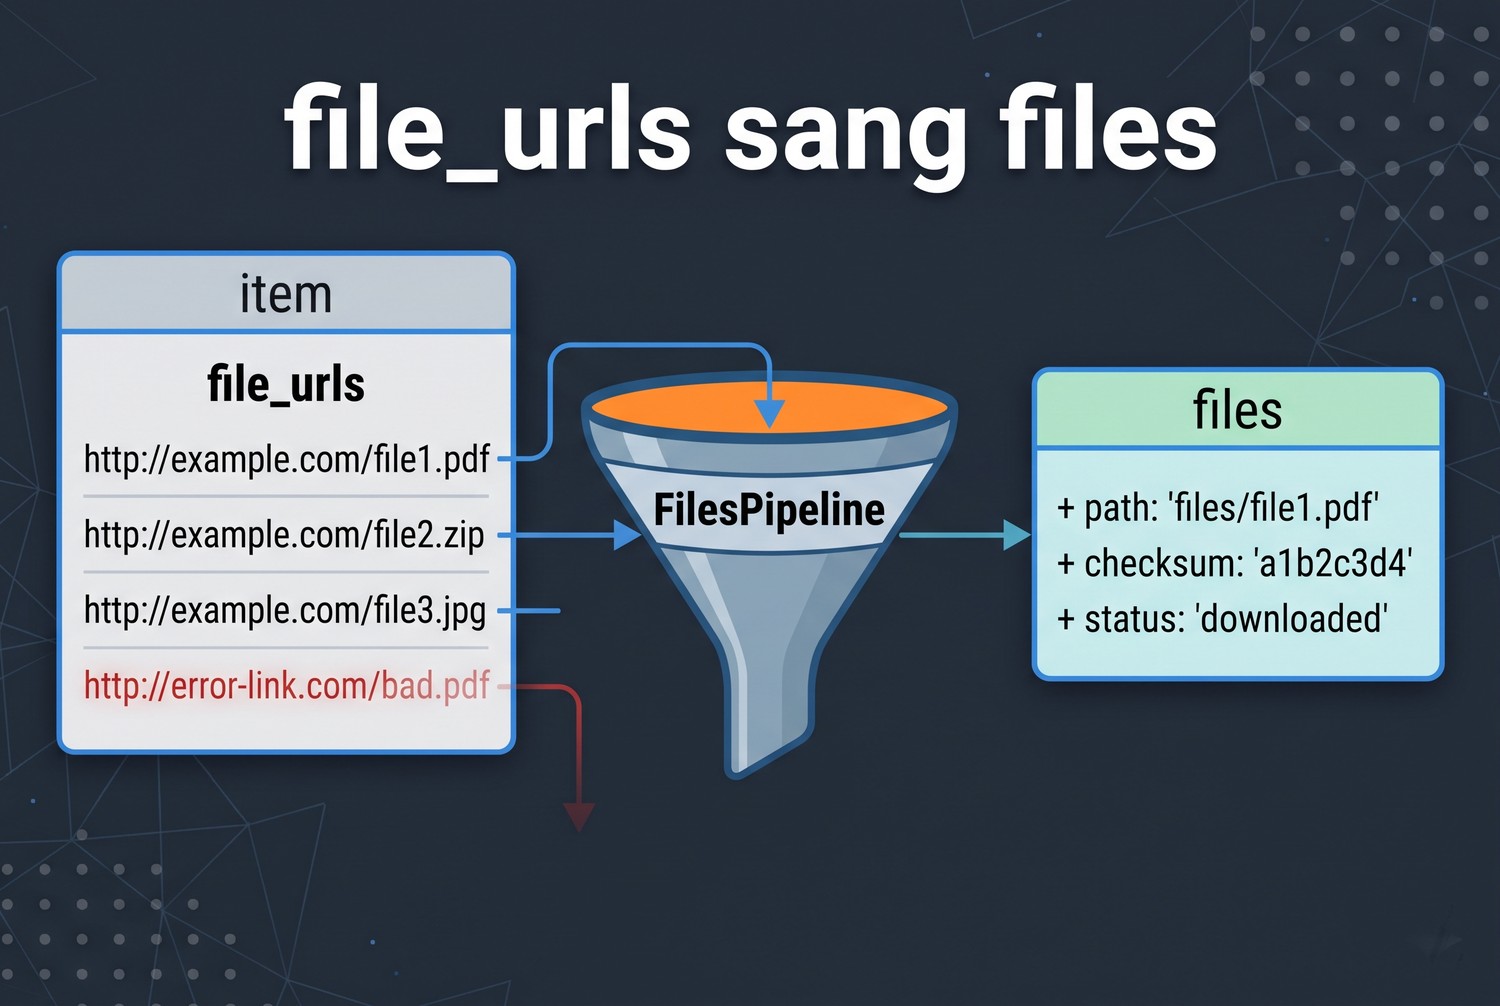
file_urls sang files
Khi item đi vào FilesPipeline, pipeline đọc file_urls, tạo request cho từng URL và gửi qua cùng engine tải của Scrapy. Item bị giữ lại cho tới khi mọi request của nó xong. Sau đó pipeline điền trường files rồi cho item đi tiếp.
Request tải tệp đi qua downloader middleware như mọi request khác. Vì vậy retry, proxy, header mặc định đều áp dụng cho tệp. Lab thấy rõ điều này với tệp trả mã 500: RetryMiddleware thử ba lần trước khi bỏ.
Tên lưu mặc định
Mặc định, tệp được lưu ở thư mục full trong FILES_STORE, tên là mã băm SHA1 của URL cộng đuôi tệp lấy từ URL. Ví dụ chung.pdf thành full/1dd55f6e....pdf. Tên này ổn định: cùng URL luôn ra cùng tên.
Tệp không có đuôi trong URL, như /f/khong-duoi, được lưu không đuôi. Tệp có tham số như anh.jpg?w=800 vẫn lấy đuôi .jpg, và hai URL khác tham số cho hai tên khác nhau vì mã băm tính trên cả URL.
Checksum là MD5 của nội dung
Trường checksum trong files là MD5 của nội dung tệp đã tải. Nó không phải SHA256 và không dùng để chống giả mạo. Nó dùng để biết hai tệp có giống nhau không và tệp trên đĩa có còn nguyên không.
Lab tính lại MD5 của từng tệp trên đĩa và so với checksum trong item. Đây là bước kiểm mà pipeline không tự làm sau khi lưu.
Trạng thái downloaded, uptodate, cached
Trạng thái downloaded là tệp vừa tải trong lần chạy này. Uptodate là tệp đã có trong kho và còn trong hạn FILES_EXPIRES, mặc định 90 ngày, nên không tải lại. Cached là tệp lấy từ HTTP cache của Scrapy nếu bật.
Trạng thái uptodate có ý nghĩa quan trọng mà phần lab sẽ cho thấy: pipeline không hỏi máy chủ tệp có đổi không. Nó chỉ nhìn tuổi của tệp trong kho.
Kho được kiểm theo đường dẫn, không theo URL
Đọc hàm media_to_download trong mã nguồn Scrapy 2.19 sẽ thấy trình tự: pipeline gọi file_path để ra đường dẫn, rồi hỏi kho tệp ở đường dẫn đó đã tồn tại chưa và bao nhiêu tuổi. Nếu tồn tại và chưa quá hạn, pipeline trả trạng thái uptodate mà không tải.
Với tên mặc định, đường dẫn và URL đi đôi với nhau nên không có vấn đề. Với file_path tùy chỉnh, hai URL khác nhau có thể ra cùng đường dẫn. Khi đó lần chạy sau sẽ coi URL thứ hai là đã có, dù tệp trên đĩa là của URL thứ nhất.
Khử trùng trong một lần chạy
Trong cùng một lần chạy, pipeline giữ bộ nhớ tạm theo dấu vân tay request. URL đã tải hay đang tải sẽ không tạo request mới, item sau chờ và nhận cùng kết quả. Đây là lý do chung.pdf chỉ có một request dù hai item cần.
Bộ nhớ tạm này mất khi tiến trình kết thúc. Lần chạy sau chỉ dựa vào kho tệp và FILES_EXPIRES để quyết định có tải hay không.
Tệp lỗi không để lại dấu trong item
Khi tải lỗi, pipeline ghi cảnh báo vào log và bỏ URL đó khỏi trường files. Item vẫn đi tiếp bình thường. Trong lab, item có hai URL đều lỗi đi ra với files là danh sách rỗng, không có trường nào cho biết đã từng có lỗi.
Khai báo file_urls, FILES_STORE và pipeline đang dùng cho Scrapy FilesPipeline tải tệp
Phần này mô tả fixture và cấu hình lab.
Máy chủ tệp giả lập
Máy chủ là http.server của Python ở 127.0.0.1 cổng 9831. Trang chủ liệt kê sáu sản phẩm sp1 đến sp6, mỗi sản phẩm có một hai link tệp. Các tình huống được cài sẵn để thử từng hành vi.
sp1 và sp2 cùng trỏ tới chung.pdf. sp3 có hai ảnh cùng tên anh.jpg, khác tham số w=800 và w=1600. sp4 có một tệp 404 và một tệp luôn trả 500. sp5 trỏ tới chuyen.pdf, thực chất chuyển hướng 302 sang catalog.pdf. sp6 có tệp không đuôi.
Spider và cấu hình
class S(scrapy.Spider):
    name = "lab308"
    custom_settings = {
        "ITEM_PIPELINES": {"scrapy.pipelines.files.FilesPipeline": 1},
        "FILES_STORE": "store",
        "ROBOTSTXT_OBEY": False,
    }
    start_urls = ["http://127.0.0.1:9831/"]

    def parse(self, r):
        for p in r.css("div.p"):
            yield {"id": p.attrib["data-id"],
                   "file_urls": [r.urljoin(u) for u in p.css("a.f::attr(href)").getall()]}
URL phải đầy đủ
file_urls phải chứa URL đầy đủ, có cả giao thức và tên miền. Lab dùng r.urljoin để ghép đường dẫn tương đối với URL trang. Quên bước này, pipeline sẽ báo lỗi URL không hợp lệ cho từng tệp.
FILES_STORE và quyền ghi
FILES_STORE có thể là thư mục cục bộ, đường dẫn S3, Google Cloud Storage hay FTP. Lab dùng thư mục cục bộ. Với kho đám mây, cần thư viện tương ứng và thông tin đăng nhập, những thứ không nên ghi thẳng vào mã nguồn.
Kho đám mây và quyền truy cập
Khi FILES_STORE là s3:// hay gs://, quyền đọc ghi của tài khoản dịch vụ quyết định pipeline có lưu được không. Tài khoản thiếu quyền liệt kê có thể làm bước kiểm kho thất bại, và pipeline sẽ tải lại mọi tệp mỗi lần chạy. Kiểm bằng một spider nhỏ hai tệp trước khi chạy job lớn.
Tệp trên kho đám mây cũng nên đặt quyền riêng tư mặc định. FILES_STORE_S3_ACL trong Scrapy mặc định là private, đừng đổi thành public chỉ để tiện chia sẻ.
Bật pipeline đúng thứ tự
Nếu dự án có pipeline khác cần đọc trường files, như pipeline ghi cơ sở dữ liệu, nó phải có số thứ tự lớn hơn FilesPipeline. Pipeline đứng trước sẽ thấy files chưa có.
Request tệp có tôn trọng robots.txt
Request tải tệp đi qua RobotsTxtMiddleware như mọi request. Nếu robots.txt của website chặn thư mục tệp, tệp sẽ không tải được và chỉ hiện cảnh báo. Lab tắt robots.txt vì máy chủ cục bộ không có tệp này, website thật thì nên giữ mặc định.
Tùy chỉnh file_path và giữ quan hệ tệp với item nguồn trong Scrapy FilesPipeline tải tệp
Tên băm SHA1 khó đọc, nên nhiều người viết lại file_path để lưu theo id item. Lab thử đúng cách làm phổ biến đó.
Cách tùy chỉnh phổ biến
class ItemPathPipeline(FilesPipeline):
    def file_path(self, request, response=None, info=None, *, item=None):
        name = os.path.basename(urlparse(request.url).path) or "index"
        return f"{item['id']}/{name}"
Từ Scrapy 2.4, file_path nhận thêm tham số item, nên lấy id item để đặt thư mục là việc dễ. Kết quả là kho có dạng sp1/bang-gia.pdf, sp2/catalog.pdf, dễ đọc hơn nhiều.
Sự cố một: tệp dùng chung nằm sai thư mục
chung.pdf thuộc cả sp1 lẫn sp2. Pipeline nhận ra cùng URL nên chỉ tải một lần, rồi dùng chung kết quả cho cả hai item. Hệ quả là item sp2 có đường dẫn sp1/chung.pdf. Thư mục sp2 không có chung.pdf.
Ai dựa vào quy ước thư mục theo id để lấy tệp của sp2 sẽ thiếu một tệp. Thứ tự item nào tới trước cũng thay đổi giữa các lần chạy, nên tệp dùng chung có thể nằm ở thư mục khác mỗi lần.
Sự cố hai: hai tệp khác nhau ghi đè lên nhau
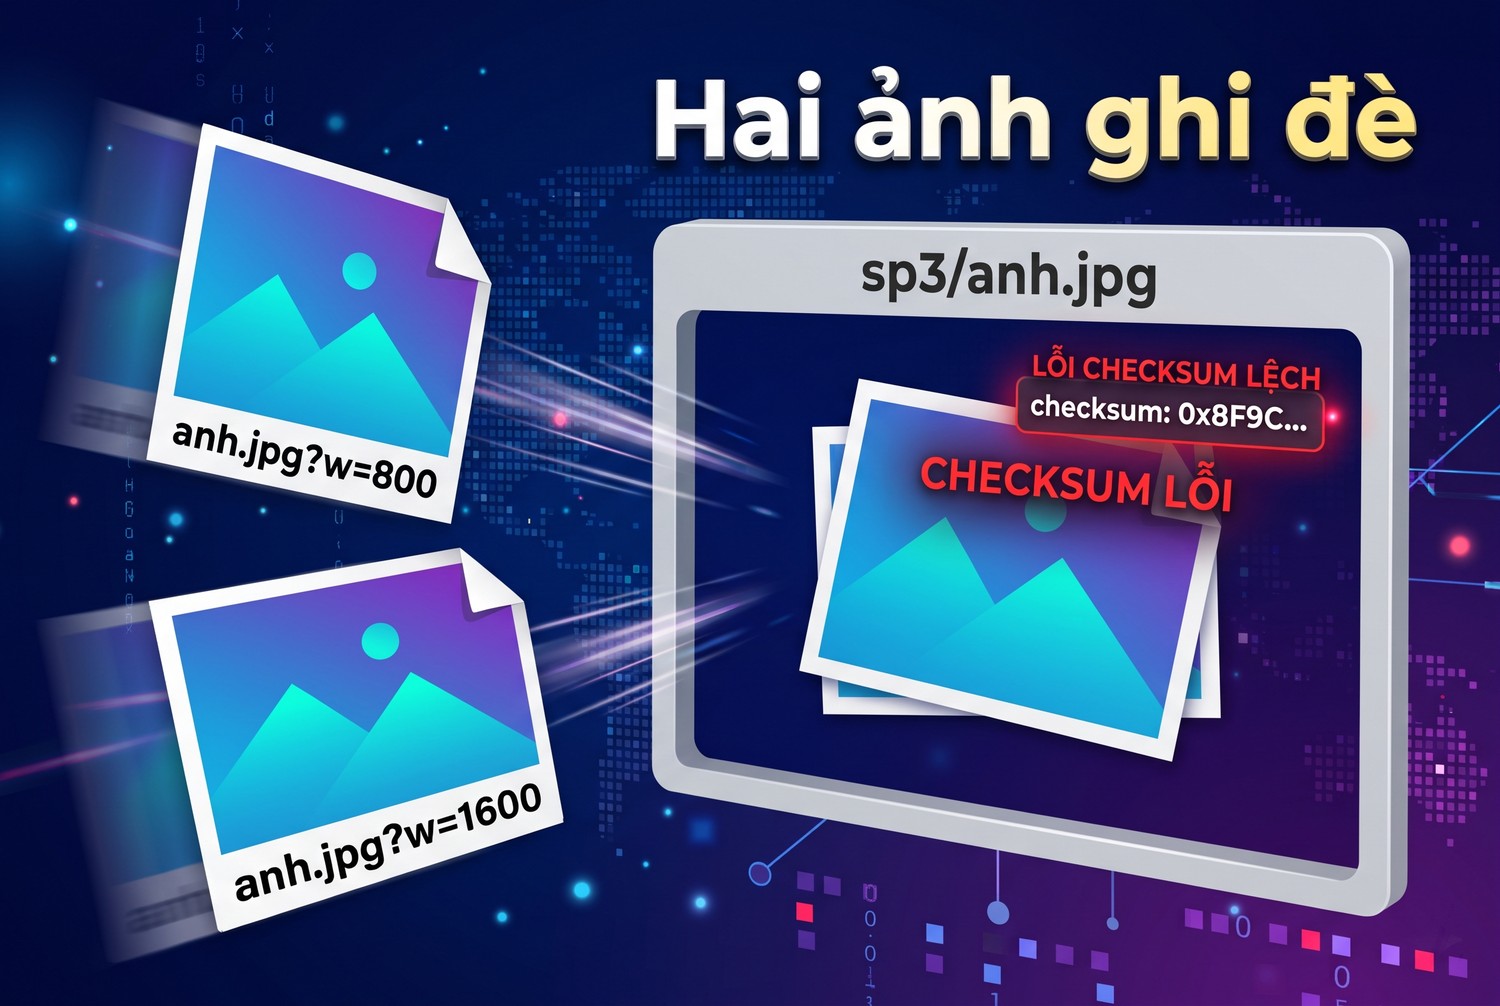
Hai ảnh ghi đè
sp3 có anh.jpg?w=800 và anh.jpg?w=1600. Hàm file_path chỉ lấy tên cuối đường dẫn nên cả hai ra sp3/anh.jpg. Pipeline tải cả hai và ghi cả hai vào cùng một chỗ.
Trên đĩa chỉ còn một tệp 16 byte, đúng là bản 800. Item vẫn ghi hai dòng: dòng w=800 có checksum khớp với tệp, dòng w=1600 có checksum 629da284 không khớp với bất cứ tệp nào. Không có cảnh báo nào trong log.
Tên an toàn cần đủ thông tin
Tên lưu phải khác nhau khi URL khác nhau. Cách đơn giản là giữ mã băm URL trong tên và thêm id item làm tiền tố để dễ đọc, ví dụ sp3/bcaa0da5-anh.jpg. Mã băm đảm bảo duy nhất, tiền tố giúp người xem.
Với tệp dùng chung, nên chấp nhận một bản lưu duy nhất và để manifest ghi rõ item nào dùng tệp nào. Sao chép tệp vào thư mục của mọi item tốn dung lượng và dễ lệch khi tệp cập nhật.
file_path phải tất định
Hàm file_path được gọi cả lúc kiểm kho lẫn lúc lưu. Nếu tên chứa thời gian hiện tại hay số ngẫu nhiên, mỗi lần gọi ra một tên khác. Lần chạy sau sẽ không bao giờ thấy tệp cũ, và kho phình theo số lần chạy.
Tên chỉ nên dựa trên dữ liệu ổn định: URL, id item, mã băm. Nếu cần lưu theo ngày để giữ lịch sử phiên bản, đặt ngày ở cấp thư mục kho và đổi FILES_STORE cho mỗi đợt, không đặt trong file_path.
Kiểm tên trùng trước khi lưu
Một kiểm tra rẻ là giữ từ điển đường dẫn sang URL trong pipeline. Nếu file_path trả về một đường dẫn đã gán cho URL khác, ghi lỗi và thêm mã băm vào tên. Dòng mã nhỏ này chặn được sự cố hai ngay khi xảy ra.
Đọc kết quả tải, checksum và tình huống URL dùng chung với Scrapy FilesPipeline tải tệp
Phần này tổng hợp kết quả bốn lần chạy.
Bảng kết quả theo item
Item |
URL trong file_urls |
Dòng trong files |
Ghi chú lab |
|---|---|---|---|
sp1 |
2 |
2 |
Tải đủ |
sp2 |
2 |
2 |
chung.pdf dùng chung với sp1, tải một lần |
sp3 |
2 |
2 |
Tên mặc định đúng; file_path theo id ghi đè, checksum lệch |
sp4 |
2 |
0 |
404 và 500, item ra với files rỗng |
sp5 |
1 |
0 |
302 bị coi là lỗi khi chưa bật chuyển hướng |
sp6 |
1 |
1 |
Tệp không đuôi lưu không đuôi |
Số request tới máy chủ
Lần chạy đầu, máy chủ nhận 11 request tới thư mục tệp cho 9 URL tệp khác nhau. chung.pdf chỉ một request dù hai item cần. loi500.pdf ba request do RetryMiddleware. Còn lại mỗi URL một request.
Con số này giúp ước lượng tải cho website đích. Tệp lỗi 5xx tốn gấp ba, nên một website có nhiều tệp hỏng sẽ nhận nhiều request hơn dự tính.
Chuyển hướng bị chặn mặc định
chuyen.pdf trả 302. Mặc định MEDIA_ALLOW_REDIRECTS là False, nên pipeline coi 302 là lỗi và ghi cảnh báo File (code: 302). Bật MEDIA_ALLOW_REDIRECTS bằng True thì chuyen.pdf được tải.
Nhưng khi bật, kho có hai tệp cùng nội dung: full/607b352c....pdf cho catalog.pdf và full/6c76fdc5....pdf cho chuyen.pdf, cả hai checksum 3c001129. Tên lưu dựa trên URL gốc trước chuyển hướng, nên nội dung giống nhau vẫn bị lưu hai lần.
Gom trùng theo checksum
Vì checksum có sẵn, manifest có thể nhóm các tệp cùng checksum. Trong lab, nhóm này phát hiện ngay cặp catalog và chuyen. Với website hay dùng link rút gọn hay link theo dõi, bước gom theo checksum giảm dung lượng đáng kể.
ImagesPipeline khác ở đâu
ImagesPipeline kế thừa FilesPipeline nhưng thêm bước xử lý ảnh bằng Pillow: chuyển ảnh sang JPEG, tạo ảnh thu nhỏ theo IMAGES_THUMBS, lọc ảnh nhỏ hơn IMAGES_MIN_WIDTH và IMAGES_MIN_HEIGHT. Checksum vì thế tính trên ảnh sau chuyển đổi, không trên byte gốc.
Nếu mục tiêu là lưu đúng tệp gốc để đối chiếu với nguồn, dùng FilesPipeline cho cả ảnh. Chỉ dùng ImagesPipeline khi thật sự cần ảnh thu nhỏ hoặc cần đồng nhất định dạng.
Cảnh báo không có trang nguồn
Log cảnh báo lỗi tệp có dạng referred in None. Pipeline không ghi trang chứa link. Muốn biết tệp lỗi nằm trên trang nào, phải tự lưu URL trang vào item, ví dụ trường source_url, và đưa vào manifest.
Kiểm tệp lỗi, hết hạn cache và manifest tải lại cho Scrapy FilesPipeline tải tệp
Phần này nói về lần chạy thứ hai và cách dựng manifest.
Lần chạy hai: nội dung đổi nhưng không tải lại
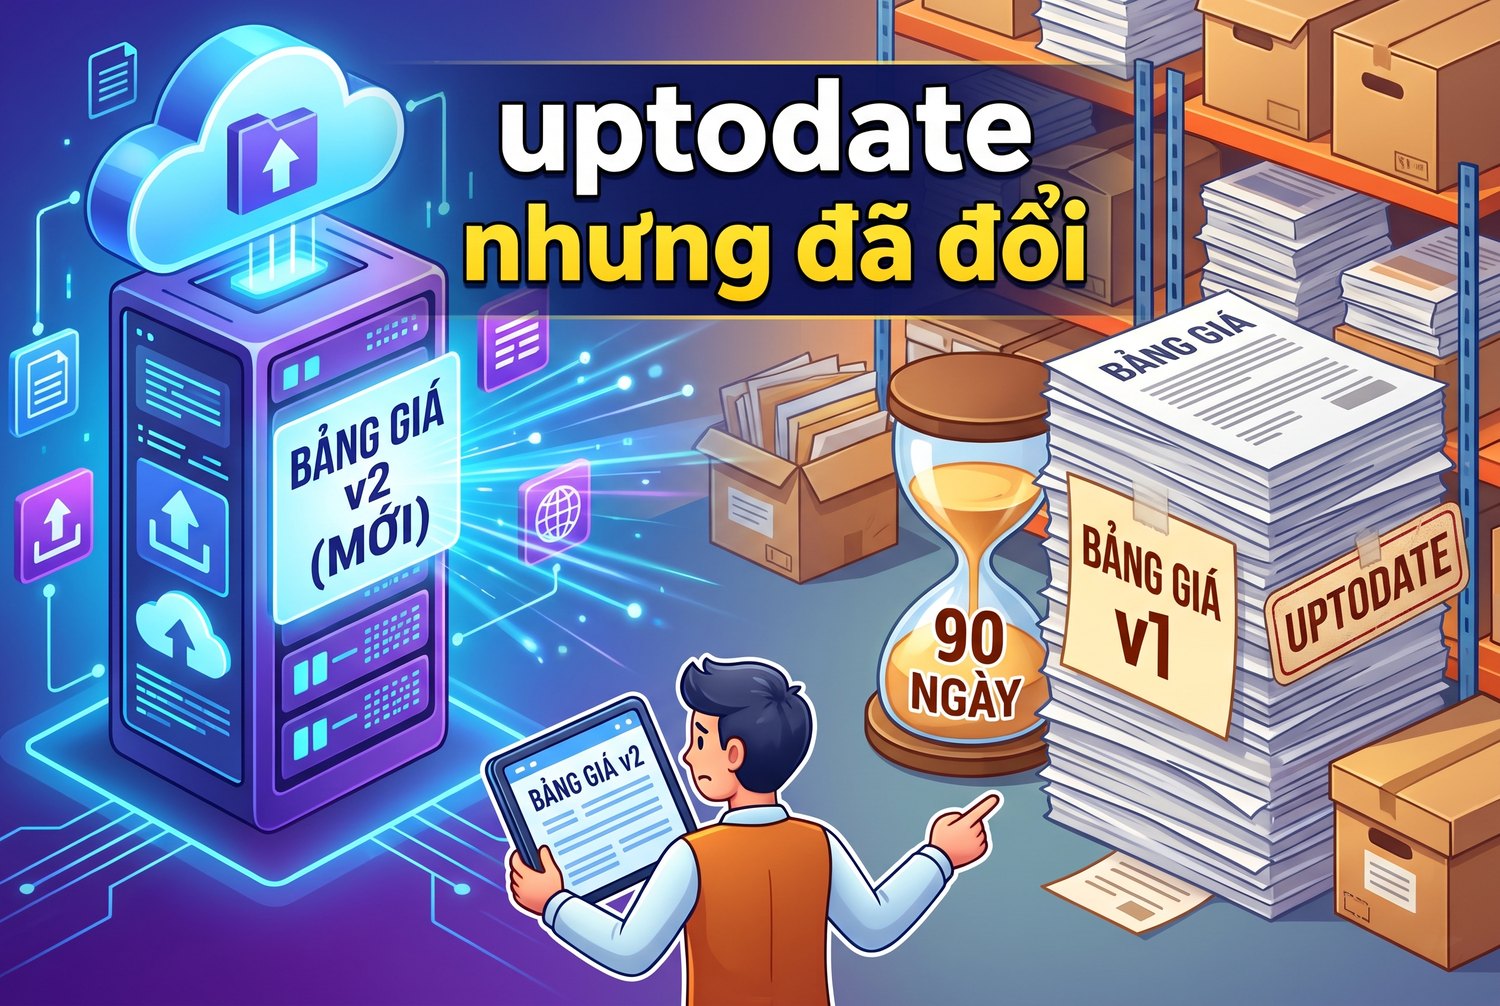
uptodate nhưng đã đổi
Ở lần hai, máy chủ đổi nội dung bang-gia.pdf thành bản v2. Spider chạy lại với cùng FILES_STORE. Kết quả: mọi tệp đã có đều trạng thái uptodate, checksum vẫn là của bản cũ 457f4e0a. Máy chủ chỉ nhận 5 request tới thư mục tệp, toàn là các tệp lỗi được thử lại.
Pipeline không gửi request điều kiện như If-Modified-Since. Nó nhìn ngày sửa của tệp trong kho, thấy còn trong 90 ngày thì bỏ qua. Bảng giá mới không bao giờ về nếu không can thiệp.
Chọn FILES_EXPIRES theo tốc độ đổi của nguồn
FILES_EXPIRES nhận số ngày. Với tài liệu ít đổi như hướng dẫn sử dụng, 90 ngày hợp lý. Với bảng giá đổi hằng tuần, nên đặt nhỏ hơn hoặc bằng 0 để luôn tải lại. Cách cân bằng là tách hai loại tệp sang hai spider hay hai pipeline có hạn khác nhau.
Nếu muốn tải lại theo điều kiện thật, phải tự viết: lưu ETag hay Last-Modified trong manifest, gửi HEAD hay GET có điều kiện ở lần sau, chỉ đưa URL đổi vào file_urls.
Script dựng manifest
for it in rows:
    got = {f["url"]: f for f in it.get("files", [])}
    for u in it["file_urls"]:
        f = got.get(u)
        if not f:
            out.append([it["id"], u, "", "", "MISSING", ""]); continue
        md5 = hashlib.md5(open(os.path.join(store, f["path"]), "rb").read()).hexdigest()
        out.append([it["id"], u, f["path"], f["checksum"], f["status"],
                    "OK" if md5 == f["checksum"] else "LECH"])
Script đọc tệp item jsonlines, so file_urls với files theo từng URL, rồi tính lại MD5 trên đĩa. URL không có trong files ghi MISSING. Tệp có checksum khác trên đĩa ghi LECH.
Kiểm Content-Type và kích thước
Pipeline lưu bất cứ thứ gì máy chủ trả với mã 200. Nếu link PDF bị đổi thành trang đăng nhập hay trang thông báo, kho sẽ có một tệp đuôi .pdf chứa HTML. Checksum vẫn khớp, manifest vẫn ghi OK, nhưng tệp vô dụng.
Cách chặn là ghi đè file_downloaded hoặc thêm một bước sau pipeline để đọc vài byte đầu. PDF bắt đầu bằng %PDF, JPEG bằng FF D8 FF, ZIP bằng PK. Tệp không khớp chữ ký thì đánh dấu SAI_LOAI trong manifest. Trong lab, các tệp giả lập đều có chữ ký đúng ở đầu, nên phép kiểm này đều đạt.
Ghi trang nguồn vào item
yield {"id": p.attrib["data-id"], "source_url": r.url,
       "file_urls": [r.urljoin(u) for u in p.css("a.f::attr(href)").getall()]}
Thêm source_url vào item giúp manifest trả lời được câu hỏi tệp lỗi nằm ở trang nào, điều mà log của pipeline không làm. Với website có nhiều trang trỏ tới cùng tệp, có thể giữ danh sách các trang nguồn thay vì một giá trị.
Kết quả manifest trong lab
Với tên lưu mặc định, manifest có 10 dòng: 7 dòng OK và 3 dòng MISSING cho mat.pdf, loi500.pdf và chuyen.pdf. Với file_path theo id, manifest có 6 dòng OK, 1 dòng LECH cho anh.jpg?w=1600 và 3 dòng MISSING.
Dòng LECH là bằng chứng duy nhất cho sự cố ghi đè. Không có manifest kiểm trên đĩa, lỗi này sẽ đi thẳng tới khách hàng.
Lưu ETag và Last-Modified để tải có điều kiện
def file_downloaded(self, response, request, info, *, item=None):
    path = super().file_downloaded(response, request, info, item=item)
    meta = {"etag": response.headers.get("ETag", b"").decode(),
            "last_modified": response.headers.get("Last-Modified", b"").decode()}
    self.headers_log[request.url] = meta
    return path
Ghi đè file_downloaded để lưu thêm hai header ETag và Last-Modified vào một từ điển, rồi xuất cùng manifest khi spider đóng. Lần chạy sau, một bước kiểm trước gửi HEAD hoặc GET có If-None-Match. Máy chủ trả 304 thì giữ tệp cũ, trả 200 thì đưa URL vào danh sách tải lại và xóa tệp cũ khỏi kho.
Không phải máy chủ nào cũng gửi hai header này. Khi thiếu cả hai, chỉ còn cách tải lại và so checksum, tốn băng thông nhưng chắc.
Dọn tệp mồ côi
Theo thời gian, kho tích tụ tệp không còn item nào trỏ tới: sản phẩm đã gỡ, link đã đổi, tệp tải nhầm do file_path cũ. Manifest giúp dọn: lấy tập đường dẫn trong manifest mới nhất, so với danh sách tệp trong kho, phần thừa là mồ côi.
Đừng xóa ngay. Chuyển sang thư mục cách ly vài tuần, vì có thể có job khác cũng dùng chung kho. Xóa hẳn sau khi chắc không ai cần.
Tải lại những dòng MISSING
Manifest cũng là danh sách việc cho lần sau. Lọc các dòng MISSING, phân loại theo mã lỗi trong log: 404 thường là link chết thật, không cần thử lại; 5xx và timeout nên thử lại sau vài giờ; 302 cần quyết định có bật chuyển hướng không.
Bài lỗi 410 Gone khi crawl bàn cách xử lý tài nguyên đã bị gỡ hẳn, một trường hợp hay gặp với tệp đính kèm cũ.
Đầu ra nghiệm thu: manifest URL gốc, đường dẫn tệp, checksum và tình huống tải lỗi của Scrapy FilesPipeline tải tệp
Phần cuối gom lại bộ bàn giao và vai trò của proxy.
Bộ bàn giao
Bộ bàn giao gồm thư mục tệp, manifest CSV với cột kiểm trên đĩa, và bảng tổng: số URL, số tệp tải, số MISSING theo mã lỗi, số LECH, số nhóm trùng checksum. Kèm cấu hình FILES_EXPIRES và MEDIA_ALLOW_REDIRECTS đã dùng, để người nhận biết vì sao tệp có hay không.
Định dạng CSV hay JSON cho manifest đều được. Bài JSON và CSV khi crawl dữ liệu so sánh hai lựa chọn này.
Giới hạn tệp lớn
Mặc định Scrapy giới hạn kích thước phản hồi qua DOWNLOAD_MAXSIZE là 1 GiB và cảnh báo từ DOWNLOAD_WARNSIZE 32 MiB. Tệp video hay tệp nén lớn có thể chạm giới hạn này và bị hủy. Pipeline giữ cả nội dung tệp trong bộ nhớ trước khi ghi, nên nhiều tệp lớn cùng lúc sẽ tốn RAM.
Với tệp vài trăm MB, cân nhắc chỉ lưu URL và tải riêng bằng công cụ tải theo luồng thay vì qua pipeline.
Tốc độ tải tệp
Request tệp tính chung vào CONCURRENT_REQUESTS_PER_DOMAIN và DOWNLOAD_DELAY của tên miền chứa tệp. Một trang có 20 tệp đính kèm sẽ sinh 20 request gần như cùng lúc nếu giới hạn cho phép. Website nhỏ có thể coi đó là tải bất thường.
Bật AutoThrottle hay đặt độ trễ riêng cho tên miền tệp là cách lịch sự. Nếu tệp nằm trên CDN của bên thứ ba, giới hạn của CDN thường cao hơn, nhưng điều khoản sử dụng vẫn áp dụng.
Dữ liệu cá nhân trong tệp
Tệp đính kèm hay chứa thông tin mà trang HTML không có: hồ sơ, hóa đơn, danh sách người tham gia. Trước khi tải hàng loạt, xem mẫu vài tệp. Nếu có dữ liệu cá nhân, cần cơ sở pháp lý để thu và chính sách lưu trữ, xóa phù hợp.
Manifest cũng nên ghi rõ loại tệp và mục đích sử dụng, để người nhận biết cần bảo vệ kho ở mức nào.
Giới hạn của lab
Lab dùng máy chủ cục bộ, tệp nhỏ, một lần chạy cho mỗi cấu hình. Chưa thử kho S3 hay GCS, chưa thử ImagesPipeline với ảnh thật, chưa thử tệp lớn hàng trăm MB. Thứ tự xử lý item có thể đổi giữa các lần chạy, nên thư mục chứa tệp dùng chung không cố định.
Khi nào cần proxy với Scrapy FilesPipeline tải tệp
Request tệp đi qua cùng middleware với request trang, nên proxy đặt cho spider cũng áp dụng cho tệp. Cần chú ý khi tệp nằm trên tên miền khác, như CDN hay kho đám mây của website. Middleware gán proxy theo tên miền có thể bỏ sót tên miền tệp.
Proxy cần khi máy chạy crawler phải ra ngoài qua proxy của tổ chức, hoặc khi website cung cấp tệp chỉ cho phép một IP cố định đã đăng ký. Với tệp lớn và job dài, proxy tĩnh ổn định hơn proxy xoay vì đổi IP giữa chừng có thể làm đứt kết nối tải. Anh em có thể mua proxy tĩnh Việt Nam tại trang chủ ProxyVN. Chuỗi proxy có mật khẩu nên viết theo bài định dạng proxy.
Proxy không đổi quyền với tệp. Tệp có bản quyền hay giới hạn sử dụng vẫn giữ nguyên điều kiện đó, như bài Web Scraping proxy là gì đã nhắc.
Checklist Scrapy FilesPipeline tải tệp
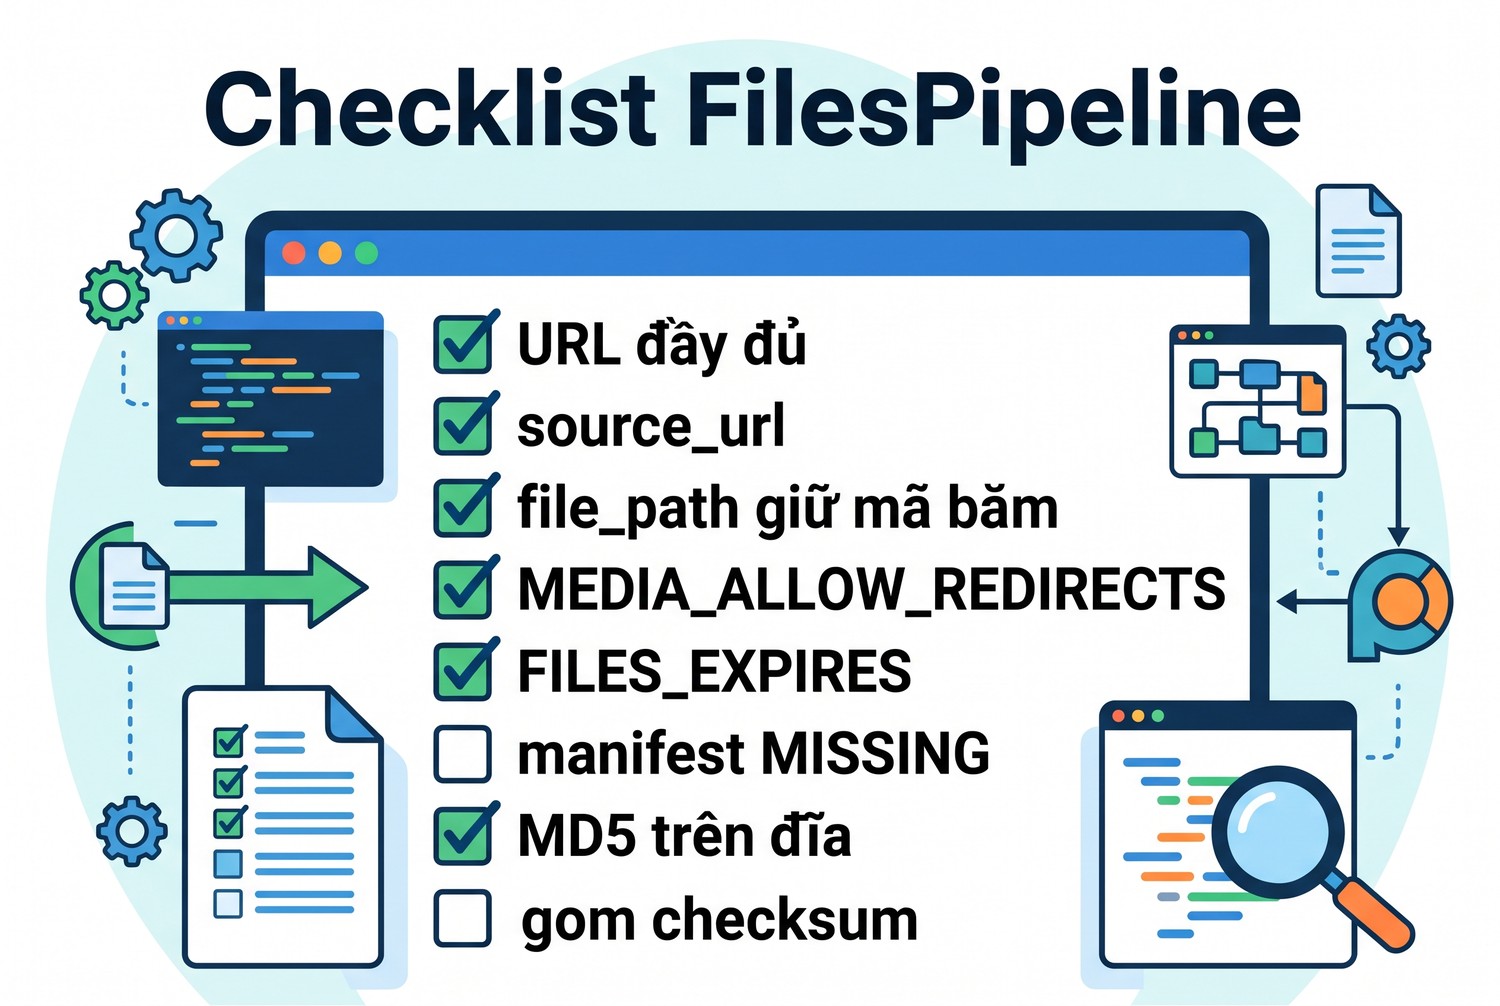
Checklist FilesPipeline
- file_urls chứa URL đầy đủ, item có thêm source_url.
- Pipeline đọc files đặt sau FilesPipeline.
- file_path tùy chỉnh phải giữ mã băm URL hoặc kiểm tên trùng.
- Quyết định MEDIA_ALLOW_REDIRECTS và ghi vào bàn giao.
- FILES_EXPIRES theo tốc độ đổi của nguồn.
- Manifest so file_urls với files, ghi MISSING.
- Tính lại MD5 trên đĩa, ghi LECH.
- Gom nhóm theo checksum để phát hiện tệp trùng.
Câu hỏi thường gặp về Scrapy FilesPipeline tải tệp
Vì sao số tệp trong kho ít hơn số URL?
Tệp lỗi bị bỏ khỏi files mà không báo trong item, URL dùng chung chỉ tải một lần, và file_path trùng tên làm tệp ghi đè nhau.
Checksum trong files là gì?
MD5 của nội dung tệp. Dùng để so trùng và kiểm tệp trên đĩa, không dùng để chống giả mạo.
Vì sao tệp đổi nội dung mà vẫn uptodate?
Pipeline chỉ nhìn tuổi tệp trong kho so với FILES_EXPIRES, mặc định 90 ngày, không hỏi máy chủ.
Vì sao tệp chuyển hướng bị lỗi 302?
MEDIA_ALLOW_REDIRECTS mặc định False. Bật lên thì tải được, nhưng có thể lưu trùng nội dung.
Đặt tên theo id item có an toàn không?
Chỉ an toàn khi tên vẫn khác nhau cho URL khác nhau. Lab cho thấy hai ảnh cùng tên ghi đè và checksum lệch.
Tệp có đi qua proxy của spider không?
Có. Request tệp đi qua downloader middleware, kể cả retry và proxy.
Scrapy FilesPipeline tải tệp và những điều cần nhớ
Scrapy FilesPipeline tải tệp gọn và ổn định, nhưng không tự báo tệp lỗi trong item, không tải lại tệp đổi nội dung trong hạn 90 ngày, và để file_path tùy chỉnh ghi đè lên nhau. Lab ngày 03/11/2026 phát hiện cả ba nhờ manifest so URL với files và tính lại MD5 trên đĩa. Cần IP thoát ổn định cho job Scrapy FilesPipeline tải tệp, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


