
ScraperAPI async jobs: sổ job, thời hạn kết quả và khởi động lại
ScraperAPI async jobs là cách gửi URL cần tải vào hàng đợi của ScraperAPI, nhận về một mã job và một đường dẫn trạng thái, rồi quay lại lấy kết quả khi job xong. Cách này hợp với lô lớn hoặc trang khó tải, vì không phải giữ kết nối chờ. Đổi lại, người dùng phải tự quản lý danh sách job: job nào đang chạy, job nào xong, kết quả đã lưu chưa. ProxyVN đọc tài liệu Job Handling ngày 03/11/2026, gọi endpoint thật với khóa giả, rồi chạy một sổ job bằng SQLite trên máy chủ mô phỏng theo đúng định dạng trong tài liệu, có cài hai lần tiến trình sập. Bài ghi lại số job thực tế phải tạo cho sáu URL.
ScraperAPI async jobs: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và giới hạn.
Bài toán
Một nhóm cần tải vài nghìn trang sản phẩm mỗi đêm qua ScraperAPI. Gọi đồng bộ từng trang làm tiến trình giữ hàng trăm kết nối và dễ hết thời gian chờ. Async API cho phép gửi hết rồi quay lại lấy. Câu hỏi là làm sao không mất URL nào, không tạo job trùng khi tiến trình khởi động lại, và không để kết quả hết hạn trước khi lấy.
Đầu ra nghiệm thu
Đầu ra là một sổ job ghi trạng thái cuối của từng URL, gồm cả ca job thất bại mà URL nguồn vẫn được giữ. Kèm theo là số job thực tế máy chủ nhận được, để thấy chi phí của từng sự cố.
Ranh giới với batch của Firecrawl
Firecrawl có API batch với hợp đồng riêng: một lần gửi nhiều URL, một mã batch. ScraperAPI async trong bài này là một job cho một URL, mỗi job một đường dẫn trạng thái. Hai hợp đồng khác nhau ở cách nhận diện kết quả và cách hết hạn. Bài không dùng chung mã polling cho cả hai.
Giới hạn của lab
Lab không có tài khoản ScraperAPI. Gửi job thật với khóa giả nhận HTTP 401 dạng văn bản. Hỏi một mã job mẫu trong tài liệu nhận HTTP 404 với nội dung no such job. Mọi phép thử sổ job chạy trên máy chủ mô phỏng ở cổng 9431, trả về đúng cấu trúc JSON trong tài liệu. Thời gian chạy job trong mô phỏng là ba lần hỏi, không phản ánh thời gian thật.
Ai nên đọc
Người dùng ScraperAPI cho lô lớn và đang cân nhắc chuyển từ gọi đồng bộ sang async. Người đã dùng async nhưng thấy số credit tiêu cao hơn số URL. Người viết pipeline cần chạy lại an toàn sau khi máy chủ khởi động lại giữa chừng.
Khi nào nên dùng async
Async hợp khi lô lớn, khi trang đích chậm hoặc cần nhiều lần thử phía nhà cung cấp, và khi tiến trình gọi không muốn giữ kết nối lâu. Với vài chục URL mỗi ngày, gọi đồng bộ đơn giản hơn và không cần sổ job. Lợi ích của async chỉ rõ khi số URL đủ lớn để việc giữ kết nối trở thành vấn đề.
Mỗi job là một request có tính phí
Theo cách ScraperAPI tính phí theo request thành công, mỗi job tạo ra có thể tính credit khi chạy xong. Job trùng là credit trùng. Lab đếm số job máy chủ nhận để biết mỗi sự cố tốn thêm bao nhiêu. Mức credit cụ thể mỗi job lab không kiểm được.
Theo dõi async job ScraperAPI với ID và thời hạn kết quả theo đúng docs với ScraperAPI async jobs
Phần này tóm tắt tài liệu chính thức.
Gửi job
Theo trang Job Handling trong tài liệu ScraperAPI, gửi job bằng POST tới https://async.scraperapi.com/jobs với thân JSON chứa apiKey và url. Phản hồi có id, status bằng running, statusUrl và url.
Hỏi trạng thái
statusUrl là đường dẫn riêng của job. Gọi GET vào đó khi job đang chạy nhận lại thông tin job với status running. Khi job xong, phản hồi có status bằng finished và thêm khối response chứa headers, body và statusCode của trang đích.
Thời hạn kết quả
Tài liệu ghi kết quả của job async được lưu tối đa 72 giờ, bảo đảm 24 giờ, hoặc cho tới khi bạn lấy kết quả, tùy điều nào tới trước. Quá hạn thì kết quả bị xóa và phải gửi lại request. Câu hoặc cho tới khi bạn lấy kết quả là chi tiết quan trọng nhất của cả bài.
Phản hồi lỗi là văn bản
Cả 401 lẫn 404 đều trả văn bản thuần, trong khi phản hồi thành công là JSON. Mã đọc phản hồi phải kiểm mã trạng thái trước khi gọi json(). Lab kiểm 404 trước, rồi mới đọc JSON. Thứ tự ngược lại sẽ ném lỗi giải mã JSON và che mất nguyên nhân thật.
Hủy job
Tài liệu cho phép hủy job đang chạy bằng DELETE vào đường dẫn job. Lab có cài DELETE trong máy chủ mô phỏng nhưng không dùng trong các ca chính.
Trường meta
Có thể gửi kèm đối tượng meta chứa dữ liệu riêng, ví dụ mã request của bạn. Tài liệu ghi meta được trả lại trong phản hồi. Lab gửi meta chứa URL nguồn để có thể ghép kết quả với URL kể cả khi mất mã job.
Batch và callback
Mục lục tài liệu có các trang Batch Requests và Callbacks, nằm cùng nhóm Async API. Batch cho gửi nhiều URL một lần, callback cho nhà cung cấp gọi ngược về máy chủ của bạn khi job xong. Lab chỉ làm theo trang Job Handling, không thử hai trang kia. Với callback, câu hỏi về kết quả bị mất khi sập sẽ chuyển sang phía máy chủ nhận callback.
Trạng thái nào có thể xuất hiện
Trang Job Handling chỉ nêu hai trạng thái running và finished. Tài liệu không liệt kê trạng thái lỗi trên trang này. Lab không bịa thêm trạng thái. Mã trong lab coi mọi trạng thái không phải running hay finished là bất thường, ghi lại nguyên văn để người xem xét.
Gửi URL vào async endpoint và lưu job ID trong ScraperAPI async jobs
Phần này ghi lại lần gọi thật và cách dựng sổ job.
Gọi thật với khóa giả
Lab gửi POST tới async.scraperapi.com/jobs với apiKey bằng FAKEKEY123. Phản hồi là HTTP 401, Content-Type text/html, nội dung Unauthorized request. Please check your API key and try again. Phản hồi lỗi là văn bản, không phải JSON. Mã gọi resp.json() trên phản hồi này sẽ ném lỗi.
Job không tồn tại
Lab gọi GET vào đường dẫn của mã job mẫu trong tài liệu. Phản hồi là HTTP 404 với nội dung no such job kèm mã. Đây cũng là văn bản. Máy chủ mô phỏng trả đúng hai dạng này cho ca lỗi.
Vì sao dùng SQLite
Sổ job cần ghi bền, đọc lại sau khi sập, và cập nhật từng dòng. Tệp JSON ghi đè cả tệp mỗi lần, dễ hỏng nếu sập giữa lúc ghi. SQLite ghi theo giao dịch, sập giữa chừng thì giao dịch dở bị bỏ, dữ liệu cũ còn nguyên. Với một tiến trình, SQLite là đủ. Nhiều tiến trình thì cần cơ sở dữ liệu có khóa dòng tốt hơn.
Sổ job bằng SQLite
db.execute("""create table if not exists jobs(
    url text primary key, job_id text, status text,
    submitted_at real, target_status int, result_path text, note text)""")
Khóa chính là URL, không phải mã job. Mỗi URL một dòng, dù đã tạo bao nhiêu job cho nó. Mã job là thuộc tính có thể thay đổi khi gửi lại.
Ghi ý định trước khi gửi
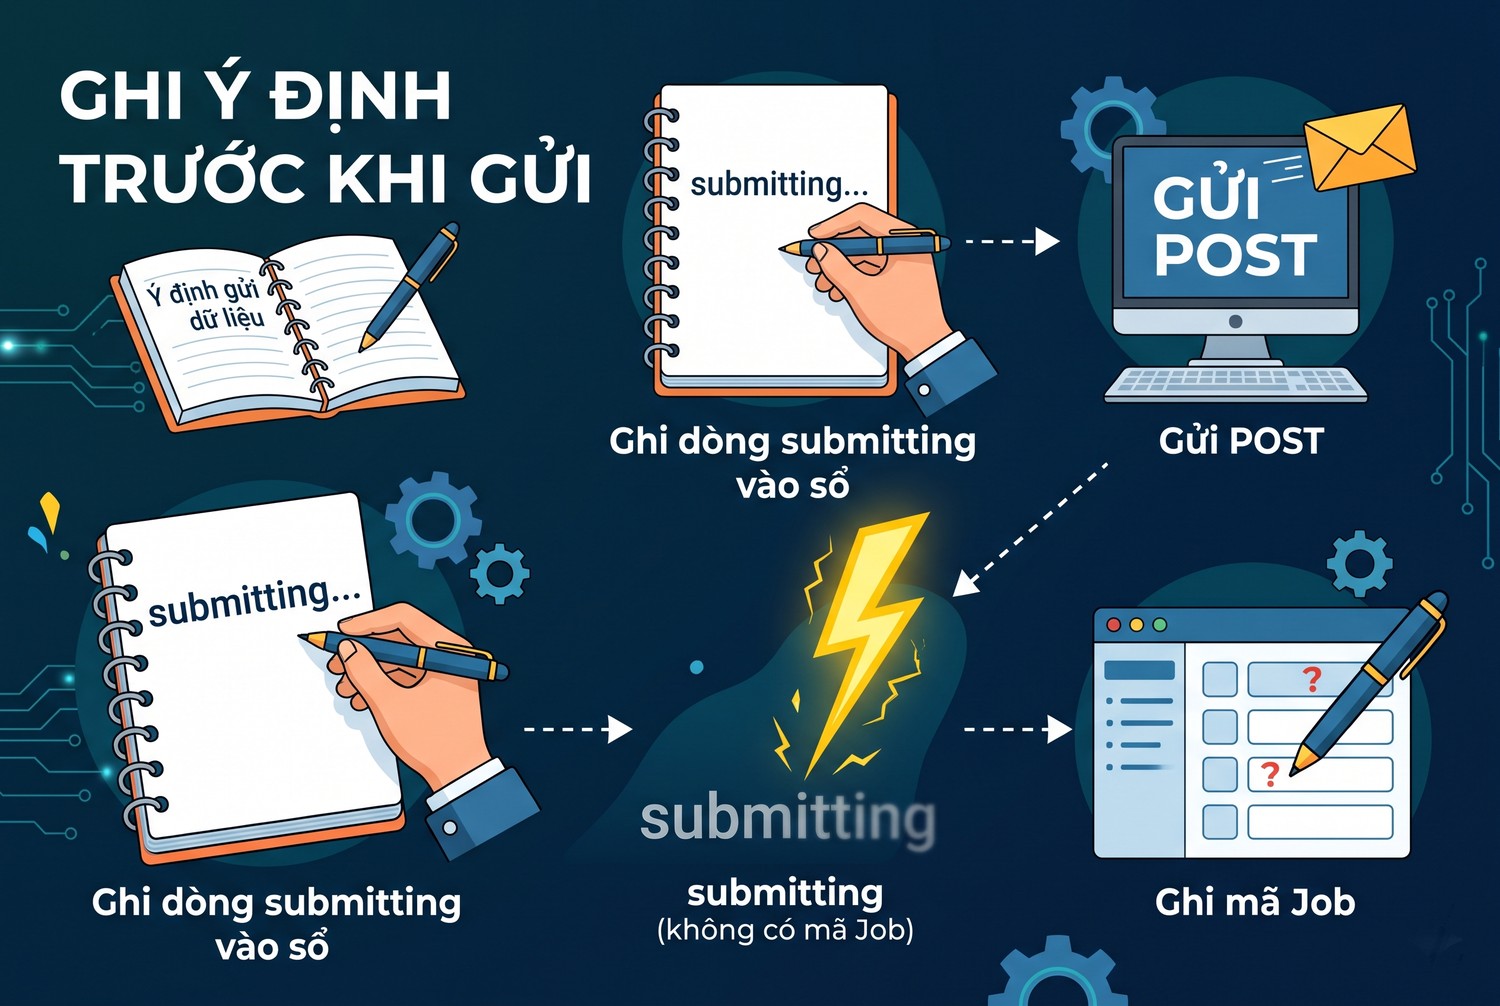
Ghi ý định trước khi gửi
Trước khi POST, mã ghi một dòng với trạng thái submitting. Sau khi nhận phản hồi, mã cập nhật mã job và trạng thái running. Nếu tiến trình sập giữa hai bước, dòng submitting cho biết URL đó đang ở trạng thái không rõ: có thể đã tạo job, có thể chưa.
Một hàm gửi, một hàm hỏi
Mã chia hai hàm: submit chỉ gửi job và ghi sổ, poll chỉ hỏi trạng thái và lưu kết quả. Hai hàm chạy độc lập, có thể chạy ở hai tiến trình hay hai thời điểm khác nhau. Sổ là chỗ duy nhất hai hàm trao đổi thông tin.
Sáu URL thử
Bốn URL sản phẩm thường, một URL trang đích trả 404, một URL mà job sẽ hết hạn trước khi lấy. Máy chủ mô phỏng nhận biết các ca đặc biệt qua chuỗi trong URL.
Bước 1: sập sau khi gửi URL thứ ba
Mã gửi p/1, p/2, rồi p/3. Ngay sau POST của p/3, trước khi ghi mã job, tiến trình sập. Sổ có p/1 và p/2 running với mã job, p/3 submitting không có mã. Máy chủ đã nhận ba job.
Thời điểm sập được chọn có chủ ý
Lab cố ý sập đúng giữa POST và ghi sổ, khoảng thời gian rất ngắn. Trong thực tế, xác suất sập đúng lúc này thấp. Nhưng với hàng nghìn URL mỗi đêm và máy chủ có thể khởi động lại bất cứ lúc nào, sớm muộn cũng sẽ gặp. Mã phải xử lý được ca hiếm, không chỉ ca thường.
Bước 2: chạy lại phần gửi
Mã đọc sổ, bỏ qua URL đã running. Gặp p/3 ở trạng thái submitting, mã không biết job đã được tạo hay chưa, và không có cách hỏi máy chủ theo URL. Mã chọn gửi lại. Máy chủ nhận job thứ hai cho p/3. Ba URL còn lại được gửi bình thường. Tổng số job trên máy chủ là 7 cho 6 URL.
Vì sao không hỏi được máy chủ
Trang tài liệu không mô tả endpoint liệt kê job theo URL hay theo meta. Không có cách nào, chỉ với mã của mình, biết job thứ nhất của p/3 có tồn tại không. Đây là giới hạn thật của hợp đồng: sau sự cố giữa POST và ghi sổ, chỉ có thể chấp nhận gửi trùng, hoặc bỏ URL đó và kiểm tay.
Đọc trạng thái job cùng thời hạn truy cập kết quả theo docs của ScraperAPI async jobs
Phần này chạy bước hỏi trạng thái, có cài sự cố thứ hai.
Hàm hỏi trạng thái
for u, jid in running_jobs:
    for _ in range(5):
        r = requests.get(f"{B}/{jid}", timeout=30)
        if r.status_code == 404:
            mark(u, "expired", r.text[:40]); break
        j = r.json()
        if j["status"] == "running": continue
        if j["status"] != "finished":
            mark(u, j["status"], "trang thai la"); break
        save_body(jid, j["response"]["body"])
        sc = j["response"]["statusCode"]
        mark(u, "done" if sc == 200 else "target_error", target_status=sc); break
Mỗi job được hỏi tối đa năm lần trong một vòng. 404 nghĩa là job không còn. Trạng thái lạ được ghi nguyên văn. Thân trang được lưu ra tệp trước khi đánh dấu xong.
Bước 3: sập sau khi lấy kết quả, trước khi lưu
Mã hỏi p/1, lấy kết quả, lưu tệp, đánh dấu done. Tới p/2, mã nhận phản hồi finished có body, rồi tiến trình sập trước khi ghi tệp. Sổ vẫn ghi p/2 running.
Kết quả bị xóa sau lần lấy đầu
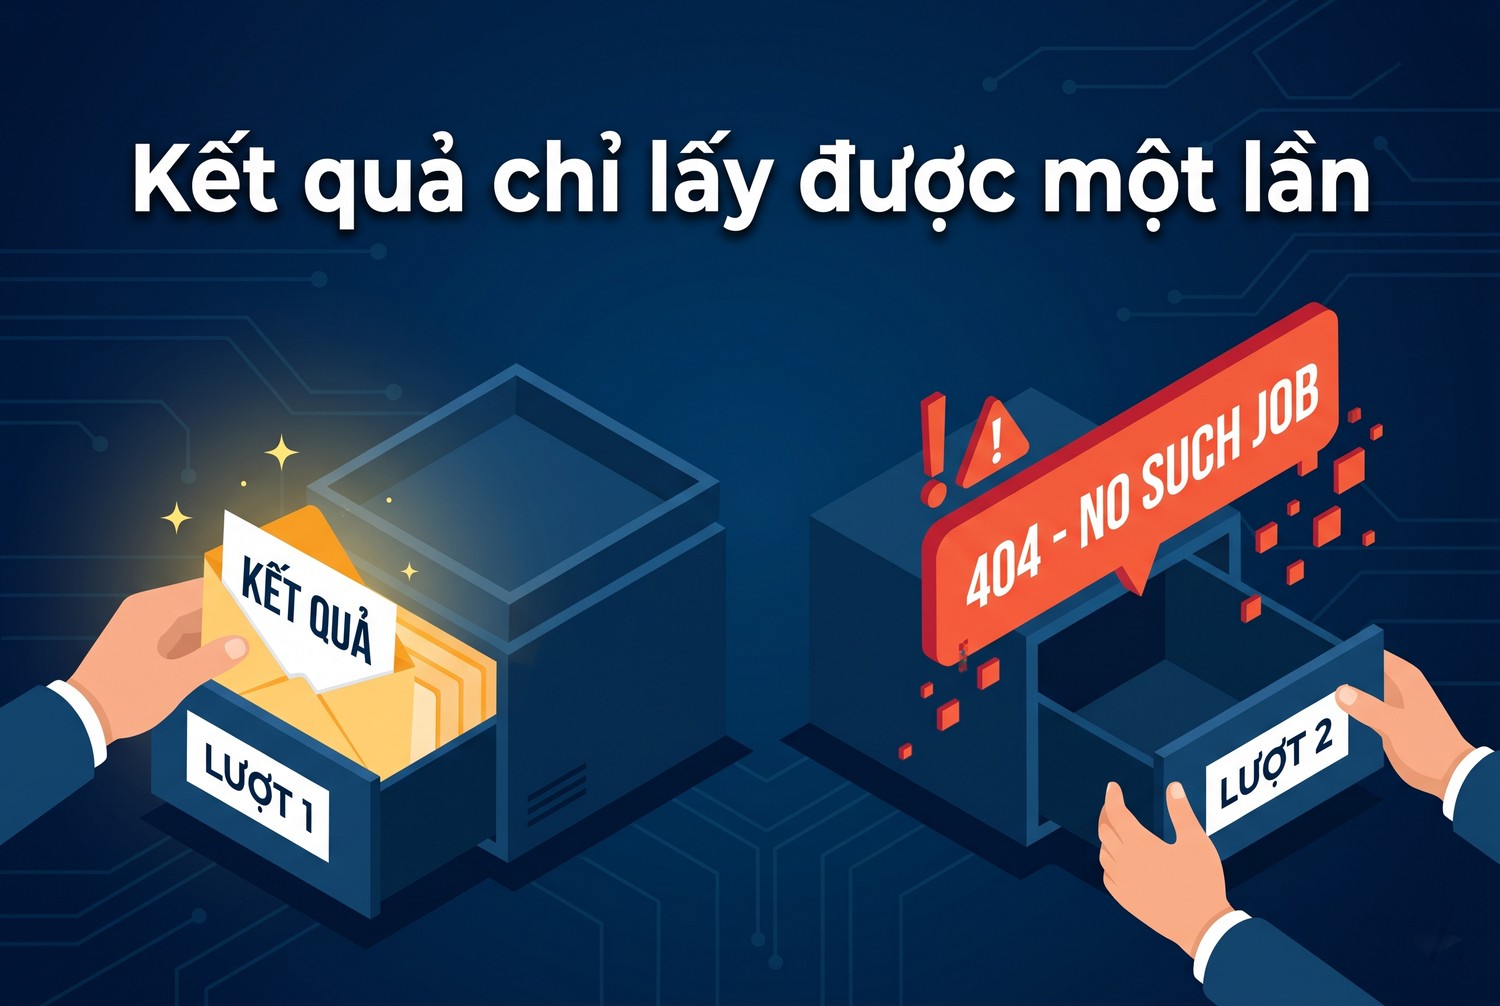
Kết quả chỉ lấy được một lần
Máy chủ mô phỏng làm đúng câu trong tài liệu: lấy kết quả xong thì xóa. Bước 4 chạy lại, hỏi p/2, nhận 404 no such job. Sổ chuyển p/2 sang expired. Kết quả đã từng nằm trong bộ nhớ của tiến trình bị sập, giờ không còn ở đâu cả.
Expired và lost trông giống nhau
Trong sổ, p/2 và URL het-han đều có trạng thái expired với cùng nội dung no such job. Nhưng nguyên nhân khác hẳn: URL het-han hết hạn vì không ai lấy kịp, còn p/2 đã được lấy rồi bị mất do sập. Nhìn từ phía máy chủ, cả hai đều là job không còn.
Tệp tạm và đổi tên
Ghi thân ra tệp cũng có thể bị sập giữa chừng, để lại tệp dở. Cách an toàn là ghi vào tệp tạm, đồng bộ xuống đĩa, rồi đổi tên thành tệp chính thức. Đổi tên trên cùng ổ đĩa gần như tức thời. Lab ghi thẳng vào tệp chính thức cho đơn giản, môi trường thật nên dùng tệp tạm.
Lưu thân trước khi làm gì khác
Bài học của bước 3 là thứ tự: nhận phản hồi, ghi thân ra tệp, đồng bộ tệp xuống đĩa, rồi mới cập nhật sổ. Không xử lý, không phân tích HTML trước khi thân đã nằm an toàn trên đĩa. Với hợp đồng xóa sau lần lấy đầu, phản hồi chỉ có một cơ hội.
Hỏi trạng thái không làm mất kết quả
Trong mô phỏng, hỏi một job đang running không xóa gì. Chỉ phản hồi finished mới làm job biến mất. Nghĩa là có thể hỏi bao nhiêu lần tùy ý khi job đang chạy, nhưng chỉ có một lần nhận kết quả. Lab mô phỏng theo câu chữ của tài liệu, chưa kiểm với dịch vụ thật.
Thời hạn 24 giờ bảo đảm
Kết quả được bảo đảm giữ 24 giờ. Pipeline chạy đêm mà phần lấy kết quả bị lỗi tới tối hôm sau sẽ có nguy cơ mất kết quả. Nên đặt cảnh báo khi còn job running trong sổ quá 12 giờ, để có thời gian xử lý trước hạn.
Map result về URL nguồn, kể cả job thất bại với ScraperAPI async jobs
Phần này đọc kết quả cuối và xử lý job có trang đích lỗi.
Trang đích trả 404
Job của URL khong-ton-tai chạy xong với status finished. Khối response có statusCode 404, header sa-statuscode bằng 404. Job thành công, trang đích thì không. Sổ ghi target_error với target_status 404, giữ nguyên URL.
Job xong không có nghĩa là trang tốt
status finished chỉ nói ScraperAPI đã chạy xong job. Trang đích có thể trả 404, 500, hay một trang chặn. Mã phải đọc response.statusCode để biết. Lab tách hai trạng thái done và target_error dựa trên con số này.
Thân trang lớn
Thân trang nằm trong JSON phản hồi dưới dạng chuỗi. Với trang vài trăm kilobyte, phản hồi JSON cũng lớn tương ứng. Đọc toàn bộ vào bộ nhớ là bình thường với vài trang, nhưng với nhiều tiến trình song song có thể tốn bộ nhớ. Lab chỉ có trang nhỏ, chưa đo.
Header của ScraperAPI
Phản hồi mẫu trong tài liệu có header sa-final-url và sa-statuscode, ngoài các header gốc của trang. sa-final-url cho biết URL cuối cùng sau chuyển hướng. Nếu URL gửi đi và sa-final-url khác nhau, trang đã chuyển hướng. Lab ghi sa-statuscode nhưng chưa dùng sa-final-url.
Ghép kết quả về URL qua sổ
Mỗi kết quả được ghép về URL nhờ dòng trong sổ chứa mã job. Không cần đọc lại url trong phản hồi. Nhưng nếu sổ mất mã job như ca p/3, trường url và meta trong phản hồi là cách duy nhất để biết kết quả thuộc về URL nào.
URL trùng trong danh sách đầu vào
Nếu danh sách đầu vào có cùng một URL hai lần, khóa chính URL của sổ gộp chúng thành một dòng, chỉ một job được tạo. Đây là tác dụng phụ có lợi. Nếu cần tải cùng URL hai lần với tham số khác nhau, khóa chính phải gồm cả tham số.
Không bỏ URL thất bại
Sổ giữ dòng cho mọi URL, kể cả target_error và expired. Không xóa dòng nào. Báo cáo cuối đọc sổ và liệt kê URL theo trạng thái. Người dùng biết chính xác URL nào có dữ liệu, URL nào trang lỗi, URL nào cần gửi lại.
Bước 5: gửi lại và hỏi lại
Mã gửi lại mọi URL expired: p/2 và het-han. Máy chủ nhận job thứ hai cho mỗi URL. Hỏi lại, p/2 chuyển done. het-han hết hạn lần nữa, vì mô phỏng luôn làm hết hạn URL này. Tổng số job trên máy chủ là 9.
Bảng trạng thái cuối
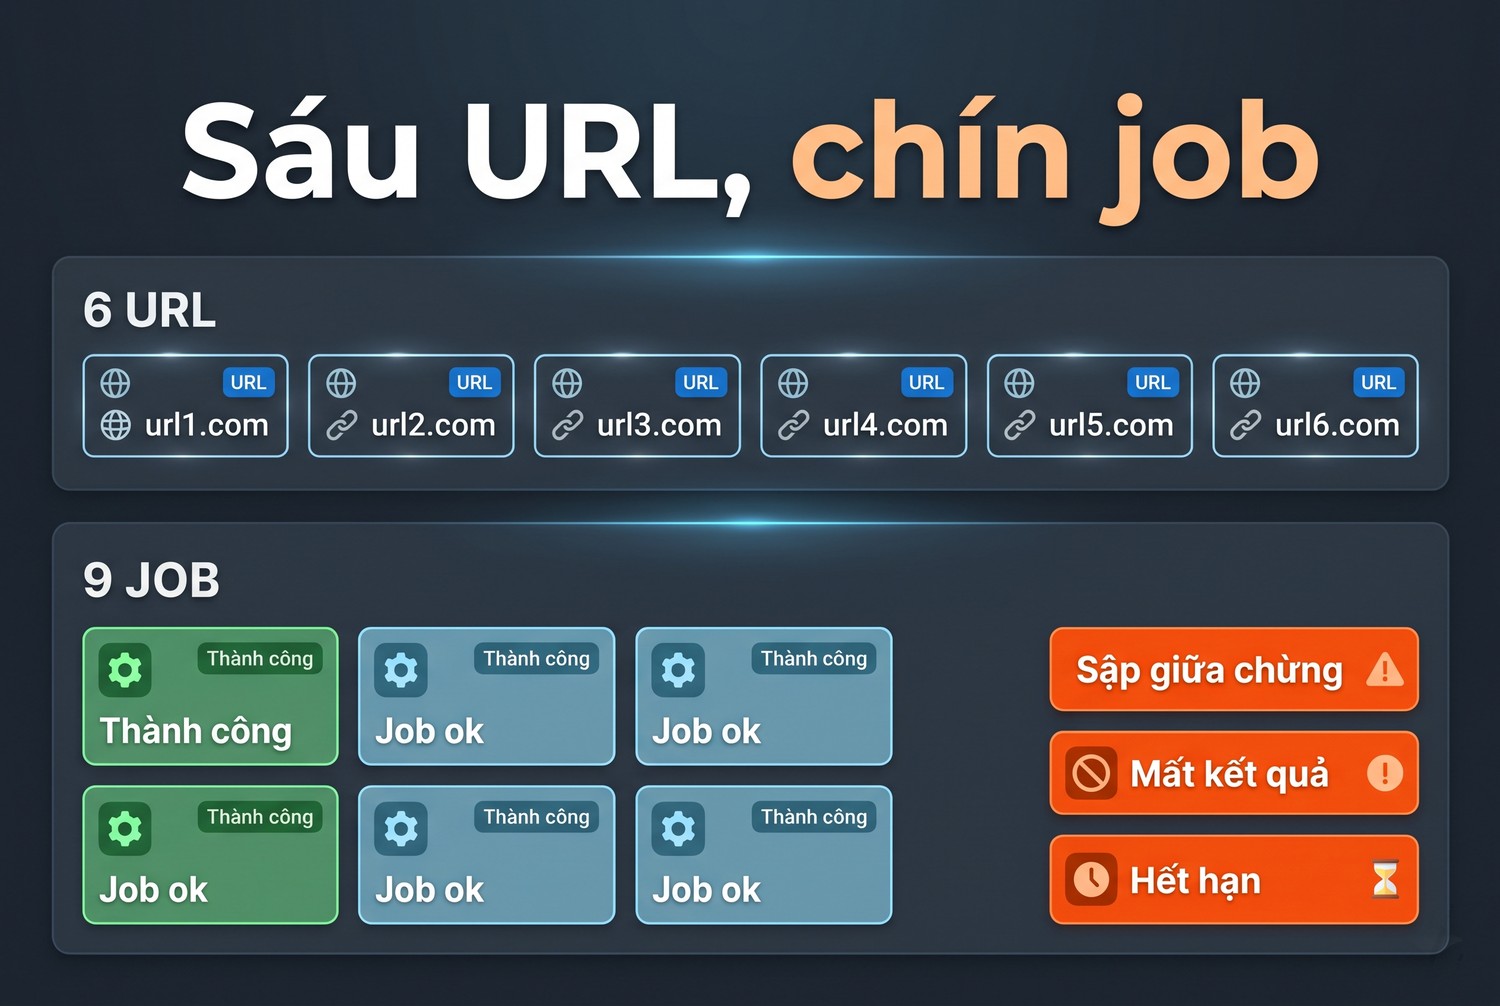
Sáu URL, chín job
URL |
Trạng thái |
Trang đích |
Số job đã tạo |
Lý do job thêm |
|---|---|---|---|---|
p/1 |
done |
200 |
1 |
không |
p/2 |
done |
200 |
2 |
kết quả mất do sập trước khi lưu |
p/3 |
done |
200 |
2 |
sập giữa POST và ghi sổ |
p/4 |
done |
200 |
1 |
không |
khong-ton-tai |
target_error |
404 |
1 |
không |
het-han |
expired |
không có |
2 |
hết hạn, gửi lại vẫn hết hạn |
Sáu URL, chín job. Ba job thêm do hai sự cố và một ca hết hạn.
Khôi phục job ledger sau ngắt tiến trình mà không tạo job trùng với ScraperAPI async jobs
Phần này rút ra cách giảm job trùng.
Ca sập giữa POST và ghi sổ
Không thể loại bỏ hẳn ca này với hợp đồng hiện có. Có thể thu hẹp: ghi sổ ngay khi nhận phản hồi, không làm gì khác giữa POST và ghi. Dùng giao dịch SQLite ngắn. Khoảng thời gian rủi ro giảm xuống còn thời gian mạng trả phản hồi.
Dùng meta làm dấu vết
Gửi meta chứa URL và một mã lần chạy. Nếu có cách nhận kết quả theo cơ chế callback mà tài liệu nhắc ở trang khác, kết quả của job bị mất mã vẫn tìm được chủ nhờ meta. Lab chưa thử callback. Với cơ chế hỏi trạng thái, meta chỉ giúp khi đã có mã job.
Gửi lại hay không gửi lại
Với dòng submitting sau sự cố, có hai lựa chọn. Gửi lại: chắc có kết quả, có thể tốn gấp đôi. Không gửi lại: tiết kiệm, nhưng có thể mất URL. Lab chọn gửi lại vì không mất URL là yêu cầu của đầu ra. Với lô rất lớn, nếu tỷ lệ sập thấp, chi phí gửi trùng thường nhỏ hơn chi phí thiếu dữ liệu.
Ca sập sau khi lấy kết quả
Ca này tránh được bằng thứ tự đúng: lưu thân xuống đĩa trước. Sổ có thể thêm trạng thái fetched giữa running và done: lấy xong thì ghi tệp, ghi trạng thái fetched kèm đường dẫn tệp, rồi mới xử lý tiếp. Khởi động lại, dòng fetched có tệp thì không cần hỏi lại.
Đếm job trên máy chủ để đối soát
Máy chủ mô phỏng có đường dẫn stats đếm số job theo URL. Dịch vụ thật không có đường dẫn này, nhưng bảng điều khiển của ScraperAPI cho biết số request đã dùng. So con số đó với số dòng trong sổ cho biết có bao nhiêu job trùng hoặc gửi lại. Chênh lệch lớn là dấu hiệu sổ có vấn đề.
Phân biệt expired và lost
Thêm trạng thái lost cho ca biết chắc đã lấy kết quả mà không lưu được. Mã chỉ biết điều này nếu ghi nhật ký ngay khi nhận phản hồi finished, trước khi ghi tệp. Phân biệt hai trạng thái giúp đo đúng nguyên nhân: hết hạn là vấn đề lịch chạy, mất là vấn đề mã.
Hủy job khi dừng lô
Nếu quyết định dừng một lô giữa chừng, các job đang running vẫn chạy phía nhà cung cấp và có thể tốn credit. Dùng DELETE theo tài liệu để hủy những job chưa cần. Sổ nên có trạng thái cancelled để phân biệt với expired.
Chỉ một tiến trình hỏi trạng thái
Nếu hai tiến trình cùng hỏi một job, tiến trình nào nhận finished trước sẽ lấy được kết quả, tiến trình kia nhận 404 và đánh dấu expired. Sổ sẽ có trạng thái sai tùy thứ tự ghi. Nên khóa theo dòng trong sổ, hoặc chỉ chạy một tiến trình hỏi trạng thái tại một thời điểm.
Đầu ra nghiệm thu: job ledger với trạng thái kết thúc và ca job thất bại không mất URL nguồn của ScraperAPI async jobs
Phần cuối gom kết quả thành bộ bàn giao.
Bộ bàn giao
Bộ bàn giao gồm mock.py mô phỏng async API theo tài liệu, ledger.py với năm bước chạy, tệp ledger.db sau bước 5, thư mục ket_qua chứa các thân trang đã lưu. Người nhận chạy mock.py rồi chạy ledger.py lần lượt các bước 1 tới 5, phải thấy đúng bảng trạng thái cuối và chín job trên máy chủ.
Tiêu chí đạt
Mọi URL có một dòng trong sổ với trạng thái kết thúc rõ ràng. URL trang đích lỗi giữ nguyên với mã lỗi. URL hết hạn được gửi lại. Không URL nào biến mất sau hai lần sập.
Giữ sổ sau khi lô xong
Sau khi mọi URL có trạng thái kết thúc, đừng xóa sổ ngay. Giữ sổ của vài lô gần nhất để đối soát credit và để chạy lại những URL expired hoặc target_error ở lô sau. Sổ cũng là bằng chứng cho biết dữ liệu ngày nào đến từ job nào.
Quy tắc vận hành
URL làm khóa của sổ. Ghi ý định trước khi gửi. Ghi mã job ngay khi nhận. Lưu thân xuống đĩa trước khi cập nhật trạng thái. Đọc response.statusCode để tách trang lỗi. Cảnh báo job running quá 12 giờ. Một tiến trình hỏi trạng thái tại một thời điểm.
Khi nào cần proxy với ScraperAPI async jobs
ScraperAPI tự lo phần tải trang đích, gồm cả việc đi qua mạng proxy của họ. Người dùng async API không cần proxy riêng. Chỉ khi máy chạy pipeline nằm sau proxy công ty thì requests mới cần cấu hình proxy để gọi ra async.scraperapi.com.
Với những trang được phép thu thập mà nhóm tự tải không qua ScraperAPI, có lúc cần IP tại Việt Nam để thấy đúng nội dung cho người dùng trong nước. Khi đó anh em có thể mua proxy tĩnh Việt Nam tại trang chủ ProxyVN. Proxy không giữ kết quả job lâu hơn và không thay sổ job. Vai trò hợp lệ của proxy được giải thích ở bài Web Scraping proxy là gì.
Khóa API trong thân request
Async API nhận apiKey trong thân JSON, không trên URL. Khóa không vào log truy cập ghi URL. Nhưng nếu mã ghi nguyên thân request để gỡ lỗi, khóa sẽ vào log. Che khóa trước khi ghi. Cách cấu hình proxy công ty cho requests có trong bài định dạng proxy.
Lịch chạy hai pha
Có thể tách pipeline thành hai lịch: pha gửi chạy đầu đêm, pha lấy kết quả chạy mỗi 15 phút tới sáng. Pha lấy kết quả chỉ đọc sổ và hỏi những job running. Tách pha giúp pha gửi không bị chặn bởi job chậm, và pha lấy có nhiều cơ hội lấy kết quả trước hạn 24 giờ.
Những gì lab chưa thử
Lab chưa có tài khoản, chưa thấy thời gian chạy job thật, chưa kiểm câu kết quả bị xóa sau khi lấy với dịch vụ thật. Lab chưa thử callback, batch request, DELETE trên job thật, và chưa biết trạng thái nào khác ngoài running và finished có thể xuất hiện. Mức credit mỗi job chưa đối chiếu.
Checklist ScraperAPI async jobs
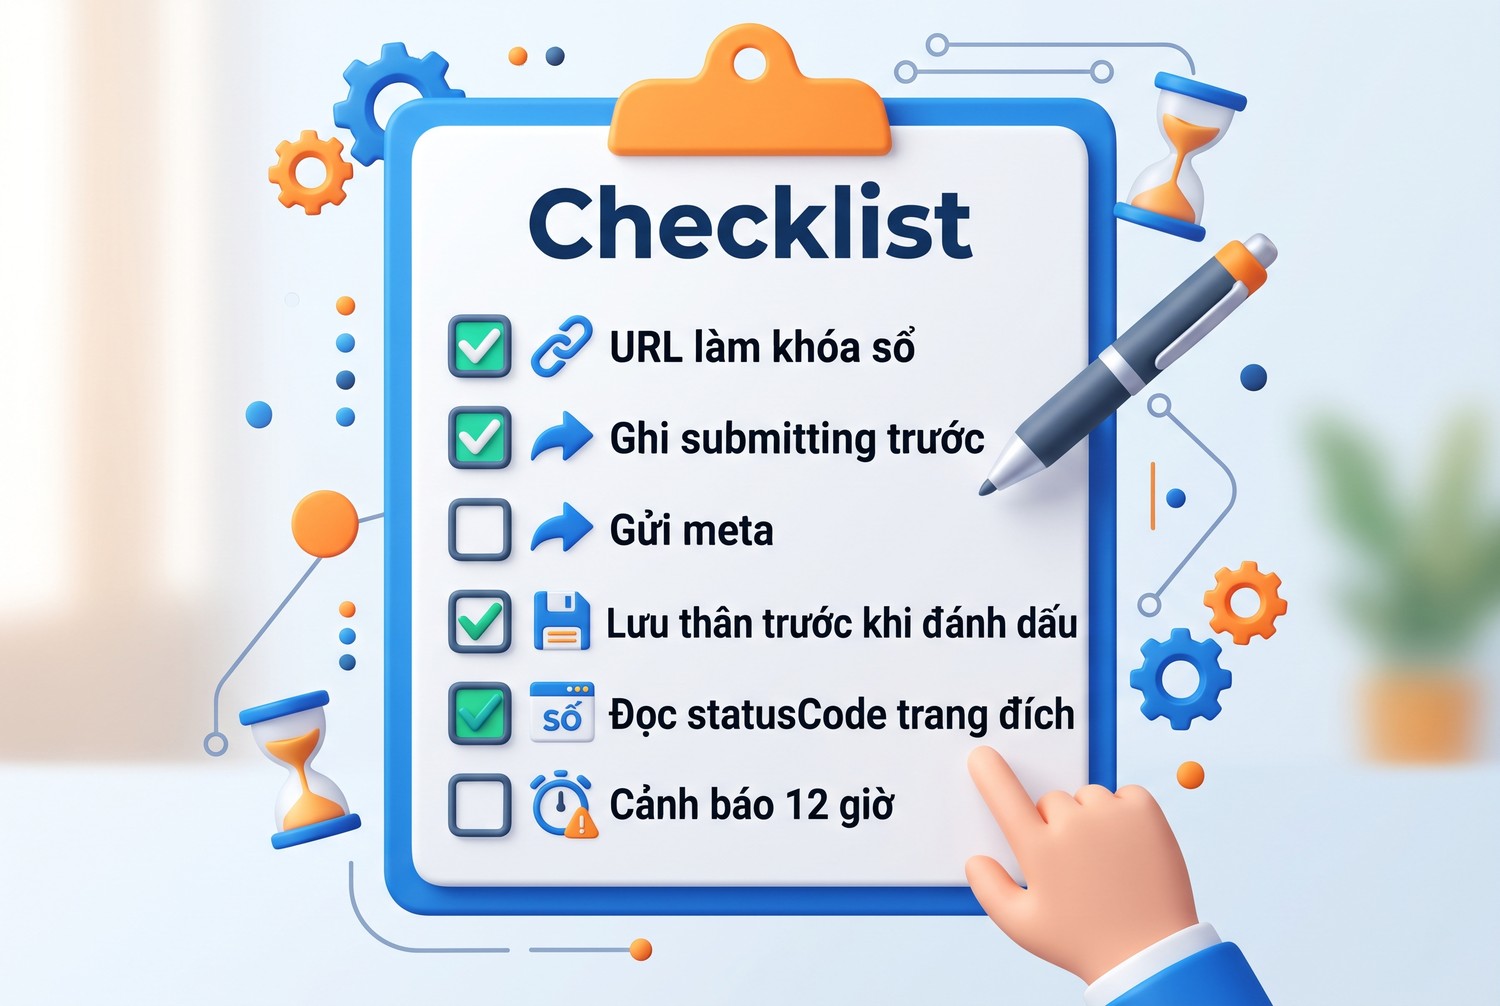
Checklist
- Sổ job lấy URL làm khóa chính.
- Ghi submitting trước POST, ghi mã job ngay sau.
- Gửi meta chứa URL và mã lần chạy.
- Lưu thân xuống đĩa trước khi đánh dấu xong.
- Đọc response.statusCode, tách done với target_error.
- 404 khi hỏi nghĩa là job không còn, gửi lại.
- Cảnh báo job running quá 12 giờ.
- Chỉ một tiến trình hỏi trạng thái mỗi lúc.
Câu hỏi thường gặp về ScraperAPI async jobs
Kết quả job được giữ bao lâu?
Theo tài liệu, tối đa 72 giờ, bảo đảm 24 giờ, hoặc tới khi bạn lấy kết quả, tùy điều nào tới trước.
Lấy kết quả hai lần được không?
Theo câu chữ tài liệu thì không. Lab mô phỏng đúng như vậy: lần hỏi sau trả 404 no such job.
Job finished có nghĩa là trang tải thành công không?
Không. Phải đọc response.statusCode. Lab có job finished với trang đích 404.
Tiến trình sập thì có tạo job trùng không?
Có thể. Lab sập giữa POST và ghi sổ, khởi động lại tạo thêm một job cho cùng URL.
Khóa sai thì API trả gì?
Lab gọi thật nhận HTTP 401 dạng văn bản với thông điệp Unauthorized request.
Dùng async API có cần proxy không?
Không. ScraperAPI tự lo phần tải trang. Chỉ cần khi mạng công ty bắt buộc.
ScraperAPI async jobs và những điều cần nhớ
ScraperAPI async jobs chuyển việc chờ sang phía nhà cung cấp, và chuyển việc giữ sổ sang phía bạn. Lab cho thấy sáu URL có thể thành chín job sau hai lần sập, kết quả lấy rồi không lưu là mất hẳn, còn job finished vẫn có thể chứa trang 404. Lấy URL làm khóa, lưu thân trước khi đánh dấu, đọc mã trạng thái trang đích, và không bao giờ xóa dòng của URL lỗi. Cần IP tĩnh cho phần tự tải bên cạnh ScraperAPI async jobs, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


