
ScrapeBox proxy: kiểm tra URL của site được phép qua proxy
ScrapeBox proxy là phần cấu hình giúp các module của ScrapeBox gửi yêu cầu qua proxy thay vì IP máy bạn. ProxyVN đọc các trang chính thức của ScrapeBox để biết module nào hỗ trợ proxy và Proxy Manager kiểm được gì. Bài chỉ nói về kiểm URL của site được phép, không nói về spam.
ScrapeBox proxy dùng trong tình huống nào
ScrapeBox là phần mềm chạy trên Windows và Mac, gồm một lõi và rất nhiều addon. Với người làm SEO, nó thường được dùng để kiểm hàng loạt URL: trang còn sống hay đã chết, trang có chuyển hướng không, liên kết nào đang hỏng. Khi số URL lên đến hàng nghìn, việc gửi tất cả từ một IP dễ bị máy chủ đích giới hạn tốc độ, và đó là lúc anh em cần proxy.
Bài này chỉ tập trung vào một nhóm việc: kiểm tra URL của site mà anh em có quyền kiểm. Đó có thể là website của chính anh em, của khách hàng đã đồng ý, hoặc một danh sách đích đã được cho phép. Bài không hướng dẫn gửi bình luận, điền form hay tạo liên kết hàng loạt.
Lý do mình giới hạn như vậy rất đơn giản. Proxy không biến một việc vi phạm điều khoản của site đích thành việc hợp lệ. Trang FAQ của ScrapeBox tự nói rằng công cụ này có thể dùng cho nhiều mục đích, kể cả những việc không sạch, và mức độ dùng thế nào là do người dùng quyết định.
Phạm vi bài viết
Máy mình không cài ScrapeBox và mình cũng không mua giấy phép, nên bài không có ảnh chụp giao diện hay kết quả chạy phần mềm thật. Mình đọc các trang tính năng, FAQ, trang proxy và nhật ký thay đổi chính thức của ScrapeBox, rồi viết các script Python nhỏ làm đúng công việc tương tự để minh họa cách kiểm.
Vì vậy mọi kết quả trong bài là kết quả của script lab, không phải đầu ra của ScrapeBox. Những chỗ phụ thuộc giao diện cụ thể, như tên nút, mình chỉ nhắc khi trang chính thức có nói.
Bài này khác các bài công cụ SEO khác ở đâu
ProxyVN đã có bài về proxy cho Screaming Frog và proxy cho ScrapeStorm, cả hai nói về công cụ crawl. Bài này đi vào Proxy Manager của ScrapeBox và các addon kiểm URL, tức là cách nạp proxy, kiểm proxy và gán proxy cho đúng module.
ScrapeBox proxy và bảng module có hỗ trợ proxy
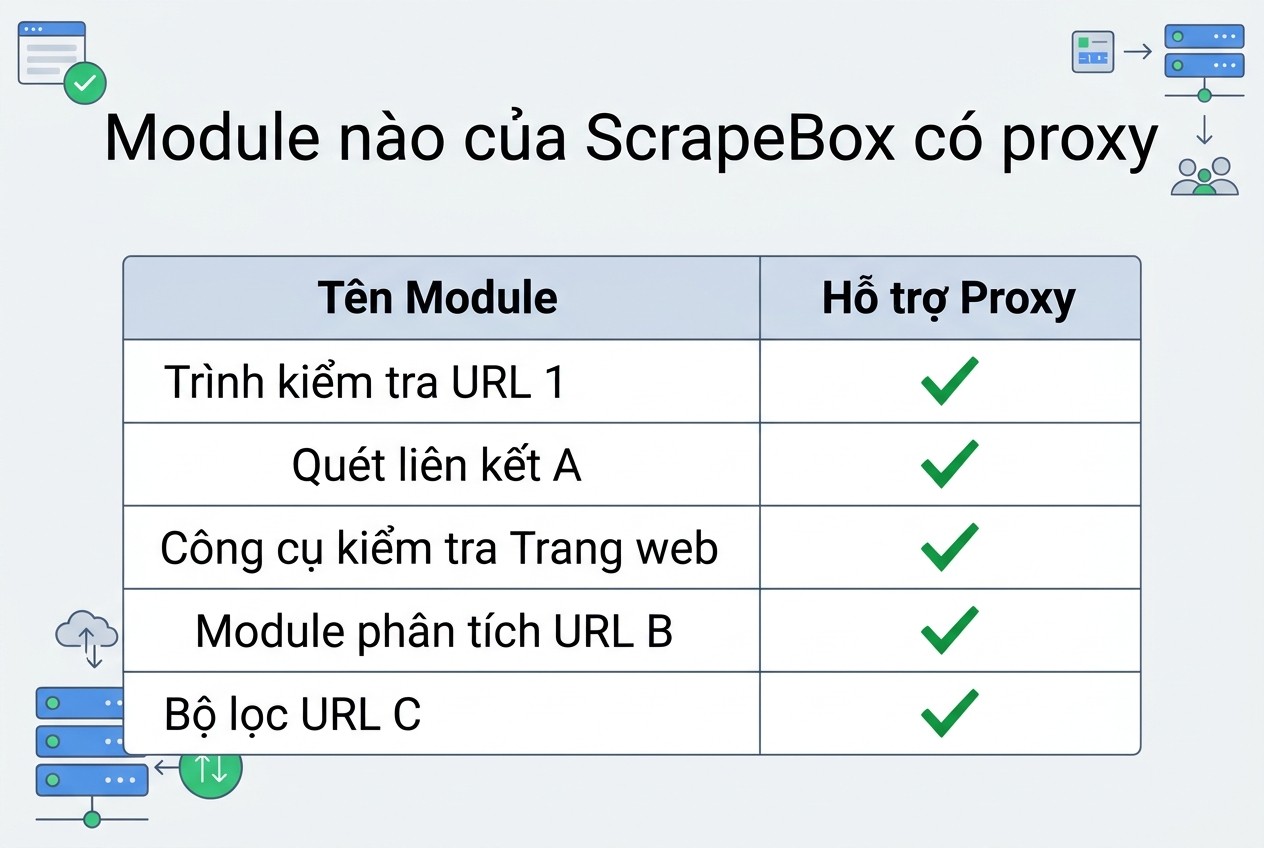
Module nào của ScrapeBox có proxy
Trước khi cấu hình, anh em cần biết module nào của ScrapeBox thật sự dùng proxy. Trang giới thiệu từng addon trên scrapebox.com ghi rõ trong danh sách tính năng có dòng Proxy Support hay không. Mình tổng hợp lại các module kiểm URL từ những trang đó.
Module |
Làm gì |
Proxy |
Ghi chú theo trang chính thức |
|---|---|---|---|
[Alive Checker](https://www.scrapebox.com/mass-alive-checker) |
Kiểm URL còn sống hay chết |
Có |
Chỉnh số luồng, số lần thử lại, theo dõi chuyển hướng |
[Redirect Checker](https://www.scrapebox.com/redirect-checker) |
Tìm đích của URL chuyển hướng |
Có |
Tối đa 500 kết nối, xem loại và số lần chuyển hướng |
[Broken Links Checker](https://www.scrapebox.com/broken-links-checker) |
Tìm liên kết hỏng trong trang |
Có |
Chọn mã trả về được coi là sống |
Page Scanner |
Tìm đoạn văn bản hoặc HTML trong trang |
Có |
Hỗ trợ mẫu tìm kiếm và regex |
Outbound Link Checker |
Đếm liên kết ra ngoài của trang |
Có |
Xuất ra Excel |
Webpage Meta Scraper |
Lấy title, description, keywords |
Có |
Nhiều luồng |
Bảng cho thấy các module kiểm URL đều có hỗ trợ proxy và đều nhiều luồng. Hai điều này đi cùng nhau: càng nhiều luồng, càng cần phân tán yêu cầu qua nhiều IP để không chạm giới hạn của site đích.
Module không nằm trong phạm vi bài
Trang chính thức cũng liệt kê các module khác như Search Engine Scraper, Blog Poster, Contact Form Submitter và Manual Blog Poster. Đó là các module thu thập từ công cụ tìm kiếm hoặc gửi nội dung lên site khác. Bài này không dùng chúng, vì chúng chạm vào điều khoản của bên thứ ba và không phải việc kiểm URL của site được phép.
Riêng với việc lấy dữ liệu từ công cụ tìm kiếm, điều khoản của từng công cụ có quy định riêng về truy cập tự động. Anh em đọc điều khoản của công cụ đó trước khi làm, và bài proxy cho SERP tracking nói về hướng làm có kiểm soát hơn.
Đọc bảng này thế nào khi chọn gói proxy
Cột Proxy giúp anh em chọn đúng việc cần proxy. Nếu danh sách URL nhỏ và thuộc site của mình, nhiều khi không cần proxy nào cả. Proxy chỉ có ích khi số URL lớn, khi cần kiểm từ vị trí khác, hoặc khi mạng công ty chặn một số đích.
Chuẩn bị phiên bản, danh sách proxy và môi trường cho ScrapeBox proxy
Đầu trang nhật ký thay đổi ghi danh sách tới bản 2.1.0.60, phát hành ngày 29 tháng 1 năm 2026. Cuối trang nhắc rằng nhật ký của các bản mới hơn nằm trong công cụ cập nhật của phần mềm. Anh em nên cập nhật lên bản mới trước khi kiểm proxy, vì nhiều sửa lỗi proxy nằm trong các bản này.
Yêu cầu hệ điều hành
Trang FAQ ghi ScrapeBox chạy trên Windows 10, Windows 11 và Windows Server bản 64 bit, và có bản cho Mac. Trang này cũng ghi rõ giấy phép gắn với một máy, và phần mềm không chạy trên WINE. Nếu anh em muốn chạy lâu dài, FAQ gợi ý dùng một máy chủ Windows ảo kết nối bằng Remote Desktop.
Loại proxy được hỗ trợ
Qua nhật ký thay đổi, mình thấy các mốc liên quan đến loại proxy. Ở bản 2.0.0.30, ScrapeBox thêm hỗ trợ đầy đủ SOCKS5. Ở bản 2.0.0.62, Proxy Manager có thể tự xác định proxy là HTTP hay SOCKS trong lúc kiểm. Ở bản 2.0.0.22, Proxy Manager xử lý được URL https.
Trang Proxy Harvester còn nói rõ Proxy Manager có thể đánh dấu proxy là SOCKS và kiểm cả proxy riêng yêu cầu tên đăng nhập và mật khẩu. Điều này nghĩa là proxy dịch vụ có tài khoản dùng được, không chỉ proxy công khai.
Định dạng khi nạp proxy
Các trang chính thức mình đọc không mô tả cụ thể định dạng dòng khi nạp proxy. Nhiều hướng dẫn bên thứ ba dùng dạng ip:port cho proxy không mật khẩu và ip:port:user:pass cho proxy có mật khẩu, nhưng đó không phải nguồn chính thức. Vì vậy anh em nên nạp thử một dòng và xem Proxy Manager hiển thị thế nào trước khi nạp cả danh sách.
Nếu nhà cung cấp trả định dạng khác, bài định dạng proxy hướng dẫn chuyển qua lại. Phần Proxy Manager có nút nạp từ tệp, nạp từ clipboard và lưu ra clipboard, nên anh em có thể dán trực tiếp từ trang quản lý của nhà cung cấp.
Chọn nhà cung cấp và kiểu proxy
Trang Proxy của ScrapeBox nói proxy riêng nhanh và đáng tin hơn proxy dùng chung, vì chỉ một người dùng nó. Trang này cũng nói proxy dùng chung rẻ hơn nhưng người khác dùng cùng proxy có thể làm nó bị chặn, và gợi ý dùng cho việc không giới hạn truy vấn chặt. Trang còn nêu tên vài nhà cung cấp không hỗ trợ ScrapeBox.
Với việc kiểm URL của site mình, proxy riêng ổn định hơn vì tốc độ ít dao động. Bài xác thực proxy bằng IP whitelist hay user password giúp anh em chọn cách xác thực hợp với máy chạy ScrapeBox.
Cấu hình tối thiểu cho ScrapeBox proxy và cách kiểm tra danh sách
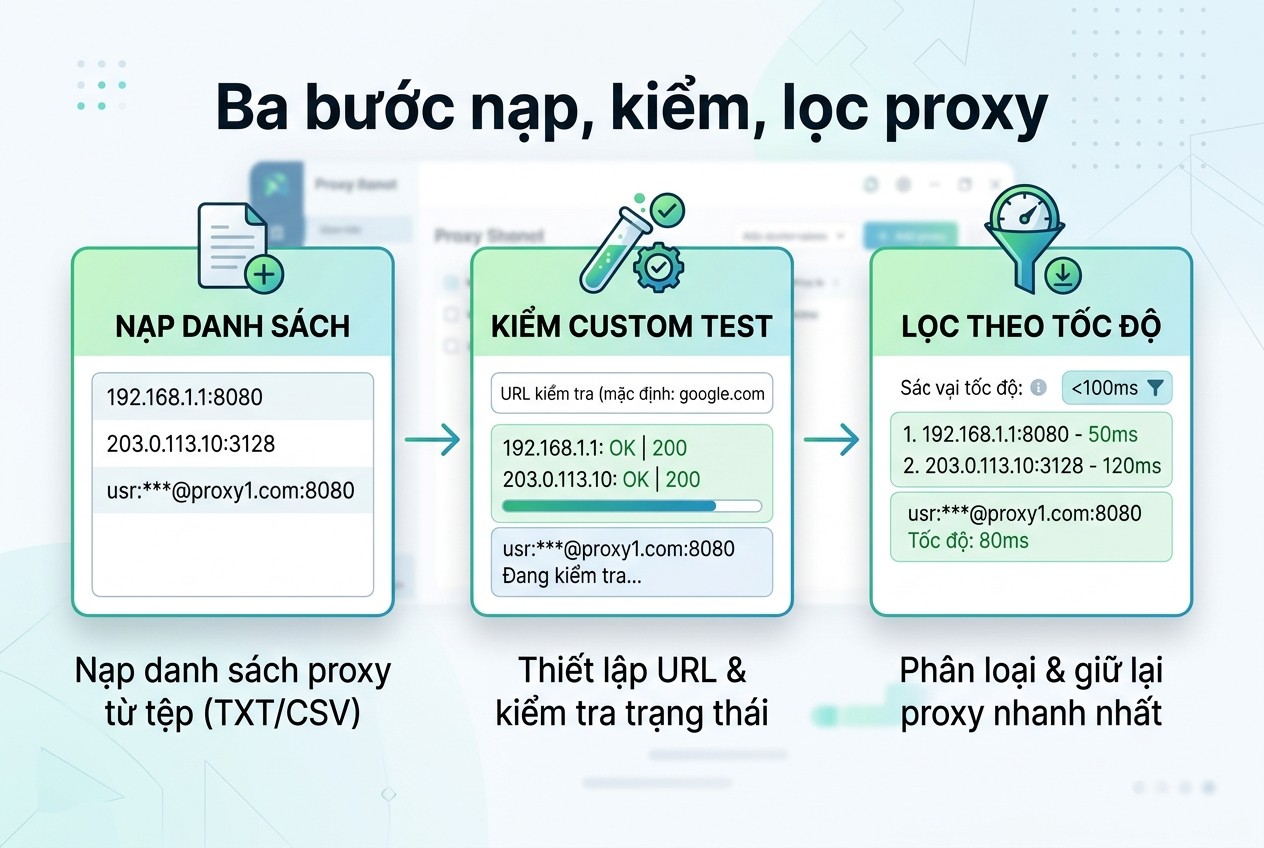
Ba bước nạp, kiểm, lọc proxy
Quy trình tối thiểu có ba bước: nạp proxy vào Proxy Manager, kiểm proxy sống hay chết, rồi dùng danh sách đã lọc trong module cần chạy. Mình đi qua từng bước và nêu tính năng chính thức có thể giúp ở từng bước.
Bước 1: nạp proxy vào Proxy Manager
Trang Proxy Harvester mô tả Proxy Manager có nhiều cách nạp: lấy từ nguồn công khai, lấy từ tệp cục bộ, nạp từ clipboard. Với proxy dịch vụ, anh em nạp từ tệp hoặc clipboard là đủ. Phần thu thập proxy công khai từ các trang web mình không dùng, vì chất lượng và độ an toàn của proxy công khai rất khó kiểm soát.
Sau khi nạp, nên dùng chức năng loại trùng. Nhật ký thay đổi ghi nhận có mục Remove Duplicate Proxies trong menu của lưới proxy, và có mục so sánh với danh sách đã có để loại bản trùng.
Bước 2: kiểm proxy
Theo trang chính thức, trình kiểm proxy chạy nhiều luồng, anh em chỉnh được số kết nối đồng thời và thời gian chờ. Nó có bài kiểm Google bằng cách thực hiện một truy vấn và xem có kết quả không. Nó cũng có Custom Test: anh em nhập một URL tùy ý và nội dung cần tìm trên trang để biết proxy có hoạt động.
Với việc kiểm URL của site mình, Custom Test là cách hợp lý nhất. Anh em trỏ nó tới một trang của chính site mình, chọn một đoạn chữ chắc có trên trang, và proxy nào lấy về được đoạn chữ đó là proxy dùng được cho site này. Bài kiểm Google chỉ cần khi anh em thật sự làm việc với kết quả tìm kiếm.
Bước 3: lọc và lưu danh sách
Sau khi kiểm xong, trang chính thức nói anh em lọc theo tốc độ, chỉ giữ proxy ẩn danh hoặc chỉ giữ proxy qua bài kiểm Google, rồi lưu ra tệp văn bản hoặc dùng ngay trong ScrapeBox. Nhật ký còn ghi tính năng tự lưu proxy tốt theo chu kỳ trong lúc kiểm, và gửi email khi kiểm xong.
Proxy tĩnh hay proxy xoay trong danh sách
Danh sách proxy có thể gồm nhiều IP tĩnh, hoặc một cổng xoay nơi nhà cung cấp tự đổi IP phía sau. Với proxy tĩnh, mỗi dòng là một IP riêng, và Proxy Manager kiểm từng dòng như bình thường. Với cổng xoay, chỉ một dòng là đủ, nhưng kết quả kiểm một lần chưa nói lên IP ở lần sau.
Cho việc kiểm URL của site mình, proxy tĩnh dễ gỡ lỗi hơn vì cùng một IP cho kết quả lặp lại. Cổng xoay hợp khi site đích giới hạn tốc độ theo IP. Bài sticky session proxy giải thích cách giữ IP trong một khoảng thời gian khi dùng cổng xoay.
Bước 4: chạy module với danh sách đã lọc
Mỗi module kiểm URL có tùy chọn dùng proxy. Đặt số luồng vừa phải và số lần thử lại thấp. Trang Alive Checker nói số lần thử lại giúp loại kết quả sai, nên một lần thử lại thường đủ cho kiểm tra thông thường. Mình sẽ cho thấy tác dụng của hai tham số này trong lab bên dưới.
Cảnh báo về thời gian chờ
Một số hướng dẫn tích hợp của bên thứ ba lưu ý thời gian chờ mặc định của bài kiểm Google khá ngắn, nên nhiều proxy chậm bị đánh dấu hỏng oan. Đó là thông tin gián tiếp, mình chưa kiểm trên phần mềm thật. Nếu proxy chậm nhưng dùng được, anh em tăng thời gian chờ trong cấu hình kiểm.
Kiểm chứng ScrapeBox proxy bằng lab: kiểm danh sách proxy
Vì không có ScrapeBox, mình viết hai script làm công việc tương tự để minh họa cách kiểm. Script proxy_tester.py đọc một danh sách proxy và kiểm từng dòng trên trang đích của lab. Script url_checker.py đọc danh sách URL và ghi lại mã trả về, chuỗi chuyển hướng, số lần thử lại, có hoặc không qua proxy.
Trang đích lab có sáu đường dẫn: /ok trả 200, /gone trả 404, /chuyen chuyển hướng 301 về /ok, /chuyen2 chuyển hướng 302 về /chuyen, /cham trả lời sau ba giây, và /loi trả 500. Proxy lab là proxy HTTP có mật khẩu. Tên miền đuôi .test chỉ proxy lab mới phân giải được.
Năm dòng proxy và kết quả
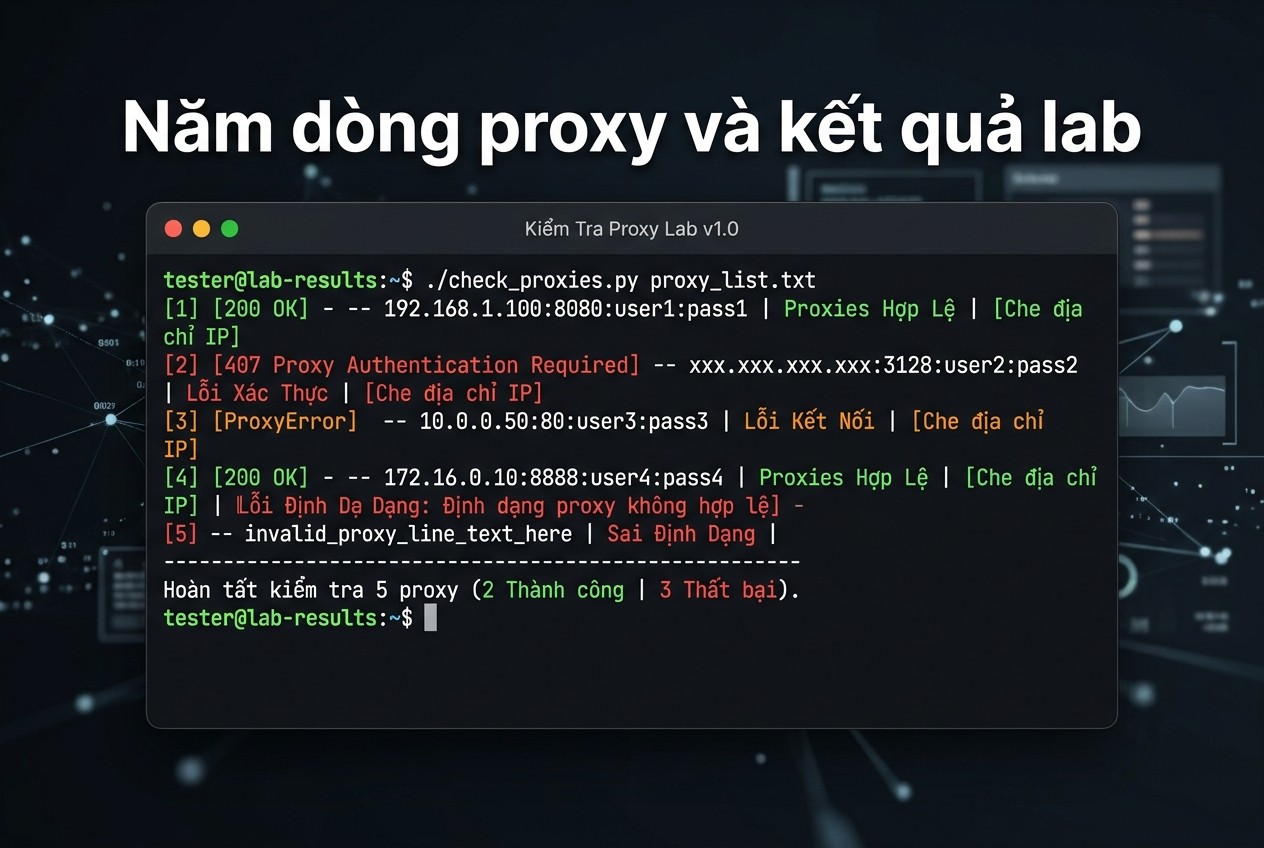
Năm dòng proxy và kết quả lab
Danh sách thử có năm dòng, mỗi dòng mô phỏng một tình huống mà Proxy Manager cũng sẽ gặp khi kiểm proxy thật.
Dòng |
Tình huống |
Kết quả script |
|---|---|---|
1 |
Đúng tài khoản và mật khẩu |
HTTP 200, 6 ms, thấy header do proxy thêm |
2 |
Sai mật khẩu |
HTTP 407 |
3 |
Không có tài khoản |
HTTP 407 |
4 |
Cổng không có proxy |
ProxyError sau khoảng 2 giây |
5 |
Dòng chỉ có ba phần |
Báo sai định dạng, không gửi yêu cầu |
Kết quả cho thấy vài điều có ích khi đọc bảng kiểm proxy thật. Mã 407 nghĩa là proxy sống nhưng tài khoản sai hoặc thiếu, nên không nên xóa proxy đó ngay. Lỗi proxy sau khoảng hai giây nghĩa là không có gì lắng nghe ở địa chỉ đó. Header do proxy thêm vào chứng minh yêu cầu thật sự đã đi qua proxy.
Bẫy mật khẩu có ký tự @
Lần chạy đầu tiên của mình cho kết quả lạ: dòng đúng tài khoản lại báo lỗi proxy và đòi kết nối tới một host tên ss. Nguyên nhân là mật khẩu thử có ký tự @, mà script ghép thẳng vào địa chỉ proxy, nên phần sau ký tự @ đầu tiên bị hiểu là host.
Sau khi mình mã hóa phần trăm tên đăng nhập và mật khẩu trước khi ghép, dòng 1 trả 200. Bài học áp dụng cho mọi công cụ nhận proxy dạng URL: mật khẩu có ký tự đặc biệt cần mã hóa, hoặc nhà cung cấp nên cấp mật khẩu chỉ gồm chữ và số. Trong ScrapeBox, nếu một proxy có mật khẩu chứa ký tự lạ bị báo hỏng oan, anh em thử đổi mật khẩu trước khi kết luận proxy có vấn đề.
Proxy báo 407 chưa phải proxy hỏng. Đó là proxy sống đang từ chối tài khoản của anh em.
Lệnh để chạy lại lab
Anh em có thể chạy lại cả hai script trên máy mình với một proxy HTTP bất kỳ. Thay địa chỉ proxy bằng proxy của anh em và đổi danh sách URL thành URL của site mình. Đừng trỏ script vào site không phải của mình.
python proxy_tester.py proxies.txt https://site-cua-ban.example/trang-thu --threads 4 --timeout 6
python url_checker.py urls.txt --proxy "http://user:matkhau@ip:cong" --threads 4 --retries 1 --follow
Lệnh đầu kiểm danh sách proxy trên một trang của site mình. Lệnh sau kiểm danh sách URL, đi theo chuyển hướng và thử lại một lần khi lỗi. Cả hai in kết quả ra màn hình dạng bảng, nên anh em chuyển sang tệp bằng dấu chuyển hướng của shell nếu muốn lưu.
ScrapeBox proxy và kiểm URL: Alive Checker, Redirect Checker bằng lab
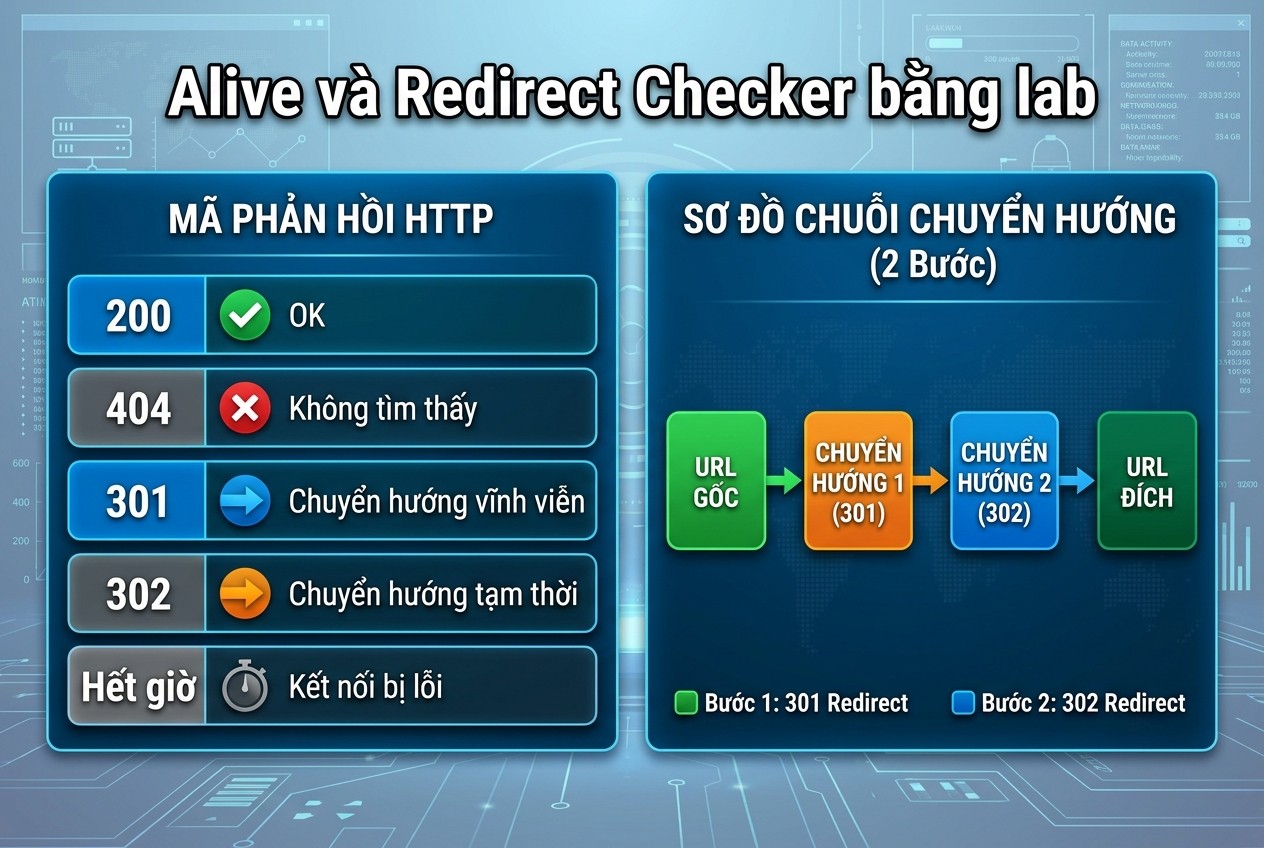
Alive và Redirect Checker bằng lab
Phần này mô phỏng hai addon kiểm URL phổ biến. Script url_checker.py nhận danh sách sáu URL của trang lab, kết nối qua proxy có mật khẩu, và in ra bảng gồm URL, kết quả, chuỗi chuyển hướng, đích và số lần thử lại.
Chạy không theo chuyển hướng
Khi không bật theo dõi chuyển hướng, script báo đúng mã của chính URL trong danh sách, giống tùy chọn không theo dõi chuyển hướng của Alive Checker. Thời gian chờ đặt hai giây, không thử lại.
URL lab |
Kết quả |
Đích chuyển hướng |
|---|---|---|
/ok |
200 |
không có |
/gone |
404 |
không có |
/chuyen |
301 |
/ok |
/chuyen2 |
302 |
/chuyen |
/cham |
ReadTimeout |
không có |
/loi |
500 |
không có |
Từ đây anh em thấy vì sao trang Alive Checker cho phép tự quy định mã nào là sống. Mã 301 và 302 là kết quả đúng của một URL chuyển hướng. Nếu coi chúng là chết, một site mới đổi giao thức sang https sẽ trông như chết hàng loạt.
Chạy theo chuyển hướng
Khi bật theo dõi chuyển hướng, script đi theo chuỗi tới đích cuối và ghi lại các mã trung gian, giống cách Redirect Checker hiển thị số lần chuyển hướng và loại chuyển hướng.
URL lab |
Kết quả cuối |
Chuỗi chuyển hướng |
|---|---|---|
/chuyen |
200 |
301 |
/chuyen2 |
200 |
302 rồi 301 |
/gone |
404 |
không có |
/loi |
500 |
không có |
Với /chuyen2, hai bước chuyển hướng nối nhau cho một đích duy nhất. Đây là tình huống chuỗi chuyển hướng dài mà người làm SEO cần phát hiện và rút gọn. Trang Redirect Checker ghi nhận số lần chuyển hướng ngay để phục vụ việc này.
Thử lại không cứu được mọi lỗi
Ở lần chạy theo chuyển hướng, mình đặt một lần thử lại. Đường dẫn /cham vẫn hết giờ sau lần thử thứ hai, vì lỗi nằm ở chính trang đích chứ không phải do mạng chập chờn. Thử lại giúp loại kết quả sai tạm thời, không sửa được một trang thật sự chậm.
Điều này giải thích vì sao trang Alive Checker nhắc số lần thử lại là để loại kết quả dương tính giả. Nếu mọi lần thử đều lỗi giống nhau, kết quả đó đáng tin hơn một lần lỗi đơn lẻ.
Khi thiếu mật khẩu proxy
Mình cũng chạy một lần với địa chỉ proxy không kèm tài khoản. Mọi URL đều trả 407 từ proxy, kể cả những trang không có vấn đề gì. Đây là mẫu lỗi cần nhận ra trong báo cáo hàng loạt: nếu cả danh sách URL cùng trả một mã lạ, nguyên nhân thường nằm ở proxy, không phải ở từng URL.
Lỗi thường gặp khi chạy ScrapeBox proxy
Bảng dưới gom các triệu chứng thường gặp và nguyên nhân tương ứng. Phần nguyên nhân mình suy từ kết quả lab và từ các trang chính thức, chưa tái hiện từng triệu chứng trên phần mềm thật.
Triệu chứng |
Nguyên nhân có thể |
Cách xử lý |
|---|---|---|
Cả danh sách cùng một mã lạ |
Proxy từ chối tài khoản |
Kiểm tài khoản, thử ba URL trước |
Proxy tốt bị báo hỏng |
Thời gian chờ quá ngắn |
Tăng thời gian chờ trong cấu hình kiểm |
Proxy có mật khẩu lạ bị báo hỏng |
Ký tự đặc biệt làm sai địa chỉ |
Đổi mật khẩu hoặc mã hóa |
Nhiều URL thuộc site mình báo chết |
Site đích giới hạn tốc độ |
Giảm số luồng, giãn yêu cầu |
Kết quả khác nhau mỗi lần chạy |
Proxy chia sẻ bị người khác dùng |
Dùng proxy riêng |
Mã 301, 302 bị coi là chết |
Cấu hình mã sống chưa đúng |
Cho phép các mã chuyển hướng |
Giảm luồng để khỏi tự làm hỏng kết quả
Trang tính năng cho phép chạy hàng trăm kết nối, tối đa 500 ở Redirect Checker. Con số này là giới hạn của phần mềm, không phải mức nên dùng. Một site nhỏ trên hosting giá rẻ có thể chậm hoặc chặn khi nhận quá nhiều yêu cầu cùng lúc, và kết quả kiểm sẽ sai.
Hướng làm an toàn là bắt đầu với số luồng thấp, tăng dần và theo dõi tỷ lệ lỗi. Nếu tỷ lệ lỗi tăng khi số luồng tăng, anh em đã chạm giới hạn của site đích. Bài robots.txt khi crawl website nói về việc tôn trọng quy tắc truy cập của site đích.
Ước lượng số luồng hợp lý
Có một cách tính đơn giản để chọn số luồng. Giả sử site đích chịu được khoảng năm yêu cầu mỗi giây mà không chậm đi, và mỗi yêu cầu mất khoảng một giây. Khi đó chỉ cần năm luồng là đủ, thêm luồng chỉ làm tăng lỗi. Anh em thường không biết con số năm này, nên cách làm là tăng dần và quan sát.
Proxy làm bài toán phức tạp hơn một chút. Nếu anh em dùng chung một proxy cho mọi luồng, giới hạn của proxy (băng thông, số kết nối đồng thời) cũng có thể là nút thắt. Khi tăng luồng mà thời gian phản hồi tăng theo, hãy nghi ngờ proxy trước khi nghi ngờ site đích. Bài proxy bị chậm liệt kê các nguyên nhân thường gặp.
Đừng nhầm lỗi proxy với lỗi site
Khi một URL báo lỗi, phân biệt hai trường hợp. Lỗi 4xx hoặc 5xx do site đích trả là kết quả thật của URL. Lỗi hết giờ, từ chối kết nối hoặc 407 thường đến từ proxy hoặc đường mạng. Chạy lại cùng URL không qua proxy là cách nhanh nhất để phân biệt.
Bài công cụ kiểm tra proxy giới thiệu các cách kiểm proxy độc lập. Kiểm proxy bằng công cụ khác rồi mới nạp vào ScrapeBox giúp loại bớt biến số khi gỡ lỗi.
ScrapeBox proxy: gỡ cấu hình thử, bí mật và checklist dùng thật
Sau khi thử, anh em dọn dẹp để không để lại danh sách proxy có mật khẩu rải rác. Xóa các tệp proxy tạm, xóa proxy khỏi Proxy Manager nếu không dùng nữa, và nếu đã lưu danh sách lên đám mây thì xóa luôn bản đó. Nhật ký thay đổi cho biết Proxy Manager có thể lưu và nạp danh sách qua đám mây, nên bản lưu đó cũng cần được dọn.
Mật khẩu proxy là bí mật. Đừng gửi tệp danh sách có mật khẩu qua chat hoặc email. Nếu nhiều người trong nhóm dùng chung, hãy cấp tài khoản riêng cho từng người hoặc dùng whitelist IP của từng máy.
Cần proxy ổn định để kiểm URL của site mình, anh em có thể mua proxy uy tín tại ProxyVN: proxy dân cư tĩnh Viettel, VNPT, FPT, datacenter Việt Nam và Mỹ, 4G và proxy xoay. Nhà cung cấp hỗ trợ HTTP và SOCKS5, cấp tài khoản hoặc whitelist IP.
Checklist trước khi chạy thật
- Chỉ kiểm URL của site mình hoặc site đã được phép.
- Cập nhật ScrapeBox lên bản mới nhất trước khi kiểm proxy.
- Nạp thử một dòng proxy để xem định dạng được nhận ra chưa.
- Dùng Custom Test trỏ vào trang của chính site cần kiểm.
- Đặt số luồng thấp rồi tăng dần, theo dõi tỷ lệ lỗi.
- Cho phép các mã chuyển hướng là sống nếu muốn thấy đích cuối.
- Dọn danh sách proxy và bản lưu đám mây sau khi xong.
Khi nào không cần ScrapeBox
Nếu anh em chỉ kiểm vài trăm URL của một site, một script ngắn hoặc một công cụ crawl khác có thể đủ. ScrapeBox có ích khi cần giao diện, xuất Excel nhanh và nhiều luồng. Đừng cài thêm công cụ chỉ vì có sẵn chức năng, và bài proxy cho SEO website lên top bàn thêm về chọn công cụ đúng việc.
ScrapeBox proxy: câu hỏi thường gặp
ScrapeBox proxy có hỗ trợ SOCKS5 không. Theo nhật ký thay đổi chính thức, bản 2.0.0.30 thêm hỗ trợ SOCKS5 đầy đủ, và bản 2.0.0.62 cho phép tự xác định loại proxy trong lúc kiểm. Anh em kiểm trên bản đang dùng.
Proxy có mật khẩu dùng được không. Có. Trang Proxy Harvester nói trình kiểm proxy kiểm được proxy riêng cần tên đăng nhập và mật khẩu.
Module nào của ScrapeBox dùng proxy. Các trang chính thức ghi Proxy Support cho Alive Checker, Redirect Checker, Broken Links Checker, Page Scanner, Outbound Link Checker, Webpage Meta Scraper và Search Engine Scraper. Bài này chỉ dùng các module kiểm URL.
Có nên dùng proxy công khai miễn phí không. Mình không khuyên. Chất lượng và độ an toàn của proxy công khai khó kiểm soát, và bài free proxy có an toàn không giải thích rủi ro.
Kiểm Google có cần thiết không. Chỉ khi anh em làm việc với kết quả tìm kiếm. Với kiểm URL của site mình, Custom Test trên trang của chính site hợp lý hơn.
Nạp proxy theo định dạng nào. Các trang chính thức mình đọc không nói rõ. Hướng dẫn bên thứ ba dùng ip:port và ip:port:user:pass. Anh em nạp thử một dòng và xem lưới proxy hiển thị trước.
Dùng cùng một danh sách proxy cho nhiều module được không. Được, vì danh sách nằm trong Proxy Manager và các module đọc từ đó. Tuy nhiên nên giảm số luồng khi chạy nhiều module cùng lúc, vì tổng yêu cầu qua cùng một proxy sẽ cộng dồn.
Kiểm URL qua proxy có chậm hơn không. Có thêm một chặng nên mỗi yêu cầu chậm hơn đôi chút. Bù lại anh em chạy được nhiều luồng hơn mà không bị giới hạn theo một IP, nên tổng thời gian cho danh sách lớn thường không tệ hơn.
Bài này có thay được hướng dẫn chính thức của ScrapeBox không. Không. Mình chưa chạy ScrapeBox, nên các bước giao diện cụ thể cần đối chiếu với video hướng dẫn chính thức trên kênh của họ.
ScrapeBox proxy và những điều cần nhớ
ScrapeBox proxy dùng tốt nhất cho việc kiểm URL của site được phép: nạp proxy vào Proxy Manager, kiểm bằng Custom Test, rồi chạy Alive hoặc Redirect Checker với số luồng vừa phải. Mã 407 là proxy sống từ chối tài khoản, không phải proxy hỏng. Cần proxy có tài khoản hoặc whitelist IP, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam cho ScrapeBox proxy.


