
RabbitMQ publisher confirms cho crawl: không mất task khi lỗi
RabbitMQ publisher confirms cho crawl là cách để bên đẩy URL biết broker đã nhận task hay chưa, rồi kết hợp với consumer ack để task không rơi giữa đường. Hai cơ chế này giải hai nửa khác nhau của bài toán. ProxyVN chạy thư viện pika thật trên một broker mô phỏng tự viết, cho broker và worker chết ở từng thời điểm, rồi ghi lại timeline.
RabbitMQ publisher confirms cho crawl: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và giới hạn của lab.
Bài toán cần giải
Một crawler đưa URL vào RabbitMQ, nhiều worker lấy ra và tải. Sau một lần khởi động lại broker, số trang tải được ít hơn số URL đã đẩy. Lần khác, cùng một trang lại nằm hai lần trong kho. Nhóm cần biết task mất ở đâu, trùng ở đâu, và phải sửa chỗ nào.
Đầu ra nghiệm thu
Đầu ra là timeline publish, confirm, deliver, ack cho từng ca lỗi. Kèm theo là một bảng cho biết chết ở thời điểm nào thì mất task, thời điểm nào thì trùng task. Phần code gồm outbox phía publisher và bảng done phía worker.
Ranh giới với bài Celery
Bài Celery nói về API của framework task, ví dụ gọi delay và cấu hình worker. Bài này đi xuống tầng giao thức, nói chuyện giao nhận giữa client và broker. Anh em dùng Celery thì khái niệm vẫn đúng, nhưng tên cấu hình sẽ khác và bài không bàn tới.
Giới hạn của lab
Đây là điểm phải nói trước. Lab không chạy RabbitMQ thật. Máy lab không tải được máy chủ từ bên ngoài, nên ProxyVN viết một broker AMQP 0-9-1 rất nhỏ bằng Python, dùng bộ mã frame của pika. Broker này chỉ có handshake, channel, confirm, khai báo queue, publish, consume, ack và nack.
Thứ gì thật, thứ gì giả
Client pika 1.4.4 là thật, nói giao thức thật qua socket thật. Worker là tiến trình riêng, bị giết thật bằng os._exit. Còn quy tắc giữ và trả lại thông điệp là do ProxyVN viết theo tài liệu RabbitMQ. Broker mô phỏng không có đĩa, không có cluster, không có quorum queue.
Vậy kết quả có giá trị tới đâu
Lab chứng minh mã client của anh em phản ứng đúng với từng tín hiệu: có confirm, không có confirm, nack, return, redelivered. Nó không chứng minh RabbitMQ thật ghi đĩa nhanh chậm ra sao. Mọi con số về độ bền và độ trễ, anh em phải đo trên broker thật của mình.
Ai nên đọc bài này
Người đang vận hành crawler phân tán dùng RabbitMQ. Người thấy số task đẩy vào không khớp số trang tải được. Người định dùng auto_ack cho nhanh mà chưa biết cái giá của nó.
Chống mất task crawl bằng RabbitMQ publisher confirms cho crawl và consumer ack
Phần này tóm tắt tài liệu chính thức, vì nhầm hai khái niệm là nguồn gốc của hầu hết lỗi.
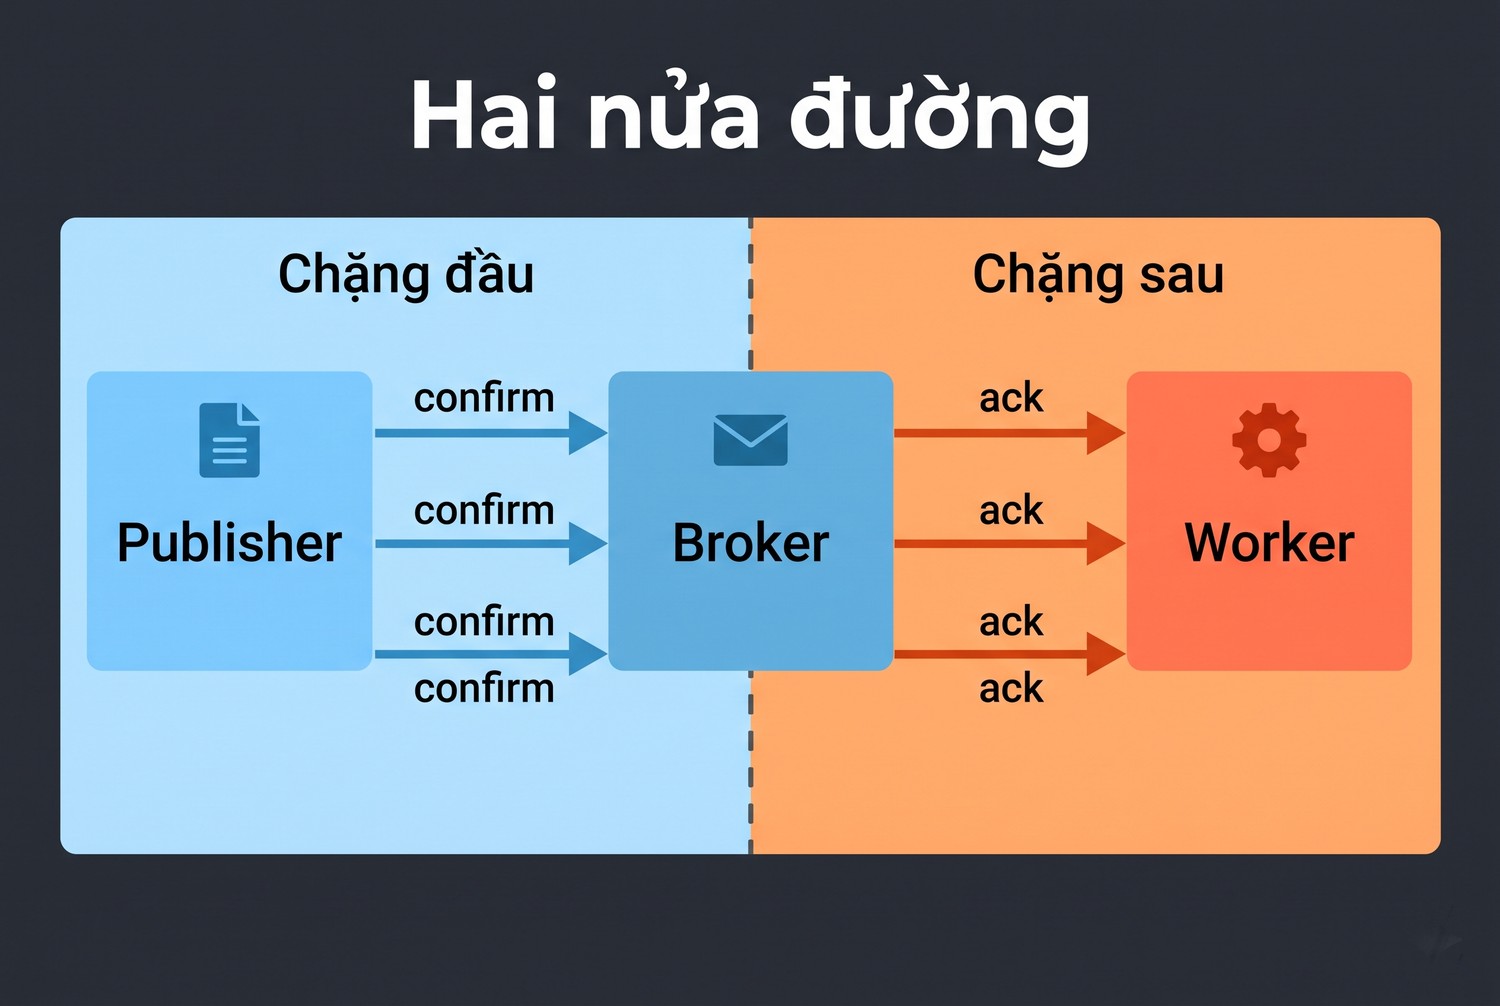
Hai cơ chế, hai nửa đường
Hai nửa đường
Trang Consumer Acknowledgements and Publisher Confirms viết rõ publisher confirm chỉ nói về liên lạc giữa publisher và broker, không biết gì về consumer. Consumer ack thì không biết gì về publisher. Hai cơ chế độc lập, nên có cái này không thay được cái kia.
Cơ chế |
Ai nói với ai |
Trả lời câu hỏi |
|---|---|---|
Publisher confirm |
Broker báo publisher |
Broker đã nhận trách nhiệm giữ task chưa |
Consumer ack |
Consumer báo broker |
Task đã được xử lý xong, xóa được chưa |
Mandatory và return |
Broker trả lại publisher |
Task có vào được queue nào không |
Prefetch |
Consumer đặt giới hạn |
Được giữ bao nhiêu task chưa ack |
Vì sao thiếu confirm là mất âm thầm
Publish trong AMQP không chờ trả lời. Hàm basic_publish chạy xong chỉ nói rằng byte đã ghi ra socket. Broker chết ngay sau đó thì publisher không biết gì. Tài liệu nói muốn bảo đảm giữ được thông điệp thì client nên dùng confirm.
Confirm được gửi khi nào
Tài liệu nêu với thông điệp persistent đi vào durable queue, broker gửi basic.ack sau khi đã ghi xuống đĩa. RabbitMQ ghi theo lô, cách nhau vài trăm mili giây, để giảm số lần fsync. Vậy nên publisher chờ confirm từng thông điệp một sẽ chậm, và tài liệu khuyên xử lý theo lô.
Điều kiện đủ để giữ được
Confirm chỉ có ý nghĩa khi cả hai vế đúng: queue là durable và thông điệp có delivery_mode bằng 2. Tài liệu cũng cảnh báo node có thể mất thông điệp persistent nếu lỗi trước khi ghi xong, trong khi client chưa dùng confirm. Quên một vế, task vẫn bay hơi khi broker khởi động lại.
Consumer ack hoạt động thế nào
Với ack thủ công, broker giữ thông điệp cho tới khi nhận basic.ack. Tài liệu nêu thông điệp chưa ack sẽ tự động được đưa lại queue khi channel hoặc connection đóng, gồm cả mất TCP và tiến trình consumer chết. Việc phát hiện client mất cũng tốn một khoảng thời gian.
Cờ redelivered
Tài liệu nêu thông điệp giao lại có cờ redelivered bằng true, lần đầu là false. Cờ này chỉ là gợi ý. Nó không nói lần trước đã làm tới đâu. Thông điệp cũng có thể đã từng giao cho một consumer khác, nên worker không thể dựa vào bộ nhớ riêng của mình.
Câu quan trọng nhất trong tài liệu
Tài liệu kết luận consumer phải chuẩn bị cho việc giao lại và phải được thiết kế theo hướng idempotent. Nói cách khác, RabbitMQ giao ít nhất một lần. Không có cấu hình nào của broker thay được việc worker tự chịu trùng.
Delivery tag có phạm vi channel
Tài liệu nêu delivery tag tăng dần và gắn với channel. Ack bằng tag trên channel khác sẽ gặp lỗi giao thức unknown delivery tag. Với crawler đa luồng, đừng giữ tag rồi ack từ một channel khác. Tag cũng không phải mã task, vì lần giao lại có thể mang tag khác.
Prefetch và công bằng giữa worker
Prefetch giới hạn số thông điệp chưa ack trên một channel. Không đặt, một worker có thể ôm rất nhiều task rồi chết, kéo theo tất cả phải giao lại. Tải trang chậm và thời gian dao động lớn, nên prefetch nhỏ là hợp lý. Lab dùng prefetch 1 để timeline dễ đọc.
Bật RabbitMQ publisher confirms cho crawl và lưu task ID trước publish
Phần này là mã publisher, chỗ giải quyết nửa đầu của bài toán.
Bật confirm trong pika
Với BlockingConnection, chỉ một dòng confirm_delivery. Sau đó basic_publish sẽ chờ phản hồi và ném ngoại lệ nếu không thành công. Anh em dùng mandatory để bắt trường hợp không có queue nào nhận.
import json, pika
from pika import exceptions as X

c = pika.BlockingConnection(pika.ConnectionParameters("127.0.0.1", 9475))
ch = c.channel()
ch.confirm_delivery()
ch.queue_declare("crawl", durable=True)

ch.basic_publish(
    "", "crawl",
    json.dumps({"task_id": "t1", "url": "http://s/t1"}),
    pika.BasicProperties(delivery_mode=2, message_id="t1"),
    mandatory=True,
)
Đoạn trên chạy thật với pika 1.4.4 trên broker mô phỏng. Cổng 9475 là của lab, RabbitMQ mặc định dùng 5672.
Ca không bật confirm
Lab gửi vào một queue chưa tồn tại, không confirm, không mandatory. Hàm basic_publish chạy xong không báo gì, queue trống, phía broker mô phỏng ghi nhận bỏ qua. Ở phía publisher, ca này nhìn y như thành công. Đây là kiểu mất task khó tìm nhất, vì không có dòng lỗi nào.
Ca confirm cộng mandatory
Cũng queue đó, có confirm và mandatory, pika ném UnroutableError với thông báo một thông điệp bị trả về. Đây là tín hiệu đúng. Anh em bắt ngoại lệ, giữ task lại, báo cấu hình sai tên queue.
Vì sao cần outbox
Confirm cho biết kết quả của từng lần gửi. Nó không giúp nếu chính publisher chết giữa chừng. Muốn không mất URL, phải ghi task xuống chỗ bền trước khi publish, rồi chỉ đánh dấu xong khi có confirm. Đó là mẫu outbox.
out.execute("""create table outbox(
  task_id text primary key, url text,
  state text default 'new', tries int default 0)""")

def pub_all(q):
    c = conn()
    ch = c.channel()
    ch.confirm_delivery()
    ch.queue_declare(q, durable=True)
    rows = out.execute("select task_id,url from outbox where state='new'").fetchall()
    for tid, url in rows:
        out.execute("update outbox set tries=tries+1 where task_id=?", (tid,))
        try:
            ch.basic_publish("", q, json.dumps({"task_id": tid, "url": url}),
                pika.BasicProperties(delivery_mode=2, message_id=tid), mandatory=True)
            out.execute("update outbox set state='confirmed' where task_id=?", (tid,))
        except (X.NackError, X.UnroutableError, X.AMQPError):
            return
Hàm này là mã lab, rút gọn phần đếm và đóng kết nối. Mã task sinh ra trước khi gửi và đi theo thông điệp suốt đường, nên về sau đối soát được.
Mã task lấy từ đâu
Mã task nên suy ra từ nội dung, ví dụ băm URL đã chuẩn hóa cộng lượt crawl. Sinh mã ngẫu nhiên mỗi lần publish sẽ làm hai bản trùng có hai mã khác nhau, và phía worker không khử trùng được. Quy tắc này quyết định mọi thứ ở phần sau.
Ca broker chết trước khi lưu
Broker mô phỏng đóng kết nối ngay khi nhận thông điệp, chưa lưu. pika ném StreamLostError. Outbox giữ t1 ở trạng thái new, tries bằng 1. Lần chạy thứ hai gửi lại t1 và t2, cả hai được confirm. Task không mất.
Lượt |
Confirmed |
Trong queue |
Trạng thái outbox |
|---|---|---|---|
Lần 1 |
0 |
0 |
t1 new, tries 1; t2 new, tries 0 |
Lần 2 |
2 |
2 |
t1 confirmed, tries 2; t2 confirmed, tries 1 |
Ca broker lưu xong rồi chết trước confirm
Không rõ đã lưu hay chưa
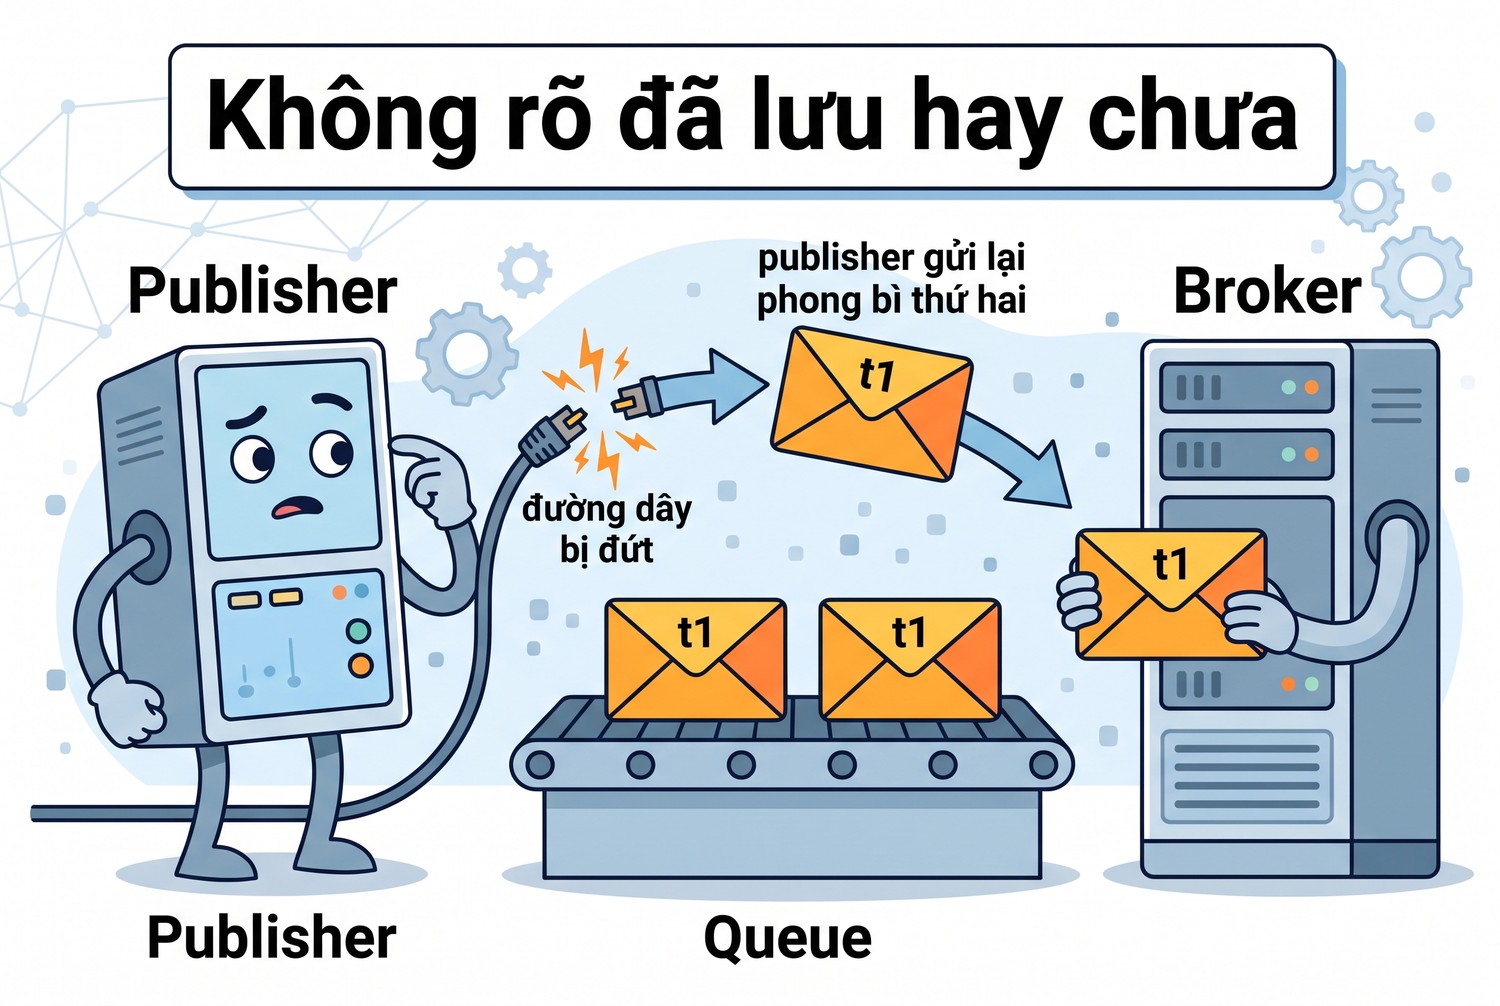
Ca này đau hơn. Broker mô phỏng lưu task, rồi đóng kết nối trước khi gửi confirm. Publisher nhận StreamLostError, không biết task đã vào hay chưa, nên gửi lại. Queue có hai bản t1. Không có cách nào phân biệt ca này với ca trước từ phía publisher.
Kết luận cho phía publisher
Phía publisher chỉ có hai lựa chọn: không gửi lại và có thể mất, hoặc gửi lại và có thể trùng. Với crawl, chọn gửi lại. Trùng thì xử lý được, mất thì không biết mà xử lý. Vì thế confirm luôn đi kèm khử trùng ở worker.
Ca broker nack
Tài liệu nêu broker có thể gửi basic.nack khi không nhận được trách nhiệm giữ thông điệp. Lab cho broker mô phỏng trả nack, pika ném NackError, outbox giữ new. Anh em đối xử với nack như một lỗi tạm: chờ một lúc rồi gửi lại, kèm trần số lần thử.
Gửi theo lô
Chờ confirm từng thông điệp có độ trễ cộng dồn. Tài liệu gợi ý publish theo lô rồi chờ các confirm còn treo. BlockingConnection chờ từng cái nên dễ hiểu nhưng chậm. Khi cần thông lượng cao, chuyển sang SelectConnection với callback theo delivery tag. Lab không đo phần này.
Phân biệt broker confirm với consumer ack trong RabbitMQ publisher confirms cho crawl
Phần này đi vào worker và đọc timeline của ca bình thường.
Worker tối thiểu
Worker bật ack thủ công, đặt prefetch, và chỉ ack sau khi đã lưu kết quả. Thứ tự này là cả câu chuyện.
ch.basic_qos(prefetch_count=1)

def cb(ch, m, p, b):
    t = json.loads(b)
    effect(t)                     # tai trang, luu ket qua
    ch.basic_ack(m.delivery_tag)  # chi ack sau khi da luu

ch.basic_consume("crawl", cb, auto_ack=False)
ch.start_consuming()
Hàm effect trong lab ghi một dòng vào SQLite thay cho việc tải trang, để dễ đếm số lần chạy.
Timeline ca bình thường
Ba task đi trọn đường. Mỗi task có bốn mốc, và mỗi mốc do một bên khác nhau xác nhận.
Mốc |
Bên phát sinh |
Ý nghĩa |
|---|---|---|
luu t1 |
Broker |
Task đã nằm trong queue |
publisher_confirm 1 |
Broker tới publisher |
Publisher được đánh dấu xong |
deliver tag 1, redelivered False |
Broker tới worker |
Worker bắt đầu làm |
consumer_ack 1 |
Worker tới broker |
Broker xóa task |
Kết quả: t1, t2, t3 mỗi task chạy một lần, queue về 0.
Nhầm lẫn hay gặp
Publisher thấy confirm rồi báo trang đã tải xong. Sai. Confirm chỉ nói task đã vào queue. Muốn biết trang đã tải, phải nhìn kho kết quả. Dashboard nên có hai số riêng: số task confirmed và số task done.
Hai trạng thái trong outbox
Outbox nên dừng ở confirmed. Trạng thái done nằm ở phía worker. Trộn hai thứ vào một cột sẽ tạo ra phụ thuộc vòng: worker phải quay về sửa bảng của publisher. Đối soát cuối ngày chỉ cần so hai tập mã task.
Tại sao không dùng auto_ack
Với auto_ack, broker coi thông điệp xong ngay khi gửi đi. Tài liệu gọi đây là chế độ fire and forget, đánh đổi độ an toàn để lấy thông lượng. Lab cho worker auto_ack chết ngay khi nhận t1: queue về 0, kết quả rỗng, task mất hẳn. Với crawl, tải trang chậm hơn giao thông điệp rất nhiều, nên thông lượng thêm đó không đáng.
Nack và requeue
Khi tải lỗi tạm thời, worker có thể gọi basic_nack với requeue true. Tài liệu cảnh báo thông điệp requeue có thể quay lại ngay, tạo vòng lặp giao lại tốn tài nguyên. Một URL hỏng sẽ quay mãi. Anh em nên đếm số lần thử trong header hoặc kho riêng, rồi đưa sang queue lỗi.
Hàng đợi lỗi cho URL hỏng
Với URL lỗi vĩnh viễn như 404, không nên requeue. Gọi nack với requeue false và cấu hình dead letter exchange để thông điệp sang queue lỗi. Lab không có dead letter vì broker mô phỏng không làm phần này, nên bài chỉ nêu hướng, không có kết quả chạy.
Timeout khi giữ thông điệp quá lâu
Tài liệu có nhắc RabbitMQ áp thời hạn ack cho consumer. Task tải dài hơn thời hạn đó thì kênh có thể bị đóng và thông điệp trả lại queue. Crawler có trang rất chậm nên kiểm tra cấu hình này trên broker thật. Lab không mô phỏng thời hạn, nên bài không nêu con số.
Cho worker dừng trước và sau ack trong RabbitMQ publisher confirms cho crawl
Phần này là nơi lab có giá trị nhất, vì nó cho thấy thứ tự thao tác quyết định kết quả.
Cách giết worker
Mỗi worker là một tiến trình Python riêng. Lab gọi os._exit(9) ở đúng điểm cần kiểm tra, nên không có khối finally nào chạy, không có đóng kết nối tử tế. Với broker mô phỏng, socket mất, và thông điệp chưa ack được đưa lại đầu queue.
Ca worker chết sau khi lưu, trước khi ack
Ack sau khi lưu
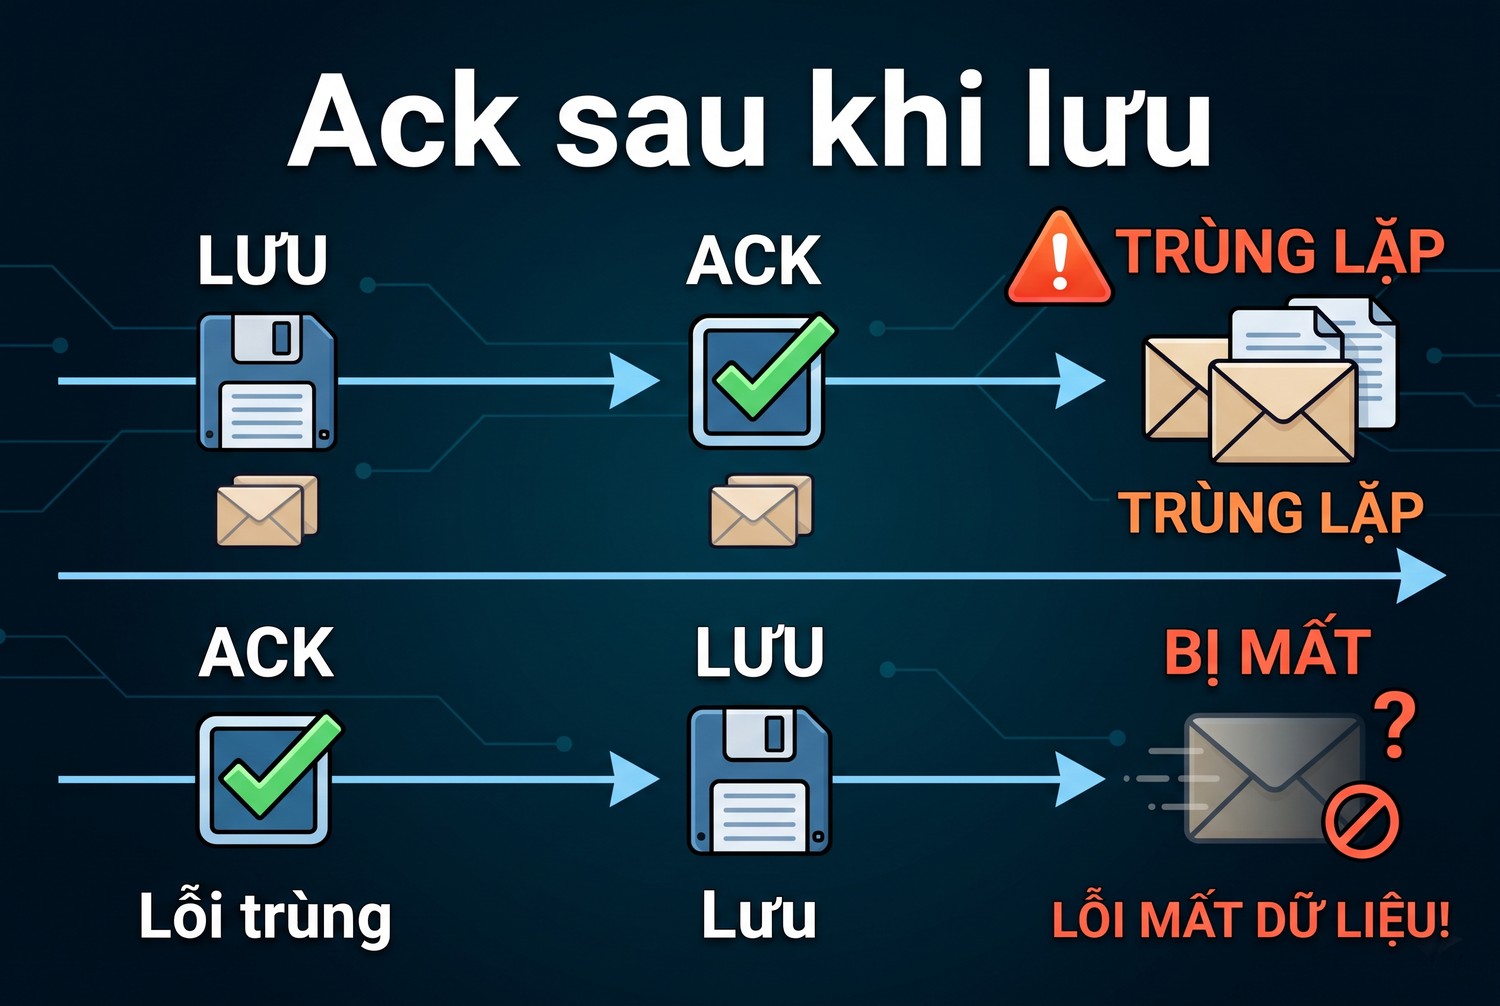
Worker nhận t1, lưu kết quả, rồi chết. Broker đưa t1 lại queue. Worker thứ hai nhận t1 với redelivered bằng True, lưu lần nữa, rồi ack. Bảng kết quả có t1 hai lần.
worker die_before_ack exit=9: nhan task=t1 tag=1 redelivered=False
queue 1, ket qua [('t1', 1)]
worker normal exit=0: nhan task=t1 tag=1 redelivered=True
ket qua [('t1', 2)]
timeline: deliver 1 False, requeue 1, deliver 1 True, consumer_ack 1
Đây là output của lab. Tag ở hai lần đều là 1 vì mỗi worker có channel mới, đúng như việc tag gắn với channel.
Ca worker chết sau khi ack, trước khi lưu
Worker ack trước cho nhanh, rồi chết. Broker đã xóa t1. Queue chỉ còn t2. Worker kế tiếp làm t2, và t1 biến mất khỏi hệ thống mà không để lại dấu vết nào.
worker early_ack_die exit=9: nhan task=t1 tag=1 redelivered=False
queue 1, ket qua []
worker normal exit=0: nhan task=t2 tag=1 redelivered=True
ket qua [('t2', 1)]
Để ý t2 cũng có redelivered True dù chưa ai xử lý nó. Trong lab, worker đầu đã nhận trước t2 rồi chết trước khi đụng tới. Cờ này không có nghĩa là task đã được làm một phần.
Giữ thông điệp nhỏ
Thông điệp chỉ nên chứa mã task, URL và vài tham số. Đừng nhét HTML vào queue. Trang đã tải nên nằm ở kho tệp, còn thông điệp mang đường dẫn tới tệp đó. Thông điệp nhỏ thì ghi đĩa nhanh, confirm về nhanh, và queue không ngốn bộ nhớ khi worker chậm.
Task dài và heartbeat
Với BlockingConnection, callback chạy lâu sẽ chặn vòng lặp của pika, nên client không trả lời được heartbeat. Trang chậm vài phút có thể làm broker cắt kết nối, kéo theo task bị giao lại dù worker vẫn đang làm. Lab đặt heartbeat bằng 0 để timeline gọn, nên không thử ca này. Khi triển khai, anh em đưa phần tải sang luồng riêng và ack trở lại bằng add_callback_threadsafe, hoặc đặt timeout tải ngắn hơn heartbeat.
Dừng worker tử tế khi triển khai
Mỗi lần cập nhật mã, worker bị dừng giữa lúc đang có task. Nếu chỉ kill, task đó được giao lại và làm từ đầu. Cách dừng gọn là bắt tín hiệu, gọi stop_consuming, làm nốt task hiện tại, ack rồi mới thoát. Prefetch nhỏ giúp bước này kết thúc nhanh, vì worker không ôm nhiều task chưa làm.
Bảng chết ở đâu thì ra sao
Bảng này gom các ca đã chạy. Kết quả phản ánh quy tắc trong tài liệu, được mô phỏng lại, nên anh em cần thử lại trên broker thật.
Thời điểm chết |
Cấu hình |
Kết quả |
Hướng xử lý |
|---|---|---|---|
Broker chết trước khi lưu |
Confirm + outbox |
Gửi lại, không mất |
Giữ nguyên |
Broker chết sau lưu, trước confirm |
Confirm + outbox |
Trùng 1 bản |
Khử trùng ở worker |
Worker chết sau lưu, trước ack |
Ack thủ công |
Trùng 1 lần xử lý |
Khử trùng ở worker |
Worker chết sau ack, trước lưu |
Ack sớm |
Mất task |
Ack sau khi lưu |
Worker chết khi vừa nhận |
auto_ack |
Mất task |
Bỏ auto_ack |
Quy tắc ngắn gọn
Ack đặt sau side effect thì lỗi biến thành trùng. Ack đặt trước side effect thì lỗi biến thành mất. Chọn đặt sau, rồi làm side effect chịu được trùng. Hai dòng này đáng dán lên đầu tệp worker.
Đối soát redelivery và side effect trùng với RabbitMQ publisher confirms cho crawl
Phần này giải nốt nửa còn lại: làm sao chịu được trùng.
Bảng done
Cách đơn giản nhất là bảng có khóa chính task_id. Worker thử chèn trước, chèn được mới làm, không chèn được thì chỉ ack.
def cb(ch, m, p, b):
    t = json.loads(b)
    cur = db.execute("insert or ignore into done(task_id) values(?)", (t["task_id"],))
    if cur.rowcount:
        effect(t)
    ch.basic_ack(m.delivery_tag)
Với ca broker gửi hai bản t1, worker in ra dòng đã xử lý trước đó, chỉ ack, và kết quả là t1 một lần. Đây là output thật của lab.
Lỗ hổng của cách trên
Đoạn trên chèn done trước khi effect chạy. Worker chết giữa hai dòng thì done có t1 nhưng kết quả không có, lần giao lại sẽ bỏ qua và task mất. Lỗ hổng này nguy hiểm vì nó xóa đi đúng lợi ích của ack sau.
Cách đúng hơn
Đưa done và kết quả vào cùng một giao dịch, hoặc viết kết quả theo kiểu ghi đè bằng khóa task_id. Với kho dữ liệu hỗ trợ upsert, chỉ cần một câu ghi có khóa ổn định, không cần bảng done riêng. Lần thứ hai ghi đè giá trị giống hệt, không có gì sai.
INSERT INTO result(task_id, url, body_hash, fetched_at)
VALUES (?, ?, ?, ?)
ON CONFLICT(task_id) DO UPDATE SET
  body_hash = excluded.body_hash,
  fetched_at = excluded.fetched_at;
Câu này là ví dụ triển khai cho SQLite, ProxyVN không chạy nó trong lab. Điểm chính là một câu lệnh, một khóa.
Side effect không gom được vào giao dịch
Tải trang là side effect ra bên ngoài, không thể hoàn tác. Hai lần tải cùng URL là hai request tới website người ta. Với crawl thông thường, tải trùng hiếm gặp vẫn chấp nhận được. Nhưng nếu task là gửi biểu mẫu hay gọi API có tính phí, phải có khóa idempotency ở phía dịch vụ, và đó là việc nằm ngoài phạm vi broker.
Dùng cờ redelivered thế nào cho đúng
Cờ false chưa chắc là lần đầu: bản trùng do publisher gửi lại cũng có cờ false, như ca hai bản t1 trong lab. Vì thế đừng dùng cờ này để quyết định có khử trùng hay không. Hãy luôn kiểm tra theo task_id. Cờ chỉ nên dùng để ghi số liệu theo dõi.
Đối soát cuối ngày
Đối soát
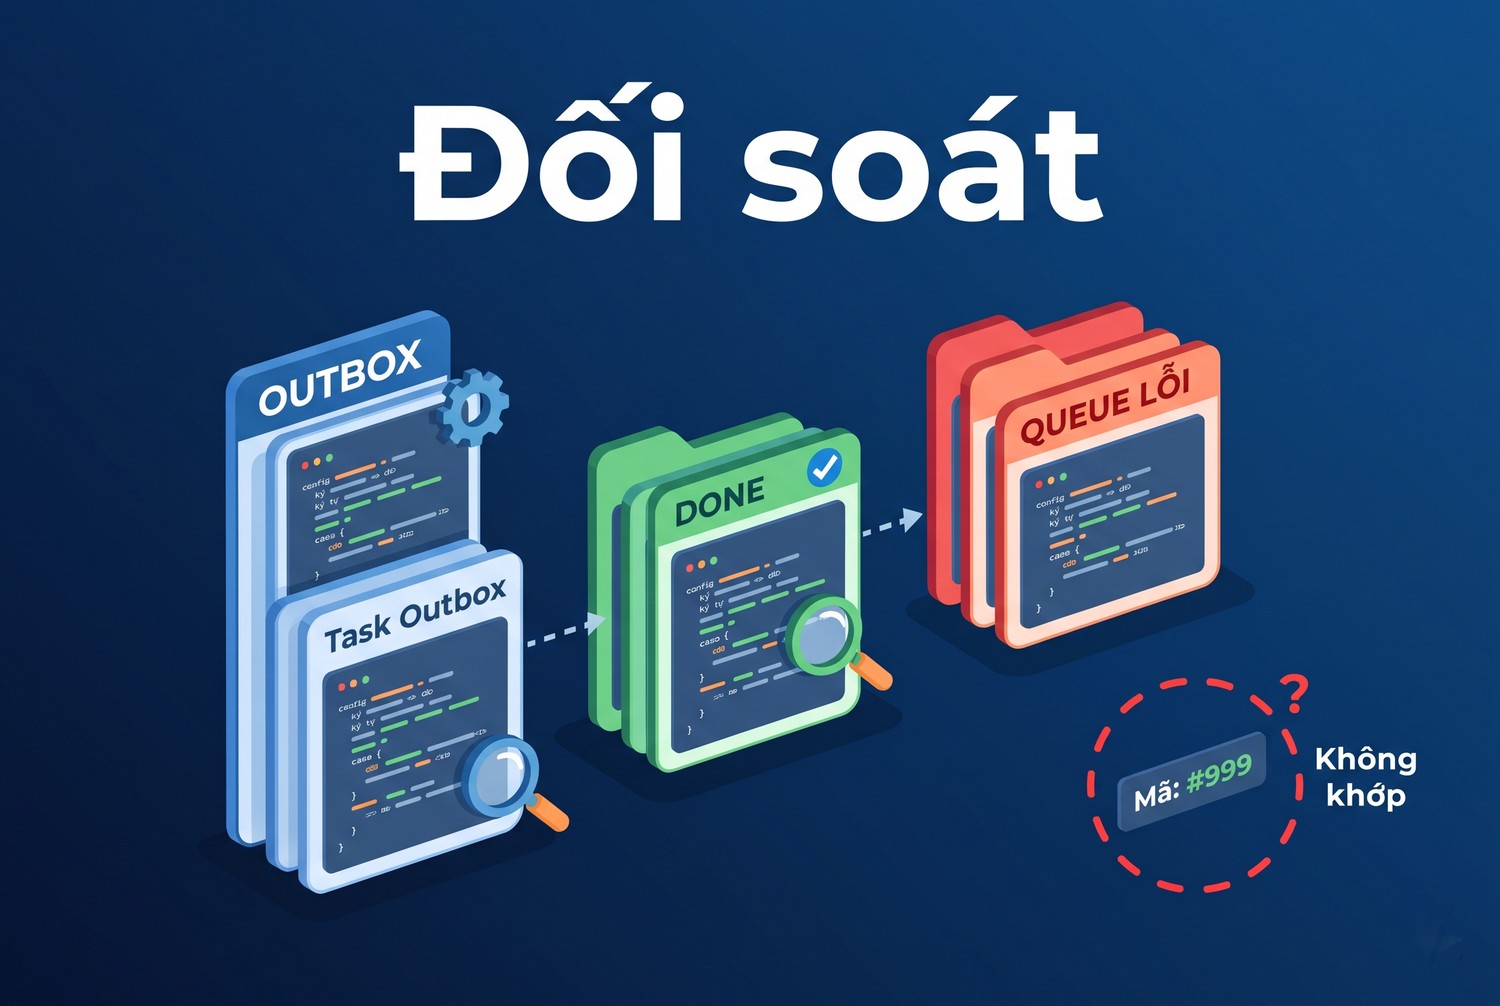
Mỗi ngày so ba tập mã: task trong outbox, task trong done, và task trong queue lỗi. Mã có trong outbox mà không có ở hai tập kia, sau một khoảng đủ lâu, là task mất. Lab dùng đúng phép so này để tìm ra t1 trong ca ack sớm.
SELECT o.task_id FROM outbox o
LEFT JOIN done d ON d.task_id = o.task_id
WHERE o.state = 'confirmed' AND d.task_id IS NULL;
Câu lệnh này giả định hai bảng cùng cơ sở dữ liệu. Nếu tách riêng, anh em xuất mã ra rồi so bằng script.
Số liệu nên theo dõi
Theo dõi số task confirmed, số done, số lần redelivered, độ sâu queue, và tuổi task cũ nhất. Tỷ lệ redelivered tăng đột ngột thường là dấu hiệu worker chết hoặc task dài quá thời hạn. Tuổi task cũ nhất cho biết hàng đợi có tắc không, chính xác hơn độ sâu queue.
Đầu ra nghiệm thu của RabbitMQ publisher confirms cho crawl
Phần này gom tiêu chí để biết đã làm xong.
Danh sách kiểm tra
Hệ thống đạt khi mọi dòng dưới đây đúng.
- Queue là durable, thông điệp có delivery_mode 2.
- Publisher bật confirm và mandatory, không gửi task nào chưa có trong outbox.
- Mã task ổn định, suy ra từ nội dung.
- Worker dùng ack thủ công, ack sau khi đã lưu kết quả.
- Lưu kết quả là thao tác ghi đè được theo mã task.
- Prefetch có giá trị cụ thể, không để mặc định không giới hạn.
- Có queue lỗi và trần số lần thử.
- Có đối soát outbox với kết quả.
Thứ tự triển khai từng bước
Anh em đang có hệ thống chạy thì sửa theo thứ tự này, mỗi bước kiểm tra xong mới sang bước sau.
- Chuyển queue sang durable và thêm delivery_mode 2 cho thông điệp.
- Sinh mã task ổn định, đưa vào message_id và phần thân thông điệp.
- Đổi lưu kết quả thành ghi đè theo mã task.
- Tắt auto_ack, đặt prefetch, chuyển ack xuống sau bước lưu.
- Bật confirm và mandatory ở publisher, thêm outbox.
- Thêm queue lỗi, trần số lần thử, và đối soát hằng ngày.
Bước ghi đè phải đi trước bước đổi ack. Làm ngược lại, số bản trùng sẽ tăng ngay khi worker bắt đầu ack muộn.
Thử nghiệm phá hỏng nên chạy trên môi trường thật
Trên broker thật, anh em chạy lại bốn ca: tắt broker giữa lúc đẩy, tắt mạng giữa lúc confirm, kill worker trước ack, kill worker sau ack. Lần nào cũng đếm số task vào và số task ra. Dùng cùng script publisher và worker, chỉ đổi cổng sang 5672.
Những gì lab chưa chạy
Chưa chạy RabbitMQ thật. Chưa có đĩa, chưa có quorum queue, chưa có cluster, chưa có dead letter exchange, chưa có thời hạn ack, chưa đo độ trễ confirm. Bài cũng chưa thử chế độ bất đồng bộ của pika. Tất cả cần kiểm trên hệ thống của anh em.
Quorum queue hay classic queue
Tài liệu độ tin cậy của RabbitMQ bàn về nhân bản dữ liệu giữa nhiều node. Crawl một node thì durable queue là đủ để bắt đầu. Khi mất task thật sự gây thiệt hại, cần xem xét quorum queue. Lab không kiểm chứng phần này nên bài không khuyến nghị cụ thể.
Kết nối lại khi mất mạng
BlockingConnection không tự kết nối lại. Worker nên bọc vòng lặp ngoài cùng, bắt lỗi AMQPConnectionError, chờ rồi tạo kết nối mới. Lab thấy lỗi StreamLostError nằm trong nhóm lỗi AMQP nên một khối except là đủ. Thời gian chờ nên tăng dần, tránh nhiều worker cùng nối lại một lúc.
Proxy nằm ở đâu trong sơ đồ
Proxy không đụng tới RabbitMQ. Nó thuộc về bước tải trang bên trong effect. Với website được phép thu thập, có lúc cần IP tại Việt Nam để nhận đúng nội dung trong nước. Khi đó anh em có thể mua proxy tại trang chủ ProxyVN. Proxy không giữ được task và không sửa lỗi ack. Bối cảnh dùng hàng đợi cho thu thập dữ liệu lớn có ở bài Proxy training AI, vai trò proxy khi cào dữ liệu ở bài Web Scraping proxy là gì.
Khi proxy lỗi thì ack hay không
Lỗi proxy là lỗi tạm. Worker nên nack hoặc đưa vào queue thử lại có độ trễ, đừng ack rồi coi như hỏng. Hãy tách ba nhóm lỗi: proxy hoặc mạng thì thử lại, website trả 4xx thì đưa sang lỗi, dữ liệu sai thì giữ để xem. Thông tin proxy nên nằm trong cấu hình worker, đừng nhét vào thông điệp, cách viết chuỗi cấu hình có ở bài định dạng proxy.
RabbitMQ publisher confirms cho crawl: câu hỏi thường gặp
Các câu dưới đây gom những điểm anh em hay hỏi.
Publisher confirm có nghĩa là trang đã được tải chưa?
Không. Confirm chỉ nói broker đã nhận trách nhiệm giữ task. Muốn biết đã tải, phải xem kho kết quả hoặc bảng done của worker.
Bật confirm rồi có cần consumer ack không?
Có. Tài liệu nói rõ hai cơ chế độc lập. Lab cho thấy có confirm mà worker dùng auto_ack thì task vẫn mất khi worker chết.
Task có thể bị xử lý hai lần dù cấu hình đúng không?
Có. Lab tái lập hai đường: publisher gửi lại khi mất confirm, và worker chết trước khi ack. Tài liệu cũng yêu cầu consumer được thiết kế idempotent.
Nên ack trước hay sau khi lưu kết quả?
Sau. Ack trước khiến lỗi trở thành mất task. Ack sau khiến lỗi trở thành trùng task, mà trùng thì khử được bằng mã task ổn định.
Cờ redelivered có đủ để khử trùng không?
Không đủ. Trong lab, bản trùng do publisher gửi lại có cờ false, và một task chưa ai xử lý vẫn có cờ true. Hãy khử trùng theo mã task.
Kết quả trong bài có đúng với RabbitMQ thật không?
Quy tắc lấy từ tài liệu chính thức, nhưng broker trong lab là mô phỏng. Client pika và phần giết tiến trình là thật. Anh em nên chạy lại trên broker của mình trước khi dựa vào.
RabbitMQ publisher confirms cho crawl và những điều cần nhớ
RabbitMQ publisher confirms cho crawl chỉ giải nửa đường từ publisher tới broker, nửa còn lại là consumer ack đặt sau khi lưu kết quả. Lab với pika cho thấy lỗi biến thành trùng, nên mã task ổn định và thao tác ghi đè là bắt buộc. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em kiểm lại RabbitMQ publisher confirms cho crawl trên broker thật.


