
Proxy Tìm Khách Hàng B2B: Thu Thập Lead Mà Không Bị Chặn
Proxy tìm khách hàng B2B là công cụ giúp đội bán hàng thu thập thông tin công ty từ danh bạ doanh nghiệp, hồ sơ công ty và website mà không bị khóa IP giữa chừng. Khi phải đọc hàng nghìn trang để lập danh sách khách tiềm năng, một IP duy nhất sẽ nhanh chóng bị giới hạn. Bài này ProxyVN hướng dẫn quy trình sáu bước, loại proxy phù hợp và giới hạn pháp lý cần nhớ. Các gói đối chiếu với trang ProxyVN.
Proxy tìm khách hàng B2B giải quyết vấn đề gì
Tìm khách hàng B2B là quá trình xác định doanh nghiệp phù hợp với sản phẩm của anh em, rồi tìm đúng người ra quyết định để tiếp cận. Phần lớn thông tin cần thiết nằm rải rác trên mạng: danh bạ doanh nghiệp, hồ sơ công ty, tin tuyển dụng, trang web của chính doanh nghiệp đó.
Multilogin trong bài thu thập dữ liệu web để tìm khách hàng giải thích rằng việc thu thập giúp doanh nghiệp lấy thông tin về ngành, đối thủ và khách hàng một cách có hệ thống thay vì sao chép thủ công.
Vì sao cần proxy
Khi một công cụ đọc liên tục hàng trăm trang từ cùng một website, máy chủ nhận ra hành vi tự động và giới hạn IP. Kết quả là công việc dừng giữa chừng, danh sách khách hàng bị thiếu. Proxy chia request ra nhiều IP, giữ nhịp truy cập giống người dùng thật.
- Tránh bị giới hạn tốc độ: mỗi IP chỉ gửi một phần request.
- Lấy dữ liệu đúng vùng: một số danh bạ hiển thị kết quả khác nhau theo quốc gia người xem.
- Tách biệt với IP công ty: IP văn phòng không bị đánh dấu khi chạy công cụ.
Proxy không thay cho chiến lược
Proxy chỉ giải quyết phần kỹ thuật. Nếu chọn sai nguồn dữ liệu hoặc không có tiêu chí khách hàng rõ ràng, danh sách thu được vẫn kém chất lượng. Multilogin lưu ý một sai lầm phổ biến là thu thập từ website kém chất lượng, dẫn tới khách hàng tiềm năng không đạt.
Một danh sách 500 công ty đúng tiêu chí có giá trị hơn 10.000 dòng thu thập vội vàng không ai kiểm tra.
Quy trình sáu bước dùng proxy tìm khách hàng B2B
Multilogin chia việc thu thập để tìm khách hàng thành sáu bước: đặt mục tiêu, chọn công cụ, xác định website nguồn, thu thập, tổ chức và phân tích dữ liệu, rồi đo kết quả. ProxyVN giữ khung này và bổ sung phần proxy ở từng bước.
Làm đúng thứ tự giúp tránh tình trạng thu thập xong mới phát hiện thiếu trường dữ liệu quan trọng.
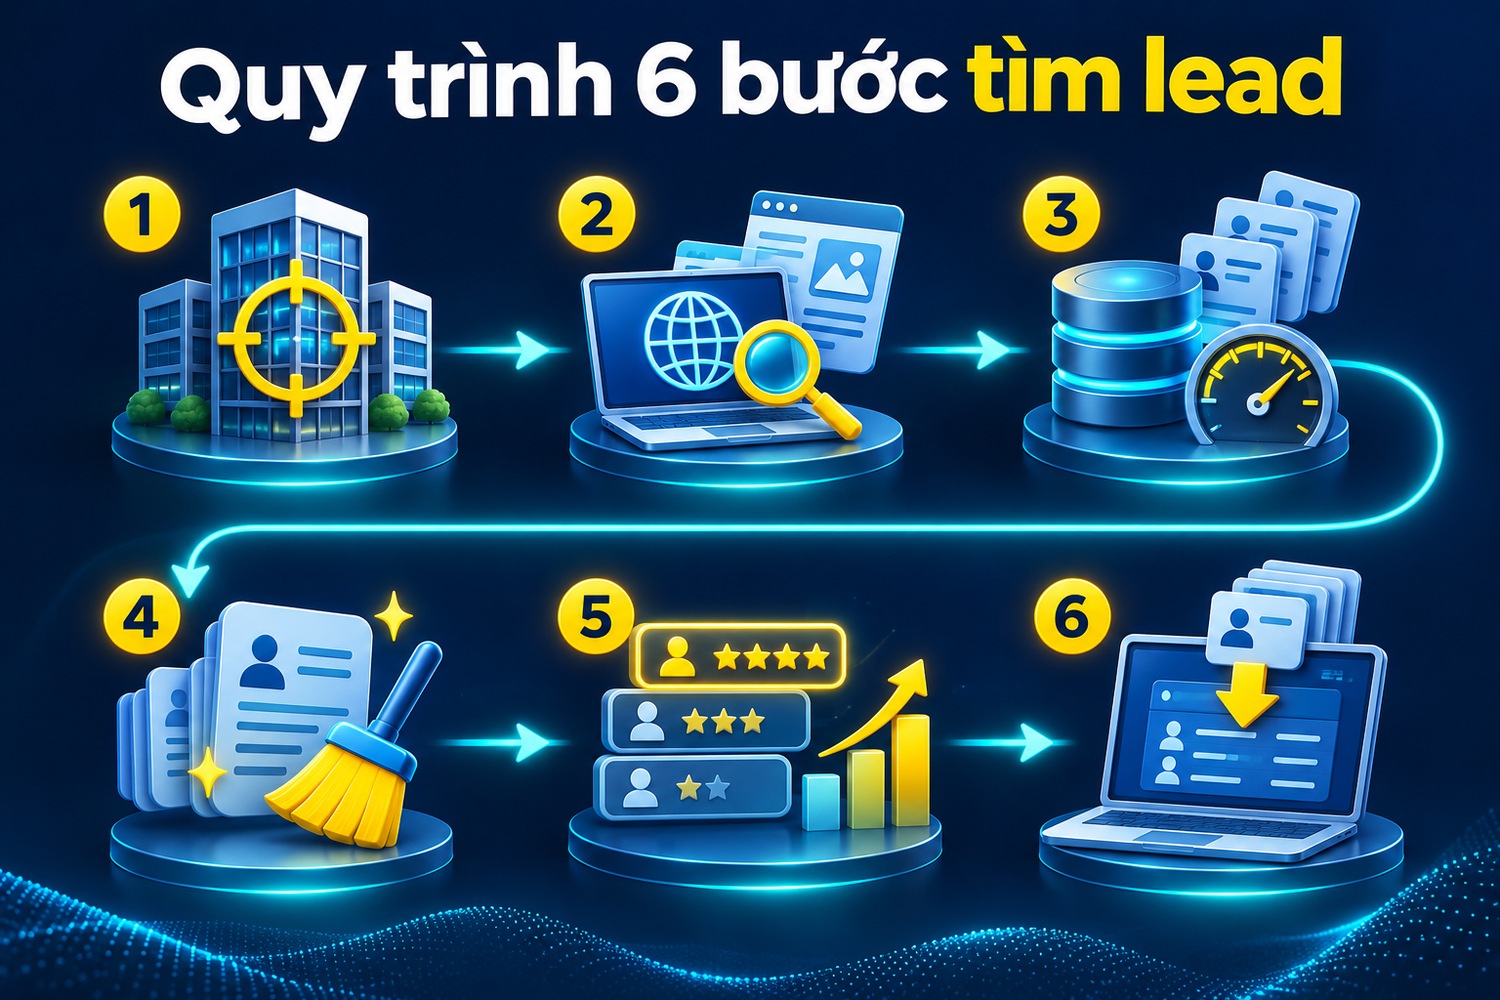
Quy trình 6 bước tìm lead
Bước 1: đặt mục tiêu và chân dung khách hàng
Trước tiên phải trả lời khách hàng lý tưởng là ai. Ngành nào, quy mô bao nhiêu nhân viên, ở khu vực nào, đang dùng công nghệ gì. Multilogin nhấn mạnh phải xác định rõ loại dữ liệu cần thu thập trước khi bắt đầu.
Với B2B, các trường dữ liệu cấp công ty thường quan trọng hơn thông tin cá nhân: tên công ty, ngành, quy mô, địa chỉ, website, tin tuyển dụng gần đây, vòng gọi vốn.
Bước 2: chọn công cụ
Multilogin giới thiệu bốn công cụ phổ biến. Beautiful Soup là thư viện Python để đọc HTML, Scrapy là khung thu thập chuyên dụng, Octoparse và ParseHub là công cụ không cần lập trình có giao diện trực quan. Ngoài ra còn tiện ích trình duyệt như Web Scraper và Data Miner.
Anh em biết lập trình nên chọn Scrapy hoặc Beautiful Soup vì dễ gắn proxy và kiểm soát nhịp truy cập. Anh em không lập trình có thể dùng Octoparse, phần lớn công cụ loại này đều có ô nhập proxy.
Bước 3: xác định website nguồn
Chọn nguồn uy tín, dữ liệu cập nhật và cho phép truy cập. Multilogin khuyên kiểm tra điều khoản dịch vụ của website trước khi thu thập. Phần sau của bài đi sâu vào các nhóm nguồn phổ biến.
Bước 4: thu thập qua proxy
Đây là bước proxy phát huy tác dụng. Công cụ gửi request qua proxy, xoay IP theo nhịp hợp lý, xử lý lỗi và lưu kết quả. Phần code ví dụ ở dưới minh họa cách làm.
Bước 5: tổ chức và phân tích
Loại bỏ dòng trùng, chuẩn hóa định dạng, lưu vào bảng tính hoặc cơ sở dữ liệu. Multilogin gợi ý dùng CSV, Excel hoặc cơ sở dữ liệu. Sau đó chấm điểm từng công ty theo mức độ khớp với chân dung khách hàng.
Bước 6: đo kết quả
Theo dõi tỷ lệ phản hồi khi tiếp cận, tỷ lệ chuyển đổi thành cuộc họp và hợp đồng. Dựa vào kết quả để điều chỉnh nguồn dữ liệu và tiêu chí chấm điểm cho đợt sau.
Nguồn dữ liệu khi dùng proxy tìm khách hàng B2B
Chất lượng danh sách khách hàng phụ thuộc trước hết vào nguồn. Mỗi nhóm nguồn có loại dữ liệu, mức độ bảo vệ và yêu cầu proxy khác nhau. Hiểu rõ giúp chọn đúng loại proxy và đúng cách thu thập.
Phần này chia nguồn thành bốn nhóm theo mức độ phổ biến với đội bán hàng Việt Nam.
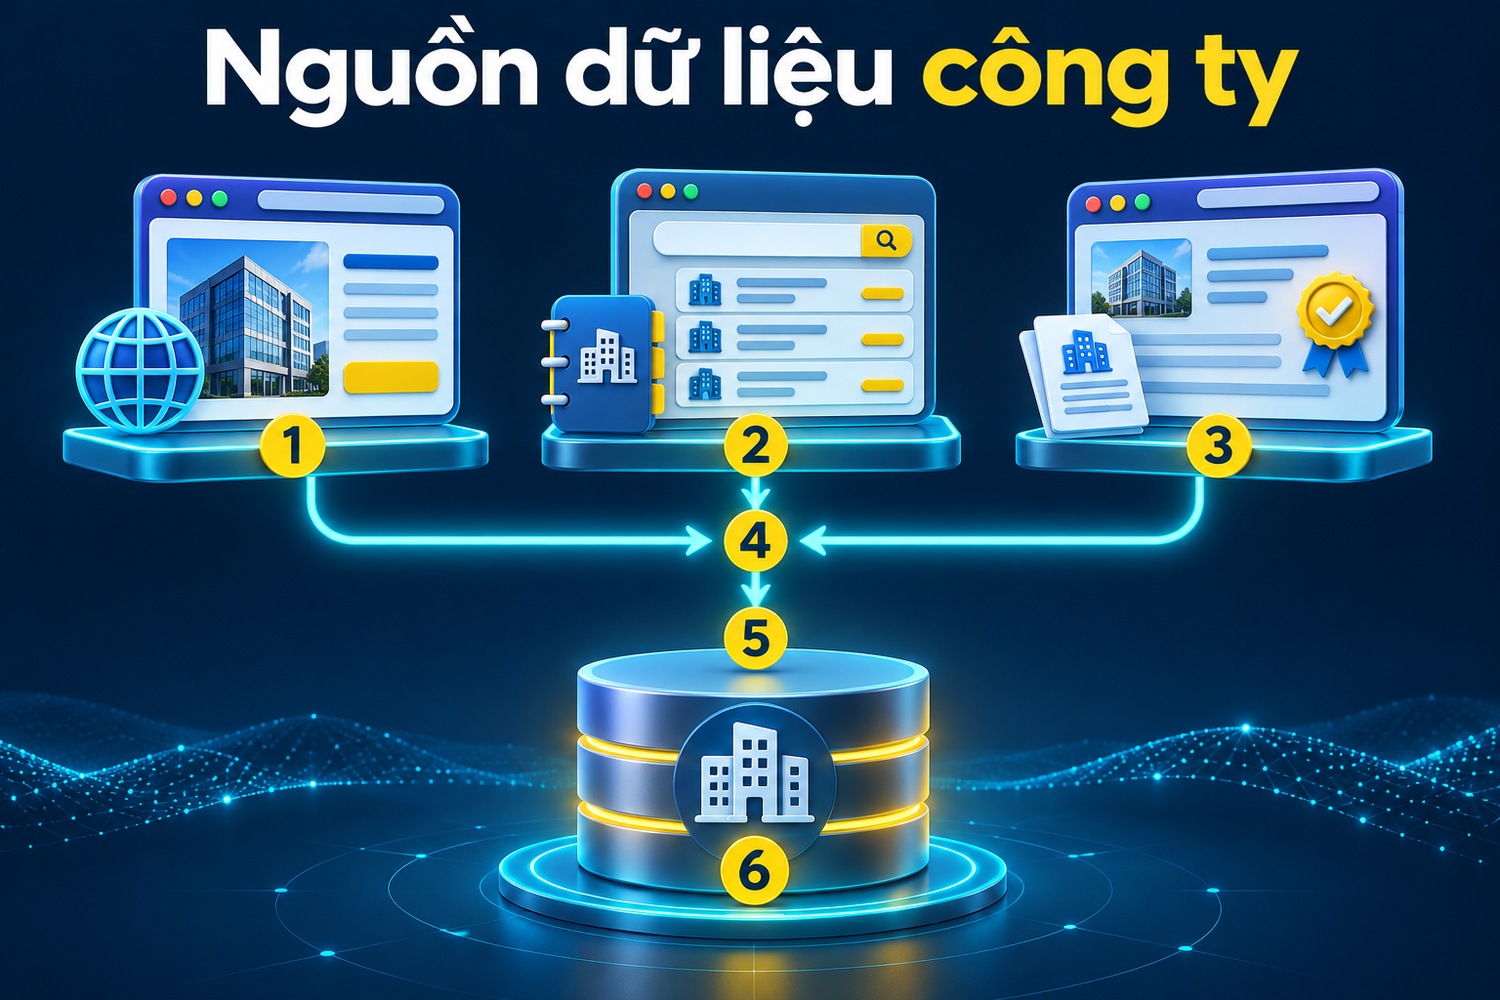
Nguồn dữ liệu công ty
Danh bạ và cơ sở dữ liệu doanh nghiệp
Danh bạ doanh nghiệp, trang tra cứu thông tin công ty, danh sách thành viên hiệp hội ngành là nguồn cơ bản. Dữ liệu thường gồm tên công ty, ngành nghề, địa chỉ, website. Các trang này ít khi có bộ lọc chống bot mạnh, proxy datacenter thường đủ dùng nếu giữ nhịp truy cập chậm.
Hồ sơ công ty và dữ liệu gọi vốn
Crunchbase là nguồn nổi tiếng về hồ sơ công ty, vòng gọi vốn và nhà đầu tư. Decodo trong trang công cụ thu thập Crunchbase liệt kê các loại dữ liệu có trên hồ sơ: tên và mô tả công ty, ngày thành lập, lịch sử gọi vốn, nhà đầu tư, số nhân viên và xu hướng tăng trưởng, ngành, website, thương vụ mua lại.
Decodo cũng cho biết Crunchbase đã ngừng gói API miễn phí, API chính thức nay chỉ dành cho hợp đồng doanh nghiệp. Họ lưu ý điều khoản của Crunchbase hạn chế thu thập tự động và người dùng phải tự đảm bảo tuân thủ. Nếu ngân sách cho phép, dùng API chính thức luôn là lựa chọn an toàn nhất.
Website của chính doanh nghiệp
Trang "Giới thiệu", "Liên hệ", "Tuyển dụng" trên website doanh nghiệp chứa nhiều tín hiệu giá trị. Tin tuyển dụng cho thấy công ty đang mở rộng mảng nào. Trang sản phẩm cho thấy công nghệ đang dùng. Các website này thường ít bảo vệ, nhưng số lượng rất lớn nên cần tool và proxy để xử lý hàng loạt.
Mạng nghề nghiệp
LinkedIn là kênh tìm khách hàng B2B lớn nhất. Multilogin có bài hướng dẫn tìm khách hàng trên LinkedIn giải thích khác biệt giữa B2B và B2C trên nền tảng này. LinkedIn có bộ lọc chặt và điều khoản rõ ràng về tự động hóa. ProxyVN đã có bài mua proxy LinkedIn và LinkedIn Sales Navigator chuyên sâu, nên bài này không đi lại phần đó.
Chọn loại proxy tìm khách hàng B2B
Mỗi nguồn dữ liệu cần một loại proxy khác nhau. Chọn loại mạnh nhất cho mọi nguồn sẽ tốn kém không cần thiết. Chọn loại yếu nhất cho nguồn khắt khe sẽ bị chặn liên tục. Bảng dưới gợi ý cách ghép.
Nguyên tắc chung là bắt đầu với loại rẻ, chỉ nâng cấp khi tỷ lệ bị chặn cao.
Bảng ghép nguồn với loại proxy
Nguồn dữ liệu |
Mức bảo vệ |
Loại proxy gợi ý |
Gói ProxyVN |
|---|---|---|---|
Danh bạ doanh nghiệp |
Thấp đến vừa |
Datacenter |
Datacenter Việt Nam Share1 hoặc Share3 |
Website doanh nghiệp |
Thấp |
Datacenter |
Datacenter Việt Nam |
Hồ sơ công ty quốc tế |
Cao |
Dân cư xoay |
Proxy xoay theo key |
Nguồn chỉ mở cho Mỹ |
Vừa |
Datacenter Mỹ |
Datacenter US San Jose |
Tài khoản mạng nghề nghiệp |
Rất cao |
Dân cư tĩnh |
Dân cư tĩnh private |
Proxy xoay cho thu thập số lượng lớn
Với nguồn có bộ lọc, proxy xoay giúp mỗi request đi qua một IP khác. ProxyVN bán proxy xoay theo key, mua theo ngày, tuần hoặc tháng. Theo tài liệu API, khi lấy IP có thể chọn nhà mạng và tỉnh thành.
Proxy tĩnh cho tài khoản
Nếu quy trình có bước đăng nhập, ví dụ dùng tài khoản trên nền tảng nghề nghiệp, hãy dùng IP tĩnh dân cư. Đổi IP liên tục khi đã đăng nhập là cách nhanh nhất để tài khoản bị yêu cầu xác minh.
Code mẫu dùng proxy tìm khách hàng B2B
Phần này dành cho anh em biết lập trình. Hai đoạn code dưới đây là ví dụ triển khai chung, minh họa cách gắn proxy vào Beautiful Soup và Scrapy, hai công cụ được Multilogin giới thiệu. URL và bộ chọn HTML là giả định, anh em thay bằng nguồn thật.
Cả hai ví dụ đều giữ nhịp truy cập chậm và chỉ lấy dữ liệu cấp công ty.
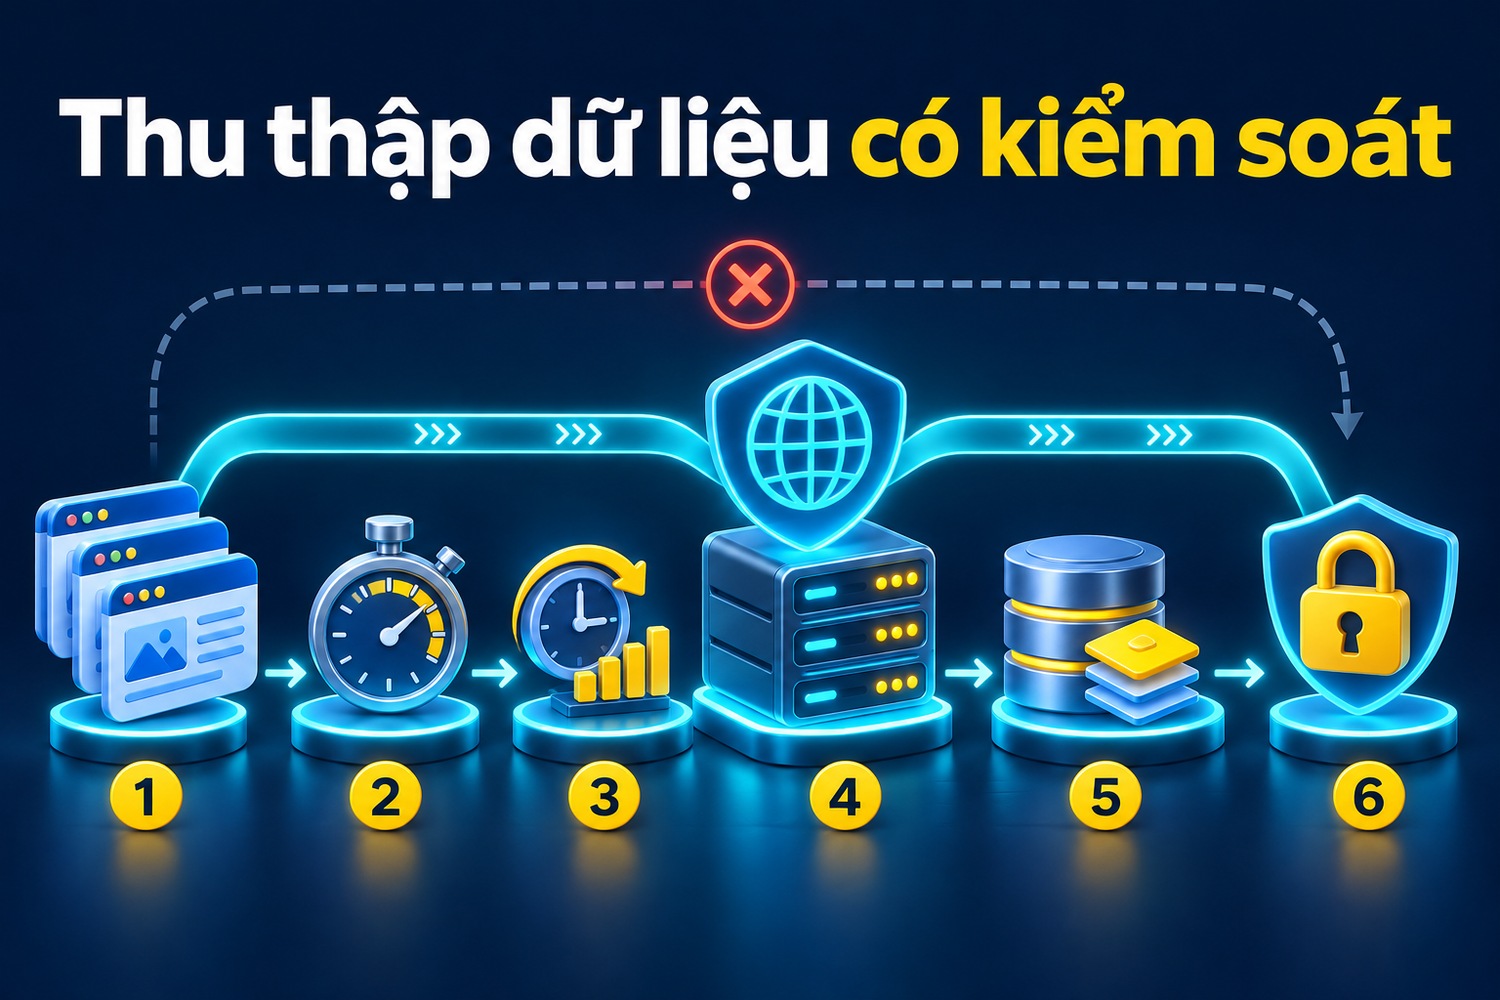
Thu thập không bị chặn
Beautiful Soup với danh sách proxy xoay vòng
import csv
import itertools
import time
import requests
from bs4 import BeautifulSoup

PROXIES = itertools.cycle([
    "http://USER:PASS@IP1:PORT",
    "http://USER:PASS@IP2:PORT",
])
HEADERS = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}

rows = []
for page in range(1, 11):
    p = next(PROXIES)
    url = f"https://example-directory.com/nganh/phan-mem?page={page}"
    r = requests.get(url, headers=HEADERS, proxies={"http": p, "https": p}, timeout=20)
    if r.status_code != 200:
        print("Trang", page, "loi", r.status_code)
        continue
    soup = BeautifulSoup(r.text, "html.parser")
    for card in soup.select("div.company"):
        rows.append({
            "ten": card.select_one("h3").get_text(strip=True),
            "website": card.select_one("a.web")["href"],
            "tinh_thanh": card.select_one("span.city").get_text(strip=True),
        })
    time.sleep(4)

with open("danh_sach_cong_ty.csv", "w", newline="", encoding="utf-8") as f:
    w = csv.DictWriter(f, fieldnames=["ten", "website", "tinh_thanh"])
    w.writeheader()
    w.writerows(rows)
Mỗi trang đi qua một IP trong danh sách, nghỉ bốn giây giữa các trang. Dữ liệu lấy về chỉ gồm tên, website và tỉnh thành của công ty.
Scrapy với proxy qua middleware
Scrapy hỗ trợ proxy qua khóa `proxy` trong `meta` của từng request. Đoạn dưới là spider tối giản, kèm các cài đặt giới hạn tốc độ có sẵn của Scrapy.
import random
import scrapy

PROXIES = ["http://USER:PASS@IP1:PORT", "http://USER:PASS@IP2:PORT"]

class CongTySpider(scrapy.Spider):
    name = "cong_ty"
    start_urls = ["https://example-directory.com/nganh/phan-mem?page=1"]
    custom_settings = {
        "DOWNLOAD_DELAY": 3,
        "CONCURRENT_REQUESTS_PER_DOMAIN": 2,
        "AUTOTHROTTLE_ENABLED": True,
        "ROBOTSTXT_OBEY": True,
    }

    def start_requests(self):
        for url in self.start_urls:
            yield scrapy.Request(url, meta={"proxy": random.choice(PROXIES)})

    def parse(self, response):
        for card in response.css("div.company"):
            yield {
                "ten": card.css("h3::text").get(default="").strip(),
                "website": card.css("a.web::attr(href)").get(),
            }
        next_page = response.css("a.next::attr(href)").get()
        if next_page:
            yield response.follow(next_page, meta={"proxy": random.choice(PROXIES)})
Các cài đặt `DOWNLOAD_DELAY`, `CONCURRENT_REQUESTS_PER_DOMAIN`, `AUTOTHROTTLE_ENABLED` và `ROBOTSTXT_OBEY` giúp spider tôn trọng website nguồn. ProxyVN có bài riêng về proxy Scrapy và proxy cho Beautiful Soup nếu anh em cần cấu hình sâu hơn.
Làm sạch và chấm điểm sau khi dùng proxy tìm khách hàng B2B
Dữ liệu thu thập được luôn có dòng trùng, dòng thiếu và dòng không khớp tiêu chí. Multilogin nhấn mạnh phải loại trùng, đưa về định dạng có cấu trúc và kiểm tra độ chính xác định kỳ. Bước này quyết định danh sách có dùng được hay không.
Một danh sách sạch giúp đội bán hàng tập trung vào đúng khách hàng thay vì mất thời gian lọc thủ công.
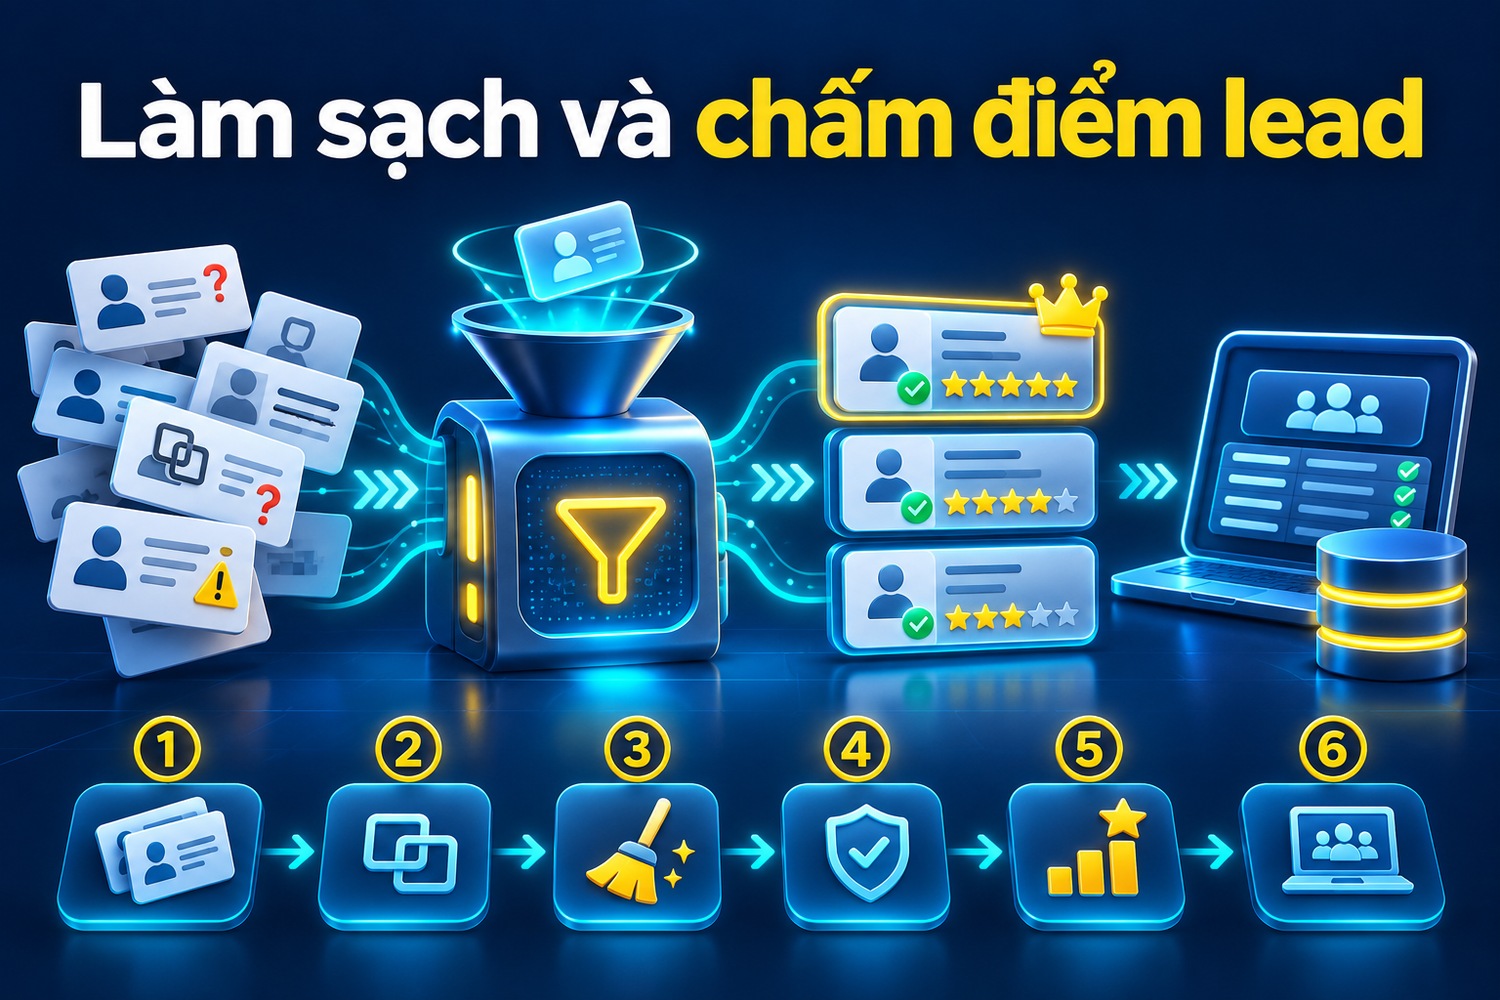
Làm sạch và chấm điểm lead
Loại trùng theo tên miền
Cùng một công ty có thể xuất hiện ở nhiều nguồn với tên viết khác nhau. Tên miền website là khóa loại trùng đáng tin cậy hơn tên công ty. Đoạn Python dưới đây là ví dụ chuẩn hóa tên miền rồi loại trùng.
import csv
from urllib.parse import urlparse

def ten_mien(url):
    host = urlparse(url if "://" in url else "http://" + url).netloc.lower()
    return host[4:] if host.startswith("www.") else host

seen, sach = set(), []
with open("danh_sach_cong_ty.csv", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        d = ten_mien(row["website"])
        if d and d not in seen:
            seen.add(d)
            sach.append(row)
print("Con lai", len(sach), "cong ty sau khi loai trung")
Chấm điểm theo chân dung khách hàng
Tiêu chí |
Cách chấm |
Ví dụ điểm |
|---|---|---|
Đúng ngành |
Khớp danh sách ngành mục tiêu |
3 điểm |
Quy mô phù hợp |
Số nhân viên trong khoảng mục tiêu |
2 điểm |
Đúng khu vực |
Tỉnh thành hoặc quốc gia mục tiêu |
2 điểm |
Tín hiệu mua |
Đang tuyển vị trí liên quan, vừa gọi vốn |
3 điểm |
Công ty đạt từ bảy điểm trở lên được ưu tiên tiếp cận trước. Công ty dưới bốn điểm có thể tạm gác. Thang điểm này chỉ là ví dụ, mỗi đội nên điều chỉnh theo kinh nghiệm bán hàng thực tế.
Làm giàu dữ liệu từ website công ty
Sau khi có danh sách sạch, có thể dùng proxy để đọc trang tuyển dụng hoặc trang sản phẩm của từng công ty, tìm thêm tín hiệu mua. Đây là bước tốn nhiều request nhất, nên dùng datacenter giá rẻ vì website doanh nghiệp thường ít bảo vệ.
Giới hạn pháp lý khi dùng proxy tìm khách hàng B2B
Tìm khách hàng B2B có một ranh giới quan trọng: dữ liệu của doanh nghiệp khác với dữ liệu của cá nhân. Tên công ty, ngành, quy mô, website là thông tin doanh nghiệp. Họ tên, số điện thoại, email cá nhân của nhân viên là dữ liệu cá nhân, chịu sự điều chỉnh của pháp luật về bảo vệ dữ liệu cá nhân.
Multilogin nhắc phải để ý bảo vệ dữ liệu và cẩn trọng khi xử lý thông tin cá nhân.
Ưu tiên dữ liệu cấp công ty
Luật Bảo vệ dữ liệu cá nhân 2025 có hiệu lực từ 01/01/2026 xác lập quyền được biết và quyền đồng ý của chủ thể dữ liệu, đồng thời nghiêm cấm mua bán dữ liệu cá nhân. Với đội bán hàng, cách an toàn là thu thập thông tin công ty, rồi tiếp cận qua kênh công khai của chính công ty như email liên hệ chung hay biểu mẫu trên website.
Tôn trọng điều khoản của nguồn
Nhiều nguồn như Crunchbase hạn chế thu thập tự động trong điều khoản. Vi phạm có thể dẫn tới bị chặn truy cập hoặc tranh chấp. Đọc điều khoản trước và ưu tiên API chính thức khi có.
Không dùng proxy để gửi thư rác
Điều khoản của ProxyVN nghiêm cấm spam email, spam SMS và phát tán quảng cáo trái phép. Danh sách khách hàng chỉ nên dùng để tiếp cận có chọn lọc, cá nhân hóa, không gửi hàng loạt thư giống hệt nhau.
Sai lầm hay gặp khi dùng proxy tìm khách hàng B2B
Ngoài các giới hạn pháp lý, còn nhiều lỗi kỹ thuật và quy trình khiến danh sách khách hàng kém hiệu quả. Multilogin liệt kê một số lỗi phổ biến. ProxyVN bổ sung những lỗi liên quan tới proxy mà anh em hay gặp.
Phần lớn các lỗi này sửa được bằng một thay đổi nhỏ trong quy trình.
Thu thập quá nhanh
Đặt độ trễ quá thấp, chạy quá nhiều luồng khiến IP bị chặn nhanh, kể cả khi dùng nhiều proxy. Hãy bắt đầu chậm, theo dõi tỷ lệ lỗi rồi mới tăng dần.
Không kiểm tra độ chính xác
Multilogin nhấn mạnh không kiểm tra độ chính xác dẫn tới thông tin sai. Danh bạ doanh nghiệp có thể chứa công ty đã ngừng hoạt động hoặc đổi tên. Kiểm tra ngẫu nhiên một phần danh sách trước khi đưa cho đội bán hàng.
Dùng chung IP cho thu thập và tài khoản
Nếu cùng một IP vừa chạy công cụ thu thập vừa đăng nhập tài khoản mạng nghề nghiệp, hành vi thu thập có thể làm IP bị đánh dấu và kéo theo tài khoản. Tách hai việc ra hai nhóm IP khác nhau.
Bỏ qua bước đo kết quả
Không theo dõi tỷ lệ phản hồi thì không biết nguồn nào tốt, nguồn nào kém. Sau mỗi đợt tiếp cận, ghi lại kết quả theo từng nguồn để lần sau tập trung vào nguồn hiệu quả.
Khi đã xác định nguồn và quy mô, anh em có thể mua proxy tại ProxyVN: datacenter cho danh bạ và website doanh nghiệp, proxy xoay cho nguồn khắt khe, dân cư tĩnh cho tài khoản.
Kết hợp trình duyệt antidetect với proxy tìm khách hàng B2B
Thu thập dữ liệu công ty chỉ là nửa đầu. Nửa sau là tiếp cận, thường qua nhiều tài khoản của các nhân viên bán hàng trên mạng nghề nghiệp và công cụ email. Ở bước này, IP không còn là yếu tố duy nhất nền tảng dùng để nhận diện. Dấu vân tay trình duyệt cũng quan trọng không kém.
Multilogin trong bài trình duyệt antidetect cho tìm khách hàng B2B giải thích rằng ngay cả khi đội bán hàng xoay IP, dùng nhiều tên miền email và giãn khoảng cách tin nhắn, nền tảng vẫn có thể nhận diện qua môi trường trình duyệt như độ phân giải màn hình, hệ điều hành và dấu vân tay canvas.
Số liệu Multilogin đưa ra
Multilogin nêu một số con số để minh họa rủi ro. Theo họ, hơn 45% tài khoản tiếp cận trên LinkedIn bị hạn chế ở mức nào đó trong 14 ngày đầu nếu không có lớp bảo vệ trình duyệt. Họ cũng cho rằng các công cụ tự động hóa mạnh tay bị chặn dựa trên dấu vân tay trình duyệt nhiều gấp ba lần so với chỉ dựa trên IP. Đây là số liệu do một nhà cung cấp trình duyệt antidetect công bố, anh em nên đọc như một tín hiệu tham khảo.
Mỗi nhân viên một môi trường riêng
Cách làm phổ biến là mỗi nhân viên bán hàng có một profile trình duyệt riêng, gắn một IP dân cư tĩnh riêng. Profile lưu cookie, phiên đăng nhập và dấu vân tay ổn định qua nhiều ngày. Khi nhân viên nghỉ, profile được chuyển giao mà không làm tài khoản bị đăng nhập từ môi trường lạ.
- IP: dân cư tĩnh, đúng quốc gia của tài khoản.
- Múi giờ và ngôn ngữ: khớp vị trí IP.
- Profile: lưu lâu dài, không tạo mới mỗi ngày.
ProxyVN có nhiều bài hướng dẫn gắn proxy vào từng trình duyệt antidetect, ví dụ proxy AdsPower, proxy GoLogin và proxy Multilogin.
Tách bạch hai nhóm IP
Nhóm IP dùng cho công cụ thu thập và nhóm IP dùng cho tài khoản tiếp cận phải tách riêng. Nhóm thu thập dùng datacenter hoặc proxy xoay, chấp nhận bị chặn và thay thế thường xuyên. Nhóm tài khoản dùng dân cư tĩnh, giữ ổn định lâu dài. Trộn hai nhóm là cách nhanh nhất để mất tài khoản bán hàng.
Đo hiệu quả khi dùng proxy tìm khách hàng B2B
Không đo thì không biết proxy và quy trình có đáng tiền hay không. Có hai lớp chỉ số cần theo dõi: chỉ số kỹ thuật của việc thu thập và chỉ số kinh doanh của việc tiếp cận. Lớp đầu giúp tối ưu chi phí proxy, lớp sau giúp tối ưu nguồn dữ liệu.
Multilogin nhắc rằng phải theo dõi hiệu quả và điều chỉnh quy trình dựa trên kết quả.
Chỉ số kỹ thuật
Chỉ số |
Cách đo |
Ý nghĩa |
|---|---|---|
Tỷ lệ trang tải thành công |
Số trang mã 200 trên tổng số trang |
Proxy và nhịp truy cập có ổn không |
Tỷ lệ 403 và 429 |
Đếm mã bị chặn và giới hạn |
Cần đổi loại proxy hoặc giảm tốc |
Chi phí proxy trên mỗi công ty |
Tổng chi phí chia số công ty sạch |
So sánh hiệu quả giữa các nguồn |
Tỷ lệ dòng trùng |
Dòng trùng chia tổng dòng |
Nguồn có chồng chéo nhiều không |
Chỉ số kinh doanh
Chỉ số |
Cách đo |
Ý nghĩa |
|---|---|---|
Tỷ lệ phản hồi |
Số công ty trả lời trên số đã tiếp cận |
Chất lượng danh sách và nội dung tiếp cận |
Tỷ lệ cuộc họp |
Số cuộc họp trên số phản hồi |
Mức khớp với chân dung khách hàng |
Tỷ lệ chốt |
Số hợp đồng trên số cuộc họp |
Giá trị cuối cùng của nguồn |
Khi một nguồn có chi phí proxy trên mỗi công ty cao nhưng tỷ lệ chốt thấp, đó là nguồn nên cắt. Ngược lại, nguồn đắt mà chốt tốt vẫn đáng giữ.
Câu hỏi thường gặp về proxy tìm khách hàng B2B
Phần cuối trả lời nhanh những thắc mắc của đội bán hàng khi lần đầu dùng proxy cho việc tìm khách hàng.
Không biết lập trình có dùng được không?
Được. Các công cụ không cần lập trình như Octoparse, ParseHub hay tiện ích trình duyệt đều có ô nhập proxy. ProxyVN có bài proxy Octoparse hướng dẫn chi tiết. Anh em chỉ cần dán thông tin proxy dạng IP, cổng, user, password vào đúng ô.
Cần bao nhiêu proxy cho một đợt thu thập?
Tùy số trang và mức bảo vệ của nguồn. Với danh bạ ít bảo vệ, vài IP datacenter chạy chậm đã đủ cho vài nghìn trang mỗi ngày. Với nguồn khắt khe, proxy xoay theo key cho phép đổi IP liên tục mà không phải mua nhiều IP tĩnh.
Có nên mua danh sách khách hàng có sẵn thay vì tự thu thập?
Danh sách mua sẵn tiết kiệm thời gian nhưng thường cũ và không rõ nguồn gốc. Nếu danh sách chứa dữ liệu cá nhân được mua bán, việc sử dụng có thể vi phạm quy định về bảo vệ dữ liệu cá nhân. Tự thu thập dữ liệu cấp công ty từ nguồn công khai minh bạch hơn.
Kết luận
Proxy tìm khách hàng B2B giúp đội bán hàng thu thập thông tin công ty ổn định, đúng vùng và không bị gián đoạn. Hãy bắt đầu từ chân dung khách hàng, chọn nguồn uy tín, ghép đúng loại proxy, thu thập chậm, làm sạch kỹ và ưu tiên dữ liệu cấp công ty. Cần tư vấn chọn gói, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam để triển khai proxy tìm khách hàng B2B hiệu quả.


