
OpenSearch bulk index dữ liệu web: đọc lỗi từng item, retry đúng
OpenSearch bulk index dữ liệu web là cách nạp hàng loạt tài liệu crawl trong một request bằng Bulk API. Cái bẫy nằm ở chỗ request trả 200 nhưng vài item bên trong vẫn hỏng. ProxyVN chạy client opensearch-py thật trên máy chủ mô phỏng phần Bulk API, gửi một lô có item sai mapping, đọc lỗi từng item rồi retry đúng item đó, và ghi rõ phần chưa chạy trên OpenSearch thật.
OpenSearch bulk index dữ liệu web: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và giới hạn.
Bài toán cần giải
Một pipeline crawl đẩy mỗi lô vài nghìn tài liệu vào OpenSearch. Log báo 200 đều đều, nhưng số tài liệu trong index luôn ít hơn số đã gửi. Lý do: mã chỉ kiểm tra mã trạng thái của cả request. Một trang có giá dạng chữ thì rơi mất, không ai hay.
Đầu ra nghiệm thu
Đầu ra là tệp NDJSON có một item lỗi mapping, phản hồi cho thấy item nào hỏng, và một request thứ hai chỉ gửi lại đúng item đó. Cuối cùng là đối soát số tài liệu theo source ID, không theo tổng đếm.
Ranh giới với bài khác
Bài parser validation nói về kiểm tra dữ liệu trước khi lưu. Bài Meilisearch nói về hàng đợi task bất đồng bộ. Bài này nói về phản hồi đồng bộ theo từng item của Bulk API. Bài không đi vào thiết kế mapping, tìm kiếm hay vận hành cụm.
Giới hạn của lab
Nói rõ ngay. Lab không chạy máy chủ OpenSearch. Máy lab không tải được phần mềm máy chủ, nên ProxyVN viết một máy chủ Python chỉ có vài endpoint: tạo index, _bulk, _count, lấy tài liệu theo ID. Nó kiểm tra kiểu số cho các trường float, và không có shard, không có refresh, không có phân tích văn bản.
Thứ gì thật, thứ gì giả
Client opensearch-py 3.2.0 là thật, kể cả helpers.bulk và bộ phát sinh ngoại lệ. Tệp NDJSON là thật. Cấu trúc phản hồi được mô phỏng theo tài liệu, thông báo lỗi do ProxyVN đặt theo dạng quen thuộc của OpenSearch. Vì vậy đừng so từng chữ thông báo với máy chủ thật.
Đọc kết quả thế nào
Lab chứng minh mã của anh em xử lý đúng phản hồi một phần thành công. Nó không chứng minh hiệu năng, độ trễ refresh, hay cách OpenSearch thật ép kiểu. Một ví dụ cụ thể: máy chủ thật có thể ép chuỗi số thành float, trong lab chỉ chuỗi không phải số mới lỗi. Mapping thật anh em phải thử trên cụm của mình.
Ai nên đọc bài này
Người nạp dữ liệu crawl vào OpenSearch hoặc hệ tương tự. Người thấy số tài liệu lệch mà log không có lỗi. Người đang dùng client helper và chưa biết nó xử lý lỗi thế nào.
Nạp dữ liệu crawl bằng Bulk API và xử lý lỗi từng item với OpenSearch bulk index dữ liệu web
Phần này tóm tắt tài liệu chính thức.
Bulk API làm gì
Trang Bulk API mô tả API này thực hiện nhiều thao tác index, update, delete trong một request, giảm số lượt mạng và tăng tốc độ nạp. Endpoint là POST /_bulk hoặc POST /{index}/_bulk. Tài liệu khuyến nghị dùng POST thay vì PUT.
Câu quan trọng nhất
Tài liệu ghi Bulk API xử lý các action độc lập với nhau. Một action lỗi thì OpenSearch tiếp tục các action sau, và phản hồi cho biết từng action thành công hay thất bại. Mã 200 chỉ nói request đã được xử lý, không nói mọi tài liệu đã vào.
Định dạng NDJSON
Thân request là JSON tách dòng. Mỗi action một dòng, nếu action cần dữ liệu thì dòng kế tiếp là tài liệu. Với curl, tài liệu dặn dùng --data-binary, vì cờ -d làm mất ký tự xuống dòng và phá định dạng.
curl -H "Content-Type: application/x-ndjson" -X POST "localhost:9200/_bulk?pretty" --data-binary "@bulk-operations.ndjson"Dòng trên lấy từ tài liệu. Đích localhost:9200 là cổng mặc định của OpenSearch.
Bốn loại action
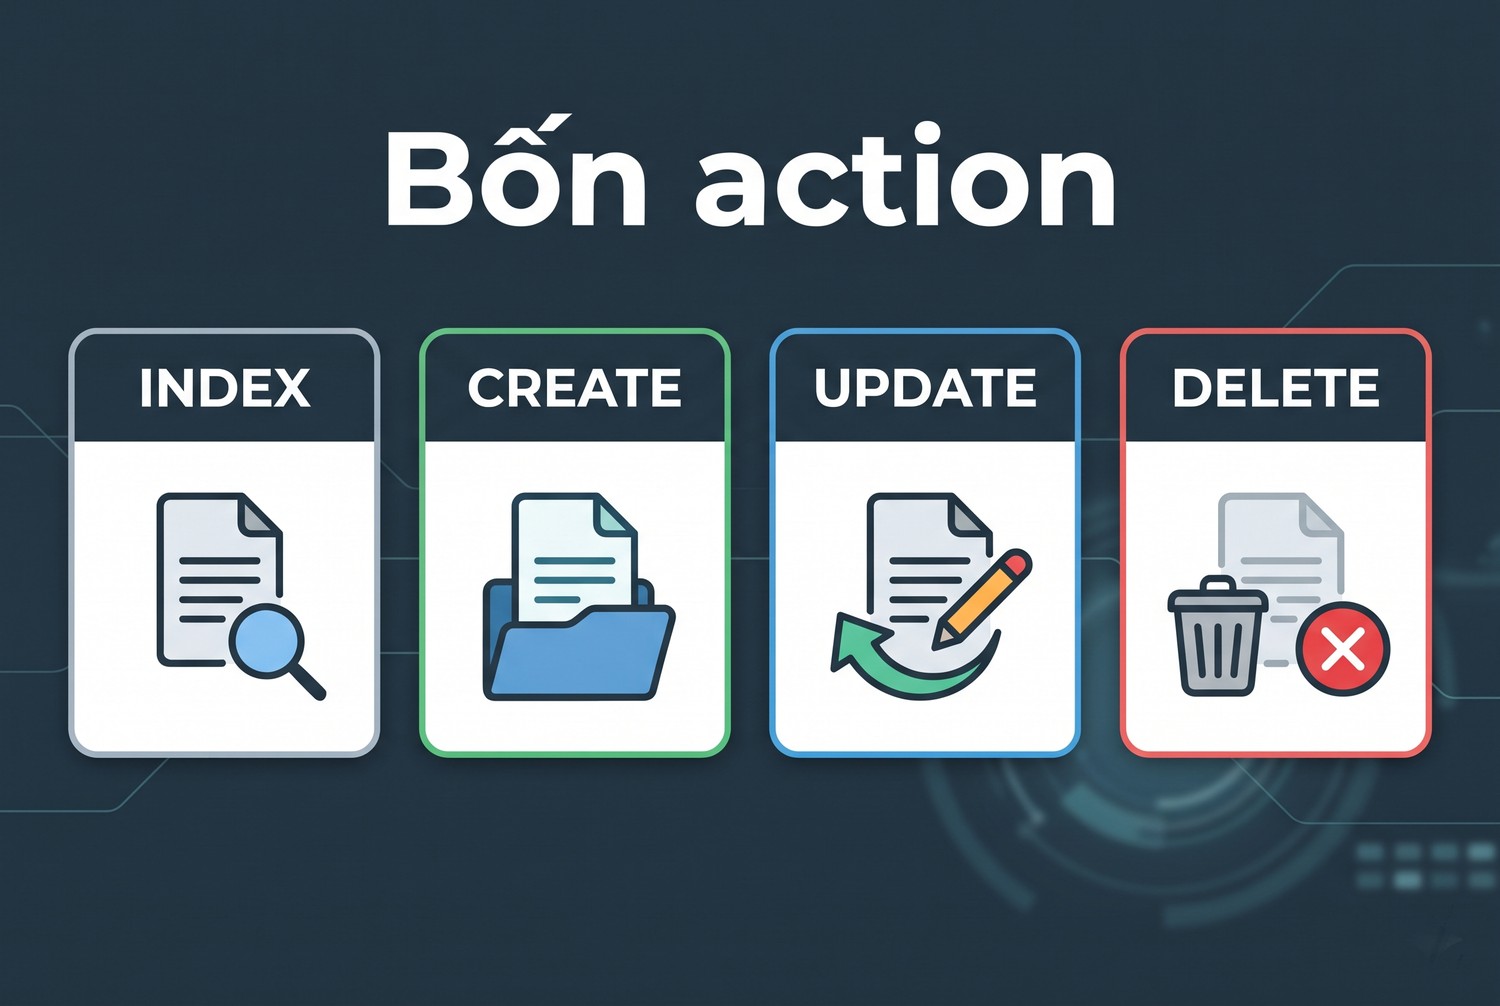
Bốn action
Tài liệu nêu bốn action, khác nhau ở cách xử lý tài liệu đã tồn tại. Với crawl, index là lựa chọn mặc định vì nó ghi đè theo ID.
Action |
Khi ID đã có |
Khi ID chưa có |
Cần dòng dữ liệu |
|---|---|---|---|
index |
Ghi đè |
Tạo mới |
Có |
create |
Báo lỗi |
Tạo mới |
Có |
update |
Cập nhật |
Báo lỗi theo mặc định |
Có |
delete |
Xóa |
Trả not_found, không lỗi |
Không |
Giới hạn của ID
Tài liệu nêu _id phải từ 512 byte trở xuống. URL dài có thể vượt mức này. Vì thế dùng URL làm ID là ý hay nhưng cần cẩn thận: băm URL chuẩn hóa thành chuỗi cố định sẽ an toàn hơn, và cũng tránh ký tự lạ.
Tham số refresh
Tài liệu nêu refresh nhận true, wait_for hoặc false. Mặc định dữ liệu chưa hiện ngay với tìm kiếm. Pipeline nạp hàng loạt không nên đặt true cho từng lô vì tốn tài nguyên. Muốn kiểm tra ngay sau khi nạp, lấy tài liệu theo ID hoặc refresh một lần ở cuối. Máy chủ mô phỏng không có độ trễ này.
Tham số filter_path
Tài liệu có ví dụ filter_path=items.*.error để chỉ nhận lỗi trong phản hồi. Lô lớn có phản hồi lớn, đọc toàn bộ tốn bộ nhớ. Nhưng bỏ thông tin thành công cũng làm mất khả năng đối chiếu theo thứ tự. Lab đọc phản hồi đầy đủ, vì lô nhỏ và cần đối soát.
Kiểm soát đồng thời
Tài liệu nêu có thể truyền if_seq_no và if_primary_term trong action, sai thì nhận version_conflict_engine_exception. Crawl nhiều worker ghi cùng tài liệu thường không cần mức này, vì lần ghi sau đúng là bản mới hơn. Khi có hai nguồn cùng sửa tài liệu thì mới nên dùng.
Lời khuyên về client
Tài liệu khuyên dùng thư viện client có bulk helper, xử lý chia lô và retry. Lab dùng cả hai đường: gọi thẳng để thấy phản hồi thô, rồi dùng helpers.bulk. Cách helper báo lỗi có điểm cần biết, được nói tới ở phần sau.
Tạo NDJSON action, source với ID ổn định cho OpenSearch bulk index dữ liệu web
Phần này dựng dữ liệu đầu vào.
Mapping của index
Lab tạo index crawl với ba trường. Trường price là float, chỗ sẽ gây lỗi.
from opensearchpy import OpenSearch

c = OpenSearch(hosts=[{"host": "127.0.0.1", "port": 9472}], use_ssl=False)
c.indices.create(index="crawl", body={"mappings": {"properties": {
    "url": {"type": "keyword"},
    "price": {"type": "float"},
    "title": {"type": "text"},
}}})
Cổng 9472 là của máy chủ mô phỏng. Client 3.2.0 yêu cầu truyền index theo từ khóa, gọi theo vị trí báo TypeError. Lab đã gặp đúng lỗi này ở lần chạy đầu.
Mapping tường minh
Với dữ liệu crawl, đừng để hệ thống tự đoán kiểu. Trang đầu tiên có giá là số thì trường thành số, trang sau có chữ liên hệ sẽ hỏng. Trang đầu là chữ thì cả trường thành text, mọi phép lọc theo giá vỡ theo. Khai báo trước là cách duy nhất biết chắc kiểu của trường.
Sinh ID ổn định
ID phải suy ra từ dữ liệu. Lab dùng phần cuối URL. Crawl thật nên băm URL chuẩn hóa.
import hashlib

def doc_id(url_norm):
    return hashlib.sha256(url_norm.encode()).hexdigest()[:32]
Hàm này là ví dụ triển khai. Điều quan trọng: cùng trang cho cùng ID ở mọi lượt, mọi worker.
Tại sao không để OpenSearch tự sinh ID
Không truyền _id thì OpenSearch tự sinh. Tiện, nhưng gửi lại một lô là nhân đôi dữ liệu. Lab gửi ba tài liệu hai lần vào hai index. Index dùng ID ổn định có 3 tài liệu, index dùng uuid ngẫu nhiên có 6.
Cách đặt ID |
Sau lần 1 |
Sau lần 2 |
|---|---|---|
Theo URL |
3 |
3 |
uuid ngẫu nhiên |
3 |
6 |
ID ổn định biến retry thành thao tác an toàn. Không có nó, phần retry sau đây sẽ sinh bản trùng.
Tạo tệp NDJSON
Lô lab có sáu tài liệu, tài liệu thứ tư có giá là chữ lien he. Mỗi tài liệu tạo hai dòng, tổng 12 dòng.
def action(d):
    return {"index": {"_index": "crawl", "_id": d["url"].rsplit("/", 1)[1]}}

nd = "".join(
    json.dumps(action(d)) + "\n" + json.dumps(d, ensure_ascii=False) + "\n"
    for d in docs
)
ensure_ascii=False giữ tiếng Việt nguyên dạng. Ký tự xuống dòng sau tài liệu cuối cùng là bắt buộc.
Ký tự xuống dòng cuối cùng
Lab cắt ký tự xuống dòng cuối rồi gửi. Máy chủ mô phỏng trả 400, client ném RequestError với loại illegal_argument_exception. Quy tắc này ProxyVN đặt theo thông báo quen thuộc của OpenSearch. Đây là lỗi toàn request, khác lỗi từng item: không tài liệu nào vào, và mã sẽ báo ngay.
Trường ngày tháng
Ngày là nguồn lỗi mapping phổ biến thứ hai sau giá. Website ghi 04/11/2026, Nov 4, hoặc hôm qua. Parser nên đổi hết về ISO 8601 có múi giờ, không đổi được thì để null và giữ chuỗi gốc ở trường raw. Khai báo trường là date trong mapping, kèm định dạng cụ thể, sẽ chặn dữ liệu xấu thay vì để nó nằm im trong index.
Tài liệu quá lớn
Một số trang crawl rất dài. Nhét cả HTML vào tài liệu làm lô phình to và tìm kiếm chậm. Chỉ đưa vào index phần văn bản đã làm sạch và trường cần lọc. HTML gốc để ở kho tệp, tài liệu chỉ giữ đường dẫn. Cách này cũng làm thời gian nạp ổn định hơn, vì lô không bị một trang khổng lồ kéo dài.
Trường do người khác thêm
Khi mapping đang ở chế độ động, mỗi trường lạ trong tài liệu crawl sinh ra một trường mới trong index. Website nhét khóa ngẫu nhiên vào JSON thì số trường tăng không kiểm soát. Hãy lọc tài liệu theo danh sách trường cho phép trước khi tạo dòng NDJSON. Lab chỉ có ba trường khai báo nên không thử ca này.
Xuống dòng trong tài liệu
Dấu xuống dòng trong nội dung bài viết không phá định dạng, vì json.dumps đổi nó thành chuỗi thoát. Tự ghép chuỗi JSON bằng tay mới gây lỗi. Luôn dùng thư viện để tạo dòng, đừng format chuỗi.
Lô bao nhiêu là vừa
Tài liệu nói không có con số đúng cho mọi trường hợp, và gợi ý bắt đầu từ 1.000 tới 5.000 thao tác, rồi thử các cỡ khác trong khi theo dõi CPU, bộ nhớ và độ trễ nạp. Với trang crawl, độ dài tài liệu lệch nhau rất lớn, nên ProxyVN khuyên giới hạn thêm theo dung lượng. Lab chỉ chạy lô sáu tài liệu nên không có số đo về cỡ lô.
Không dồn cả lượt crawl vào bộ nhớ
Tài liệu khuyên không tích tất cả thao tác trong bộ nhớ trước khi gửi, mà gửi dần khi sinh ra. Hàm helpers.bulk nhận generator, nên anh em viết hàm yield từng action từ tệp kết quả. Crawler đọc tệp JSON Lines, chia lô, gửi, ghi lại vị trí đã gửi. Mất điện giữa chừng thì chạy lại từ vị trí đó, và ID ổn định lo phần trùng.
def actions(path):
    with open(path, encoding="utf-8") as f:
        for line in f:
            d = json.loads(line)
            yield {"_index": "crawl", "_id": doc_id(d["url"]), "_source": d}

ok, errs = helpers.bulk(c, actions("items.jsonl"), raise_on_error=False)
Đoạn trên là ví dụ triển khai, lab chỉ chạy helper với danh sách trong bộ nhớ.
Làm sạch tài liệu trước khi tạo dòng
Một số trường crawl dễ gây lỗi mapping: giá có chữ, ngày nhiều định dạng, số có dấu chấm ngăn cách hàng nghìn. Làm sạch ở parser giúp giảm lỗi từng item xuống mức hiếm gặp. Khi đó mỗi lỗi item còn lại đều đáng xem, không chìm trong hàng trăm lỗi quen thuộc.
Gửi bulk có một tài liệu sai mapping trong OpenSearch bulk index dữ liệu web
Phần này là ca chính của lab.
Gọi Bulk API
Client có hàm bulk, lab dùng perform_request để thấy thẳng request và phản hồi.
r = c.transport.perform_request(
    "POST", "/_bulk", body=nd,
    headers={"Content-Type": "application/x-ndjson"},
)
print(r["errors"], len(r["items"]))
print([list(i.values())[0]["status"] for i in r["items"]])
Không có ngoại lệ nào được ném ra. Đây là điểm cần nhớ: client coi 200 là thành công.
Kết quả
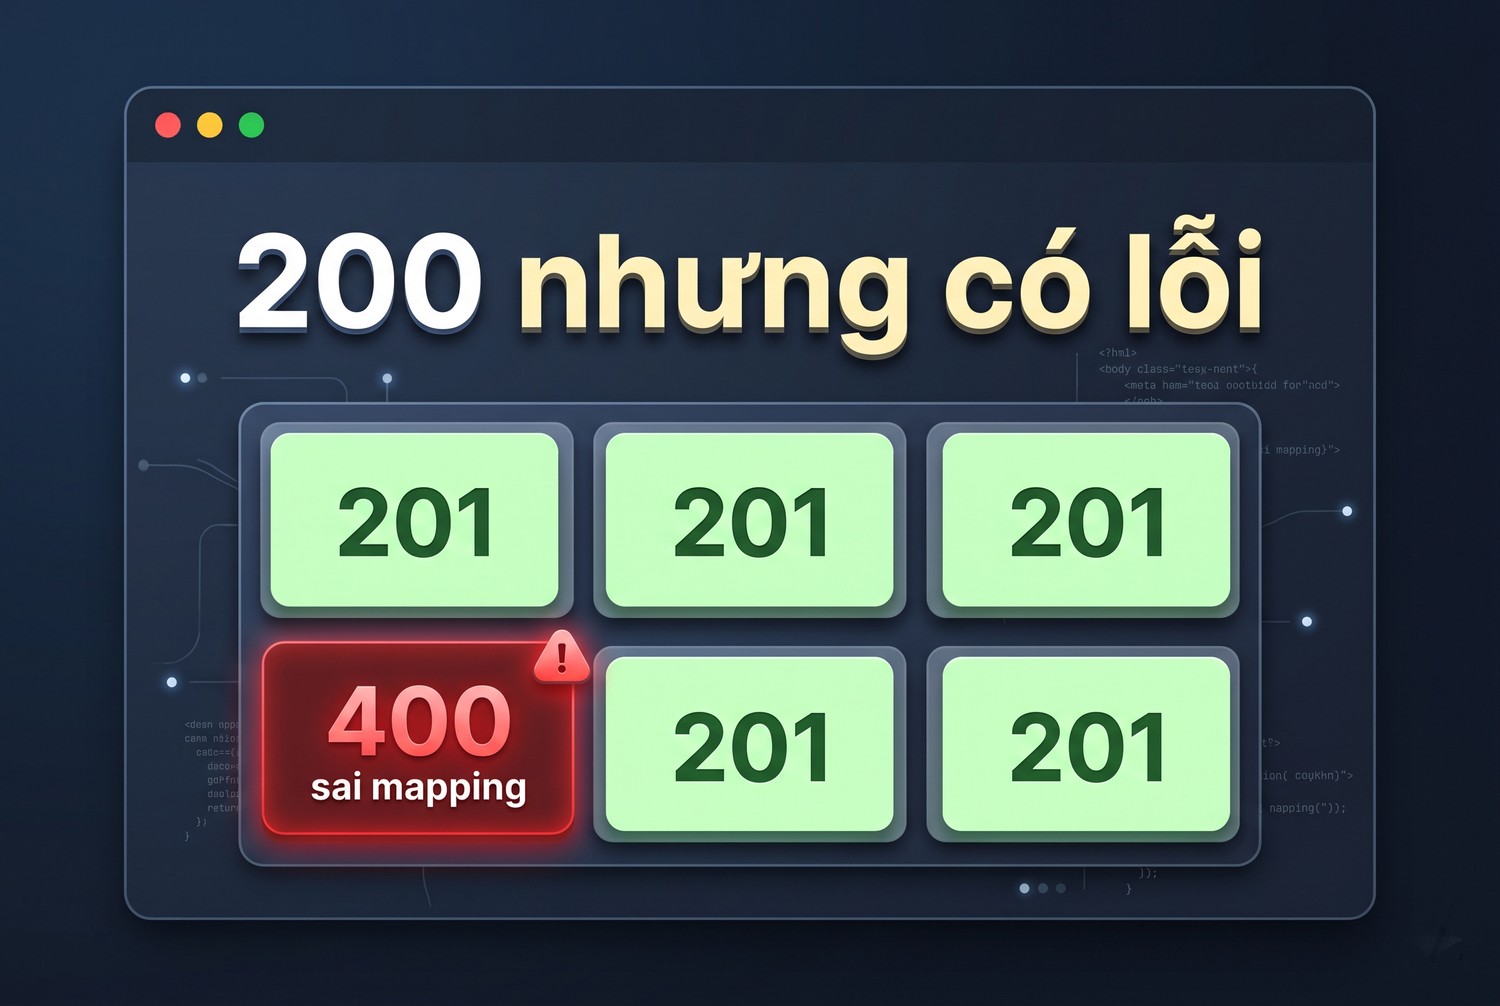
200 nhưng có lỗi
Output của lab cho sáu item, năm item 201 và một item 400.
A errors True items 6 [201, 201, 201, 400, 201, 201]
count 5
failed [('p4', 'mapper_parsing_exception', "failed to parse field [price] of type [float] in document with id 'p4'")]
Năm tài liệu vào, một tài liệu không vào, cả lô không bị hủy. Các tài liệu sau item lỗi vẫn được xử lý, đúng như tài liệu mô tả.
Trường errors
Trường errors ở cấp cao nhất là cờ nhanh. False nghĩa là mọi item ổn. True nghĩa là phải đọc mảng items. Tốn đúng một phép so sánh, nên không có lý do gì để bỏ qua.
Mảng items
Mảng items có cùng thứ tự với action đã gửi. Mỗi phần tử có khóa là tên action, bên trong là _index, _id, status, và error nếu có. Khóa đó thay đổi theo action, nên dùng list(i.values())[0] hoặc lặp qua items của dict.
def failed_items(r):
    out = []
    for i in r["items"]:
        op, res = next(iter(i.items()))
        if "error" in res:
            out.append((op, res["_id"], res["status"], res["error"]["type"], res["error"]["reason"]))
    return out
Hàm này gom lỗi thành danh sách phẳng, sẵn sàng ghi nhật ký. Thứ tự giữ nguyên, nên nối được với tài liệu gốc qua vị trí hoặc _id.
Tại sao chỉ đếm là không đủ
Sau lô đầu, count bằng 5. Con số đó không cho biết tài liệu nào thiếu. Nếu trong lô có tài liệu cập nhật, count không tăng đều, so tổng càng vô nghĩa. Chỉ có danh sách theo ID mới trả lời được.
Đọc lỗi từng item dù status toàn request thành công với OpenSearch bulk index dữ liệu web
Phần này phân loại lỗi và xem helper xử lý ra sao.
Hai tầng lỗi
Lỗi Bulk có hai tầng. Tầng request: định dạng sai, không xác thực được, cụm quá tải. Tầng item: mapping sai, xung đột phiên bản. Mã phải xử lý cả hai, vì tầng item không bao giờ ném ngoại lệ khi gọi trực tiếp.
Tầng |
Ví dụ |
Dấu hiệu |
Xử lý |
|---|---|---|---|
Request |
Thiếu xuống dòng cuối |
Mã 400, ngoại lệ |
Sửa mã tạo lô |
Request |
Quá tải, lỗi mạng |
429, 5xx, timeout |
Thử lại cả lô sau khi chờ |
Item |
mapper_parsing_exception |
status 400 trong item |
Sửa dữ liệu, không thử nguyên xi |
Item |
version_conflict_engine_exception |
status 409 trong item |
Tùy action, thường bỏ qua |
Item |
Lỗi tạm của shard |
status 429 hoặc 503 trong item |
Thử lại đúng item |
Retry nguyên xi có ích không
Với lỗi mapping, không. Gửi lại y hệt sẽ lỗi y hệt. Mã phải tách lỗi tạm với lỗi dữ liệu dựa vào status của từng item. Trạng thái 429 và 5xx là tạm, 400 là dữ liệu, 409 tùy tình huống. Không tách là tốn thời gian cho thứ không bao giờ thành công.
helpers.bulk mặc định
Lab gọi helpers.bulk với cùng dữ liệu. Mặc định helper ném BulkIndexError khi có item lỗi, kèm danh sách lỗi trong thuộc tính errors. Đây là hành vi an toàn hơn gọi thẳng, vì lỗi không còn âm thầm.
from opensearchpy import helpers

acts = [{"_index": "crawl", "_id": d["url"].rsplit("/", 1)[1], "_source": d} for d in docs]
try:
    helpers.bulk(c, acts)
except helpers.BulkIndexError as e:
    print(len(e.errors), "item loi")
Lab nhận BulkIndexError với 1 lỗi, thông báo 1 document(s) failed to index.
Item trước và sau khi ném lỗi
Khi helper ném lỗi, các item khác trong đoạn đã gửi vẫn vào rồi. Ngoại lệ không có nghĩa là không có gì được ghi. Mã catch rồi gửi lại cả lô cũng không sao, miễn là ID ổn định. Đây là một lý do nữa để giữ ID ổn định.
raise_on_error=False
Với pipeline dài, thường nên đặt raise_on_error=False để nhận cả số thành công và danh sách lỗi. Lab nhận 5 thành công, 1 lỗi.
ok, errs = helpers.bulk(c, acts, raise_on_error=False, stats_only=False)
print(ok, len(errs))   # 5 1
Nhớ đọc errs. Tắt ngoại lệ mà không đọc danh sách thì quay về đúng bài toán ban đầu, chỉ khác tên hàm.
stats_only là bẫy
Đặt stats_only=True thì helper chỉ trả số lượng, mất chi tiết. Với dữ liệu crawl, biết có lỗi mà không biết item nào thì không làm được gì. Lab dùng stats_only=False. Tham số này tiện cho báo cáo nhanh, không hợp với đối soát.
Ghi nhật ký lỗi
Mỗi item lỗi nên ghi vào tệp hoặc collection riêng: ID, URL, loại lỗi, lý do, thời điểm, mã lượt crawl. Đừng ghi vào log ứng dụng rồi quên. Tập lỗi đó là đầu vào cho bước sửa dữ liệu, và là bằng chứng khi có người hỏi vì sao trang X không tìm thấy.
Đừng chỉ log số lỗi
Một dòng log kiểu 3 item lỗi không giúp được gì lúc nửa đêm. Hãy gom theo loại lỗi và trường gây lỗi, rồi đếm. Khi một loại lỗi tăng vọt, gần như chắc là website đổi cấu trúc hoặc parser vừa đổi. Một cảnh báo theo tỷ lệ lỗi trên số item có ích hơn cảnh báo theo số lượng thô.
Chạy lại một lượt đã nạp
Sửa parser xong thường phải nạp lại dữ liệu cũ. Với action index và ID ổn định, chỉ cần chạy lại từ tệp kết quả, tài liệu được ghi đè tại chỗ. Trường hợp đổi mapping thì khác: một trường đã có kiểu không đổi được tại chỗ, nên phải tạo index mới rồi nạp vào đó, sau đó trỏ alias sang. Lab không thử alias.
Ca create trên ID đã có
Lab gửi action create với ID đã tồn tại, nhận errors True, status 409, loại version_conflict_engine_exception. Tài liệu ghi create báo lỗi nếu đã tồn tại. Với crawl lặp lại, create luôn sinh lỗi ở lượt thứ hai, nên chỉ dùng khi đúng ý muốn là không ghi đè.
Retry đúng item lỗi và đối soát theo source ID trong OpenSearch bulk index dữ liệu web
Phần này khép vòng: sửa, gửi lại, kiểm tra.
Sửa dữ liệu trước khi gửi lại
Gửi lại đúng một item
Với p4, giá lien he không phải số. Quyết định nghiệp vụ là giữ chữ gốc ở trường riêng, để price null. Lab tạo bản sửa rồi gửi lô chỉ có một item.
d4 = {**d4, "price": None, "price_raw": "lien he"}
nd2 = json.dumps({"index": {"_index": "crawl", "_id": "p4"}}) + "\n" + \
      json.dumps(d4, ensure_ascii=False) + "\n"
Kết quả errors False, status 201, count lên 6. Năm tài liệu kia không bị gửi lại, không bị đụng tới.
Sửa ở parser, đừng sửa ở bước nạp
Sửa tay một item chỉ giải quyết một lần. Giá liên hệ sẽ quay lại ở lượt sau. Parser nên trả về giá đúng kiểu hoặc null, kèm trường raw. Bước nạp chỉ nên nạp. Lỗi mapping nên coi như một báo cáo cho người viết parser.
Hàng đợi item lỗi
Item lỗi dữ liệu nên vào hàng đợi riêng để xem xét, item lỗi tạm thì vào hàng đợi thử lại có giới hạn số lần. Hàm dưới là ví dụ tách hai nhóm.
def split_retry(r):
    retry, bad = [], []
    for i in r["items"]:
        op, res = next(iter(i.items()))
        st = res.get("status", 200)
        if st >= 500 or st == 429:
            retry.append(res["_id"])
        elif "error" in res:
            bad.append((res["_id"], res["error"]["type"]))
    return retry, bad
Hàm này là ví dụ triển khai, chưa chạy trong lab. Trường hợp 409 của action index rất hiếm, cứ để nhóm bad cho người xem.
Đối soát theo source ID
Lab đối soát bằng tập ID: lấy từng ID nguồn, hỏi tài liệu có tồn tại không. Kết quả 6 trên 6, không thiếu. Với dữ liệu lớn, dùng mget theo lô hoặc tìm kiếm theo trường source_run.
want = {d["url"].rsplit("/", 1)[1] for d in docs}
have = {i for i in want if c.get(index="crawl", id=i)["found"]}
print(len(want), len(have), sorted(want - have))   # 6 6 []
Tập want - have là thứ cần báo cáo. Một con số đếm không thể nói cho anh em biết đó là những ID nào.
Đánh dấu lượt nạp
Thêm trường run_id vào mỗi tài liệu. Sau một lượt, đếm theo run_id cho ra đúng số tài liệu đã nạp lần đó, không lẫn tài liệu cũ. Trên máy chủ thật, nhớ refresh trước khi đếm, nếu không con số sẽ thấp hơn thực tế.
Xóa tài liệu không còn trên website
Bulk có action delete, và tài liệu nêu xóa ID không tồn tại trả not_found chứ không lỗi. Muốn dọn trang đã mất, so danh sách ID hiện có với lượt crawl mới nhất, phần dư đưa vào lô delete. Cẩn thận với lượt crawl lỗi: có thể xóa nhầm hàng loạt, nên đặt trần phần trăm được xóa mỗi lượt.
Retry khi cả request lỗi
Mất mạng giữa chừng thì không biết lô đã vào hay chưa. Với action index và ID ổn định, cứ gửi lại cả lô: kết quả cuối giống nhau. Đây là lợi ích lớn nhất của ID ổn định. Dùng create hoặc ID ngẫu nhiên thì không làm vậy được.
Nạp song song
Vài worker cùng gửi lô giúp nạp nhanh hơn, tới một mức nào đó cụm sẽ từ chối. Dấu hiệu là status 429 ở từng item hoặc cả request. Lúc đó phải giảm tốc, không phải tăng số lần thử. Thử lại ngay lập tức chỉ thêm tải cho cụm đang quá tải, nên cần chờ tăng dần kèm một chút ngẫu nhiên.
import random, time

def backoff(attempt, base=1.0, cap=60):
    time.sleep(min(cap, base * 2 ** attempt) * random.uniform(0.5, 1.0))
Hàm này là mẫu quen thuộc, lab không có cụm thật để kiểm tra tác dụng.
Tệp lô giữ lại bao lâu
Nên giữ tệp NDJSON của lô lỗi một thời gian, kèm phản hồi đã nhận. Khi cần điều tra, hai tệp đó cho biết đã gửi gì và nhận gì. Tệp của lô thành công thì xóa sớm cho nhẹ đĩa. Đừng lưu chúng cùng chỗ với dữ liệu có thông tin nhạy cảm nếu không có kiểm soát truy cập.
Đầu ra nghiệm thu của OpenSearch bulk index dữ liệu web
Phần này gom tiêu chí và phần chưa thử.
Danh sách kiểm tra
Pipeline đạt khi mọi dòng dưới đây đúng.
- Mapping khai báo tường minh, nhất là trường số và ngày.
- _id suy ra từ URL chuẩn hóa, dưới 512 byte.
- Mã luôn kiểm tra trường errors, hoặc dùng helper không tắt báo lỗi.
- Lỗi tách theo tầng request và tầng item.
- Chỉ item lỗi tạm mới được thử lại tự động.
- Item lỗi dữ liệu có chỗ lưu và người xem.
- Đối soát theo tập ID, không theo tổng đếm.
Bảng kết quả lab
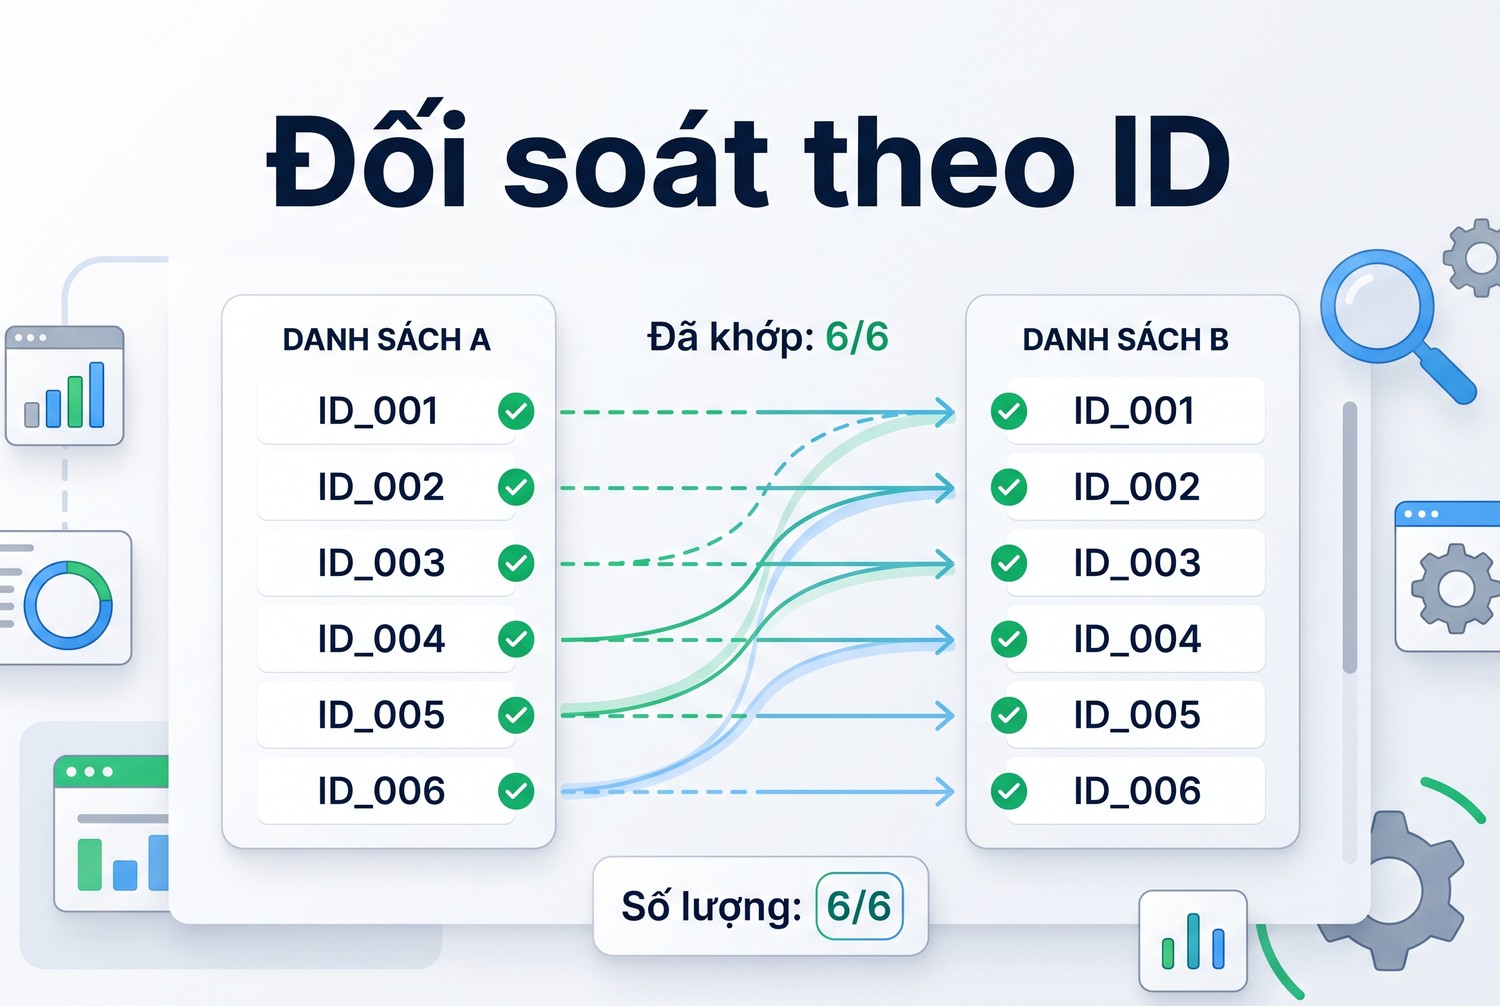
Đối soát theo ID
Bảng này gom các ca đã chạy, phản hồi đến từ máy chủ mô phỏng.
Ca |
Kết quả |
|---|---|
Lô 6 item, 1 sai mapping |
errors True, 5 vào, p4 lỗi |
Thiếu xuống dòng cuối |
RequestError 400, không item nào vào |
helpers.bulk mặc định |
BulkIndexError, 1 lỗi |
helpers.bulk, raise_on_error False |
5 thành công, 1 lỗi |
Retry p4 đã sửa |
errors False, count 6 |
ID ổn định gửi 2 lần |
3 tài liệu |
uuid gửi 2 lần |
6 tài liệu |
create trên ID đã có |
status 409 |
Những gì lab chưa chạy
Chưa chạy OpenSearch thật. Chưa có shard, chưa có refresh thật, chưa thử ép kiểu thật, chưa thử 429 từ cụm quá tải, chưa đo thông lượng, chưa thử ingest pipeline. Thông báo lỗi trong lab do ProxyVN đặt. Hàm split_retry và doc_id là ví dụ.
Kiểm lại trên cụm thật
Phần này cần làm trước khi đưa mã vào chạy thật, vì lab không thay được cụm thật.
Trên cụm thật, chạy lại đúng tệp bulk.ndjson. Nếu p4 vẫn lỗi với loại tương tự thì mã đọc lỗi dùng được ngay. Thử thêm một ca chuỗi số như 120000 để biết cụm có ép kiểu không. Sau đó mới tăng cỡ lô.
Proxy ở đâu trong luồng này
Proxy thuộc bước tải trang, không thuộc bước nạp. OpenSearch nằm trong mạng của anh em, gọi thẳng là đủ. Với website được phép thu thập, có lúc cần IP tại Việt Nam để nhận đúng nội dung trong nước. Khi đó anh em có thể mua proxy uy tín tại trang chủ ProxyVN. Proxy không sửa được lỗi mapping. Vai trò của nó có ở bài Web Scraping proxy là gì, cách ghi chuỗi cấu hình ở bài định dạng proxy.
Quyền ghi của pipeline
Phần cuối này về an toàn, dễ bị bỏ qua khi pipeline chạy trong mạng nội bộ.
Tài khoản nạp dữ liệu chỉ nên có quyền ghi vào đúng index cần thiết. Bulk là cổng rất rộng, sai một dòng là xóa được tài liệu. Tách tài khoản cho pipeline và cho người đọc. Lab không có bảo mật nên không thử phần này.
OpenSearch bulk index dữ liệu web: câu hỏi thường gặp
Các câu dưới đây gom những điểm anh em hay hỏi.
Bulk trả 200 có nghĩa là mọi tài liệu đã vào không?
Không. Tài liệu ghi rõ các action xử lý độc lập. Phải đọc trường errors và mảng items. Lab có một lô trả 200 với một item 400.
Một item lỗi có làm hủy cả lô không?
Không. Tài liệu nêu OpenSearch tiếp tục các action sau. Lab thấy p5 và p6 vẫn vào dù p4 lỗi.
Có nên gửi lại cả lô khi một item lỗi không?
Chỉ cần gửi lại item lỗi. Nếu ID ổn định thì gửi cả lô cũng không sinh trùng, nhưng tốn tài nguyên và lỗi dữ liệu vẫn y nguyên.
Vì sao phải dùng ID ổn định?
Vì retry trở nên an toàn. Lab gửi hai lần: ID theo URL giữ 3 tài liệu, uuid ngẫu nhiên thành 6.
helpers.bulk có tự xử lý lỗi không?
Mặc định nó ném BulkIndexError. Đặt raise_on_error=False thì nó trả danh sách lỗi và anh em phải tự đọc.
Bài đã chạy trên OpenSearch thật chưa?
Chưa. Máy chủ trong lab là mô phỏng, client opensearch-py là thật. Quy tắc lấy từ tài liệu, thông báo lỗi và ép kiểu cần kiểm lại trên cụm thật.
OpenSearch bulk index dữ liệu web và những điều cần nhớ
OpenSearch bulk index dữ liệu web chỉ thành công khi từng item thành công, mã 200 chưa nói lên điều đó. Luôn đọc errors và items, giữ ID ổn định, chỉ thử lại đúng item lỗi, rồi đối soát theo tập ID. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em kiểm lại OpenSearch bulk index dữ liệu web trên cụm thật.


