
Open Library bulk dump streaming: đọc theo dòng và join an toàn
Open Library bulk dump streaming là cách đọc các tệp dump hàng chục GB theo từng dòng mà không cần giải nén ra đĩa. Bài này viết cho người cần dữ liệu sách quy mô lớn. ProxyVN đã stream trọn tệp authors 784 MB ngày 05/11/2026, đếm 15474645 dòng, MD5 khớp với Internet Archive, rồi join thử ba mẫu đầu tệp và thấy tỷ lệ khớp rất thấp vì cách lấy mẫu.
Open Library bulk dump streaming: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và ranh giới với bài API Open Library đã có.
Bài toán cần giải
Một nhóm làm danh mục sách muốn lấy tác phẩm, ấn bản và tác giả cho vài trăm nghìn đầu sách. Gọi API từng ISBN thì quá chậm và không đúng tinh thần sử dụng. Họ tải tệp dump về, giải nén và mở bằng pandas. Máy hết RAM, ổ đĩa đầy, và họ vẫn chưa thấy dòng dữ liệu nào.
Đầu ra nghiệm thu
Đầu ra là một manifest gồm ngày dump, tên tệp, kích thước, checksum, số dòng, cùng pipeline join theo ID trên một tập mẫu có giới hạn. Pipeline phải báo được bao nhiêu liên kết bị thiếu và vì sao. Dump dùng được khi anh em biết rõ nó là phiên bản nào và mình đã xử lý những gì.
Ranh giới với bài API
Bài Open Library API bằng Python đi theo hướng tra cứu, phân trang và tìm ISBN qua API. Bài này không lặp những phần đó. Nó đọc tệp dump theo dòng, nối ba loại bản ghi bằng khóa nội bộ theo ngày dump. Khi cần vài bản ghi thì API hợp, khi cần quy mô lớn thì dump hợp.
Giới hạn của lab
Lab stream trọn tệp authors, nhưng với works 4.1 GB và editions 12.6 GB thì chỉ đọc 12 MB đầu mỗi tệp bằng HTTP Range. Lab không tải đủ hai tệp lớn nên không tính được tỷ lệ liên kết thật của toàn bộ dữ liệu. Mọi con số về join ở đây là số trên mẫu đầu tệp, và phần sau sẽ giải thích vì sao mẫu đó bị lệch.
Ai nên đọc
Bài hợp với kỹ sư dữ liệu, người làm nghiên cứu thư mục, nhóm dựng kho sách nội bộ. Người chỉ cần tra vài cuốn nên quay lại bài API. Người chưa quen gzip streaming sẽ thấy phần code rất ngắn và có thể dùng lại cho nhiều dump khác.
Những gì bài không làm
Bài không tải ảnh bìa. Bài không chạy trên toàn bộ 18 GB của tệp tổng hợp. Bài không đánh giá chất lượng biên mục của Open Library. Bài cũng không dựng công cụ tìm kiếm, chỉ dừng ở bảng đã nối.
Thuật ngữ dùng trong bài
Work là một tác phẩm trừu tượng. Edition là một ấn bản cụ thể của work đó, với ISBN và nhà xuất bản riêng. Author là tác giả. Key là khóa nội bộ như /works/OL10000015W. Dump date là ngày trong tên tệp, ví dụ 2026-10-31. Streaming là đọc và xử lý từng phần, không giữ cả tệp trong bộ nhớ.
Đọc bulk dump Open Library theo dòng và tách works, editions, authors với Open Library bulk dump streaming
Phần này đi từ tài liệu tới vòng lặp đọc dòng đầu tiên.
Nguồn tài liệu đã đọc
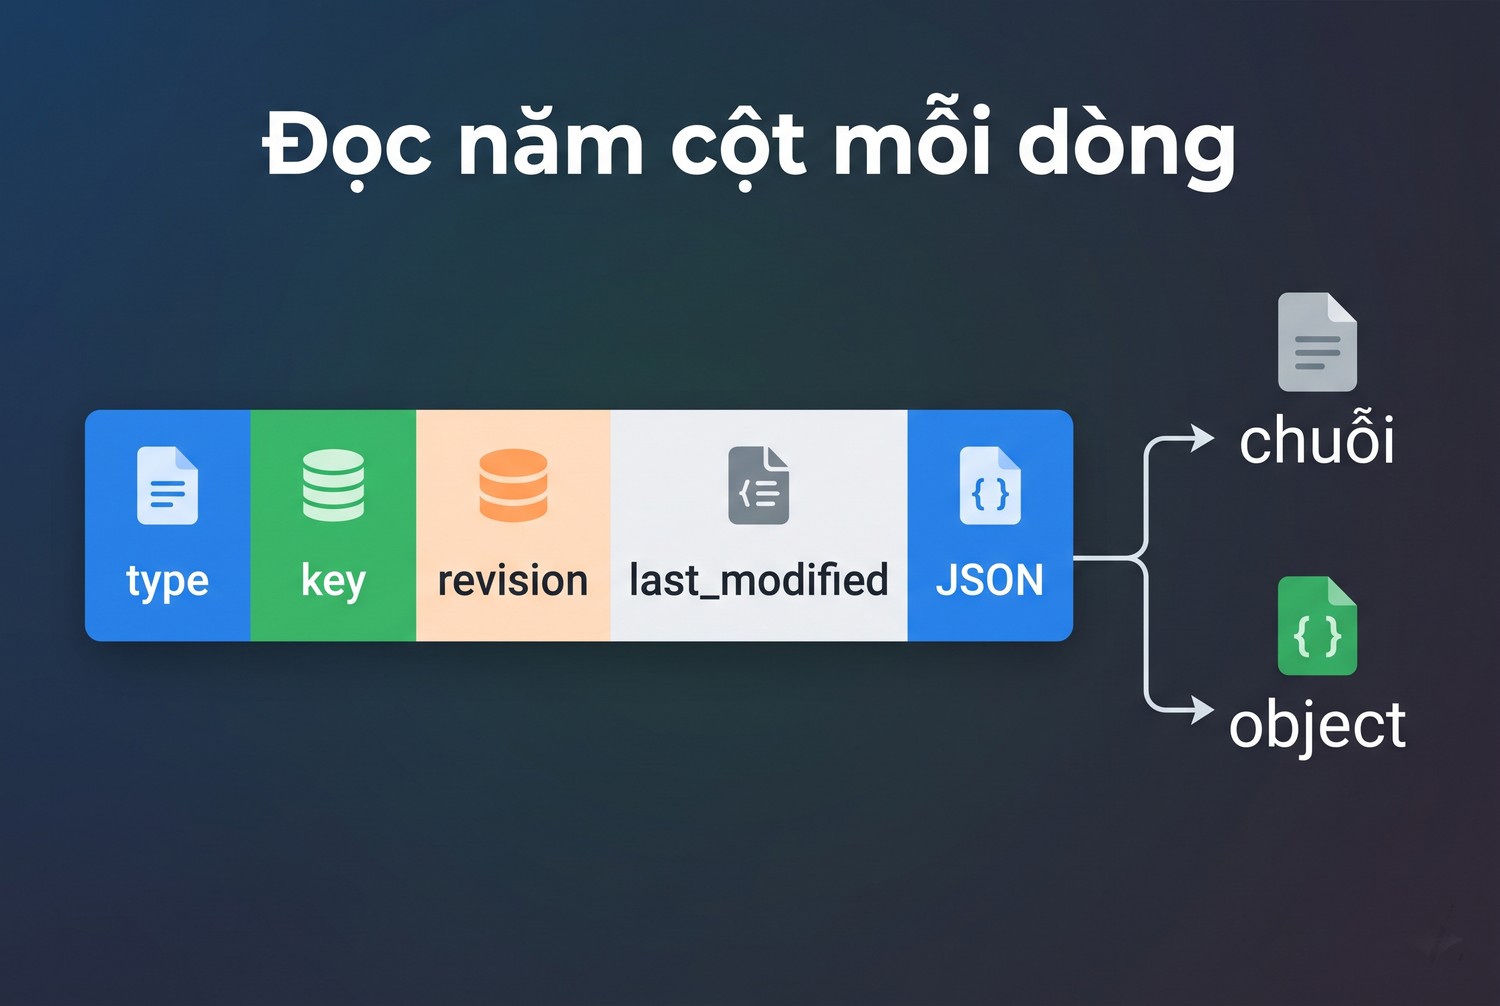
Lab đọc trang Open Library Data Dumps. Trang ghi dump được tạo mỗi tháng, phần lớn định dạng tab-separated với năm cột: type, key, revision, last_modified, JSON. Trang cũng trỏ tới bộ sưu tập ol_exports trên Internet Archive và gợi ý tải qua torrent khi cần tốc độ cao.
Liên kết latest đi đâu
Lab gọi /data/ol_dump_authors_latest.txt.gz và nhận 302 tới archive.org, rồi 302 nữa tới máy chủ lưu trữ ia600702.us.archive.org. Tên tệp thật là ol_dump_authors_2026-10-31.txt.gz. Liên kết latest tiện để bắt đầu, nhưng không nên ghi vào cấu hình lâu dài. Tệp sẽ đổi vào tháng sau mà anh em không hay biết.
Bảng tệp của dump tháng 10/2026
Lab đọc metadata của item ol_dump_2026-10-31 qua API archive.org. Kích thước thật lớn hơn con số gần đúng trên trang tài liệu, vì trang đó ghi dump cũ.
Tệp |
Kích thước gz |
Trên trang tài liệu |
|---|---|---|
authors |
784183875 byte |
khoảng 0.5 GB |
works |
4078855962 byte |
khoảng 2.9 GB |
editions |
12630804778 byte |
khoảng 9.2 GB |
redirects |
75673010 byte |
không ghi trong đoạn lab đọc |
deletes |
113291254 byte |
không ghi trong đoạn lab đọc |
ol_dump tổng |
18205492645 byte |
tất cả các loại |
Lấy checksum trước khi tải
Metadata cho MD5 và SHA1 của từng tệp. Với authors, MD5 là 70ef4b73fc6e005f49a81477d3195290. Lấy checksum trước khi tải cho anh em một điểm so ngay lúc stream, không cần tính lại sau.
import requests

s = requests.Session()
s.headers["User-Agent"] = "ProxyVN-docs-lab/1.0 (+https://proxy.vn/)"
item = "ol_dump_2026-10-31"
j = s.get(f"https://archive.org/metadata/{item}/files", timeout=60).json()
files = j.get("result", j)
for f in files:
    if f["name"].endswith(".txt.gz"):
        print(f["name"], f.get("size"), f.get("md5"), f.get("sha1"))
Đoạn này chạy thật và in đủ các tệp. Output là nền của manifest ở cuối bài.
Streaming gzip không qua đĩa
Trái tim của bài là vòng lặp dưới đây. Requests đọc từng khối 1 MiB, zlib giải nén tăng dần với wbits 31 cho định dạng gzip, phần cuối chưa trọn dòng được giữ lại cho khối sau. MD5 tính trên byte nén trong cùng vòng lặp, nên không cần đọc tệp lần thứ hai.
import zlib, hashlib, collections, time

u = f"https://archive.org/download/{item}/ol_dump_authors_2026-10-31.txt.gz"
r = s.get(u, stream=True, timeout=120)
md = hashlib.md5()
d = zlib.decompressobj(31)
buf, n, raw, bad, peak = b"", 0, 0, 0, 0
types = collections.Counter()
for c in r.iter_content(1 << 20):
    md.update(c)
    raw += len(c)
    buf += d.decompress(c)
    L = buf.split(b"\n")
    buf = L.pop()
    peak = max(peak, len(buf))
    for x in L:
        p = x.split(b"\t", 4)
        if len(p) != 5:
            bad += 1
            continue
        n += 1
        types[p[0]] += 1
print(raw, md.hexdigest(), n, bad, types.most_common(3), peak)
Điểm tốt là bộ nhớ gần như không tăng. Phần đệm cao nhất trong lần chạy thật chỉ 45790 byte, tức dòng dài nhất chưa trọn. Máy chỉ cần giữ một khối và một dòng, nên tệp vài chục GB vẫn chạy được trên máy thường.
Kết quả stream thật
Lab tải đủ 784183875 byte, MD5 khớp với metadata. Tệp có 15474645 dòng, không dòng nào hỏng, mọi dòng type là /type/author. Thời gian chạy 3993 giây, khoảng 66 phút, trong đó phần lớn là tốc độ mạng của lần đó. Không có tệp tạm nào được ghi xuống đĩa.
Tốc độ tải là điểm nghẽn
Tính ra khoảng 196 KB mỗi giây trong lần lab chạy, thấp hơn nhiều so với tốc độ xử lý dòng. Với tệp editions 12.6 GB, cùng tốc độ sẽ mất gần 18 giờ. Vì vậy với tệp lớn, tải về đĩa bằng torrent như tài liệu gợi ý rồi đọc tệp cục bộ có thể hợp lý hơn stream qua HTTP. Tốc độ phụ thuộc mạng và thời điểm, con số trên không phải chuẩn.
Tiếp tục khi đứt mạng
Stream một mạch có nhược điểm: đứt ở phút thứ 60 thì mất tiến độ. Máy chủ hỗ trợ Range, nên anh em tải theo phần vào đĩa được. Nhưng trạng thái giải nén không tiếp tục được giữa chừng nếu chưa lưu. Cách thực dụng là tải đủ về đĩa nếu mạng không ổn định, rồi đọc cục bộ bằng gzip.open.
import gzip

with gzip.open("ol_dump_authors_2026-10-31.txt.gz", "rb") as f:
    for i, line in enumerate(f):
        t, key, rev, mod, js = line.rstrip(b"\n").split(b"\t", 4)
        if i < 1:
            print(t, key, rev, mod)
Đoạn này là dạng đọc cục bộ tương đương, lab không chạy vì không lưu tệp. Điều cần giữ là split với giới hạn 4, để tab nằm trong JSON không làm hỏng dòng.
Chọn dump date và loại works, editions, authors cho Open Library bulk dump streaming
Không phải lúc nào cũng cần cả ba tệp. Phần này giúp chọn đúng thứ cần tải.
Khóa dump theo ngày
Khóa theo ngày dump
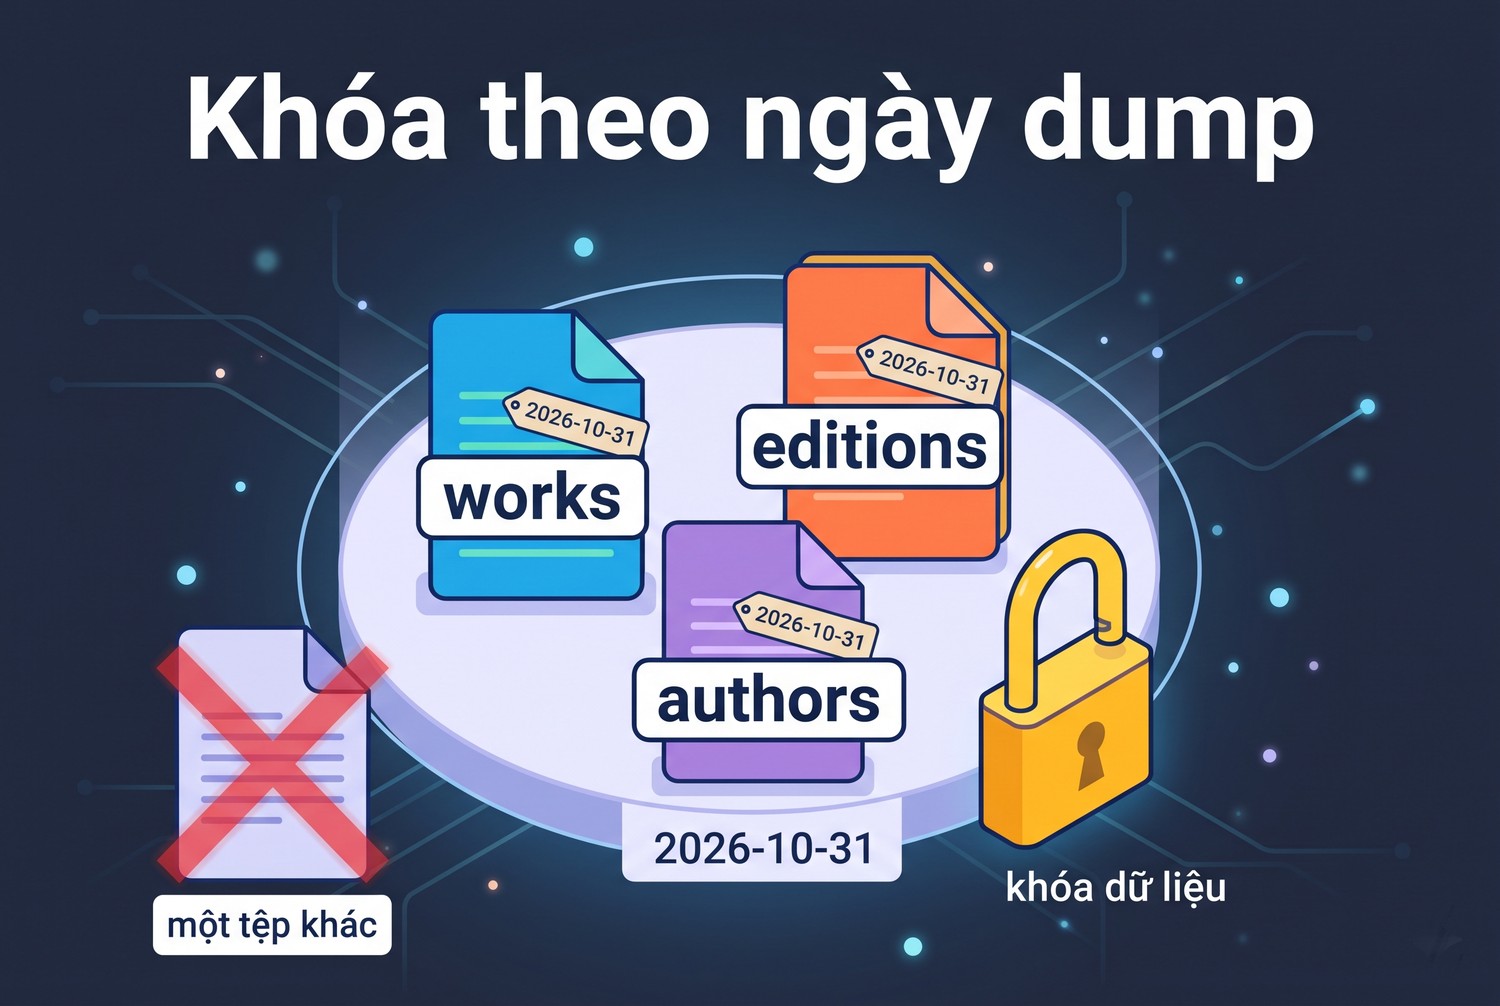
Ghi rõ ol_dump_2026-10-31 trong cấu hình. Hai tháng khác nhau sẽ có số dòng khác nhau, bản ghi bị gộp hoặc xóa. Một pipeline nối works của tháng 9 với editions của tháng 10 sẽ có liên kết thiếu không do dữ liệu. Ba tệp phải cùng ngày dump.
Chỉ lấy loại cần
Danh mục tác giả chỉ cần authors. Danh sách ấn bản có ISBN thì cần editions. Tệp tổng hợp 18 GB gồm mọi loại, thường không cần. Lab khuyên bắt đầu từ loại nhỏ nhất đáp ứng câu hỏi, rồi mới mở rộng.
Tệp redirects và deletes
Item còn có redirects và deletes. Ba tệp works, editions, authors trong mẫu của lab chỉ chứa đúng type của chúng: /type/work, /type/edition, /type/author, không thấy /type/redirect trong 121298 dòng works đầu. Khóa cũ đã gộp vì thế có thể nằm ở tệp redirects. Pipeline nối dữ liệu lâu dài cần dùng tệp này để đi theo khóa mới.
Lấy mẫu bằng HTTP Range
Lab đọc 6 MB đầu của authors, 12 MB đầu của works và editions bằng header Range. Máy chủ trả 206, zlib giải nén phần có được. Dữ liệu cuối mẫu là nửa dòng, nên lab bỏ dòng cuối. Đây là cách xem nhanh cấu trúc mà không phải tải nhiều GB.
def head(name, nbytes):
    u = f"https://archive.org/download/{item}/{name}"
    r = s.get(u, headers={"Range": f"bytes=0-{nbytes - 1}"}, timeout=120)
    t = zlib.decompressobj(31).decompress(r.content)
    return r.status_code, r.headers.get("content-range"), t.split(b"\n")[:-1]

st, cr, L = head("ol_dump_works_2026-10-31.txt.gz", 12_000_000)
print(st, cr, len(L), L[0][:120])
Output thật là 206, bytes 0-11999999/4078855962, 121298 dòng. Dòng đầu là /type/work, khóa /works/OL10000015W, tiêu đề Vocabulaire de la ville.
Tỷ lệ nén
Mẫu authors 6 MB nén giải ra 45.7 MB, gấp khoảng 7.6 lần. Mẫu editions 12 MB ra 56.4 MB, gấp khoảng 4.7 lần. Nếu giải nén cả tệp ra đĩa thì editions cần cỡ 60 GB theo tỷ lệ mẫu. Đó là lý do không nên giải nén toàn bộ khi không cần thiết.
Số bản ghi ước tính
Không có tệp nào ghi sẵn tổng số dòng. Với authors, lab có số thật. Với hai tệp còn lại, ước tính theo mẫu đầu không đáng tin vì độ dài bản ghi thay đổi theo vùng. Muốn số đúng phải đọc hết tệp. Manifest ghi rõ giá trị nào đo được, giá trị nào chưa đo.
Giữ tệp hay không
Nếu chạy nhiều lần trên cùng dump, lưu tệp gz và đọc lại rẻ hơn tải lại. Nếu chỉ lọc một lần để lấy phần nhỏ, stream rồi chỉ ghi phần lọc là tiết kiệm đĩa nhất. Hai cách đều hợp lệ, tùy số lần đọc. Dự án nên ghi lựa chọn đã dùng.
Đọc từng dòng và giải mã phần JSON theo format dump của Open Library bulk dump streaming
Năm cột thì đơn giản, phần JSON mới là nơi có bất ngờ.
Cấu trúc một dòng
Đọc năm cột mỗi dòng
Dòng đầu tệp authors có type /type/author, key /authors/OL10000004A, revision 1, last_modified 2021-12-26T21:20:34.342686 và JSON có name André Roth, source_records, created. Bốn cột đầu đủ để lọc rất nhanh, không cần parse JSON. Anh em chỉ parse JSON cho dòng cần giữ, tiết kiệm đáng kể thời gian với hàng chục triệu dòng.
Trường có nhiều kiểu
Mẫu cho thấy description của works có ba trạng thái: thiếu ở 115166 dòng, dạng dict ở 5984 dòng, dạng chuỗi ở 148 dòng. Trường bio của authors tương tự: thiếu 118255, dict 301, chuỗi 53. Dạng dict là object có type /type/text và value. Code gọi .strip() trên trường này sẽ lỗi ở dòng đầu tiên gặp dict.
def text(v):
    if isinstance(v, dict):
        return v.get("value")
    return v

print(text("mo ta"), text({"type": "/type/text", "value": "mo ta"}), text(None))
Hàm nhỏ này gom hai dạng về một, in ra mo ta, mo ta, None. Nên áp cho mọi trường văn bản tự do, vì dữ liệu lịch sử của Open Library trải qua nhiều thời kỳ schema.
Liên kết tác giả trong works
Trong work, trường authors là mảng object có type /type/author_role và author dạng object chứa key. Lab đếm 130308 liên kết trong mẫu, tất cả type là author_role. Trong đó có 179 liên kết không có khóa author, ví dụ /works/OL15356719W chỉ có phần type. Code viết a["author"]["key"] sẽ ném KeyError ở các dòng này.
Liên kết trong editions
Edition có trường works là mảng object key, và authors là mảng object key trực tiếp, khác dạng lồng của work. Mẫu có 39047 edition có authors, 13496 có isbn_13, 23481 có isbn_10. Hai cấu trúc khác nhau cho cùng một quan hệ. Hàm trích phải viết riêng cho từng loại.
def work_authors(w):
    out = []
    for a in w.get("authors", []):
        x = a.get("author")
        k = x.get("key") if isinstance(x, dict) else x
        if k:
            out.append(k)
    return out

def edition_links(e):
    return ([x["key"] for x in e.get("works", [])],
            [x["key"] for x in e.get("authors", [])])
Hàm work_authors chịu được khóa thiếu và dạng chuỗi. Trên mẫu của lab không có dạng chuỗi, nhưng phòng trước tốn thêm rất ít code.
Work không có tác giả
Mẫu có 7646 trên 121298 work không có trường authors, khoảng 6.3 phần trăm. Tệp mẫu chưa nói được tỷ lệ của toàn bộ dump. Dòng như vậy không phải lỗi đọc, đó là biên mục thiếu. Bảng cuối nên giữ cột thiếu tác giả, không loại bỏ âm thầm.
Edition không có work
Mẫu có 6486 trên 50033 edition không có trường works, khoảng 13 phần trăm. Không edition nào có nhiều hơn một work trong mẫu. Với bảng lấy work làm trục, các edition này sẽ rơi ra ngoài. Dự án phải quyết định giữ riêng hay bỏ.
Revision và last_modified
Cột revision khớp trường revision trong JSON ở mọi dòng mẫu, số dòng lệch là 0. Cột last_modified của mẫu works trải từ 2009-10-05 tới 2026-10-29. Như vậy trong cùng một dump có bản ghi rất cũ lẫn bản ghi mới. Dùng cột này để lọc tăng dần giữa hai dump là cách rẻ.
Tab trong JSON
Dùng split với giới hạn bốn lần cắt, vì JSON đã mã hóa tab thành \t nhưng phòng hờ vẫn tốt. Lab đọc 289940 dòng mẫu của ba tệp, không có dòng hỏng. Bộ đếm bad trong vòng lặp là phần phải giữ, để biết nếu tháng sau định dạng đổi.
JSON lỗi
Mọi dòng trong mẫu parse được. Dù vậy, vòng lặp sản xuất nên bắt lỗi theo dòng, ghi key vào tệp lỗi rồi đi tiếp. Một dòng hỏng không nên dừng tác vụ vài giờ. Nếu tỷ lệ hỏng vượt ngưỡng thì mới dừng.
Join khóa work, edition, author trên tập mẫu giới hạn với Open Library bulk dump streaming
Đây là phần cho một kết quả dễ hiểu sai, và cũng là bài học chính của bài.
Kết quả join trên mẫu đầu tệp
Lab lấy mẫu ba tệp rồi đếm liên kết tìm thấy trong mẫu bên kia. Bảng dưới là output thật.
Liên kết |
Tổng trong mẫu |
Khớp trong mẫu đối ứng |
Tỷ lệ |
|---|---|---|---|
Work tới author |
130308 |
1023 |
0.8 phần trăm |
Edition tới work |
43547 |
107 |
0.2 phần trăm |
Vì sao tỷ lệ rất thấp
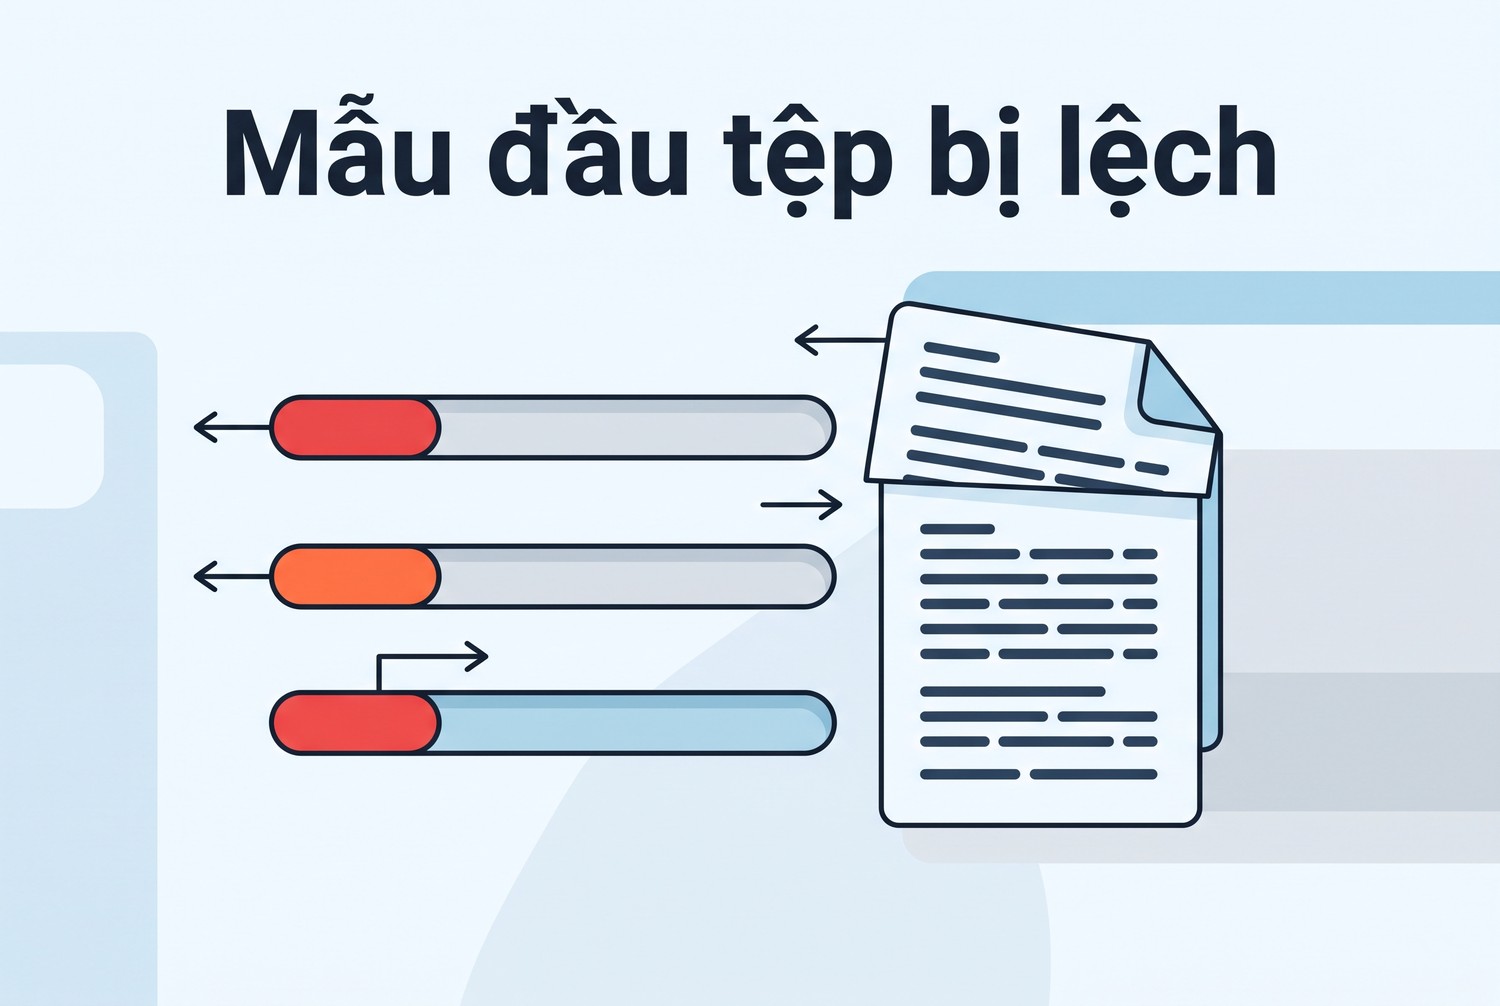
Nhìn vào con số, người mới có thể kết luận dữ liệu hỏng. Thật ra lỗi nằm ở cách lấy mẫu. Tệp được sắp theo khóa dạng chuỗi: mẫu authors đi từ OL10000004A tới OL9318729A, mẫu works từ OL10000015W tới OL41841152W, mẫu editions từ OL10000008M tới OL22164620M. Một phần đầu tệp chỉ chứa một lát khóa, còn liên kết thì trỏ đi khắp nơi. Ghép hai lát đầu tệp không đo được chất lượng liên kết.
Cách lấy mẫu đúng
Muốn kiểm join, anh em chọn một tập nhỏ làm gốc, rồi đọc tệp còn lại để lấy đúng các bản ghi được nhắc. Ví dụ chọn 1000 work, thu tập khóa tác giả, rồi stream authors và giữ các dòng khớp. Quét toàn bộ tệp authors mất thời gian nhưng bộ nhớ chỉ giữ một tập nhỏ. Đây mới là "tập mẫu có giới hạn" đúng nghĩa.
import json

def wanted_authors(work_lines, limit=1000):
    keep, picked = set(), []
    for x in work_lines[:limit]:
        w = json.loads(x.split(b"\t", 4)[4])
        picked.append(w["key"])
        keep.update(work_authors(w))
    return picked, keep

def scan_authors(lines, keep):
    found = {}
    for x in lines:
        p = x.split(b"\t", 4)
        k = p[1].decode()
        if k in keep:
            found[k] = json.loads(p[4]).get("name")
    return found
Hàm scan_authors nhận một iterator dòng, nên ghép được với vòng lặp stream ở trên. Lab chạy hai hàm này với 1000 work đầu và thu được 992 khóa tác giả. Quét trên mẫu authors 118609 dòng chỉ tìm ra 12 khóa, ví dụ OL4021559A là Bernhard F. Scholz. Con số 12 lại phản ánh việc mẫu authors chỉ là một lát. Muốn tìm đủ 992 khóa thì phải quét trọn tệp authors một lần nữa, vì lần stream đầu không lưu tệp.
Bộ lọc khóa trước khi parse
Lọc theo key trong cột thứ hai, không parse JSON cho dòng không cần. So khóa trong set rất rẻ, trong khi parse JSON cho 15 triệu dòng tốn nhiều thời gian hơn. Mẹo nhỏ này thường là khác biệt giữa vài phút và vài chục phút khi đọc từ đĩa.
Thứ tự join
Thứ tự hợp lý là editions tới works tới authors, hoặc ngược lại tùy trục dữ liệu. Nếu quan tâm ISBN, đi từ editions, thu khóa work, rồi thu khóa author từ cả edition và work. Tác giả có thể nằm ở một trong hai chỗ, nên cần hợp hai tập.
Dùng công cụ cột
Trang tài liệu có ví dụ DuckDB đọc thẳng tệp gz bằng read_csv và trích JSON. Với máy đủ tài nguyên, DuckDB tiện hơn viết tay. Lab không chạy phương án này, nên bài không có số đo. Viết tay vẫn đáng giá vì minh bạch từng bước, và không kéo thêm phụ thuộc.
SQLite trung gian
Khi cần nối nhiều lần, anh em có thể nạp phần cần vào SQLite với khóa là key. Bước nạp chỉ một lần, truy vấn sau đó rất nhanh. Với vài triệu dòng, SQLite vẫn đủ dùng. Không cần dựng cơ sở dữ liệu lớn cho một dự án nghiên cứu nhỏ.
Khóa bị gộp
Một work có thể đã bị gộp vào work khác, để lại redirect. Liên kết từ edition cũ khi đó trỏ tới khóa redirect. Trước khi kết luận liên kết hỏng, anh em tra tệp redirects cùng ngày dump. Lab chưa làm bước này, nhưng phải có trong pipeline thật.
Giữ checksum, manifest và kiểm record bị thiếu liên kết của Open Library bulk dump streaming
Phần này biến một lần chạy thành thứ người khác kiểm được.
Mẫu manifest
Mẫu đầu tệp bị lệch
Manifest là tệp JSON nhỏ, ghi đúng những gì đã làm. Ví dụ dưới dùng số thật của authors.
import json

m = {
    "dump": "ol_dump_2026-10-31",
    "file": "ol_dump_authors_2026-10-31.txt.gz",
    "bytes": 784183875,
    "md5_expected": "70ef4b73fc6e005f49a81477d3195290",
    "md5_actual": "70ef4b73fc6e005f49a81477d3195290",
    "lines": 15474645,
    "bad_lines": 0,
    "read_mode": "full_stream",
    "read_at": "2026-11-05",
}
print(json.dumps(m, indent=1))
Với tệp chỉ đọc mẫu, read_mode là range_12MB và md5_actual để null. Ghi rõ như vậy để không ai nhầm mẫu với toàn bộ.
So checksum đúng chỗ
MD5 tính trên byte nén, phải so với giá trị của tệp gz. Tính trên dữ liệu đã giải nén sẽ không khớp. Khi đọc bằng Range thì không có checksum của phần đó. Vì vậy chỉ lần đọc trọn mới xác nhận được toàn vẹn.
Báo cáo liên kết thiếu
Bảng báo cáo có bốn nhóm: khớp, không có trong tập đã quét, nằm trong redirects, nằm trong deletes. Chỉ nhóm thứ hai sau khi đã quét đủ tệp mới thật sự là thiếu. Trên mẫu đầu tệp, mọi liên kết không khớp đều thuộc loại "chưa quét", không phải "mất".
Trường bắt buộc của bảng cuối
Bảng cuối cần work_key, edition_key, author_keys, title, isbn, dump_date. Với edition không có work thì work_key rỗng và có cờ. Với work không có tác giả thì author_keys rỗng. Bảng không được tự điền bằng dữ liệu đoán.
Theo dõi qua các tháng
Khi có hai dump, so tổng số dòng, số bản ghi mới, số bản ghi xóa. Một mức thay đổi bất thường là tín hiệu kiểm lại trước khi dùng. Lab chỉ có một dump nên chưa có đường cơ sở.
Giấy phép và trích dẫn
Trang tài liệu và Internet Archive có điều kiện riêng về dữ liệu. Bảng công bố nên ghi Open Library, ngày dump và đường dẫn item. Lab chưa đọc kỹ điều khoản cho từng loại nội dung, anh em cần xem lại khi dùng thương mại.
Tải có trách nhiệm
Internet Archive là tổ chức phi lợi nhuận. Tải nhiều lần cùng một tệp lớn gây tải cho hạ tầng của họ. Tải một lần, lưu lại, và dùng torrent khi có thể. Lab chỉ tải trọn tệp nhỏ nhất và chỉ đọc 12 MB của hai tệp lớn vì lý do đó.
Proxy có cần không
Không. Đây là tệp công khai và điểm nghẽn là băng thông, không phải giới hạn theo IP. Proxy thêm một chặng trung gian, thường làm tải chậm và tốn lưu lượng hơn. Các đoạn chia nhỏ tải đã có trong bài HTTP Range tải tiếp qua proxy nếu mạng công ty buộc đi qua cổng ra. Chuỗi cấu hình theo định dạng proxy.
Tách tải và xử lý
Phần xử lý không cần mạng khi đã có tệp. Vai trò proxy trong thu thập dữ liệu có ở bài Web Scraping proxy là gì.
Với các tác vụ thu thập khác cần IP Việt Nam ổn định, anh em có thể mua proxy tại trang chủ ProxyVN.
Kế hoạch chạy đủ một lần
Một lần chạy đủ nên theo thứ tự rõ ràng. Bước một tải metadata và ghi manifest dự kiến. Bước hai tải ba tệp về đĩa bằng torrent hoặc HTTP, kiểm MD5. Bước ba quét tệp editions, giữ dòng có ISBN cần tìm, ghi ra tệp nhỏ và thu tập khóa work. Bước bốn quét works theo tập khóa, thu tập khóa author. Bước năm quét authors. Mỗi bước đều ghi số dòng đọc, số dòng giữ và số khóa chưa tìm thấy.
Vì sao quét ba lần vẫn ổn
Ba lần quét tuần tự nghe có vẻ tốn, nhưng mỗi lần chỉ giữ một set nhỏ trong bộ nhớ. Máy không cần lưu 17 GB nén vào RAM, cũng không cần cơ sở dữ liệu. Đọc tuần tự từ đĩa rất nhanh so với tải mạng. Với một dự án chạy mỗi tháng một lần, thời gian đó chấp nhận được.
Lọc sớm để giảm dữ liệu
Bước quét editions nên lọc càng sớm càng tốt: theo ISBN, ngôn ngữ hay nhà xuất bản. Dữ liệu giữ lại nên ghi dạng JSON Lines kèm key, để bước sau không phải đọc lại tệp gốc. Lớp trung gian nhỏ này cũng dễ kiểm bằng mắt. Khi có sai sót, anh em sửa từ lớp đó, không phải chạy lại từ đầu.
Khóa phiên bản
Lab chạy Python 3.12.10, requests 2.34.2, zlib của thư viện chuẩn. Tên tệp đã chứa ngày dump, nên giữ nguyên tên gốc. Schema có thể đổi theo thời gian, nên lưu thêm vài dòng mẫu của tháng đang dùng làm test.
Đầu ra nghiệm thu manifest dump date, checksum và pipeline join ID của Open Library bulk dump streaming
Mục này chốt các bảng và danh sách kiểm.
Bảng nghiệm thu của lab
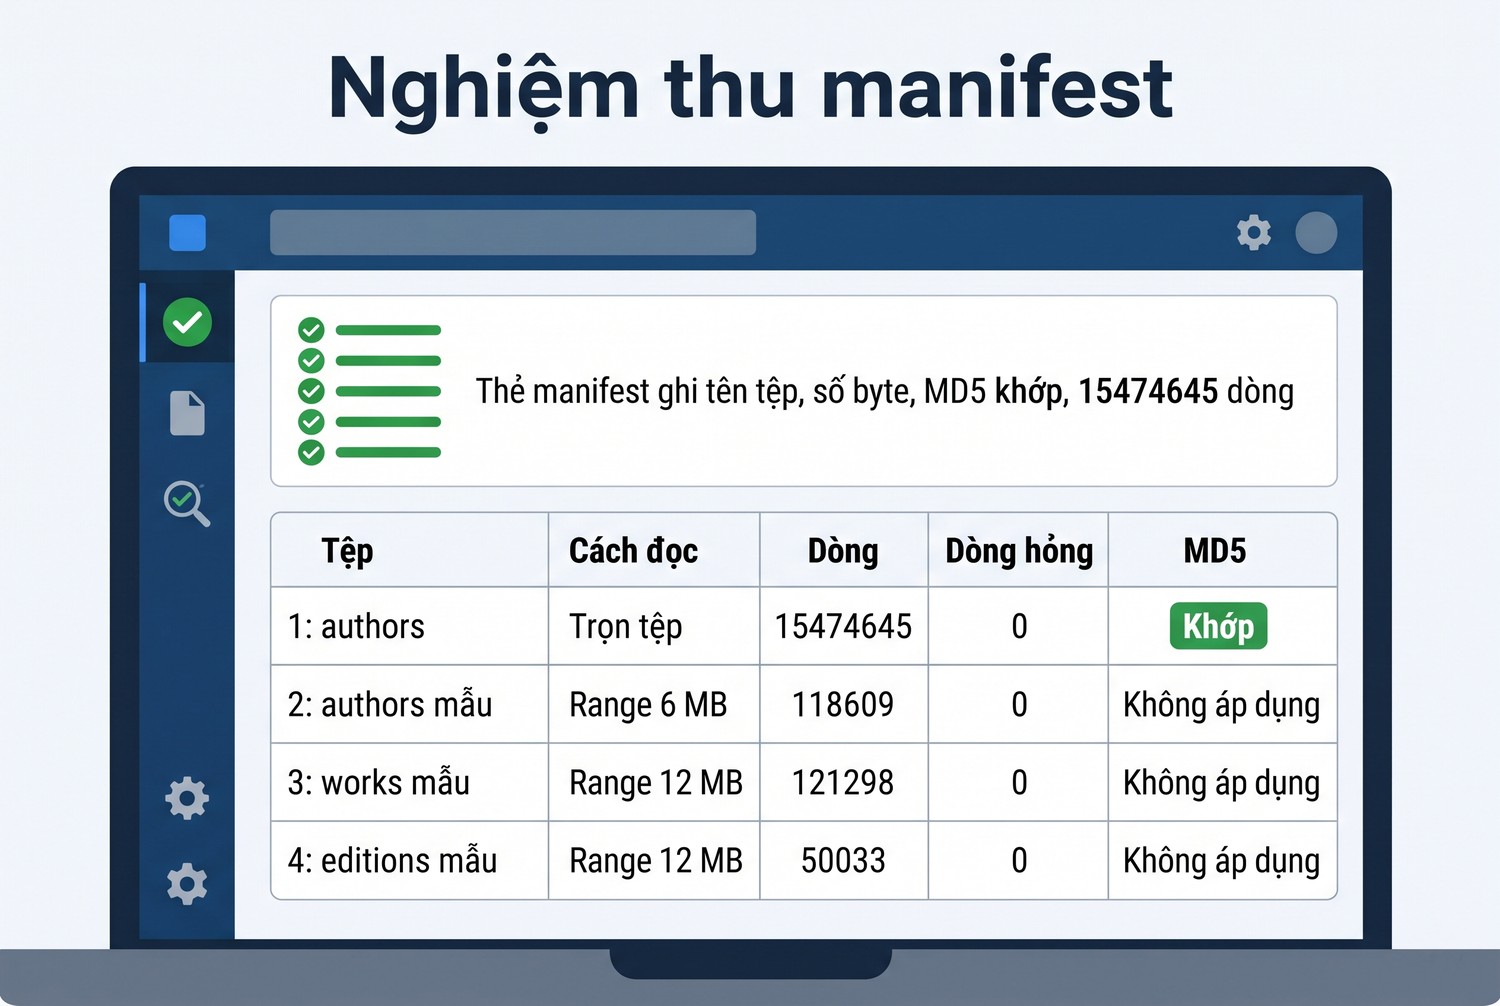
Nghiệm thu manifest
Tệp |
Cách đọc |
Dòng |
Dòng hỏng |
MD5 |
|---|---|---|---|---|
authors |
Trọn tệp |
15474645 |
0 |
Khớp |
authors mẫu |
Range 6 MB |
118609 |
0 |
Không áp dụng |
works mẫu |
Range 12 MB |
121298 |
0 |
Không áp dụng |
editions mẫu |
Range 12 MB |
50033 |
0 |
Không áp dụng |
Danh sách kiểm
- Ngày dump: ba tệp cùng một ngày, không dùng latest trong cấu hình.
- Checksum: so MD5 trên byte nén khi đọc trọn tệp.
- Bộ nhớ: đọc theo dòng, không giải nén toàn bộ.
- Kiểu dữ liệu: xử lý trường văn bản dạng dict và chuỗi.
- Liên kết: chịu được khóa thiếu, xử lý redirects.
- Mẫu: không kết luận chất lượng join từ mẫu đầu tệp.
Câu kết luận được phép viết
Từ lab có thể viết rằng tệp authors tháng 10/2026 có 15474645 dòng, MD5 khớp, stream được với đệm rất nhỏ. Trong mẫu, trường description có nhiều kiểu. Tỷ lệ khớp thấp trên mẫu đầu tệp do cách lấy mẫu. Không nên viết tỷ lệ liên kết của toàn bộ Open Library.
Những gì lab chưa chạy
Lab chưa đọc trọn works và editions, chưa dùng tệp redirects, deletes, chỉ chạy scan_authors trên mẫu, chưa thử DuckDB. Lab chưa so hai dump. Các tỷ lệ phần trăm trong bài chỉ áp cho mẫu.
Đọc theo dòng, khóa ngày dump, so MD5 trên byte nén. Và đừng kết luận chất lượng liên kết từ một lát đầu tệp.
Open Library bulk dump streaming: câu hỏi thường gặp
Các câu dưới đây gom những điểm hay bị hỏi.
Có cần giải nén trước khi đọc không?
Không. Đọc qua zlib hoặc gzip theo dòng là đủ, và tiết kiệm đĩa.
Stream qua mạng hay tải về đĩa?
Tệp nhỏ thì stream được. Tệp lớn và mạng không ổn thì tải về, có thể dùng torrent.
Vì sao mẫu join khớp ít vậy?
Vì mẫu đầu tệp chỉ là một lát khóa. Phải chọn gốc rồi quét tệp đối ứng.
Trường description lỗi kiểu dữ liệu là sao?
Trường có thể là chuỗi hoặc object có value. Dùng hàm gom về một dạng.
Có nên dùng liên kết latest không?
Dùng để xem nhanh. Pipeline nên ghi cứng ngày dump.
Bao lâu có dump mới?
Tài liệu ghi mỗi tháng. Lab thấy dump ngày 31/10/2026 là bản mới nhất ngày chạy.
Có cần API nếu đã có dump?
Dump cho quy mô lớn, API cho tra lẻ và dữ liệu mới hơn.
Proxy có làm tải nhanh hơn không?
Không phải mục đích. Thường còn chậm hơn vì thêm một chặng.
Open Library bulk dump streaming và những điều cần nhớ
Open Library bulk dump streaming hiệu quả khi anh em đọc theo dòng, khóa ngày dump, so MD5, xử lý các kiểu JSON khác nhau và kiểm join bằng tập gốc thay vì mẫu đầu tệp. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em ghi manifest cho mỗi lần chạy Open Library bulk dump streaming.


