
Open Library API bằng Python: tìm sách, tách Work và Edition
Open Library API bằng Python là cách lấy metadata sách từ Open Library qua Search API và các endpoint JSON chính thức, thay vì tải trang HTML. Điểm dễ nhầm nhất là một Work có nhiều Edition, mỗi Edition mang ISBN riêng, nên khóa của bảng phải chọn đúng tầng. ProxyVN chạy thật ngày 29/10/2026: một ISBN dẫn tới Edition rồi tới Work có 161 Edition, tham số fields cắt response, và một ISBN sai checksum vẫn trả về bản ghi có thật.
Open Library API bằng Python: mục tiêu dữ liệu, quyền và phạm vi truy cập
Phần đầu chốt dữ liệu cần lấy, chính sách sử dụng của Open Library và phạm vi của bài.
Dữ liệu cần lấy
Mục tiêu là bảng metadata sách nhỏ: khóa Work, tiêu đề, tác giả đầu tiên, năm xuất bản đầu tiên, số Edition, số ISBN, Edition có ảnh bìa, trạng thái ebook và URL nguồn. Bảng này đủ để làm danh mục tham khảo, gợi ý đọc hoặc đối chiếu với kho sách nội bộ.
Lab dùng truy vấn proxy server vì gần với chủ đề của ProxyVN và cho kết quả nhỏ, 65 Work. Với truy vấn nhỏ, anh em dễ kiểm từng dòng bằng mắt trước khi chạy truy vấn lớn hơn.
Chính sách sử dụng API
Trang API của Open Library ghi rõ mức tốc độ. Request không định danh được 1 request mỗi giây. Request có User-Agent kèm tên ứng dụng và email liên hệ được 3 request mỗi giây.
Trang này cũng liệt kê những việc không nên làm: scrape trang HTML, phân tán request qua nhiều IP, gửi hàng trăm request cho từng cuốn sách lẻ thay vì dùng search.json. Vi phạm có thể dẫn tới bị giới hạn mạnh hoặc bị chặn.
Open Library ghi thẳng việc phân tán request qua nhiều IP vào danh sách không nên làm. Proxy xoay không có chỗ trong bài này.
Khi cần dữ liệu lớn
Open Library nói rõ API không dành làm backend dữ liệu số lượng lớn. Khi cần toàn bộ catalog, dùng bản dump hàng tháng miễn phí. Dump được tải một lần, xử lý offline, không tạo tải lên máy chủ phục vụ người đọc.
Bài này phù hợp với nhu cầu tra cứu vài chục tới vài nghìn cuốn. Vượt mức đó, anh em nên chuyển sang dump thay vì cố tăng tốc API.
Không tải bản sách có quyền hạn chế
Trường ebook_access cho biết trạng thái bản điện tử: no_ebook, borrowable, printdisabled, public hoặc unclassified. Lab thấy 23 Work không có ebook, 11 cho mượn, 5 dành cho người khuyết tật đọc in và 1 chưa phân loại.
Bản cho mượn và bản printdisabled đi qua hệ thống mượn của Internet Archive, có điều kiện riêng. Bài này chỉ ghi trạng thái vào bảng, không tải bất kỳ bản sách nào.
Ranh giới với OpenAlex và Crossref
OpenAlex và Crossref quản lý công trình khoa học theo DOI. Bài OpenAlex API bằng Python xử lý nguồn đó. Open Library quản lý sách theo Work, Edition và ISBN, phần lớn là sách phổ thông, giáo trình và sách cũ.
Một cuốn giáo trình có thể có ISBN nhưng không có DOI. Một bài báo có DOI nhưng không có ISBN. Hai hệ định danh không thay thế nhau, nên chọn nguồn theo loại tài liệu cần tra.
Ai dùng bảng sách này
Thư viện trường học dùng bảng metadata để bổ sung thông tin cho sách đã có mã ISBN mà thiếu nhà xuất bản hay năm. Nhà sách nhỏ dùng nó để điền mô tả cho danh mục bán hàng. Nhóm nghiên cứu dùng nó để đếm số ấn bản của một tác phẩm qua các năm.
Cả ba nhu cầu đều là tra cứu có chủ đích, không phải sao chép cả catalog. Đó đúng là kiểu sử dụng Open Library mô tả là phù hợp: request hữu ích, phục vụ người dùng thật, có cache.
Nếu nhu cầu của anh em là xây một kho sách riêng từ đầu, hãy bắt đầu từ dump. API khi đó chỉ dùng để làm mới vài bản ghi thay đổi gần đây.
Những gì bài không làm
Bài không hướng dẫn sửa catalog, không đăng nhập, không dùng API mượn sách và không scrape HTML. Bài cũng không hướng dẫn vượt 3 request mỗi giây bằng cách đổi IP.
Open Library API bằng Python: tìm metadata sách qua Search API, phân biệt Work và Edition cùng ISBN
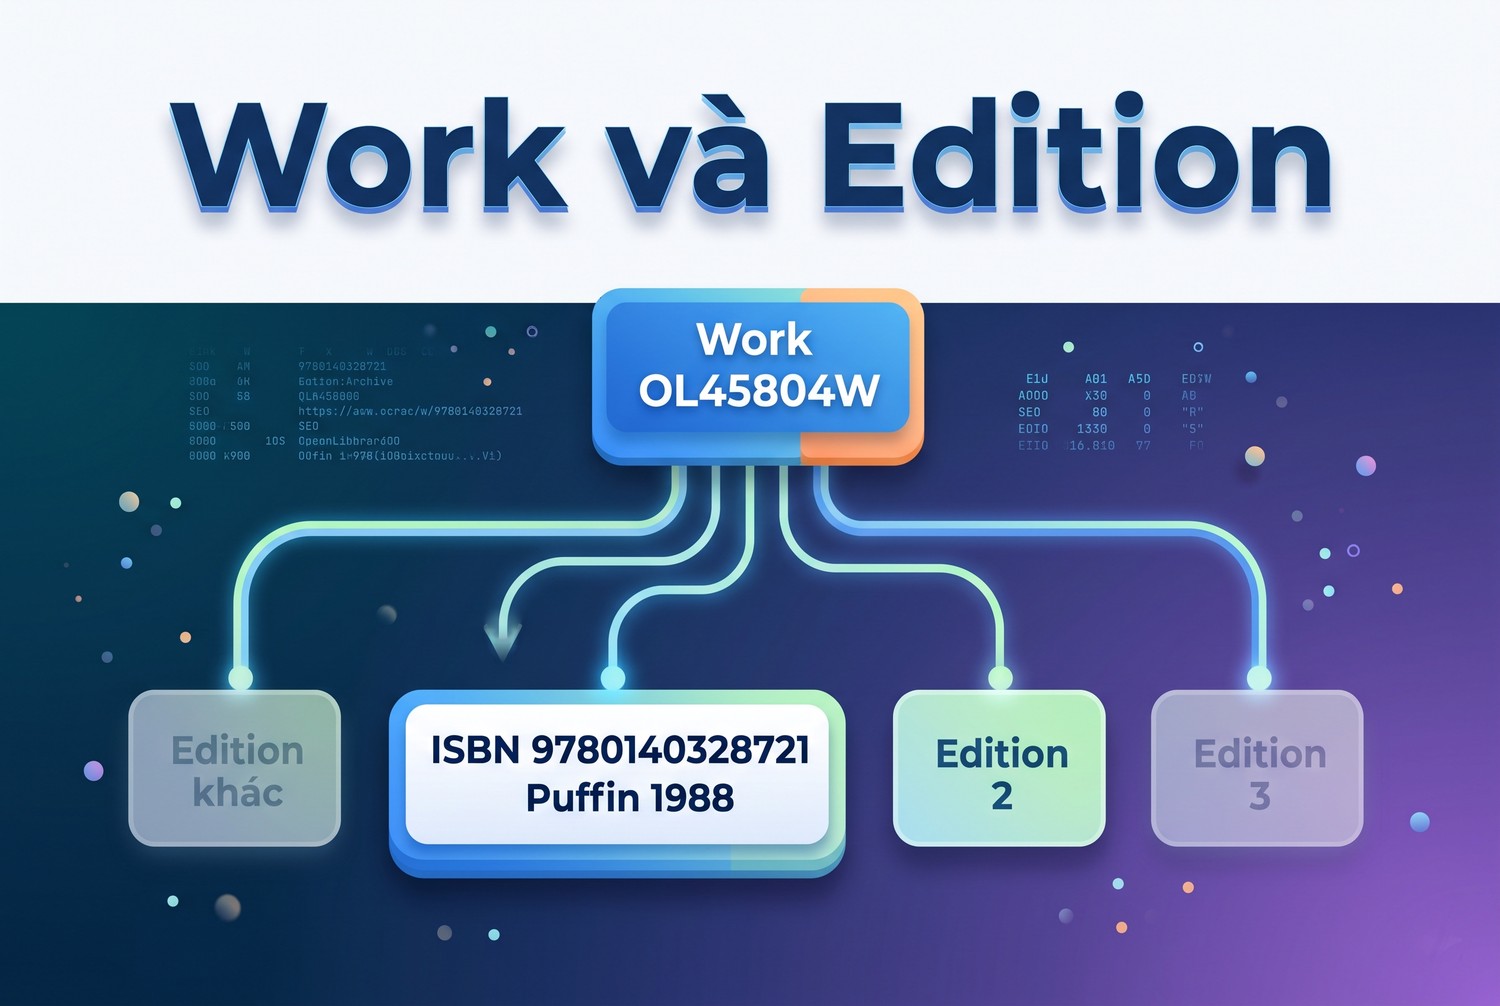
Work và Edition
Phần này giải thích mô hình dữ liệu của Open Library qua một ví dụ có thật trong lab.
Work là tác phẩm, Edition là ấn bản
Work đại diện cho tác phẩm trừu tượng, ví dụ cuốn Fantastic Mr Fox của Roald Dahl. Edition là một ấn bản cụ thể: nhà xuất bản, năm, ngôn ngữ, số trang, ISBN. Một Work có thể có hàng trăm Edition.
Khóa Work có dạng /works/OL45804W, kết thúc bằng chữ W. Khóa Edition có dạng /books/OL7353617M, kết thúc bằng chữ M. Nhìn ký tự cuối là biết đang ở tầng nào.
ISBN thuộc về Edition
ISBN gắn với ấn bản, không gắn với tác phẩm. Lab gọi /isbn/9780140328721.json và nhận mã chuyển hướng 302 tới /books/OL7353617M.json. Đó là Edition của nhà Puffin, xuất bản ngày 1/10/1988.
Gọi tiếp Work /works/OL45804W.json, lab thấy Work không có trường isbn_13. Các trường của Work gồm authors, covers, description, subjects, title và vài trường lịch sử. Muốn có ISBN, phải đi xuống tầng Edition.
Tiêu đề Work và Edition có thể khác nhau
Edition ghi tiêu đề Fantastic Mr. Fox, có dấu chấm sau Mr. Work ghi Fantastic Mr Fox, không có dấu chấm. Khác biệt nhỏ, nhưng đủ để phép khớp chuỗi tiêu đề thất bại.
Bài học: đừng khớp sách theo tiêu đề. Khớp theo khóa Work hoặc ISBN đã chuẩn hóa. Tiêu đề chỉ dùng để hiển thị.
Một Work có bao nhiêu Edition
Endpoint /works/OL45804W/editions.json trả danh sách Edition có phân trang. Lab nhận size 161, nghĩa là Work này có 161 Edition. Trang đầu với limit=50 trả 50 Edition và link next trỏ tới offset=50.
Trong 50 Edition đầu, 37 Edition có isbn_13. Các Edition còn lại là bản cũ trước thời ISBN 13 chữ số, hoặc dữ liệu chưa được nhập. Ngôn ngữ trải từ tiếng Anh, Pháp, Ý tới tiếng Trung, Nhật, Hebrew và Đan Mạch.
Tác giả là tầng thứ ba
Ngoài Work và Edition, Open Library có tầng Author với khóa dạng /authors/...A. Work trỏ tới Author qua trường authors. Edition cũng có thể có trường authors riêng, nhưng thường để trống và dựa vào Work.
Khi cần thông tin tác giả như năm sinh hay tên khác, gọi /authors/{id}.json. Đừng lấy thông tin tác giả từ chuỗi author_name trong kết quả tìm kiếm, vì chuỗi đó chỉ là tên hiển thị.
Ảnh bìa nằm ở dịch vụ riêng
Trường covers trong Work và Edition chứa số ID ảnh. Ảnh được phục vụ từ Covers API với đường dẫn riêng. Kết quả tìm kiếm có cover_edition_key chỉ ra Edition có ảnh bìa đại diện.
Bài này chỉ ghi khóa ảnh, không tải ảnh. Nếu cần ảnh, Covers API có giới hạn riêng, và tải ảnh hàng loạt nặng hơn nhiều so với tải metadata.
Search API trả Work
Search API /search.json trả danh sách Work, không trả Edition. Mỗi kết quả có edition_count và danh sách ISBN của mọi Edition thuộc Work đó. Lab tìm theo isbn=9780140328721 và nhận đúng một Work OL45804W với edition_count 161.
Như vậy Search API là đường đi từ ISBN lên Work trong một request. Endpoint /isbn là đường đi từ ISBN xuống Edition. Chọn endpoint theo tầng anh em cần.
Bảng các tầng dữ liệu
Tầng |
Ví dụ khóa |
Có ISBN |
Endpoint |
|---|---|---|---|
Work |
/works/OL45804W |
Không |
/works/{id}.json |
Edition |
/books/OL7353617M |
Có |
/books/{id}.json hoặc /isbn/{isbn}.json |
Danh sách Edition |
size 161 |
Từng Edition |
/works/{id}/editions.json |
Kết quả tìm kiếm |
numFound 65 |
Danh sách gộp |
/search.json |
Chuẩn bị truy vấn, ID và phiên bản khi dùng Open Library API bằng Python
Phần này gom các tham số Search API, cách chuẩn hóa ISBN và cách định danh ứng dụng.
Tham số q và các trường tìm kiếm
q là truy vấn tự do. Có thể giới hạn theo trường như title, author, subject hoặc isbn. Tài liệu Search API liệt kê các trường hỗ trợ và cú pháp kết hợp.
Lab dùng q=proxy server và nhận numFound 65, numFoundExact true. Khi numFoundExact là false, numFound chỉ là ước lượng. Script nên ghi cả hai giá trị để biết con số có tin được không.
Tham số fields cắt response
fields chọn trường trả về. Không có fields, mỗi Work trả khoảng 16 trường và một kết quả nặng 792 byte trong lab. Với fields gồm chín trường cần thiết, hai mươi Work chỉ nặng 5.458 byte ở trang đầu.
Tài liệu còn cho phép fields=* kèm availability, hoặc lồng editions để lấy Edition phù hợp nhất trong cùng request. Chỉ lấy trường cần dùng giúp response nhẹ và server đỡ tốn tài nguyên.
limit, page và offset
Search API nhận limit làm cỡ trang, kèm page hoặc offset. Lab dùng limit=20 với page=1 và page=2. Response trả start là 0 và 20, khớp với vị trí trang.
Không trộn page và offset trong cùng request. Chọn một cách và giữ nhất quán trong script để tránh lệch trang.
Lọc theo ngôn ngữ
Search API nhận điều kiện language với mã ba chữ cái như eng, fre hoặc vie. Trường language trong kết quả là mảng, vì một Work có Edition ở nhiều ngôn ngữ.
Khi cần sách tiếng Việt, thêm language:vie vào q và kiểm lại số kết quả. Catalog sách tiếng Việt trên Open Library còn mỏng, nên đừng kỳ vọng độ phủ như sách tiếng Anh. Lab chưa chạy điều kiện này.
Chuẩn hóa và kiểm checksum ISBN
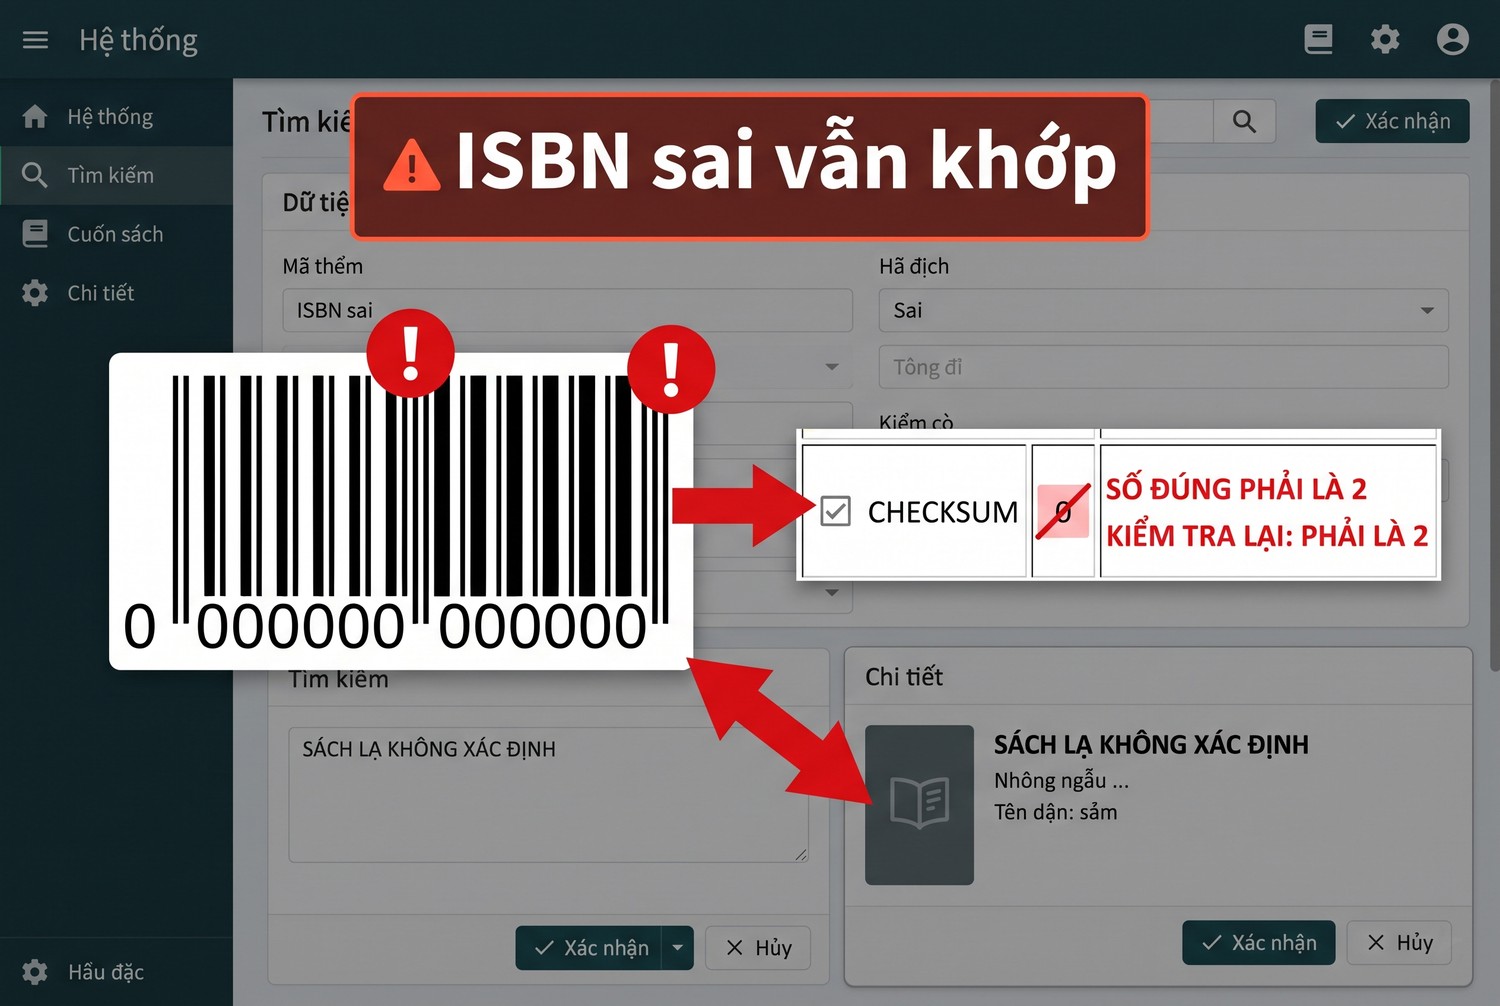
ISBN sai vẫn khớp
ISBN có thể viết kèm gạch nối, khoảng trắng, hoặc ở dạng 10 chữ số. Trước khi tra, bỏ ký tự không phải số, đổi ISBN 10 sang ISBN 13 và kiểm chữ số kiểm tra.
Lab thử ISBN 9780000000000 và nhận mã 200 với một Edition có thật, tiêu đề về Bertrand Barère, nhập từ bản ghi MARC của thư viện Harvard và Columbia. Chữ số kiểm tra đúng của dãy 978000000000 phải là 2, không phải 0. Dữ liệu nguồn đã chứa ISBN giả, và API trả nó như bình thường.
Kiểm checksum ISBN trước khi tra. Một ISBN sai vẫn có thể khớp với bản ghi rác trong catalog.
Hàm kiểm ISBN 13
import re

def isbn13(raw):
    d = re.sub(r"[^0-9Xx]", "", raw)
    if len(d) == 10:
        d = "978" + d[:9]
        d += str((10 - sum(int(c) * (1 if i % 2 == 0 else 3)
                           for i, c in enumerate(d)) % 10) % 10)
    if len(d) != 13 or not d.isdigit():
        return None
    s = sum(int(c) * (1 if i % 2 == 0 else 3) for i, c in enumerate(d[:12]))
    return d if (10 - s % 10) % 10 == int(d[12]) else None

print(isbn13("978-0-14-032872-1"), isbn13("9780000000000"))
Hàm trả 9780140328721 cho ISBN thật và None cho ISBN sai checksum. Chỉ ISBN qua được hàm này mới nên gửi tới API.
Định danh ứng dụng bằng User-Agent
Open Library yêu cầu User-Agent gồm tên ứng dụng và email hoặc số điện thoại liên hệ khi gọi nhiều lần mỗi phút. Lab dùng ProxyVN-lab/1.0 kèm email giả [email protected]. Khi chạy thật, thay bằng email thật của nhóm.
Định danh mở mức 3 request mỗi giây thay vì 1. Quan trọng hơn, khi có sự cố, Open Library liên hệ được anh em thay vì chặn thẳng.
Viết truy vấn thành cấu hình
Gom q, fields, limit và ngôn ngữ vào một dict cấu hình ở đầu script. Khi đổi chủ đề, chỉ sửa dict. Ghi dict vào đầu file kết quả để sau này biết bảng sinh ra từ truy vấn nào.
Danh sách ISBN đầu vào nên đọc từ file văn bản, mỗi dòng một mã, giữ nguyên dạng gốc. Script chuẩn hóa và kiểm checksum, rồi ghi ra file thứ hai gồm mã gốc, mã đã chuẩn hóa và lý do bị loại nếu có. Hai file song song giúp người nhập liệu sửa lỗi nhanh.
Không cần khóa API
Các endpoint đọc metadata không cần khóa. Không đăng nhập, không token. Môi trường lab gồm Python 3.12.10 và requests 2.34.2, không cần thư viện bọc riêng.
Thu dữ liệu có phân trang bằng Open Library API bằng Python
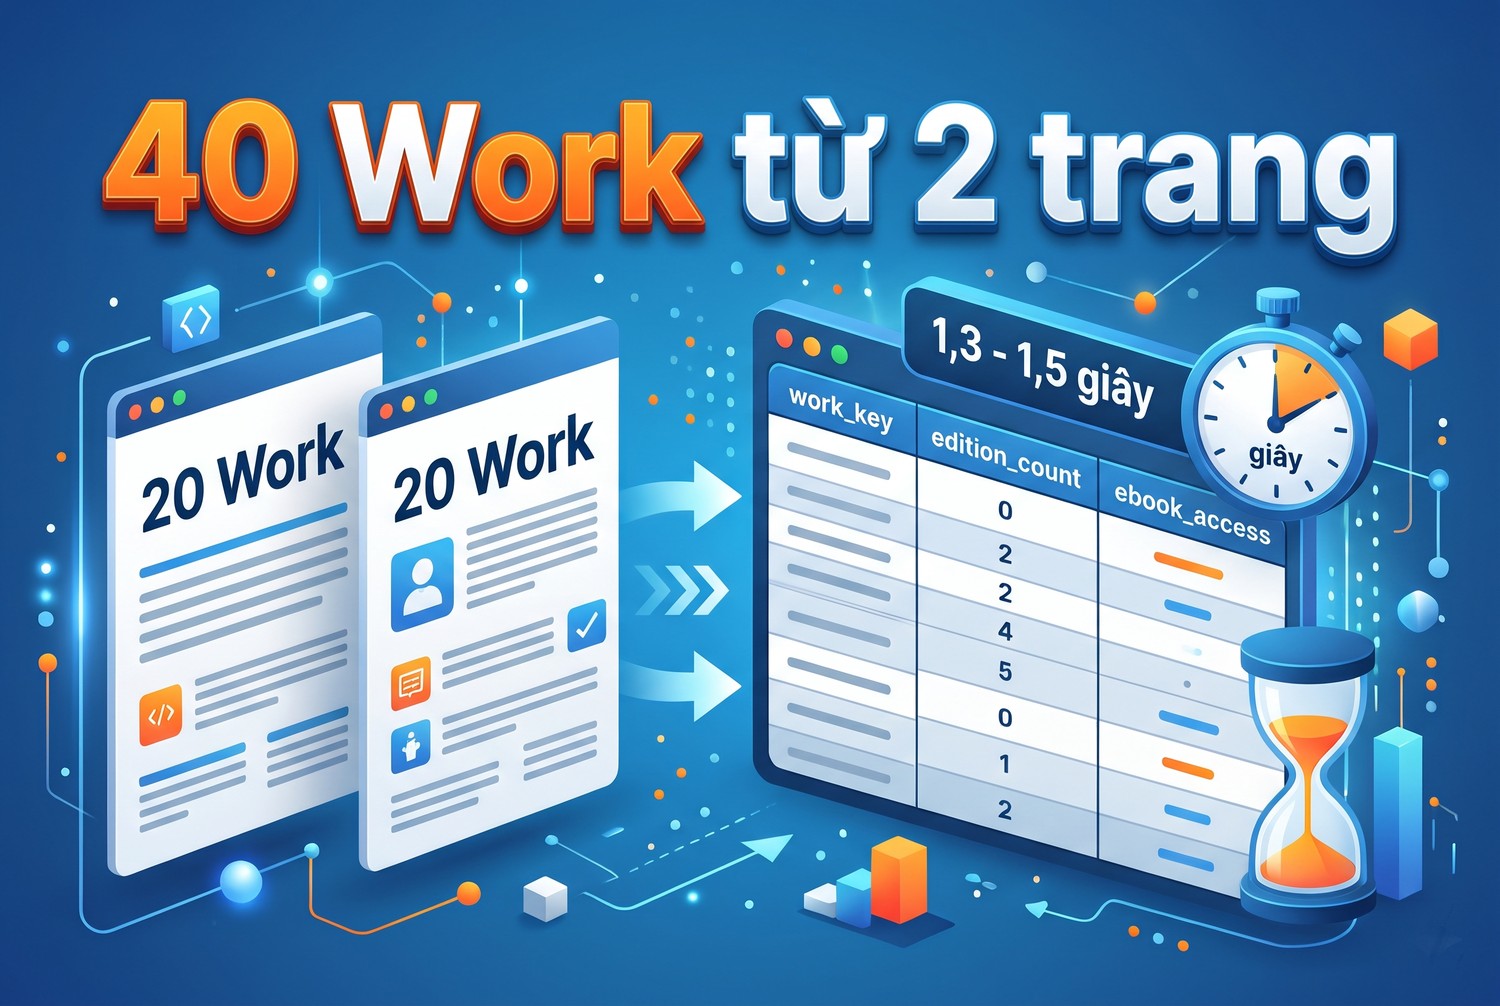
40 Work từ 2 trang
Phần này chạy Search API thật, đi từ ISBN xuống Edition và lên Work, rồi đo thời gian.
Script tìm Work có fields
import csv, time, requests
B = "https://openlibrary.org"
UA = {"User-Agent": "ProxyVN-lab/1.0 (lab@example.com)"}
F = ("key,title,author_name,first_publish_year,edition_count,"
     "isbn,language,cover_edition_key,ebook_access")
rows = []
for page in (1, 2):
    r = requests.get(B + "/search.json", headers=UA, timeout=40,
                     params={"q": "proxy server", "fields": F, "limit": 20, "page": page})
    j = r.json()
    for x in j["docs"]:
        rows.append({"work_key": x["key"], "title": x.get("title"),
                     "first_author": (x.get("author_name") or [""])[0],
                     "first_publish_year": x.get("first_publish_year"),
                     "edition_count": x.get("edition_count"),
                     "isbn_count": len(x.get("isbn", [])),
                     "ebook_access": x.get("ebook_access", ""),
                     "source_url": B + x["key"]})
    time.sleep(1)
Kết quả hai trang tìm kiếm
Trang |
Mã |
Giây |
Byte |
numFound |
start |
Số Work |
|---|---|---|---|---|---|---|
1 |
200 |
1,336 |
5.458 |
65 |
0 |
20 |
2 |
200 |
1,541 |
7.607 |
65 |
20 |
20 |
Hai trang cho 40 Work, 40 khóa khác nhau. Kết quả đầu là Web proxy servers của Ari Luotonen, năm 1998, một Edition, hai ISBN. Kết quả thứ hai là Proxy Server 2, năm 1998, hai Edition, bốn ISBN.
Đi từ ISBN xuống Edition
Request /isbn/9780140328721.json mất 1,728 giây vì có một bước chuyển hướng 302. Requests tự theo chuyển hướng, và r.history ghi lại mã 302. URL cuối là /books/OL7353617M.json.
Nếu có danh sách ISBN dài, đừng gọi /isbn từng cái một. Trang API ghi rõ không nên gửi hàng trăm request cho từng cuốn. Dùng search.json với nhiều ISBN nối bằng OR, hoặc chuyển sang dump.
Đi từ Work tới danh sách Edition
Request /works/OL45804W/editions.json?limit=50 mất 2,286 giây và nặng 39.091 byte. Response có size, entries và links.next. Đọc next để lấy trang tiếp theo cho tới khi không còn next.
Với 161 Edition và limit 50, cần 4 request. Ở mức 3 request mỗi giây có định danh, toàn bộ mất chưa tới hai giây chờ. Script lab vẫn nghỉ 1 giây giữa request để có biên an toàn.
Tra nhiều ISBN trong một request
Search API cho phép gộp nhiều ISBN bằng toán tử OR trong cùng truy vấn. Một request trả về mọi Work chứa các ISBN đó. Cách này thay hàng chục request /isbn lẻ bằng một request.
Giới hạn độ dài URL vẫn áp dụng, nên gộp vừa phải, khoảng vài chục ISBN mỗi request. Sau khi nhận kết quả, đối chiếu ngược ISBN nào đã khớp Work nào bằng trường isbn của từng kết quả. Lab chưa chạy truy vấn gộp, chỉ chạy tra ISBN đơn.
Thời gian phản hồi
Mọi request trong lab mất từ 1,2 tới 2,3 giây. Chậm hơn hẳn API của Stack Exchange hay arXiv đo cùng ngày. Thời gian chủ yếu là phía server, vì response chỉ vài KB.
Đặt timeout ít nhất 30 giây. Timeout quá ngắn sẽ làm script báo lỗi giả trong giờ cao điểm, rồi thử lại và tạo thêm tải.
Giữ nhịp dưới giới hạn
Với 3 request mỗi giây, nghỉ 0,34 giây là đủ về lý thuyết. Lab chọn 1 giây vì không cần nhanh. Khi chạy nhiều nghìn ISBN, hãy tính trước tổng thời gian và chạy theo lô qua đêm thay vì tăng tốc.
Bài rate limit API khi dùng proxy có mẫu bộ đếm tốc độ dùng chung cho nhiều luồng. Với Open Library, một luồng tuần tự đã đủ cho hầu hết nhu cầu tra cứu.
Đối soát ID, kiểu dữ liệu và giá trị thiếu trong Open Library API bằng Python
Phần này kiểm dữ liệu sau khi lấy và chỉ ra các trường thường thiếu.
Khóa chính theo tầng
Bảng Work dùng khóa /works/...W. Bảng Edition dùng khóa /books/...M và giữ cột work_key trỏ lên Work. ISBN là thuộc tính của Edition, có thể có nhiều ISBN cho một Edition: một ISBN 10 và một ISBN 13.
Lab đếm 40 dòng Work và 40 khóa khác nhau. Khi gộp nhiều truy vấn, cùng một Work có thể xuất hiện ở nhiều truy vấn. Khử trùng theo khóa Work trước khi ghi.
Trường thường thiếu
Trong 40 Work, 1 Work không có first_publish_year và 2 Work không có ISBN nào. cover_edition_key trống ở vài Work không có ảnh bìa. author_name có thể là mảng rỗng.
Dùng dict.get với giá trị mặc định cho mọi trường. Đừng giả định trường nào cũng có, kể cả tiêu đề, vì catalog do cộng đồng đóng góp.
Đối soát số lượng
numFound là 65, hai trang lấy 40 Work. Khi lấy hết bốn trang, số dòng phải bằng 65 nếu numFoundExact là true và catalog không đổi giữa chừng. Lệch một hai dòng có thể do Work mới được thêm hoặc gộp.
Ghi numFound, số dòng nhận và số khóa khác nhau sau mỗi lần chạy. Ba con số đủ để biết dữ liệu có thiếu trang hay không.
Kiểu dữ liệu
first_publish_year là số nguyên. edition_count là số nguyên. isbn, author_name và language là mảng chuỗi. publish_date trong Edition là chuỗi tự do như October 1, 1988, không phải định dạng ngày chuẩn.
Không parse publish_date thành ngày trừ khi cần. Nếu cần năm, trích bốn chữ số đầu tiên bằng biểu thức chính quy và giữ chuỗi gốc bên cạnh.
Tên tác giả không chuẩn
Kết quả thứ hai ghi tác giả là Johnson, David, theo dạng họ trước tên. Kết quả đầu ghi Ari Luotonen theo dạng tên trước họ. Catalog nhập từ nhiều nguồn nên định dạng tên không thống nhất.
Nếu cần nối theo tác giả, dùng khóa tác giả /authors/...A có trong Work, không dùng chuỗi tên. Bài này chỉ ghi tác giả đầu tiên để hiển thị.
Bản ghi rác từ dữ liệu nguồn
Ca ISBN 9780000000000 cho thấy catalog có bản ghi mang ISBN giả lấy từ MARC của thư viện. Bản ghi đó được tạo ngày 08/12/2022, có trường source_records trỏ về bốn file MARC.
Ngoài kiểm checksum, nên đánh dấu các ISBN có mẫu đáng ngờ như toàn số 0. Khi phát hiện, ghi chú vào bảng thay vì xóa, để người duyệt quyết định.
Phân bố trạng thái ebook
Bảng 40 Work có 23 no_ebook, 11 borrowable, 5 printdisabled và 1 unclassified. Hơn một nửa số Work không có bản điện tử nào. Con số này hợp lý với sách kỹ thuật về proxy server xuất bản cuối thập niên 1990.
Khi báo cáo, nên ghi rõ trạng thái là tại thời điểm lấy. Trạng thái mượn có thể đổi khi Internet Archive số hóa thêm sách hoặc thay đổi chính sách.
Giữ URL nguồn cho từng dòng
File 284_works.csv có cột source_url dạng https://openlibrary.org/works/OL2729319W. Ai đọc bảng cũng mở được trang gốc để kiểm. Đây là bằng chứng xuất xứ tối thiểu khi dữ liệu đi qua nhiều tay.
Bài JSON và CSV khi crawl dữ liệu bàn khi nào giữ thêm JSON thô. Với Open Library, JSON thô của Edition hữu ích vì có nhiều trường không vào CSV.
Lưu kết quả, giới hạn request và khi nào Open Library API bằng Python cần proxy
Phần cuối bàn chuyện lưu trữ, bộ nhớ đệm và vị trí của proxy.
Cache response
Trang API khuyến khích cache response khi có thể. Metadata sách ít thay đổi. Lưu JSON của mỗi Work và Edition theo khóa, lần sau kiểm cache trước khi gọi API.
Cache đơn giản nhất là thư mục file JSON đặt tên theo khóa. Kèm thời điểm lấy để biết khi nào cần làm mới. Với sách, làm mới mỗi tháng là thừa đủ.
Khi nào chuyển sang dump
Khi danh sách cần tra vượt vài chục nghìn ISBN, dump hàng tháng nhanh hơn và đúng chính sách hơn API. Dump là các file nén lớn, xử lý được bằng Python dòng theo dòng mà không cần nạp hết vào bộ nhớ.
Ghi nhật ký mỗi lần chạy
Mỗi lần chạy, ghi truy vấn, numFound, numFoundExact, số Work nhận, số Work mới so với lần trước, số ISBN bị loại vì sai checksum và tổng thời gian. Bảy con số này giúp phát hiện lần chạy bất thường mà không phải mở dữ liệu.
Khi số ISBN bị loại tăng đột ngột, đó thường là dấu hiệu file đầu vào bị lỗi định dạng, ví dụ bảng tính đã tự đổi ISBN thành số khoa học. Kiểm đầu vào trước khi đổ lỗi cho API.
Proxy không phải cách tăng giới hạn
Open Library ghi rõ không phân tán request qua nhiều IP. Mức 3 request mỗi giây gắn với việc định danh, không gắn với số IP. Proxy xoay để vượt giới hạn là đi ngược chính sách.
Lab đặt proxy ở tầng tải
Lab gọi search.json với fields=key và limit=1 qua proxy HTTP có xác thực và proxy SOCKS5 cục bộ.
Cách gọi |
Kết quả |
Giây |
Proxy thấy gì |
|---|---|---|---|
Proxy HTTP |
200 |
1,414 |
CONNECT openlibrary.org:443 |
SOCKS5h |
200 |
1,384 |
Tên miền openlibrary.org, cổng 443 |
Proxy HTTP, sai mật khẩu |
ProxyError |
0,018 |
auth_ok false, Open Library không nhận request |
Thời gian qua proxy gần bằng gọi trực tiếp vì phần lớn thời gian là phía server. Proxy không thấy truy vấn q vì HTTPS mã hóa đường dẫn.
Khi nào cần proxy thật
Proxy cần khi máy chạy script nằm sau tường lửa chỉ cho ra Internet qua proxy, hoặc khi thư viện, trường học cần một IP thoát cố định để quản lý. Bài Web Scraping proxy là gì phân biệt các vai trò của proxy. Với Open Library, vai trò duy nhất hợp lý là đường đi mạng.
Mật khẩu proxy có ký tự đặc biệt cần mã hóa URL. Bài định dạng proxy có bảng chuyển đổi giữa ip:port:user:pass và URL.
Nếu tổ chức của anh em cần một IP thoát cố định cho máy chủ tra cứu catalog, proxy tĩnh phù hợp hơn proxy xoay. ProxyVN có proxy dân cư tĩnh, datacenter, 4G và proxy xoay qua HTTP hoặc SOCKS5. Anh em có thể mua proxy uy tín tại trang chủ ProxyVN rồi khai báo vào requests như lab.
Giới hạn suy luận của bài
Số đo đến từ một máy ở Việt Nam ngày 29/10/2026, User-Agent có email giả. Thời gian phản hồi 1 tới 2 giây là của thời điểm đó. Số Edition 161 và numFound 65 sẽ thay đổi khi catalog được cập nhật.
Lab chưa đo ngưỡng 1 hay 3 request mỗi giây bằng cách gửi nhanh, vì không muốn tạo tải. Chưa thử dump. Proxy trong lab là proxy cục bộ, chưa thử proxy thương mại.
Checklist Open Library API bằng Python
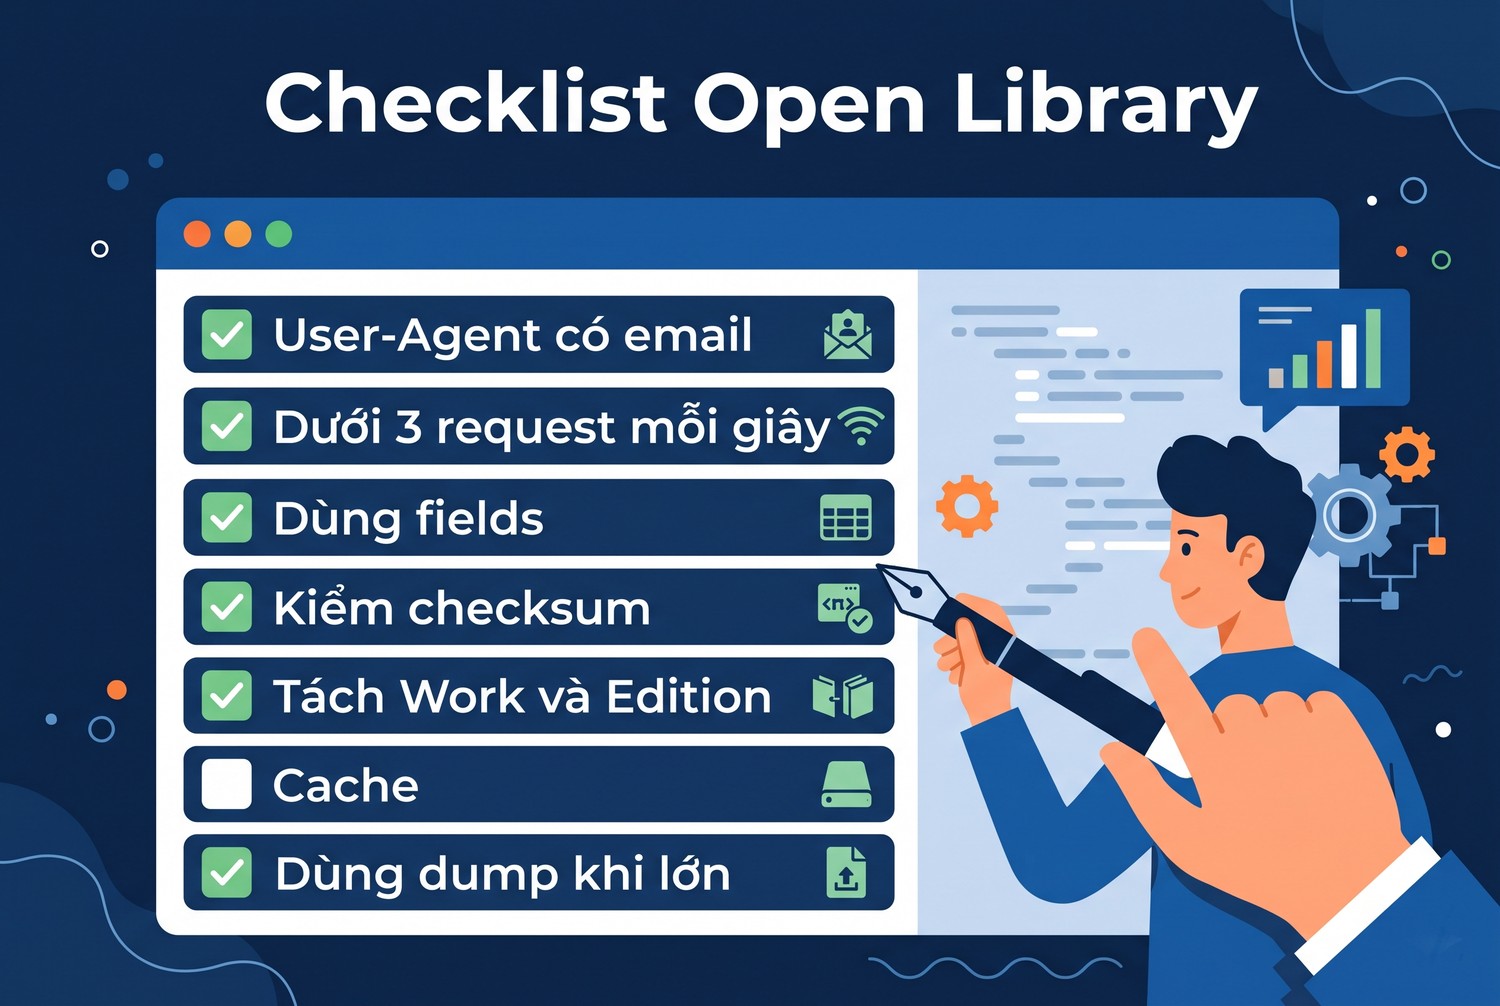
Checklist Open Library
- Đặt User-Agent có tên ứng dụng và email liên hệ.
- Giữ dưới 3 request mỗi giây, một luồng là đủ.
- Dùng fields để chỉ lấy trường cần.
- Kiểm checksum ISBN trước khi tra.
- Khóa Work cho tác phẩm, khóa Edition cho ấn bản.
- Không khớp theo tiêu đề hay chuỗi tên tác giả.
- Cache response, làm mới theo tháng.
- Vượt vài chục nghìn ISBN thì dùng dump.
Câu hỏi thường gặp về Open Library API bằng Python
Không đặt User-Agent thì sao?
Request vẫn chạy nhưng chỉ được 1 request mỗi giây. Gọi nhiều lần mỗi phút mà không định danh dễ bị giới hạn hoặc chặn.
Search API trả Work hay Edition?
Trả Work. Mỗi Work kèm edition_count và danh sách ISBN gộp. Muốn chi tiết từng Edition, gọi /works/{id}/editions.json.
Vì sao tiêu đề Work và Edition khác nhau?
Work và Edition là hai bản ghi riêng, nhập từ nguồn khác nhau. Lab thấy Fantastic Mr Fox ở Work và Fantastic Mr. Fox ở Edition.
ISBN sai có trả lỗi 404 không?
Không phải lúc nào cũng vậy. Lab thấy ISBN sai checksum vẫn khớp một bản ghi nhập từ dữ liệu thư viện. Kiểm checksum trước.
Có tải được sách điện tử qua API không?
Bài này không làm việc đó. Trường ebook_access chỉ cho biết trạng thái. Bản cho mượn có điều kiện riêng của Internet Archive.
Có nên dùng proxy xoay để tra nhanh hơn?
Không. Open Library ghi rõ không phân tán request qua nhiều IP. Cần nhiều dữ liệu thì dùng dump hàng tháng.
Open Library API bằng Python và những điều cần nhớ
Open Library API bằng Python cho anh em metadata sách qua Search API, và việc quan trọng nhất là tách đúng Work với Edition. Lab ngày 29/10/2026 đi từ một ISBN tới Edition rồi tới Work có 161 Edition, và phát hiện ISBN sai checksum vẫn khớp bản ghi rác. Định danh bằng User-Agent, giữ dưới 3 request mỗi giây, cache response. Cần IP thoát cố định cho máy chủ chạy Open Library API bằng Python, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


