
IMDb datasets bằng Python: đọc TSV, nối tconst và kiểm \N
IMDb datasets bằng Python là cách đọc bộ tệp TSV mà IMDb công bố cho mục đích cá nhân và phi thương mại, rồi nối các bảng theo khóa tconst và nconst. Đây là dữ liệu nguồn có cấu trúc, khác hẳn việc scrape giao diện trang phim. ProxyVN chạy thật ngày 29/10/2026: tệp ratings có 1.726.690 dòng đọc xong trong 2,02 giây bằng stream, 300.000 dòng đầu của title.basics có 165.278 phim, và 48.565 phim trong số đó chưa có điểm đánh giá.
IMDb datasets bằng Python: mục tiêu dữ liệu, quyền và phạm vi truy cập
Phần đầu chốt dữ liệu cần dùng, điều kiện cấp phép và lý do bài này không đụng tới trang HTML của IMDb.
Dữ liệu nằm ở đâu
IMDb công bố bảy tệp nén trên một máy chủ tệp tĩnh: name.basics, title.akas, title.basics, title.crew, title.episode, title.principals và title.ratings. Mỗi tệp là một bảng TSV nén gzip, mã hóa UTF-8. Trang mô tả bộ dữ liệu liệt kê cột của từng tệp.
Lab gọi trang mô tả và thấy địa chỉ cũ chuyển hướng 301 sang data.imdb.com. Tệp dữ liệu nằm ở datasets.imdbws.com. Không có API truy vấn, không có tham số lọc. Anh em tải tệp về rồi tự xử lý.
Điều kiện sử dụng là phi thương mại
Trang mô tả ghi rõ dữ liệu dành cho khách hàng dùng cho mục đích cá nhân và phi thương mại. Trang cũng yêu cầu người dùng đọc điều khoản cấp phép phi thương mại và trang bản quyền rồi tự xác minh việc tuân thủ.
Bài này dùng dữ liệu để minh họa kỹ thuật xử lý tệp, không đưa dữ liệu vào sản phẩm. Nếu anh em định dùng trong ứng dụng có doanh thu, hãy đọc câu hỏi về dùng dữ liệu IMDb trong phần mềm và liên hệ IMDb về giấy phép thương mại trước khi triển khai.
Kỹ thuật trong bài chạy được với mọi mục đích, nhưng quyền dùng dữ liệu thì không. Xác minh giấy phép trước, viết code sau.
Ranh giới với scrape giao diện
Scrape trang phim IMDb là bài toán khác: trang HTML thay đổi bố cục, có chống bot, và điều kiện sử dụng trang web có thể khác điều kiện của bộ dữ liệu. Bài Web Scraping proxy là gì giải thích khi nào scrape là lựa chọn duy nhất.
Với IMDb, bộ TSV đã chứa tiêu đề, năm, thời lượng, thể loại, điểm và số lượt bình chọn. Nếu nhu cầu nằm trong các cột đó, không có lý do mở trang HTML nào. Bài này không có dòng code nào tải trang phim.
Những cột không có trong bộ dữ liệu
Bộ TSV không có tóm tắt nội dung, ảnh poster, doanh thu phòng vé, bình luận người xem hay thông tin phát trực tuyến. Đó là các trường thường khiến người ta nghĩ tới scrape.
Trước khi tính tới việc lấy thêm từ giao diện, hãy hỏi lại dự án có thật cần các trường đó không. Phần lớn báo cáo thống kê phim chỉ cần những gì bộ TSV đã có.
Bảy tệp và quan hệ giữa chúng
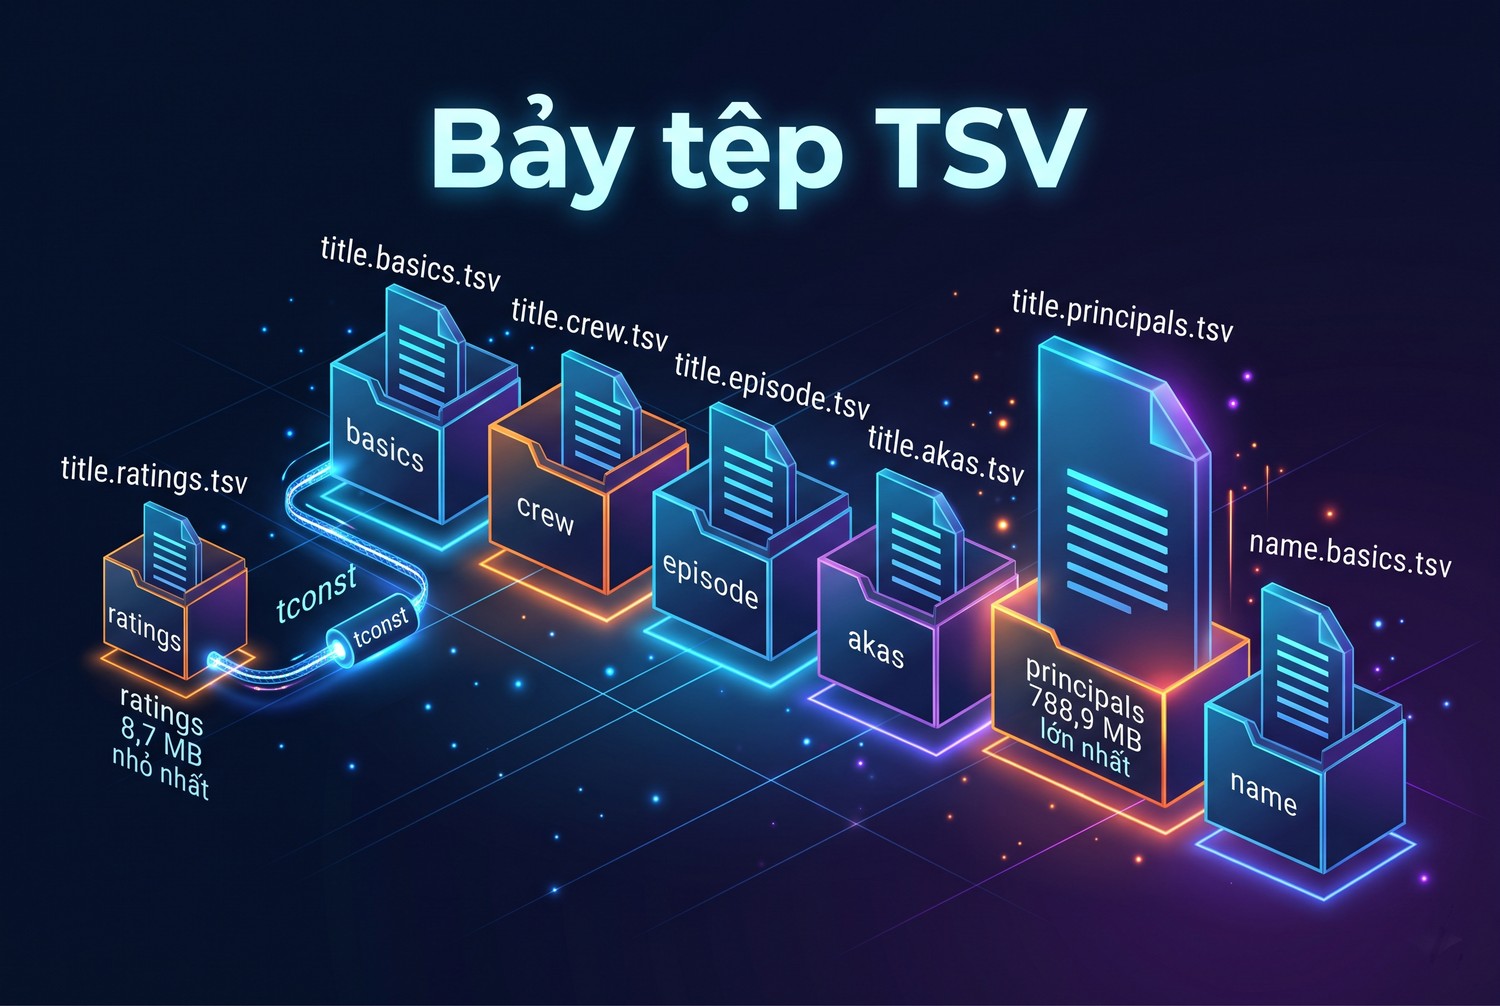
Bảy tệp TSV
title.basics là bảng trung tâm, mỗi dòng một tiêu đề với khóa tconst. title.ratings nối vào bằng tconst. title.akas chứa tên phim theo vùng, nối bằng titleId cũng là tconst. title.episode nối tập phim với phim bộ cha.
name.basics là bảng người, khóa nconst. title.principals và title.crew nối tiêu đề với người qua cặp tconst và nconst. Hiểu sơ đồ này trước giúp anh em chỉ tải đúng tệp cần, không tải cả bảy tệp nặng gần 2 GB nén.
Ai dùng bộ dữ liệu này
Sinh viên học phân tích dữ liệu dùng bộ IMDb vì nó lớn, sạch vừa phải và có nhiều kiểu quan hệ. Người viết blog phim dùng nó để kiểm năm phát hành hay thời lượng. Người làm hệ gợi ý phim thử nghiệm thuật toán trên điểm và thể loại.
Cả ba nhóm đều có nhu cầu cá nhân hoặc học tập, khớp với điều kiện phi thương mại. Khi dự án chuyển sang thương mại, câu hỏi giấy phép phải được trả lời lại từ đầu.
Những gì bài không làm
Bài không tải trọn các tệp lớn, không dựng cơ sở dữ liệu đầy đủ và không scrape trang nào của IMDb. Bài không tư vấn pháp lý về giấy phép. Bài cũng không dùng proxy để tải tệp nhanh hơn, vì máy chủ tệp không có giới hạn theo IP nào cần vượt.
IMDb datasets bằng Python: đọc bộ TSV theo điều kiện sử dụng, nối khóa tconst và nconst
Phần này đi vào cấu trúc tệp, khóa nối và ký hiệu giá trị thiếu.
Kích thước và thời điểm cập nhật
Lab gửi request HEAD cho từng tệp để lấy kích thước và Last-Modified mà không tải nội dung. Kết quả ngày 29/10/2026:
Tệp |
MB nén |
Last-Modified (GMT) |
|---|---|---|
title.ratings |
8,7 |
28/10/2026 12:35 |
title.episode |
55,2 |
29/10/2026 00:35 |
title.crew |
83,8 |
29/10/2026 00:36 |
title.basics |
229,4 |
29/10/2026 00:35 |
name.basics |
312,1 |
29/10/2026 00:36 |
title.akas |
519,7 |
29/10/2026 00:36 |
title.principals |
788,9 |
29/10/2026 00:36 |
Tổng gần 2 GB nén. Trang mô tả ghi dữ liệu được làm mới hàng ngày, và Last-Modified khớp với điều đó. Mọi tệp đều trả Accept-Ranges: bytes và ETag.
tconst và nconst
tconst là mã tiêu đề dạng tt kèm số, ví dụ tt0111161. nconst là mã người dạng nm kèm số. Hai mã này ổn định và cũng là mã xuất hiện trong URL trang IMDb, nên dùng làm khóa nối và khóa tham chiếu.
Đừng nối bằng tên phim hay tên người. Nhiều phim trùng tên, nhiều người trùng tên. Lab nối title.basics với title.ratings chỉ bằng tconst.
Ký hiệu \N cho giá trị thiếu
Trang mô tả ghi chuỗi \N biểu thị trường thiếu hoặc null. Đây là chuỗi hai ký tự gồm dấu gạch chéo ngược và chữ N, không phải chuỗi rỗng. Đọc bằng pandas mà không khai báo na_values thì \N sẽ bị coi là văn bản.
Lab đếm \N trong 300.000 dòng đầu của title.basics. endYear thiếu ở 286.476 dòng, hợp lý vì chỉ phim bộ mới có năm kết thúc. runtimeMinutes thiếu ở 71.318 dòng. genres thiếu ở 31.505 dòng. startYear thiếu ở 306 dòng.
Cột mảng nằm trong một ô
genres chứa tối đa ba thể loại ngăn bằng dấu phẩy, ví dụ Drama,Crime. knownForTitles trong name.basics chứa danh sách tconst ngăn bằng dấu phẩy. directors và writers trong title.crew cũng vậy.
Khi cần đếm theo thể loại, tách cột ra bảng riêng. Đừng tìm chuỗi Drama trong cột genres, vì sẽ khớp nhầm Docudrama nếu sau này có thể loại như vậy.
titleType phân loại tiêu đề
title.basics trộn phim lẻ, phim ngắn, phim bộ, tập phim, video và trò chơi. Lab đếm trong 300.000 dòng đầu: 165.278 movie, 61.741 short, 20.881 tvMovie, 19.783 tvSeries, 18.759 video, 6.691 tvEpisode, còn lại là tvMiniSeries, videoGame, tvSpecial và tvShort.
Lọc titleType trước khi phân tích. Báo cáo về phim chiếu rạp mà không lọc sẽ lẫn cả tập phim truyền hình và trò chơi điện tử.
Dữ liệu nguồn khác dữ liệu hiển thị
Bộ TSV là bản xuất có cấu trúc, cập nhật theo ngày. Trang web hiển thị dữ liệu theo thời gian thực và có thể có trường bổ sung. Điểm đánh giá trên trang có thể lệch nhẹ so với tệp ratings của ngày hôm trước.
Khi báo cáo, ghi rõ nguồn là tệp TSV và ngày Last-Modified. Đừng trộn số lấy từ trang web với số lấy từ tệp trong cùng một bảng.
Chuẩn bị truy vấn, ID và phiên bản khi dùng IMDb datasets bằng Python
Không có API nghĩa là không có truy vấn theo nghĩa thông thường. Phần chuẩn bị ở đây là chọn tệp, khóa phiên bản dữ liệu và chọn cách đọc.
Chọn tệp theo câu hỏi
Câu hỏi về điểm phim cần title.basics và title.ratings. Câu hỏi về đạo diễn cần thêm title.crew và name.basics. Câu hỏi về tên phim ở Việt Nam cần title.akas với cột region bằng VN.
Lab chỉ cần hai tệp nhỏ nhất liên quan: ratings 8,7 MB và basics 229,4 MB. Không tải title.principals nặng gần 800 MB vì câu hỏi không cần tới.
Không có token, không có phiên bản API
Tải tệp không cần đăng nhập hay khóa. Không có phiên bản API vì không có API. Phiên bản thực tế là ngày dữ liệu, xác định bằng Last-Modified và ETag của từng tệp.
Ghi Last-Modified và ETag vào nhật ký mỗi lần xử lý. Đây là cách duy nhất để biết kết quả của anh em sinh ra từ bản dữ liệu ngày nào.
Chọn cột ngay khi đọc
Mỗi dòng basics có chín cột, nhưng báo cáo điểm phim chỉ cần tconst, titleType, primaryTitle, startYear, runtimeMinutes và genres. Bỏ các cột còn lại ngay trong vòng lặp giúp danh sách trong bộ nhớ nhỏ đi đáng kể.
Với pandas, tham số usecols làm việc này. Với DuckDB, chỉ ghi cột cần trong câu SELECT. Thói quen chọn cột sớm quan trọng với bộ dữ liệu IMDb vì các tệp lớn có hàng chục triệu dòng.
Kiểm thay đổi trước khi tải
Request HEAD cho biết ETag hiện tại. Nếu ETag giống lần trước, tệp chưa đổi và không cần tải lại. Lab thấy ETag của ratings có dạng chuỗi hash kèm hậu tố -2, của principals kèm -95, gợi ý tệp được tải lên theo nhiều phần.
Có thể dùng If-None-Match với ETag cũ để server trả 304 nếu không đổi. Lab chưa thử 304, chỉ thử HEAD. Cả hai cách đều tránh tải lại hàng trăm MB vô ích.
Chọn cách đọc: stream hay tải về
Tải về đĩa rồi đọc là cách dễ nhất và phù hợp khi xử lý nhiều lần. Stream là đọc trực tiếp từ kết nối HTTP, giải nén từng khối và xử lý từng dòng, không lưu tệp. Stream phù hợp khi chỉ cần lướt một lần hoặc chỉ cần phần đầu tệp.
Lab dùng stream để tránh lưu gần 240 MB lên đĩa. Khi chạy thật hàng ngày, tải về một lần và đọc nhiều lần thường tiết kiệm hơn.
Thư viện cần có
Lab chỉ dùng requests 2.34.2 và thư viện chuẩn gzip, io, csv trên Python 3.12.10. pandas và polars đọc TSV nhanh hơn với tệp lớn, nhưng cần khai báo đúng dấu phân cách, na_values và tắt xử lý dấu nháy.
Bài DuckDB xử lý dữ liệu crawl JSONL giới thiệu DuckDB, công cụ cũng đọc trực tiếp được tệp TSV nén. Với join hàng triệu dòng, DuckDB thường dễ dùng hơn viết vòng lặp Python.
Đọc thẳng bằng DuckDB
DuckDB đọc được tệp TSV nén trực tiếp bằng hàm read_csv với tham số delim là ký tự tab và nullstr là \N. Một câu SQL có thể nối basics với ratings mà không cần nạp vào Python.
Cách này nhanh hơn vòng lặp Python với tệp lớn và tốn ít bộ nhớ hơn pandas. Lab chưa chạy DuckDB với dữ liệu IMDb, nên anh em cần thử trên tệp nhỏ trước để kiểm khai báo kiểu cột.
Tắt xử lý dấu nháy
Một số tiêu đề chứa dấu nháy kép. Bộ đọc CSV mặc định coi dấu nháy là ký tự bao trường và có thể nuốt nhiều dòng vào một ô. Lab tách dòng bằng split theo ký tự tab, không dùng bộ đọc CSV, nên không gặp vấn đề này.
Với pandas, đặt quoting=3 tương ứng csv.QUOTE_NONE. Với DuckDB, khai báo quote là chuỗi rỗng. Bỏ qua bước này là nguồn lỗi lệch cột phổ biến nhất với bộ dữ liệu IMDb.
Thu dữ liệu theo lô và stream với IMDb datasets bằng Python
Bộ dữ liệu không phân trang. Thay vào đó, anh em đọc theo dòng và chia lô theo số dòng. Phần này chạy stream thật và đo thời gian.
Script stream tệp TSV nén
1,7 triệu dòng trong 2 giây
import gzip, io, time, requests
B = "https://datasets.imdbws.com/"
UA = {"User-Agent": "ProxyVN-lab/1.0 (lab@example.com)"}

def stream_tsv(name, max_rows=None):
    r = requests.get(B + name + ".tsv.gz", headers=UA, stream=True, timeout=60)
    r.raw.decode_content = False
    rd = io.TextIOWrapper(gzip.GzipFile(fileobj=r.raw), encoding="utf-8", newline="")
    header = rd.readline().rstrip("\n").split("\t")
    rows = []
    for i, line in enumerate(rd):
        if max_rows and i >= max_rows:
            break
        rows.append(dict(zip(header, line.rstrip("\n").split("\t"))))
    r.close()
    return header, rows

t = time.perf_counter()
_, ratings = stream_tsv("title.ratings")
print(len(ratings), round(time.perf_counter() - t, 2))
Kết quả stream
Tệp |
Cách đọc |
Số dòng |
Giây |
|---|---|---|---|
title.ratings |
Đọc hết |
1.726.690 |
2,02 |
title.basics |
300.000 dòng đầu rồi đóng |
300.000 |
0,89 |
Tệp ratings có ba cột tconst, averageRating và numVotes. Tệp basics có chín cột tconst, titleType, primaryTitle, originalTitle, isAdult, startYear, endYear, runtimeMinutes và genres. Thời gian đo trên đường truyền ở Việt Nam, bao gồm tải và giải nén.
Đóng kết nối sớm khi đủ dòng
Với basics, script dừng sau 300.000 dòng và gọi r.close(). Phần còn lại của tệp không bị tải. Đây là cách xem nhanh cấu trúc và chất lượng dữ liệu trước khi quyết định tải trọn.
Lưu ý 300.000 dòng đầu không phải mẫu ngẫu nhiên. Tệp sắp theo tconst, nên phần đầu là các tiêu đề có mã nhỏ, phần lớn là phim cũ. Đừng suy ra tỷ lệ cho toàn bộ dữ liệu từ phần đầu.
Vì sao decode_content đặt là False
Server có thể gửi tệp gzip kèm header nén ở tầng HTTP. Đặt decode_content False để requests không tự giải nén ở tầng HTTP, rồi GzipFile tự giải nén nội dung tệp. Nếu để requests giải nén trước, GzipFile sẽ nhận dữ liệu đã giải nén và báo lỗi.
Bài gzip và brotli khi web scraping giải thích khác biệt giữa nén ở tầng truyền và tệp nén. Với IMDb, tệp tự nó đã là gzip.
Chia lô cho tệp lớn
Với title.principals gần 800 MB nén, đọc hết vào danh sách Python sẽ tốn nhiều GB bộ nhớ. Thay vào đó, đọc từng khối, ví dụ 100.000 dòng, xử lý rồi ghi ra tệp kết quả trước khi đọc khối sau.
Cách khác là lọc ngay khi đọc. Nếu chỉ cần dòng có tconst nằm trong danh sách phim đã chọn, kiểm tconst ngay trong vòng lặp và bỏ dòng không cần. Bộ nhớ khi đó chỉ chứa phần cần giữ.
Tải lại khi đứt giữa chừng
Máy chủ trả Accept-Ranges: bytes, nghĩa là hỗ trợ tải tiếp từ vị trí byte. Khi tải về đĩa và bị đứt, gửi header Range bắt đầu từ số byte đã có. Lab chưa thử tải tiếp, chỉ ghi nhận header.
Với stream, đứt giữa chừng thì phải đọc lại từ đầu, vì không thể giải nén gzip từ giữa tệp. Đây là lý do tải về đĩa an toàn hơn cho tệp lớn trên mạng không ổn định.
Đối soát ID, kiểu dữ liệu và giá trị thiếu trong IMDb datasets bằng Python
Phần này nối hai bảng, đếm phim thiếu điểm và kiểm kiểu dữ liệu.
Nối title.basics với title.ratings
Lab dựng dict từ ratings với khóa tconst, rồi duyệt các phim trong basics và tra dict. Với 1,7 triệu dòng ratings, dict nằm gọn trong bộ nhớ máy thường.
Trong 165.278 phim ở 300.000 dòng đầu, 116.713 phim có điểm và 48.565 phim không có. Khoảng 29 phần trăm phim không có dòng nào trong ratings. Đây là phim chưa đủ lượt bình chọn để có điểm hiển thị.
Phim không có điểm khác phim điểm thấp
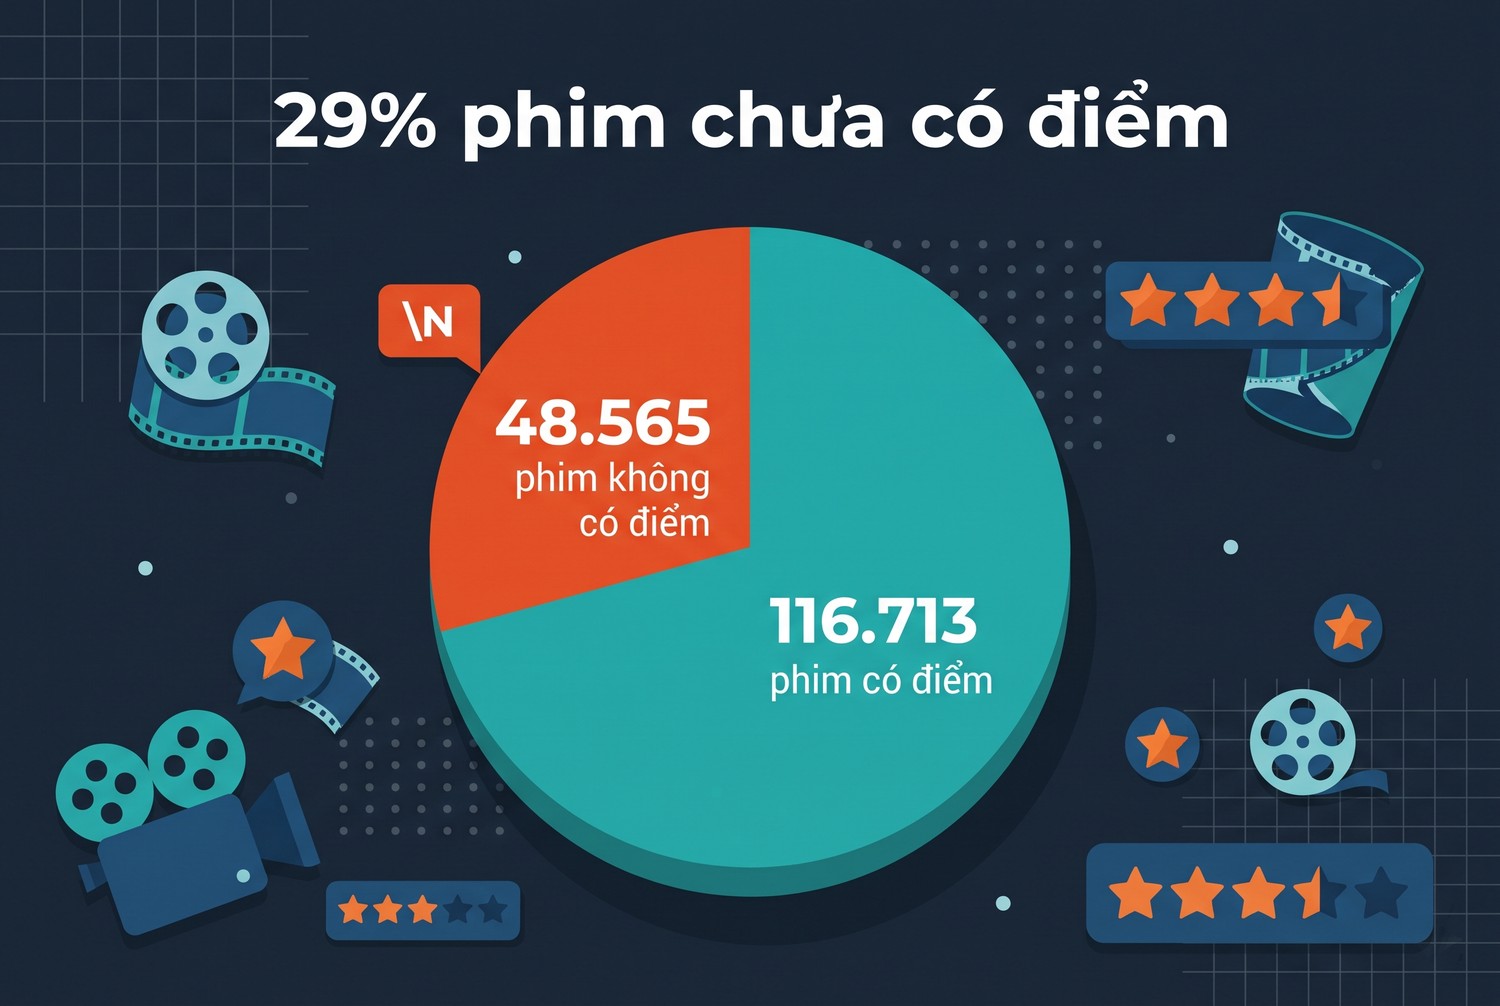
29% phim chưa có điểm
Phim thiếu điểm không có nghĩa là phim tệ. Nó chỉ là phim ít người bình chọn. Khi xếp hạng, đừng coi thiếu điểm là điểm 0.
Lab ghi riêng hai nhóm. Nhóm có điểm vào tệp 285_movies_ratings.csv. Nhóm không có điểm được đếm để báo cáo, không ghi điểm giả.
Tên gốc và tên phổ biến
title.basics có primaryTitle là tên phổ biến dùng để quảng bá và originalTitle là tên gốc bằng ngôn ngữ phát hành. Với phim nước ngoài, hai tên thường khác nhau.
Khi hiển thị cho người đọc Việt Nam, có thể cần tên phát hành tại Việt Nam từ title.akas. Ghi rõ cột nào được dùng để tránh người đọc tưởng hai phim khác nhau.
Lọc theo số lượt bình chọn
Điểm trung bình của phim ít lượt bình chọn dao động mạnh. Lab lọc numVotes từ 10.000 trở lên trước khi xếp hạng. Trong phần dữ liệu đã đọc, phim đứng đầu là The Shawshank Redemption 9,3 điểm với 3.258.917 lượt. Tiếp theo là The Godfather 9,2 điểm, The Chaos Class 9,1 điểm với 46.926 lượt, Ramayana: The Legend of Prince Rama 9,1 điểm và 12 Angry Men 9,0 điểm.
Danh sách này chỉ đúng với 300.000 dòng đầu, không phải bảng xếp hạng toàn bộ. Nó được đưa vào để kiểm phép nối cho kết quả hợp lý, vì các phim kinh điển phải xuất hiện.
Kiểu dữ liệu sau khi đọc
Mọi trường đọc từ TSV đều là chuỗi. averageRating cần đổi sang số thực, numVotes sang số nguyên, startYear và runtimeMinutes sang số nguyên sau khi xử lý \N. isAdult là chuỗi 0 hoặc 1.
Lab kiểm startYear: mọi giá trị khác \N đều là chuỗi chữ số. Không có năm sai định dạng trong phần đã đọc. Phép kiểm này rẻ và nên chạy mỗi lần, vì một lỗi định dạng có thể làm hỏng cả cột khi ép kiểu.
Tập phim nối về phim bộ cha
title.episode có các cột chính: tconst của tập, parentTconst của phim bộ, seasonNumber và episodeNumber. Tập phim cũng có dòng riêng trong basics với titleType là tvEpisode.
Khi đếm phim bộ, đừng đếm cả tập. Lọc tvSeries và tvMiniSeries trong basics, rồi dùng title.episode để đếm số tập của từng bộ. Số mùa và số tập có thể là \N với dữ liệu chưa đầy đủ.
Báo cáo trường thiếu
Báo cáo trường thiếu nên có tên cột, số dòng thiếu và tỷ lệ trên tổng số dòng đã đọc. Với basics, endYear thiếu 95 phần trăm là bình thường, runtimeMinutes thiếu 24 phần trăm cần chú ý nếu phân tích thời lượng.
Bài Pandera kiểm tra dữ liệu crawl có cách viết quy tắc kiểm tự động cho từng cột. Với IMDb, quy tắc như startYear phải là bốn chữ số hoặc \N rất dễ viết.
Giữ xuất xứ cho từng kết quả
Mỗi tệp kết quả nên ghi kèm tên tệp nguồn, Last-Modified, ETag và số dòng đã đọc. Kết quả không có xuất xứ sẽ không so sánh được giữa hai ngày.
tconst là tham chiếu chung. Ai muốn kiểm một dòng có thể ghép thành URL trang phim để xem, nhưng việc kiểm bằng mắt đó khác với tải trang tự động.
Lưu kết quả, giới hạn request và khi nào IMDb datasets bằng Python cần proxy
Phần cuối bàn chuyện lưu trữ, nhịp tải và vị trí của proxy với một nguồn chỉ có tệp tĩnh.
Lưu kết quả dạng Parquet hoặc CSV
CSV dễ mở và chia sẻ. Parquet nhỏ hơn và giữ kiểu dữ liệu. Với bảng nối phim và điểm hơn 100.000 dòng, Parquet đọc nhanh hơn nhiều khi phân tích lại.
Bài JSON và CSV khi crawl dữ liệu bàn tiêu chí chọn định dạng. Lab ghi CSV vì mục tiêu là minh họa.
Tải một lần mỗi ngày là đủ
Dữ liệu làm mới hàng ngày. Tải nhiều lần trong ngày không mang lại dữ liệu mới, chỉ tạo tải lên máy chủ. Kiểm ETag bằng HEAD, chỉ tải khi ETag đổi.
Không có giới hạn tốc độ công bố cho máy chủ tệp. Nhưng tải hàng chục lần gần 2 GB mỗi ngày vẫn là hành vi lãng phí và có thể bị chặn. Một lần mỗi ngày là nhịp hợp lý.
Ghi nhật ký mỗi lần xử lý
Nhật ký nên có ngày chạy, tên từng tệp, ETag, Last-Modified, số dòng đọc, số phim nối được và thời gian. So sánh nhật ký hai ngày liên tiếp giúp phát hiện tệp bị cắt ngắn hoặc lỗi giải nén.
Nếu số dòng ratings giảm mạnh so với hôm trước, đừng ghi đè kết quả cũ. Kiểm lại tệp, vì đó thường là dấu hiệu tải lỗi chứ không phải dữ liệu thật sự giảm.
Proxy không giải quyết câu hỏi giấy phép
Điều kiện phi thương mại gắn với việc sử dụng dữ liệu, không gắn với IP tải dữ liệu. Tải qua proxy không làm việc dùng thương mại trở nên hợp lệ. Câu hỏi giấy phép phải giải quyết bằng thỏa thuận với IMDb.
Lab đặt proxy ở tầng tải
Lab gửi HEAD cho title.ratings.tsv.gz qua proxy HTTP có xác thực và proxy SOCKS5 cục bộ.
Cách gọi |
Kết quả |
Giây |
Proxy thấy gì |
|---|---|---|---|
Proxy HTTP |
200 |
0,321 |
CONNECT datasets.imdbws.com:443 |
SOCKS5h |
200 |
0,337 |
Tên miền datasets.imdbws.com, cổng 443 |
Proxy HTTP, sai mật khẩu |
ProxyError |
gần 0 |
auth_ok false, máy chủ tệp không nhận request |
Proxy chỉ thấy tên máy và cổng. Tên tệp nằm trong đường dẫn đã mã hóa. Với tệp hàng trăm MB, băng thông của proxy quyết định thời gian tải, nên proxy chậm sẽ làm job chậm theo.
Khi nào cần proxy thật
Proxy cần khi máy chủ xử lý nằm trong mạng chỉ cho ra Internet qua proxy, hoặc khi công ty yêu cầu mọi lưu lượng ra ngoài đi qua một IP thoát cố định để kiểm soát. Cấu hình proxy cho requests và mã hóa mật khẩu có ký tự đặc biệt có trong bài định dạng proxy.
Với tệp lớn, chọn proxy có băng thông đủ và không giới hạn dung lượng quá thấp. Một lần tải basics và ratings đã khoảng 240 MB. Tải cả bảy tệp gần 2 GB mỗi ngày.
Khi mạng nội bộ bắt buộc đi qua proxy để tải tệp lớn, băng thông ổn định quan trọng hơn số lượng IP. ProxyVN có proxy dân cư tĩnh, datacenter, 4G và proxy xoay qua HTTP hoặc SOCKS5. Anh em có thể mua proxy tốc độ cao tại trang chủ ProxyVN rồi khai báo vào requests như lab.
Giới hạn suy luận của bài
Số đo đến từ một máy ở Việt Nam ngày 29/10/2026. Thời gian stream phụ thuộc đường truyền. Thống kê titleType, \N và tỷ lệ phim thiếu điểm chỉ áp dụng cho 300.000 dòng đầu của basics, không đại diện toàn bộ tệp.
Lab chưa tải trọn basics và các tệp lớn khác, chưa thử If-None-Match và Range. Bài không xác nhận quyền sử dụng dữ liệu cho bất kỳ mục đích thương mại nào. Proxy trong lab là proxy cục bộ, chưa thử proxy thương mại.
Checklist IMDb datasets bằng Python
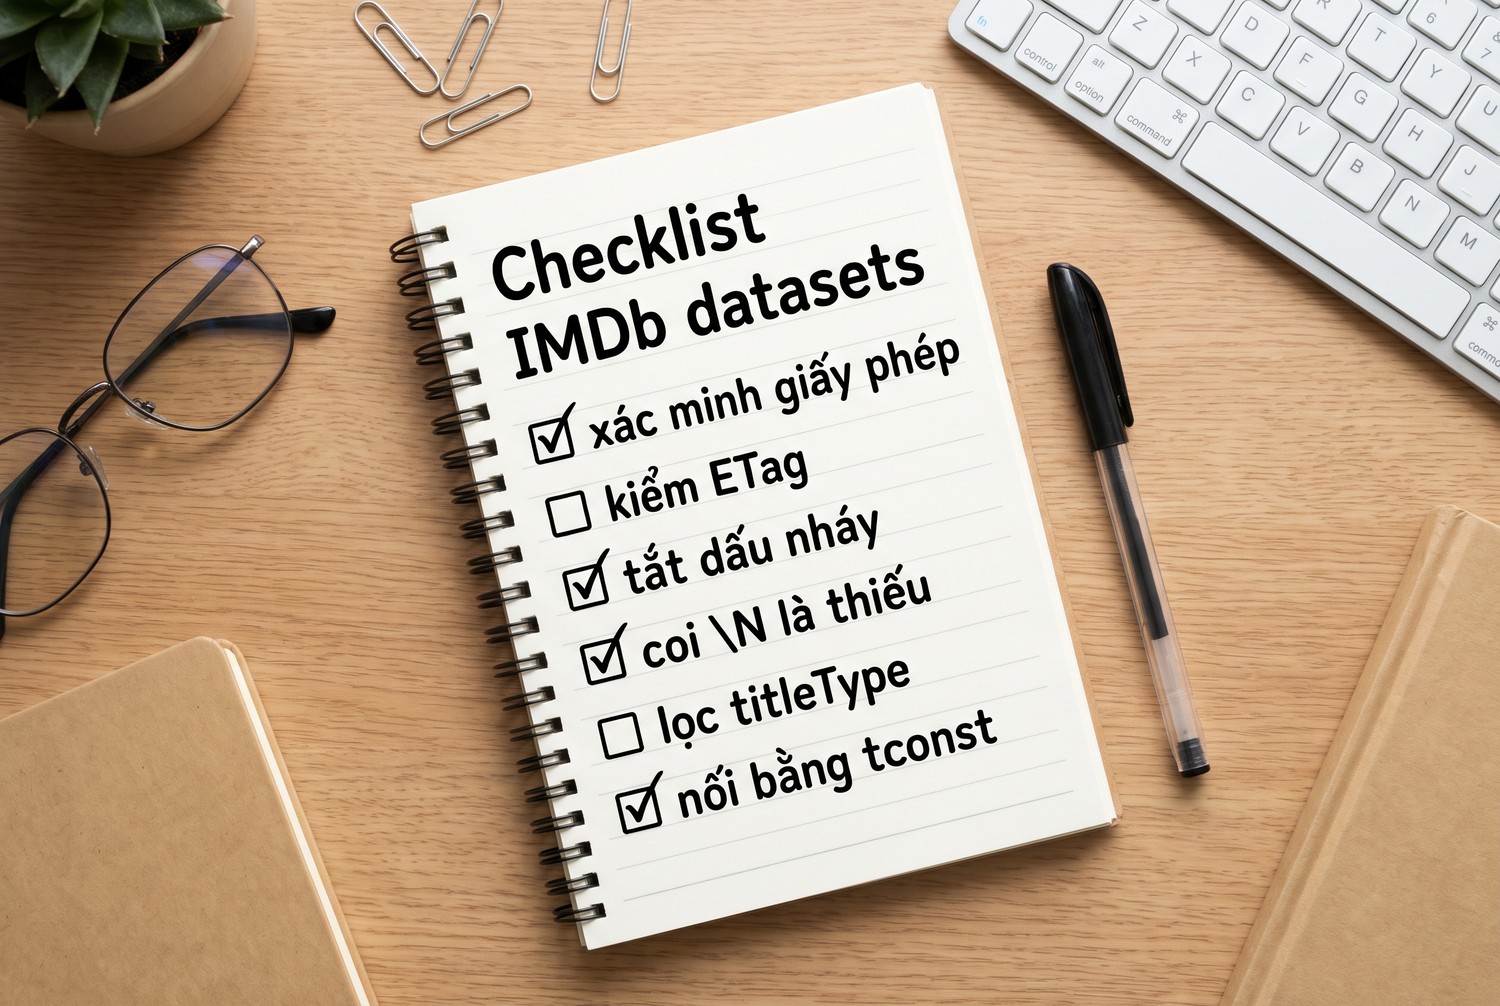
Checklist IMDb datasets
- Đọc điều kiện phi thương mại và xác minh giấy phép trước.
- Chỉ tải tệp mà câu hỏi cần.
- Kiểm ETag bằng HEAD, tải khi đổi.
- Tắt xử lý dấu nháy khi đọc TSV.
- Coi chuỗi \N là giá trị thiếu.
- Lọc titleType trước khi phân tích.
- Nối bằng tconst và nconst, không nối bằng tên.
- Phim thiếu điểm không phải điểm 0.
- Ghi Last-Modified và ETag vào nhật ký.
Câu hỏi thường gặp về IMDb datasets bằng Python
IMDb có API miễn phí không?
Bộ dữ liệu này là tệp tĩnh, không phải API. Không có tham số lọc hay phân trang. Anh em tải tệp rồi tự xử lý.
Dùng dữ liệu cho website có quảng cáo được không?
Trang mô tả ghi dữ liệu dành cho mục đích cá nhân và phi thương mại. Website có doanh thu cần liên hệ IMDb về giấy phép. Bài này không tư vấn pháp lý.
Vì sao đọc bằng pandas bị lệch cột?
Thường do dấu nháy kép trong tiêu đề. Đặt quoting bằng QUOTE_NONE và khai báo \N là giá trị thiếu.
Tệp được cập nhật lúc nào?
Trang mô tả ghi làm mới hàng ngày. Lab thấy Last-Modified của phần lớn tệp là khoảng 00:35 GMT ngày 29/10/2026.
Lấy tên phim tiếng Việt ở đâu?
Trong title.akas, lọc region bằng VN. Tệp này nặng khoảng 520 MB nén, nên lọc ngay khi đọc.
Có cần proxy để tải nhanh hơn không?
Không. Máy chủ tệp không giới hạn theo IP cần vượt. Proxy chỉ cần khi mạng của anh em bắt buộc đi qua proxy.
IMDb datasets bằng Python và những điều cần nhớ
IMDb datasets bằng Python là bài toán xử lý tệp TSV nén, không phải scrape. Lab ngày 29/10/2026 stream 1.726.690 dòng ratings trong 2,02 giây, đọc 300.000 dòng basics và nối được 116.713 phim có điểm. Xác minh giấy phép trước, coi \N là thiếu, nối bằng tconst, tải theo ETag. Cần đường mạng ổn định cho máy chủ chạy IMDb datasets bằng Python, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


