
ILOSTAT API dữ liệu lao động: nguồn, mô hình và lọc đúng chiều
ILOSTAT API dữ liệu lao động là cách lấy số thất nghiệp, việc làm theo quốc gia từ Tổ chức Lao động Quốc tế mà không cần khóa. Bài này viết cho người dựng bảng lao động cần đúng nguồn và đúng chiều. ProxyVN gọi API thật ngày 05/11/2026 với số Việt Nam, thấy lọc VN kéo cả Slovenia vào bảng, và năm 2024 có hai con số thất nghiệp khác nhau.
ILOSTAT API dữ liệu lao động: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và điểm khác với các bài dữ liệu kinh tế trong cùng nhóm.
Bài toán cần giải
Một nhóm nghiên cứu nhân sự muốn so tỷ lệ thất nghiệp Việt Nam với vài nước trong khu vực qua nhiều năm. Họ tải một bảng, thấy số đủ từ 1991 tới 2027, rồi vẽ biểu đồ. Tới lúc trích dẫn, họ phát hiện năm 2024 khác số trong một báo cáo khác, còn các năm 2025 tới 2027 chưa thể là số đo thật. Bảng trông liền mạch vì nó ghép nhiều loại số.
Đầu ra nghiệm thu
Đầu ra là dataset gồm quốc gia, chỉ tiêu, nguồn, giới tính, nhóm tuổi, thời gian, giá trị, trạng thái và ghi chú đã giải mã. Đi kèm là phép kiểm rằng bộ lọc chỉ trả đúng nước đã xin, và phép kiểm không đếm trùng các nhóm phân loại. Mỗi dòng phải cho biết số đó đến từ khảo sát hay từ mô hình.
Ranh giới với World Bank, ECB và FRED
Bài World Bank API lấy chỉ tiêu phát triển tổng hợp theo nước. Bài ECB trong cùng nhóm tập trung vào khóa SDMX, bài FRED tập trung vào số bị sửa theo thời gian. Bài này chỉ đi vào dữ liệu lao động, với hai điểm riêng: cột nguồn phân biệt khảo sát và ước tính mô hình, cùng các chiều giới tính, tuổi, ngành có nhiều hệ phân loại chồng nhau.
Không phải đánh giá thị trường lao động
Bài không nhận xét kinh tế Việt Nam tốt hay xấu, không dự báo, không so sánh chính sách. Các con số chỉ để minh họa cách đọc dữ liệu. Tỷ lệ thất nghiệp thấp cũng không tự nói lên chất lượng việc làm, vì định nghĩa và cơ cấu lao động mỗi nước khác nhau.
Phạm vi lab
Lab gọi hai dịch vụ công khai: API tại rplumber.ilo.org và điểm SDMX tại sdmx.ilo.org, không khóa, nghỉ hai giây giữa các lượt. Trang ilostat.ilo.org trả lớp kiểm tra trình duyệt với công cụ tự động, lab không vượt qua lớp đó. Vì thế mọi điều trong bài đến từ OpenAPI của dịch vụ, từ điển dữ liệu và response thật, không đến từ các trang hướng dẫn trên ilostat.ilo.org.
Ai nên đọc
Bài hợp với người làm nghiên cứu nhân sự, nhà báo dữ liệu, sinh viên kinh tế lao động, kỹ sư dựng bảng so sánh khu vực. Ai chỉ cần một con số để trích dẫn có thể dùng trang tra cứu của ILO, nhưng vẫn nên đọc phần phân biệt nguồn.
Thuật ngữ dùng trong bài
Indicator là chỉ tiêu, như UNE_DEAP_SEX_AGE_RT. Hậu tố _A, _Q, _M trong id là tần suất năm, quý, tháng. Source là mã nguồn số liệu, như BA:1788. Classif1 là chiều phân loại, ở đây là nhóm tuổi hoặc ngành. Obs_status là trạng thái quan sát. Note_source và note_indicator là mã ghi chú. Modelled estimate là số do ILO ước tính bằng mô hình.
Tìm chỉ tiêu và đọc mục lục bằng ILOSTAT API dữ liệu lao động
Phần này đi từ OpenAPI tới mục lục chỉ tiêu, vì id đúng là thứ cần có đầu tiên.
Nguồn tài liệu đã đọc
Lab đọc trang API của ILOSTAT và tệp OpenAPI, bản 1.1.0. Tệp này liệt kê các endpoint /data/indicator, /data/ref_area, /data/search, /metadata/toc/indicator, /metadata/toc/ref_area, /metadata/dic, /aggregate/data. Phần SDMX lấy từ danh sách dataflow của ILO.
Tham số của /data/indicator
Theo OpenAPI, endpoint này nhận id, format, ref_area, source, sex, classif1, classif2, time, timefrom, timeto, latestyear, best_source, type và vài tham số khác. Giá trị mặc định của format là .csv, của type là code, của best_source là yes. Tệp OpenAPI còn nêu ví dụ dùng dấu cộng để xin nhiều nước, như USA+FRA.
Mục lục chỉ tiêu
Endpoint /metadata/toc/indicator trả 1964 dòng, mỗi dòng là một chỉ tiêu theo một tần suất: 1204 dòng năm, 590 dòng quý, 170 dòng tháng. Cột có id, nhãn, đơn vị, unit_mult, data.start, data.end, last.update, database. Lưu tệp này cục bộ để tìm chỉ tiêu mà không phải gọi lại.
import csv, io, requests

s = requests.Session()
s.headers["User-Agent"] = "ProxyVN-docs-lab/1.0 (+https://proxy.vn/)"
R = "https://rplumber.ilo.org"

r = s.get(R + "/metadata/toc/indicator", params={"lang": "en", "format": ".csv"}, timeout=120)
T = list(csv.DictReader(io.StringIO(r.content.decode("utf-8-sig"))))
print(len(T))
for x in T:
    if x["id"] in ("UNE_DEAP_SEX_AGE_RT_A", "UNE_2EAP_SEX_AGE_RT_A"):
        print(x["id"], x["indicator.label"], x["unit_measure.label"], x["data.end"], x["database"])
Output thật cho thấy hai chỉ tiêu cùng nói về tỷ lệ thất nghiệp theo giới tính và tuổi. Một chỉ tiêu thuộc database LFS, một chỉ tiêu thuộc ILOEST và có nhãn ILO modelled estimates. Hai id này là điểm nhấn của cả bài.
Mục lục theo quốc gia
Endpoint /metadata/toc/ref_area cho biết Việt Nam có id VNM_A với dữ liệu năm từ 1985 tới 2030, 935 chỉ tiêu, 1850090 bản ghi, cập nhật lần cuối 25/10/2026. Năm 2030 nằm trong tương lai, tức có số dự phóng trong kho. Đây là dấu hiệu đầu tiên rằng không phải dòng nào cũng là số đo.
Tìm kiếm thử nghiệm
Endpoint /data/search nhận từ khóa, OpenAPI ghi là experimental. Lab tìm unemployment rate viet nam, kết quả đầu là UNE_DEAP_SEX_AGE_CBR_RT_A, chỉ tiêu theo nơi sinh, khác với chỉ tiêu lab cần. Dùng search để gợi ý thì được, chốt id thì nên đọc mục lục. Phần định nghĩa trả về lại có ích khi so hai chỉ tiêu gần nhau.
Id sai trả lỗi rõ ràng
Lab gọi id KHONG_CO_A và nhận HTTP 400 với JSON báo deprecated or invalid dataset, kèm đường dẫn mục lục. Một id có vẻ hợp lý như UNE_DEA1_SEX_AGE_RT_A cũng báo lỗi này, vì mục lục chỉ có bản quý của DEA1, đã điều chỉnh mùa vụ. Lỗi này tốt hơn nhiều so với các lỗi im lặng ở phần sau.
Tần suất nằm trong id
Id UNE_DEAP_SEX_AGE_RT_A là năm, _Q là quý. Lab gọi _Q cho Việt Nam và nhận 56 dòng từ 2011Q1 tới 2024Q4. Gọi _M nhận HTTP 200 với mảng rỗng, không báo gì. Việt Nam không có số tháng cho chỉ tiêu này. Mảng rỗng có thể là không có dữ liệu hoặc lọc sai, nên phải phân biệt ở bước sau.
Đơn vị đọc từ mục lục
Cột unit_measure và unit_mult cho biết đơn vị. Tỷ lệ thất nghiệp là phần trăm, unit_mult là units. Việc làm EMP_TEMP_SEX_ECO_NB_A có unit_mult là thousands, nên 55280.158 nghĩa là khoảng 55.3 triệu người. Response dữ liệu không có cột đơn vị, nên quên bước này thì thiếu ba chữ số 0.
Gọi dữ liệu theo quốc gia và thời gian với ILOSTAT API dữ liệu lao động
Phần này chạy lời gọi thật cho Việt Nam và chỉ ra bộ lọc hoạt động khác với kỳ vọng.
Lời gọi đầu tiên
Lọc VN kéo cả SVN
Lab xin tỷ lệ thất nghiệp từ 15 tuổi của Việt Nam, cả hai giới. Định dạng .json trả mảng object, dù content-type là application/octet-stream. Requests vẫn đọc r.json() bình thường.
def get_ind(id_, **k):
    r = s.get(R + "/data/indicator/", params=dict(id=id_, format=".json", **k), timeout=120)
    r.raise_for_status()
    return r.json()

N = get_ind("UNE_DEAP_SEX_AGE_RT_A", ref_area="VNM", sex="SEX_T",
            classif1="AGE_YTHADULT_YGE15")
print(len(N), N[0])
Output thật có 26 dòng, dòng đầu là năm 2024, giá trị 1.529, source BA:1788, note_source R1:3513. Dữ liệu trả theo năm giảm dần, nên đừng giả định dòng đầu là năm cũ nhất.
Trường có thể vắng mặt
Dòng đầu không có khóa obs_status, trong khi dòng năm 2007 có obs_status là B. JSON chỉ chứa khóa khi có giá trị. Code viết x["obs_status"] sẽ lỗi KeyError. Với chỉ tiêu việc làm, lab còn thấy 6 dòng không có cả obs_value, ví dụ một dòng năm 2018 chỉ có trạng thái U. Mọi khóa ngoài vài cột chính phải đọc bằng .get.
Bẫy lớn: lọc VN kéo cả Slovenia
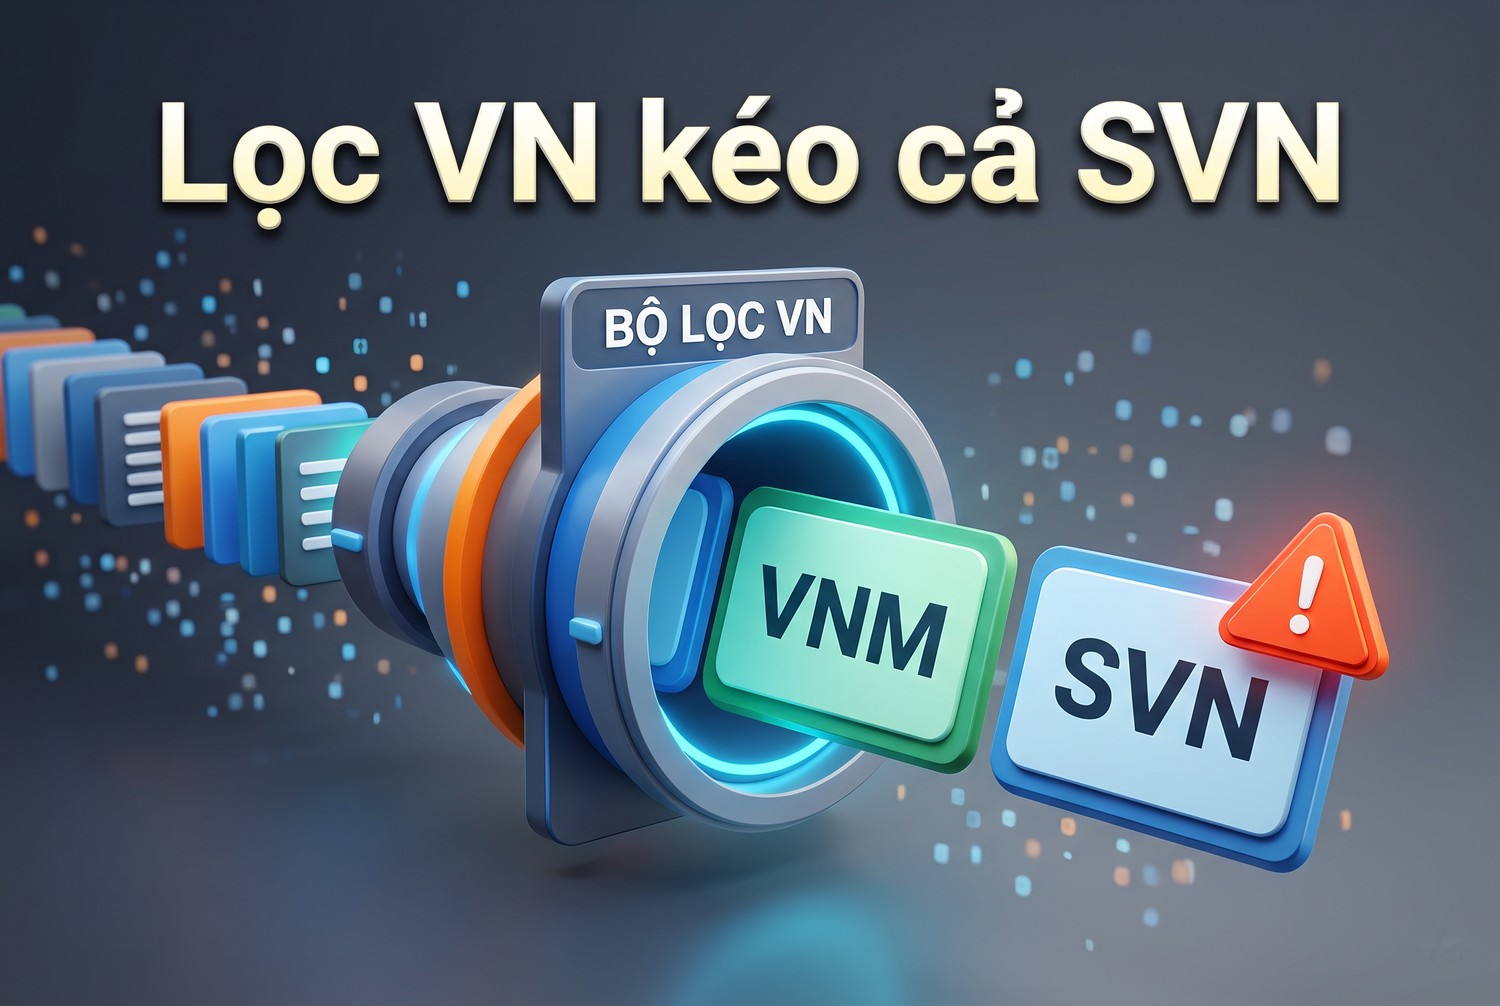
Lab thử ref_area=VN với điều kiện giống hệt, từ 2023 trở đi. API trả HTTP 200 và 5 dòng: 2 dòng VNM và 3 dòng SVN. Slovenia có mã SVN, chứa chuỗi VN. Bộ lọc khớp theo chuỗi con, không khớp đúng mã. Bảng nhận thêm một nước mà không có cảnh báo nào.
Chữ thường và tiền tố
Lab thử thêm. Ref_area=vnm vẫn ra đúng dòng. Classif1=AGE_YTHADULT, chỉ là tiền tố, trả 4 nhóm tuổi thay vì báo lỗi. Sex=SEX trả 3 dòng cho cả ba giới tính. Sex=XXX trả mảng rỗng với HTTP 200. Cách lọc này tiện khi khám phá, nhưng nguy hiểm khi anh em tin rằng mình đã chọn đúng một giá trị.
Tham số thử |
HTTP |
Số dòng |
Kết quả |
|---|---|---|---|
ref_area=VN |
200 |
5 |
VNM 2, SVN 3 |
ref_area=vnm |
200 |
1 |
Đúng Việt Nam |
ref_area=VNM+THA |
200 |
5 |
Thái Lan 3, Việt Nam 2 |
classif1=AGE_YTHADULT |
200 |
4 |
Bốn nhóm tuổi |
sex=SEX |
200 |
3 |
Cả ba giới tính |
sex=XXX |
200 |
0 |
Mảng rỗng |
Hàm kiểm sau khi gọi
Vì API không báo lỗi, phép kiểm phải nằm ở phía anh em. Sau mỗi lời gọi, so tập giá trị trả về với tập đã xin.
def check(rows, **want):
    for col, vals in want.items():
        got = {x.get(col) for x in rows}
        extra = got - set(vals)
        if extra:
            raise ValueError(f"{col} la: {sorted(extra)}")
    return rows

A = get_ind("UNE_DEAP_SEX_AGE_RT_A", ref_area="VN", sex="SEX_T",
            classif1="AGE_YTHADULT_YGE15", timefrom="2023")
check(A, ref_area=["VNM"])
Với ref_area=VN, hàm báo ValueError ref_area la: ['SVN']. Đây là dòng code rẻ nhất trong bài và chặn đúng lỗi nguy hiểm nhất.
Nhiều nước và độ mới khác nhau
Lab xin VNM+THA từ 2023. Thái Lan có 2023, 2024, 2025 với 0.733, 0.781, 0.604, nguồn BA:741. Việt Nam chỉ có 2023, 2024 với 1.645, 1.529. Số mới nhất của mỗi nước khác năm, nên câu "số mới nhất" trong bảng so sánh phải đi kèm năm. Tham số latestyear lấy năm cuối của từng chuỗi, cũng sẽ cho các năm khác nhau.
Tham số best_source
Mặc định best_source=yes, theo tên gọi là API chọn nguồn tốt nhất cho mỗi chuỗi. Lab đặt best_source=no với cùng bộ lọc và nhận mảng rỗng, không rõ lý do. Vì OpenAPI lab đọc không làm rõ điều này, lab không dùng tham số đó. Để xem nhiều nguồn, anh em thử lọc bằng tham số source. Nếu cần so các nguồn, nên kiểm trên chỉ tiêu cụ thể trước.
Nhãn thay cho mã
Tham số type=label trả tên đọc được: Viet Nam, LFS - Labour Force Survey, Age (Youth, adults): 15+. Tệp CSV có các cột .label. Bảng để người đọc thì tiện, nhưng pipeline nên tải mã, giữ từ điển riêng, để tên thay đổi không làm hỏng phép ghép.
Khoảng thời gian
Timefrom và timeto giới hạn năm. Với dữ liệu quý, time có dạng 2024Q4, là chuỗi. So sánh chuỗi vẫn sắp đúng trong cùng định dạng, nhưng khi đổi sang kiểu ngày phải viết hàm riêng. Không ép cột time thành số nguyên, vì bảng trộn năm và quý sẽ lỗi.
Phân biệt số khảo sát với ước tính mô hình trong ILOSTAT API dữ liệu lao động
Đây là nội dung quan trọng nhất của bài: một chuỗi đẹp có thể là hai loại số ghép lại.
Hai chỉ tiêu, hai loại số
Hai loại số
UNE_DEAP_SEX_AGE_RT_A thuộc database LFS, nguồn BA:1788, từ điển ghi LFS - Labour Force Survey của Việt Nam. UNE_2EAP_SEX_AGE_RT_A thuộc ILOEST, nguồn XA:2184, từ điển ghi ILO - Modelled Estimates. Lab đọc từ điển bằng /metadata/dic với var=source. Tên chỉ tiêu gần như giống nhau, chỉ khác mấy ký tự giữa.
So hai chuỗi của Việt Nam
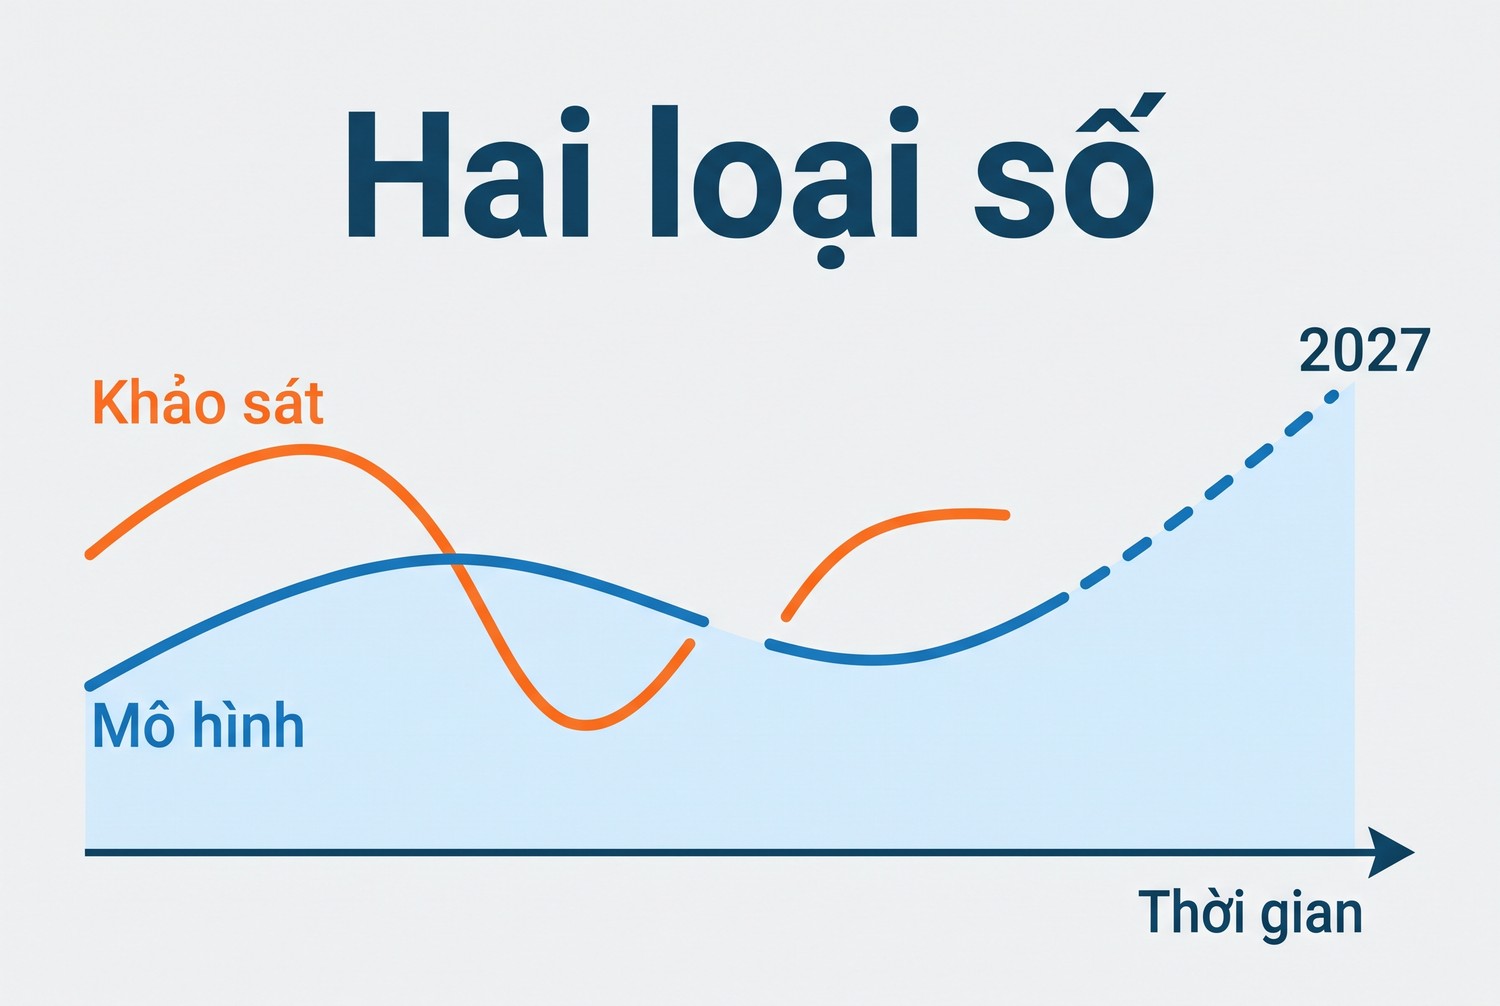
Chuỗi khảo sát có 26 năm từ 1996 tới 2024, thiếu 2005, 2006, 2008. Chuỗi mô hình có 37 năm từ 1991 tới 2027, liền mạch. Bảng dưới lấy một số mốc thật.
Năm |
Khảo sát BA:1788 |
Mô hình XA:2184 |
Ghi chú |
|---|---|---|---|
1991 |
không có |
2.14 |
Chỉ có mô hình |
2005 |
không có |
2.078 |
Mô hình lấp khoảng trống |
2007 |
2.026 |
2.026 |
Trùng, khảo sát có cờ B |
2008 |
không có |
1.889 |
Mô hình lấp khoảng trống |
2023 |
1.645 |
1.645 |
Trùng |
2024 |
1.529 |
1.602 |
Khác nhau |
2025 |
không có |
1.523 |
Sau năm khảo sát cuối |
2026 |
không có |
1.529 |
Năm chưa kết thúc |
2027 |
không có |
1.614 |
Tương lai |
Đọc bảng này
Trong hầu hết năm có khảo sát, chuỗi mô hình bằng số khảo sát, chỉ làm tròn khác đôi chút như 2.87 và 2.868. Có vẻ chuỗi mô hình lấy số thật khi có, rồi lấp phần còn lại. Riêng năm 2024, hai chuỗi lệch 0.073 điểm phần trăm, lab đếm đây là năm duy nhất lệch rõ. Lý do có thể là thời điểm cập nhật khác nhau, lab không xác minh được.
Năm tương lai trong bảng
Ngày 05/11/2026, chuỗi mô hình đã có số cả năm 2026 và 2027. Năm 2027 chưa xảy ra nên số đó chỉ có thể là dự phóng của mô hình. Response không gắn cờ gì cho các dòng này. Chỉ có cột source và ngày hiện tại cho anh em biết năm 2027 chưa xảy ra. Một bảng không giữ cột source sẽ trình bày dự phóng như dữ liệu.
Khoảng tin cậy ở điểm SDMX
Điểm SDMX trả thêm hai cột mà API thường không có: UPPER_BOUND và LOWER_BOUND. Với năm 2024 của chuỗi mô hình, khoảng là 1.202 tới 2.002 quanh 1.602. Các năm 2025 tới 2027 lab đọc có hai cột này trống. Con số 1.529 của khảo sát vẫn nằm trong khoảng đó. Một bảng nghiêm túc nên giữ khoảng này khi dùng số mô hình.
import requests

S = "https://sdmx.ilo.org/rest"
u = S + "/data/ILO,DF_UNE_2EAP_SEX_AGE_RT/VNM...SEX_T.AGE_YTHADULT_YGE15"
r = requests.get(u, params={"startPeriod": 2024, "format": "csv"}, timeout=90)
print(r.text[:400])
Output thật có dòng 2024 với giá trị 1.602, nguồn ILO - Modelled Estimates, cận trên 2.002, cận dưới 1.202. Key dùng ô trống cho FREQ và MEASURE.
Khi nào dùng chuỗi nào
Mục đích |
Chuỗi nên dùng |
Lý do |
|---|---|---|
Trích dẫn số một nước |
Khảo sát |
Số gốc, có nguồn cụ thể |
So nhiều nước cùng năm |
Mô hình |
Đủ năm hơn |
Chuỗi dài không đứt |
Mô hình, ghi rõ |
Có lấp khoảng trống |
Phân tích theo quý |
Khảo sát |
Lab chỉ đọc mô hình bản năm |
Ghi chú cho người đọc
Biểu đồ dùng chuỗi mô hình phải ghi "ước tính mô hình của ILO". Với các năm sau khảo sát cuối, nên vẽ nét đứt. Câu "tỷ lệ thất nghiệp năm 2027 là 1.6 phần trăm" là sai về bản chất nếu thiếu chữ dự phóng. Người đọc bình thường sẽ không tự đoán ra.
Định nghĩa thất nghiệp
Nhãn rep_var ghi previous ILO definition - ICLS13, tức định nghĩa theo hội nghị thống kê lao động lần thứ 13. Chữ previous cho thấy có định nghĩa mới hơn. Hai nước dùng định nghĩa khác nhau thì so trực tiếp sẽ khập khiễng. Cột note_indicator và tên rep_var là nơi kiểm tra.
So với số trong nước
Số của cơ quan thống kê Việt Nam có thể khác vì nhóm tuổi, kỳ tham chiếu hoặc cách tính. Ghi chú nguồn của ILOSTAT là Repository: ILO-STATISTICS - Micro data processing, nghĩa là số đi qua khâu xử lý vi dữ liệu của ILO. Lab không so với nguồn trong nước, nên bài không đưa kết luận về chênh lệch. Khi trích dẫn, nên ghi rõ đó là số của ILOSTAT.
Đọc trạng thái, ghi chú và điểm gãy chuỗi trong ILOSTAT API dữ liệu lao động
Cột giá trị chưa đủ. Mã ghi chú mới nói số đó được đo thế nào.
Từ điển mã
Mã ghi chú và gãy chuỗi
Endpoint /metadata/dic với var nhận source, note_source, note_indicator, obs_status, indicator và các biến khác. Lab tải các tệp này một lần rồi tra offline. Tệp source nặng hơn 200 KB, tệp indicator hơn 1.3 MB vì có cả định nghĩa.
def dic(var):
    r = s.get(R + "/metadata/dic", params={"var": var, "lang": "en", "format": ".csv"}, timeout=120)
    rows = list(csv.DictReader(io.StringIO(r.content.decode("utf-8-sig"))))
    return {x[var]: x[var + ".label"] for x in rows}

NS = dic("note_source")
NI = dic("note_indicator")
ST = dic("obs_status")
print(NS["R1:3513"], "|", NI["I11:264"], "|", ST["B"])
Output thật là Repository: ILO-STATISTICS - Micro data processing, Break in series: Methodology revised, Break in series. Bảng cuối nên có cả mã lẫn nhãn đã giải.
Bảng mã trong dữ liệu Việt Nam
Mã |
Nghĩa theo từ điển |
|---|---|
obs_status B |
Break in series |
obs_status U |
Unreliable |
note_indicator I11:264 |
Break in series: Methodology revised |
note_indicator I12:450 |
Frequency: Quarterly: average based on 3 monthly data points |
note_indicator I20:4077 |
Employment definition: Excluding own-use production workers |
note_source S3:18 |
Data reference period: July |
note_source S4:30 |
Geographical coverage: Total national, excluding overseas territories |
note_source S5:38 |
Population coverage: Excluding both institutional population and armed forces and/or conscripts |
Ghi chú nhiều mã
Cột note_source có thể là S3:18_S4:30_S5:38, tức ba mã nối bằng dấu gạch dưới. Hàm giải mã phải tách trước khi tra. Các mã lab đọc dùng dấu hai chấm và không có gạch dưới bên trong, nên tách theo gạch dưới là an toàn với dữ liệu này.
def decode(code, table):
    if not code:
        return []
    return [table.get(c, c) for c in code.split("_")]

print(decode("S3:18_S4:30_S5:38", NS))
Hàm giữ nguyên mã nếu không có trong từ điển, để không mất thông tin khi từ điển chưa có mã mới. Output thật là ba nhãn kỳ tham chiếu tháng 7, phạm vi địa lý và phạm vi dân số.
Điểm gãy chuỗi năm 2007
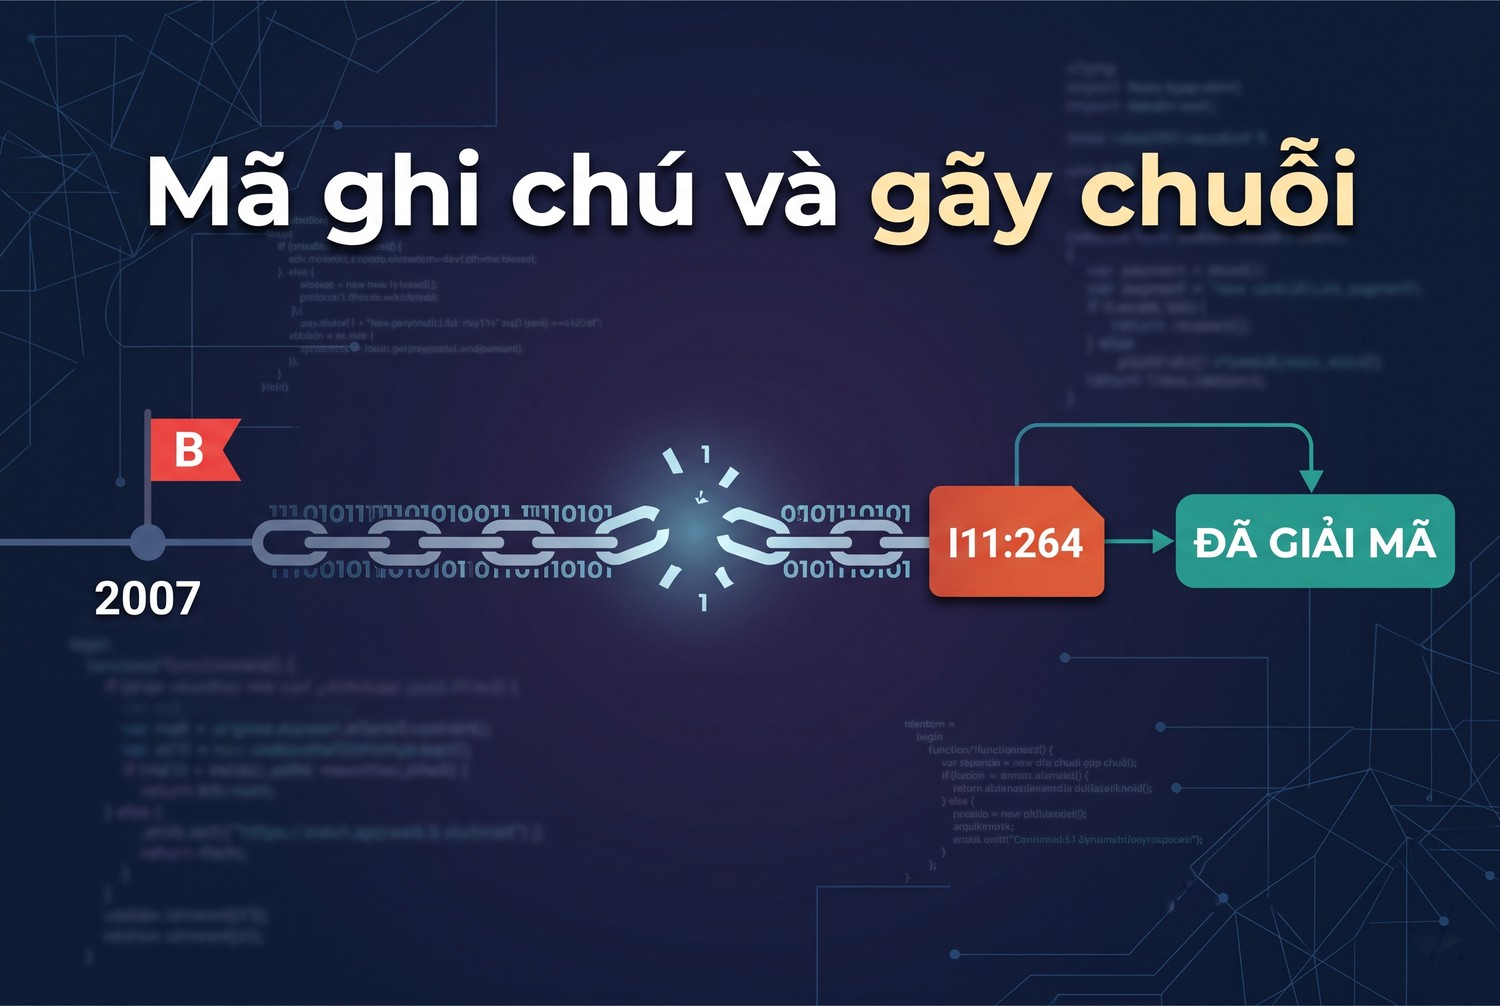
Dòng 2007 của chuỗi năm có obs_status B và note_indicator I11:264, nghĩa là phương pháp đã đổi. Số trước và sau năm này không so trực tiếp được. Lab cũng thấy các dòng 1996 tới 2004 có ghi chú kỳ tham chiếu tháng 7, còn từ 2007 thì ghi chú nguồn đổi sang R1:3513. Chuỗi gần 30 năm thực ra là vài đoạn.
Điểm gãy trong chuỗi quý
Chuỗi quý có hai điểm B: 2011Q1 và 2019Q1. Mọi dòng quý có ghi chú trung bình ba tháng. Biểu đồ quý nên đánh dấu hai mốc này. So thay đổi ngay tại mốc gãy, như từ 2018Q4 sang 2019Q1, có thể đang đo sự đổi phương pháp.
Dòng Unreliable
Chỉ tiêu việc làm theo ngành có 10 dòng trạng thái U. Ví dụ năm 2020, nhóm ECO_SECTOR_X có giá trị 0.401 và trạng thái U. Năm 2018, cùng nhóm không có giá trị, chỉ có U. Bảng không nên vẽ các dòng này như số thường. Cờ Unreliable có thể do mẫu nhỏ, nhưng lab không đọc được lý do cụ thể.
Hàm chuẩn hóa dòng
Lab gom các bước vào một hàm, đầu ra đủ cột dù khóa có thể vắng.
def norm(x, today_year=2026):
    src = x.get("source", "")
    t = x["time"]
    return {
        "ref_area": x["ref_area"], "indicator": x["indicator"], "source": src,
        "source_kind": "mo_hinh" if src.startswith("XA:") else "khao_sat",
        "sex": x.get("sex"), "classif1": x.get("classif1"), "time": t,
        "value": x.get("obs_value"), "status": x.get("obs_status"),
        "notes": decode(x.get("note_source"), NS) + decode(x.get("note_indicator"), NI),
        "is_future": int(t[:4]) > today_year,
    }
Tiền tố XA cho nguồn mô hình là quan sát của lab trên dữ liệu Việt Nam, anh em xác nhận bằng từ điển source trước khi dùng cho nước khác. Cột is_future chỉ đánh dấu năm chưa tới, năm 2026 chưa kết thúc vẫn cần nhãn riêng.
Tránh đếm trùng các nhóm phân loại trong ILOSTAT API dữ liệu lao động
Lỗi cộng nhầm rất dễ xảy ra vì một con số xuất hiện dưới nhiều nhóm.
Một số, bốn hệ phân loại
Lab gọi chỉ tiêu thất nghiệp năm 2024, không lọc classif1, được 28 dòng. Giá trị 1.529 xuất hiện bốn lần: AGE_YTHADULT_YGE15, AGE_AGGREGATE_YGE15, AGE_10YRBANDS_YGE15, AGE_5YRBANDS_YGE15. Đây là bốn cách chia tuổi của cùng dữ liệu. Tổng của 28 dòng là 55.946, không có ý nghĩa gì với tỷ lệ phần trăm.
Cả bảng không lọc
Không lọc sex và classif1, Việt Nam có 1536 dòng, chia đều 512 dòng cho mỗi giới tính SEX_T, SEX_M, SEX_F. Với chỉ tiêu đếm người, SEX_T là tổng của hai nhóm còn lại. Group by rồi cộng mà không loại SEX_T sẽ nhân đôi số liệu.
Nhóm tổng trong ngành
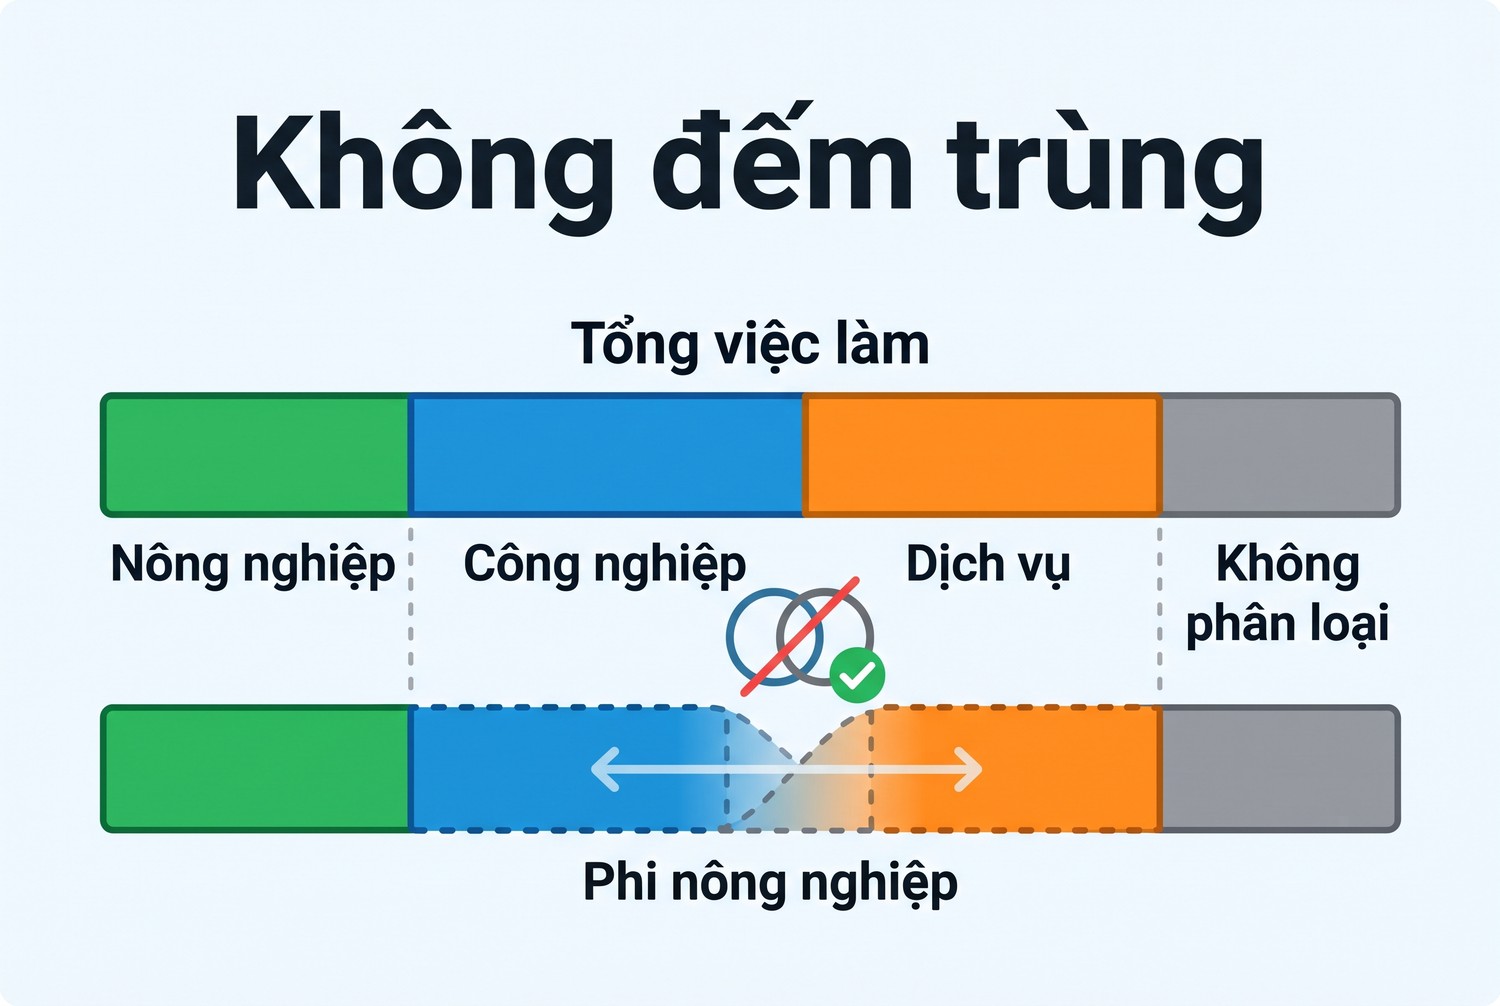
Chỉ tiêu việc làm năm 2024 có các dòng: tổng 55280.158, nông nghiệp 13637.057, phi nông nghiệp 41643.101, công nghiệp 17131.226, dịch vụ 20666.543, không phân loại 3845.332 nghìn người. Lab cộng nông nghiệp, công nghiệp, dịch vụ và không phân loại ra đúng 55280.158. Phi nông nghiệp bằng tổng trừ nông nghiệp, tức chồng lên công nghiệp và dịch vụ. Cộng cả cột sẽ sai.
Nhóm |
Mã |
Nghìn người |
Có cộng vào tổng |
|---|---|---|---|
Tổng |
ECO_SECTOR_TOTAL |
55280.158 |
Là tổng |
Nông nghiệp |
ECO_SECTOR_AGR |
13637.057 |
Có |
Phi nông nghiệp |
ECO_SECTOR_NAG |
41643.101 |
Không, chồng lấn |
Công nghiệp |
ECO_SECTOR_IND |
17131.226 |
Có |
Dịch vụ |
ECO_SECTOR_SER |
20666.543 |
Có |
Không phân loại |
ECO_SECTOR_X |
3845.332 |
Có |
Phần không phân loại lớn
Nhóm ECO_SECTOR_X năm 2024 là 3845.332 nghìn, gần 7 phần trăm tổng, trong khi năm 2020 chỉ 0.401 và có cờ U. Thay đổi lớn như vậy nên được đọc là khác biệt trong phân loại, không nên hiểu là một ngành mới tăng. Lab không biết nguyên nhân. So theo ngành qua các năm phải kiểm nhóm này.
Tỷ lệ không cộng được
Tỷ lệ thất nghiệp không cộng hay lấy trung bình đơn giản qua nhóm. Năm 2024, nam 1.626, nữ 1.424, tổng 1.529 là các tỷ lệ tính riêng. Thanh niên 15 tới 24 là 6.41, trong đó nữ 6.144, nam 6.637. Muốn tỷ lệ chung từ các nhóm phải quay về số đếm thất nghiệp và lực lượng lao động.
Quy tắc chọn một hệ phân loại
Trước khi tính, chốt một hệ: ví dụ AGE_YTHADULT cho thanh niên và người lớn, ECO_SECTOR cho khu vực. Lọc bằng danh sách mã đầy đủ, không dùng tiền tố, vì tiền tố khớp cả các nhóm tổng. Ghi lựa chọn này vào cấu hình.
SECTOR_PARTS = ["ECO_SECTOR_AGR", "ECO_SECTOR_IND", "ECO_SECTOR_SER", "ECO_SECTOR_X"]

def check_sum(rows, year):
    v = {x["classif1"]: x.get("obs_value") for x in rows
         if x["time"] == year and x.get("sex") == "SEX_T"}
    tot = v["ECO_SECTOR_TOTAL"]
    parts = sum(v[k] for k in SECTOR_PARTS)
    return tot, round(parts, 3), abs(tot - parts) < 0.01

print(check_sum(E, "2024"))
Output là 55280.158, 55280.158 và True. Biến E là mảng trả về của EMP_TEMP_SEX_ECO_NB_A. Phép kiểm tổng này bắt được lỗi lọc thiếu nhóm.
Đường tải, SDMX và vai trò proxy với ILOSTAT API dữ liệu lao động
Phần này so hai kênh truy cập và nói về nhịp gọi.
Điểm SDMX
sdmx.ilo.org liệt kê 1215 dataflow, ví dụ DF_UNE_DEAP_SEX_AGE_RT. Cấu trúc có các chiều REF_AREA, FREQ, MEASURE, SEX, AGE. Khác với API thường, không có chiều source, nguồn nằm ở attribute. Lab thử key có BA_1788 ở vị trí thứ hai và nhận 404 với văn bản No data is found. Khóa sửa thành VNM.A..SEX_T.AGE_YTHADULT_YGE15 thì trả dữ liệu.
Khớp giữa hai kênh
Năm 2023 ở điểm SDMX là 1.645, cùng giá trị với API thường. CSV có thêm UNIT_MEASURE PT, UNIT_MULT 0, DECIMALS, SOURCE dạng chữ, UPPER_BOUND, LOWER_BOUND. Với pipeline đã có công cụ SDMX, kênh này hợp hơn. Với script nhỏ, API thường dễ hơn nhiều. Cách đọc khóa SDMX tương tự bài ECB trong cùng nhóm.
Bảng so hai kênh
Tiêu chí |
rplumber |
SDMX |
|---|---|---|
Lọc |
Khớp chuỗi con |
Khóa theo từng chiều |
Đơn vị |
Tra mục lục |
Có trong response |
Khoảng tin cậy |
Không thấy |
Có với số mô hình |
Mã ghi chú |
Mã, tra từ điển |
Có cột riêng |
Dễ dùng |
Rất dễ |
Cần hiểu khóa |
Lấy nhiều chỉ tiêu
Mỗi chỉ tiêu một lời gọi là đủ cho vài chục chỉ tiêu. Lab nghỉ hai giây giữa các lượt và không gặp lỗi giới hạn. Response không có header giới hạn lab đọc được, máy chủ đứng sau Cloudflare. Đặt nhịp vừa phải, cache cục bộ, không gọi song song. Mục lục ghi last.update nên chỉ cần tải lại khi ngày đổi.
Tải lại theo last.update
Mỗi lần chạy, script đọc mục lục, so last.update của chỉ tiêu với lần trước, chỉ tải khi đổi. Dòng UNE_DEAP_SEX_AGE_RT_A có last.update 03/11/2026, còn quốc gia VNM_A có 25/10/2026. Vì số có thể được sửa, nên lưu mỗi lần tải thành một phiên bản nếu cần tái lập.
Giấy phép và trích dẫn
Lab không đọc được trang điều khoản trên ilostat.ilo.org vì lớp kiểm tra trình duyệt. Anh em mở trang đó bằng trình duyệt trước khi công bố. Trích dẫn nên ghi ILOSTAT, id chỉ tiêu, nguồn, ngày truy cập. Với số mô hình, ghi thêm cụm ILO modelled estimates.
Proxy có cần không
Không cần cho việc lấy dữ liệu này. API công khai, không khóa, gọi thẳng là cách đúng. Cloudflare đứng trước dịch vụ nên gọi dồn dập có thể bị chặn, cách xử lý là giảm nhịp, xem bài rate limit API khi dùng proxy. Phần xử lý chạy offline trên tệp đã lưu.
Khi mạng công ty bắt buộc
Nếu buộc đi qua cổng ra, khai báo ở session, chuỗi theo định dạng proxy. Vai trò proxy trong thu thập dữ liệu có ở bài Web Scraping proxy là gì.
Với tác vụ thu thập khác cần IP ổn định, anh em có thể mua proxy tại trang chủ ProxyVN.
Khóa phiên bản
Lab chạy Python 3.12.10, requests 2.34.2, API bản 1.1.0 theo OpenAPI. Ghi id chỉ tiêu, ngày tải và last.update vào manifest. Giữ vài JSON mẫu làm test, vì các trường có thể vắng tùy dữ liệu.
Một chuỗi liền mạch chưa chắc là một loại số. Giữ cột nguồn, đọc mã ghi chú, kiểm lại bộ lọc, và đừng cộng các nhóm chồng nhau.
Đầu ra nghiệm thu dataset nguồn, chiều phân loại và ghi chú của ILOSTAT API dữ liệu lao động
Mục này chốt bảng và danh sách kiểm.
Schema của bảng
Không đếm trùng
Cột |
Ví dụ thật |
Ghi chú |
|---|---|---|
ref_area |
VNM |
Kiểm đúng tập đã xin |
indicator |
UNE_DEAP_SEX_AGE_RT |
Không kèm tần suất |
source |
BA:1788 |
LFS |
source_kind |
khao_sat |
Hoặc mo_hinh |
sex |
SEX_T |
Một giá trị đã chốt |
classif1 |
AGE_YTHADULT_YGE15 |
Một hệ phân loại |
time |
2024 |
Chuỗi |
value |
1.529 |
Có thể vắng |
status |
B |
Có thể vắng |
notes |
Danh sách nhãn |
Đã giải mã |
unit |
% |
Từ mục lục |
fetched_at |
2026-11-05 |
Ngày tải |
Danh sách kiểm
- Bộ lọc: tập ref_area, sex, classif1 trả về khớp tập đã xin.
- Nguồn: mỗi dòng có khảo sát hoặc mô hình, không trộn trong một cột.
- Tương lai: năm chưa tới được đánh dấu là dự phóng.
- Gãy chuỗi: mốc B hiện trên biểu đồ.
- Đếm trùng: một hệ phân loại, có phép kiểm tổng.
- Đơn vị: đọc unit_mult từ mục lục.
Câu kết luận được phép viết
Từ lab có thể viết rằng bộ lọc khớp chuỗi con nên VN kéo theo SVN. Năm 2024 có hai giá trị theo hai chỉ tiêu. Chuỗi mô hình chứa năm tương lai không có cờ. Không nên viết con số nào đúng hơn cho Việt Nam, vì lab không đối chiếu số trong nước.
Những gì lab chưa chạy
Lab chưa đọc được hướng dẫn và điều khoản trên ilostat.ilo.org. Lab chưa thử /aggregate, tham số source, best_source với chỉ tiêu nhiều nguồn, dữ liệu tháng của nước khác. Lab không biết lý do lệch năm 2024 và lý do mảng rỗng với best_source=no. Hàm norm được viết cho bài, cần test với dữ liệu nước khác.
ILOSTAT API dữ liệu lao động: câu hỏi thường gặp
Các câu dưới đây gom những điểm hay bị hỏi.
Có cần khóa API không?
Không. Lab gọi cả hai kênh không khóa.
Vì sao năm 2024 có hai con số?
Hai chỉ tiêu khác nhau: khảo sát 1.529 và mô hình 1.602.
Số năm 2027 là gì?
Là ước tính mô hình cho năm chưa tới, chưa thể là số đo.
Vì sao bảng có Slovenia?
Bộ lọc khớp chuỗi con. Dùng đủ mã ba ký tự VNM.
Mảng rỗng nghĩa là gì?
Có thể không có dữ liệu hoặc lọc sai. API trả 200 cho cả hai ca.
Có cộng các ngành lại được không?
Được nếu chọn đúng nhóm. Đừng cộng cả phi nông nghiệp và tổng.
Nên dùng rplumber hay SDMX?
Script nhỏ dùng rplumber. Cần khoảng tin cậy hay lọc chặt thì dùng SDMX.
Proxy có cần không?
Không. Gọi thẳng và giữ nhịp là đủ.
ILOSTAT API dữ liệu lao động và những điều cần nhớ
ILOSTAT API dữ liệu lao động cho số đáng tin khi anh em tách khảo sát khỏi ước tính mô hình, kiểm bộ lọc sau mỗi lời gọi, đọc mã ghi chú và chọn một hệ phân loại. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em giữ cột nguồn khi dùng ILOSTAT API dữ liệu lao động.


