
ijson đọc JSON lớn từ web: parse theo luồng, đo RAM thật
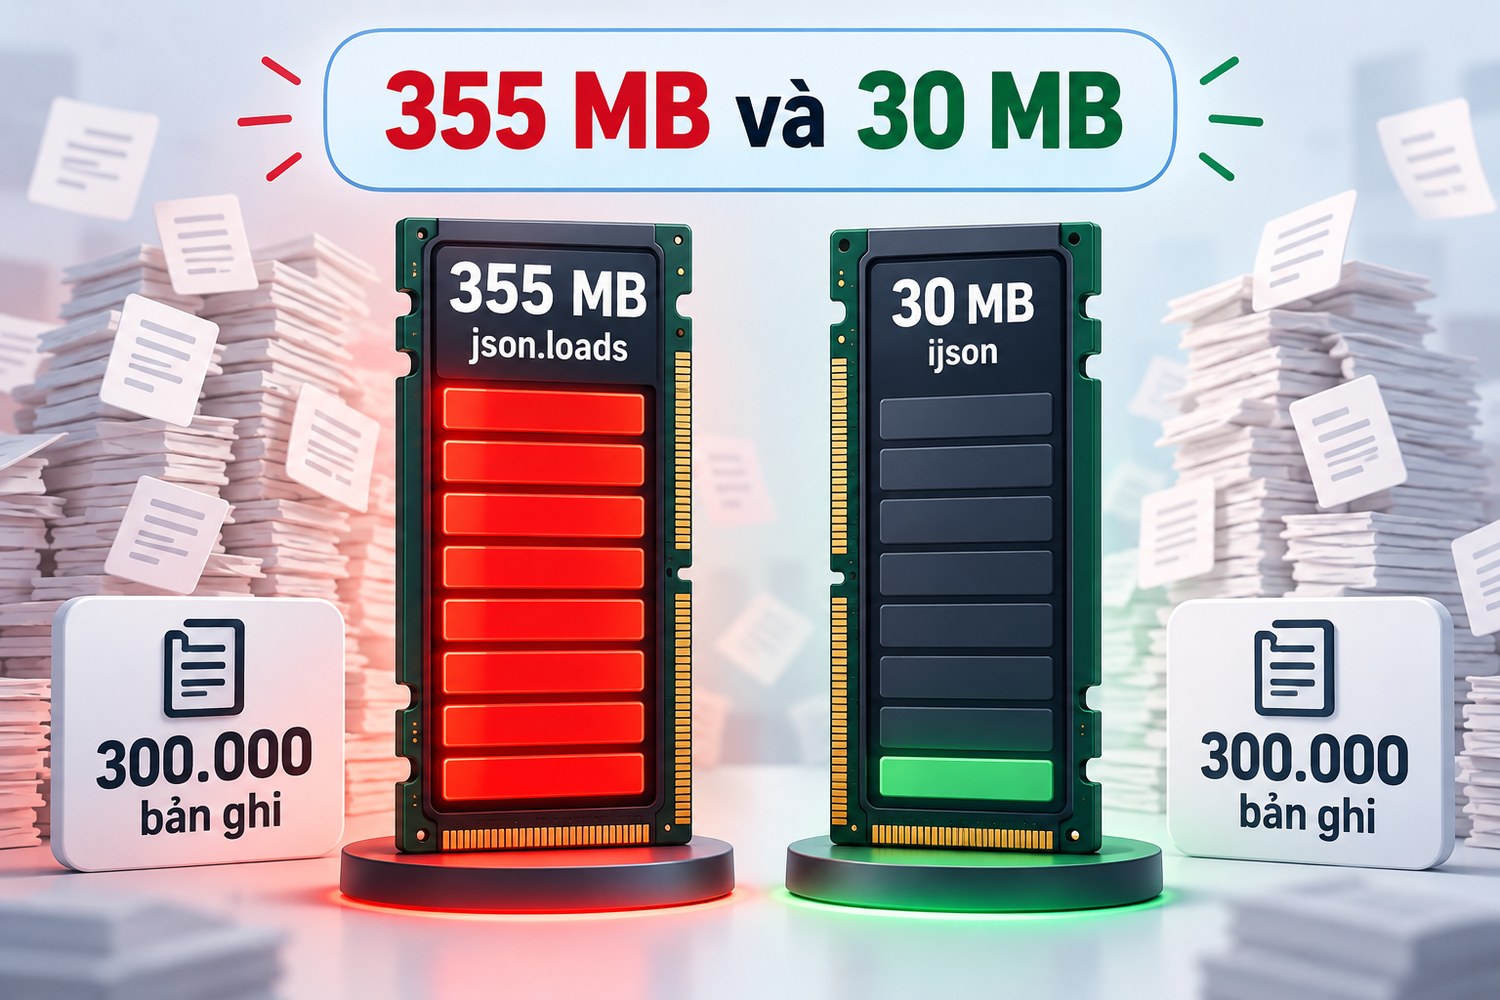
ijson đọc JSON lớn từ web là cách parse một response JSON khổng lồ theo từng phần tử ngay khi byte về tới, thay vì đợi tải hết rồi nạp cả cây vào bộ nhớ. Bài dành cho anh em hay gọi API trả về một mảng hàng trăm nghìn bản ghi và thấy tiến trình Python phình RAM tới mức máy treo. ProxyVN chạy thử ngày 29/10/2026 với một tệp 40 MB chứa 300.000 bản ghi: json.loads đẩy bộ nhớ đỉnh lên 355 MB, ijson giữ ở khoảng 30 MB, cho cùng một kết quả.
ijson đọc JSON lớn từ web: mục tiêu dữ liệu, quyền và phạm vi truy cập
Phần đầu chốt bài toán, đầu ra và ranh giới với các cách xử lý dữ liệu lớn khác.
Bài toán cụ thể
Nhiều API và trang xuất dữ liệu trả về một tài liệu JSON duy nhất với một mảng lớn bên trong. Ví dụ một catalog sản phẩm, một bản xuất log, một danh sách địa điểm. Cách quen tay là gọi response.json() rồi lặp qua mảng.
Cách đó đúng với response vài MB. Khi response lên vài chục hay vài trăm MB, Python phải giữ cả chuỗi byte, cả cây đối tượng sau khi parse, và các đối tượng trung gian. Bộ nhớ dùng thực tế gấp nhiều lần kích thước tệp.
Đầu ra mà bài này hướng tới
Đầu ra là một vòng lặp xử lý từng bản ghi khi nó vừa parse xong: đếm, cộng tổng, ghi ra tệp hay đẩy vào cơ sở dữ liệu. Kèm theo là bảng đo bộ nhớ đỉnh và thời gian, so sánh hai cách với cùng đầu vào, cùng máy, cùng điều kiện.
Bảng đo là phần quan trọng nhất. Nó cho anh em con số để quyết định khi nào cần ijson và khi nào json.loads vẫn ổn.
Dữ liệu lab là dữ liệu tự sinh
Lab không gọi API của bên thứ ba để lấy tệp lớn. Tải hàng chục MB từ máy chủ người khác chỉ để thử thư viện là tạo tải không cần thiết. Lab tự sinh tệp big.json và phục vụ qua máy chủ HTTP cục bộ ở cổng 9760.
Tệp có một khối meta nhỏ ở đầu và một mảng items gồm 300.000 bản ghi. Mỗi bản ghi có id, sku, tên tiếng Việt có dấu, giá, ba thẻ và số tồn kho. Tổng kích thước 40.304.951 byte.
Quyền khi dùng trên nguồn thật
Khi áp vào API thật, quyền truy cập vẫn là của API đó: khóa, giới hạn, điều khoản. ijson không đổi gì ở tầng này. Nó chỉ thay đổi cách xử lý byte sau khi máy chủ đã đồng ý gửi.
Tải tệp lớn từ nguồn công khai cũng nên đọc chính sách của nguồn. Nhiều cổng dữ liệu cung cấp bản xuất nén hoặc chia nhỏ, nhẹ hơn cho cả hai bên.
Ranh giới với JSONL
JSONL là mỗi dòng một tài liệu JSON độc lập. Đọc JSONL theo luồng chỉ cần đọc từng dòng rồi json.loads từng dòng, không cần ijson. Bài DuckDB xử lý dữ liệu crawl JSONL bàn cách đó.
ijson giải quyết trường hợp khó hơn: một tài liệu JSON duy nhất, không xuống dòng giữa các bản ghi, mà vẫn muốn đọc từng bản ghi. Đó là định dạng mà rất nhiều API trả về và mình không chọn được.
Ranh giới với chọn định dạng lưu
Bài JSON và CSV khi crawl dữ liệu bàn nên lưu dữ liệu crawl dạng gì. Bài này không bàn chuyện lưu. Đầu vào đã là JSON do máy chủ quyết định, việc của mình là đọc nó mà không làm sập máy.
Ai cần cách đọc này
Người chạy script thu dữ liệu trên VPS nhỏ một hai GB RAM. Người viết job chạy song song nhiều luồng, mỗi luồng đọc một response lớn. Người cần xử lý dữ liệu ngay khi về, ví dụ dừng sớm khi tìm thấy bản ghi cần.
Với cả ba, tiết kiệm vài trăm MB mỗi tiến trình là khác biệt giữa job chạy được và job bị hệ điều hành giết.
ijson đọc JSON lớn từ web: parse JSON theo luồng sau HTTP fetch
Phần này giải thích ijson làm gì, cách nối nó với requests và cú pháp prefix.
ijson là parser theo sự kiện
ijson đọc byte vào từng phần nhỏ và phát ra sự kiện: bắt đầu mảng, bắt đầu đối tượng, gặp khóa, gặp giá trị, kết thúc đối tượng. Trên các sự kiện đó, thư viện dựng sẵn ba giao diện tiện dùng: parse, kvitems và items.
items là giao diện hay dùng nhất. Nó nhận một prefix chỉ vị trí trong cây JSON và trả từng đối tượng Python đầy đủ ở vị trí đó. Mỗi đối tượng được dựng, trả ra, rồi có thể được giải phóng trước khi đối tượng tiếp theo được dựng.
Backend C nhanh hơn nhiều
ijson có nhiều backend: python thuần, yajl2_c, yajl2_cffi và vài cái khác. Bản cài từ pip trên Windows trong lab dùng yajl2_c, viết bằng C. Biến ijson.backend cho biết backend đang dùng.
Lab in ijson.backend trong mọi lần chạy và đều thấy yajl2_c. Nếu máy anh em in ra python, thư viện vẫn chạy đúng nhưng chậm hơn nhiều lần. Ghi backend vào nhật ký để giải thích khi tốc độ khác nhau giữa hai máy.
Nối ijson với requests
import requests, ijson
r = requests.get("http://127.0.0.1:9760/big.json", stream=True, timeout=60)
r.raw.decode_content = True
n, total = 0, 0.0
for item in ijson.items(r.raw, "items.item", use_float=True):
    n += 1
    total += item["price"]
r.close()
print(n, round(total, 2))
stream=True bảo requests không tải body vào bộ nhớ. r.raw là luồng byte thô từ socket. decode_content bằng True bảo urllib3 tự giải nén gzip hoặc deflate nếu máy chủ nén.
Prefix chỉ đường trong cây
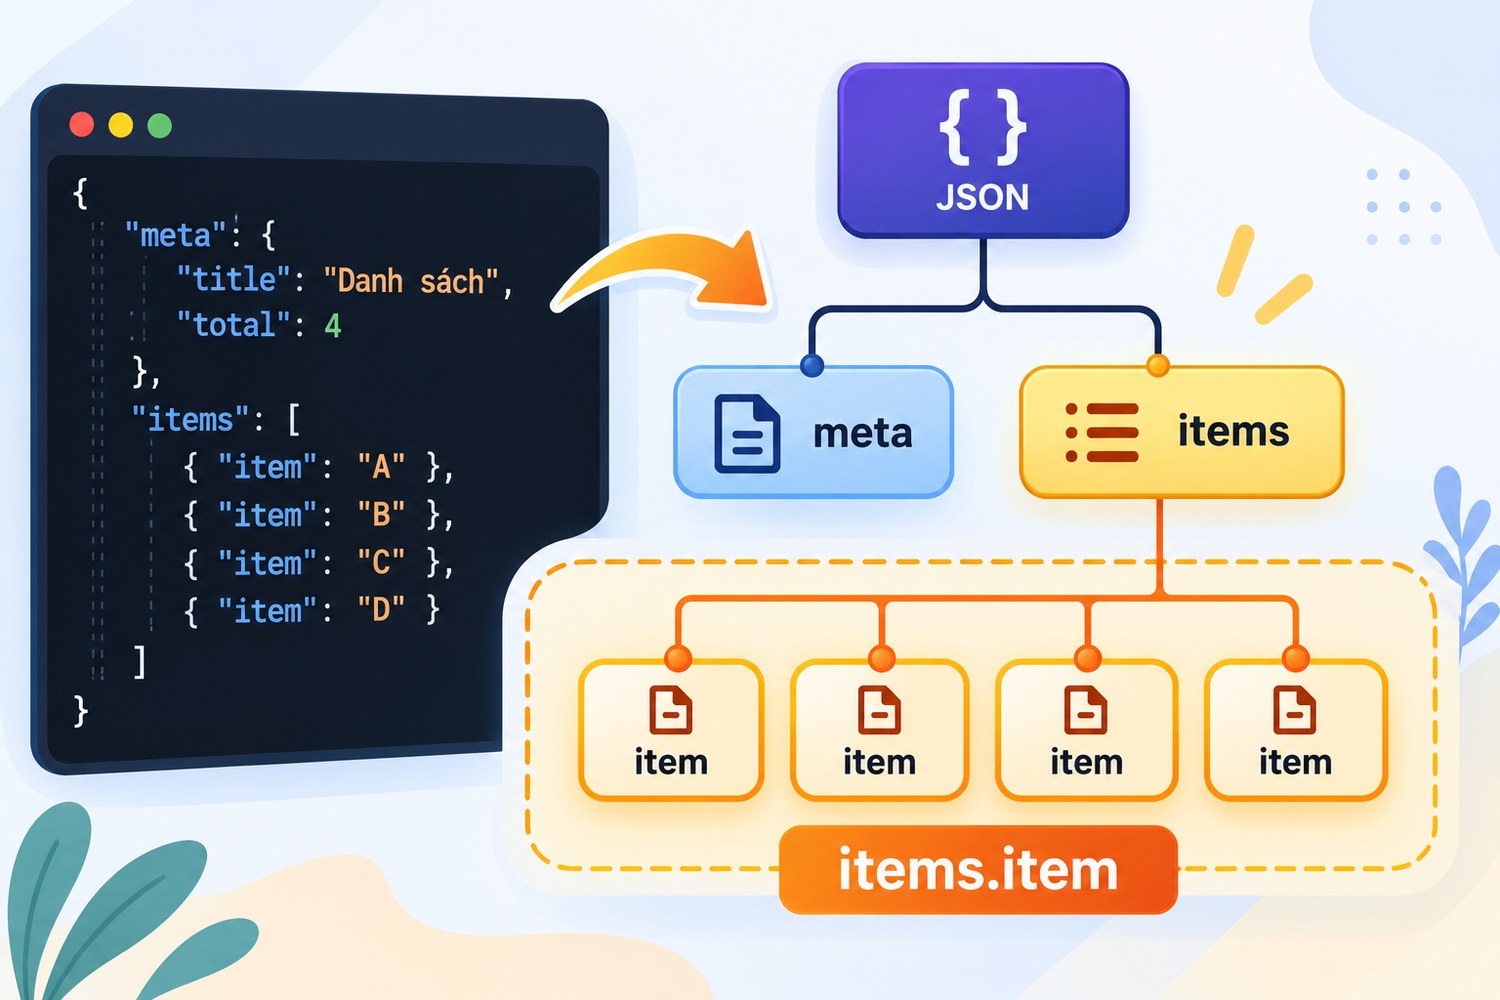
items.item
Prefix là chuỗi tên khóa nối bằng dấu chấm, với item đại diện cho mỗi phần tử của mảng. items.item nghĩa là mỗi phần tử của mảng nằm dưới khóa items ở gốc. Nếu gốc là một mảng trần, prefix là item.
Với cấu trúc lồng sâu hơn như data.results, mỗi phần tử là data.results.item. Viết sai prefix thì vòng lặp không chạy lần nào và không báo lỗi. Đếm n sau vòng lặp là cách bắt lỗi này.
use_float và Decimal
Mặc định ijson trả số thực dưới dạng decimal.Decimal để không mất độ chính xác. Decimal an toàn cho tiền tệ nhưng chậm hơn và không cộng trực tiếp được với float. Tham số use_float bằng True trả float như json.loads.
Lab dùng use_float để kết quả cộng giá giống hệt json.loads: 149.879.795,83 ở cả hai cách. Với dữ liệu tài chính cần đúng từng xu, giữ Decimal và chuyển đổi có chủ ý.
kvitems cho khối meta
kvitems trả từng cặp khóa và giá trị dưới một prefix. Gọi kvitems với prefix meta trả hai cặp source và generated. Đây là cách đọc phần đầu tài liệu mà không dựng phần còn lại.
Nhưng ijson vẫn đọc tiếp luồng tới hết nếu vòng lặp không dừng. Lab đo kvitems meta chạy hết vòng mất 0,80 giây, gần bằng đọc cả mảng. Khi break ngay sau khi đủ hai khóa và đóng response, thời gian còn 0,027 giây.
parse cho cấu trúc không đều
Khi tài liệu không có một mảng đồng nhất mà là cây lộn xộn, items không đủ. Giao diện parse trả bộ ba gồm prefix, loại sự kiện và giá trị cho từng sự kiện. Anh em tự quyết định giữ gì, bỏ gì.
parse ở mức thấp nên code dài hơn. Chỉ dùng khi items và kvitems không diễn đạt được thứ cần lấy, ví dụ cần đếm số khóa ở mọi tầng hay cần lấy một trường nằm rải rác trong nhiều nhánh khác nhau.
Nhiều mảng trong cùng một tài liệu
Một số API trả hai mảng lớn cạnh nhau, ví dụ products và variants. ijson đọc luồng một lần từ đầu tới cuối, nên không thể lặp products xong rồi quay lại lặp variants trên cùng response.
Có hai cách. Gửi hai request, mỗi request lặp một prefix. Hoặc dùng parse, xử lý cả hai prefix trong cùng một vòng lặp sự kiện. Cách đầu dễ viết, cách sau tiết kiệm băng thông.
Dừng sớm là lợi thế lớn
Với json.loads, không có cách nào dừng sớm. Phải tải hết, parse hết, rồi mới tìm. Với ijson, khi đã tìm thấy bản ghi cần, break khỏi vòng lặp và gọi r.close() để đóng kết nối. Phần còn lại của response không bao giờ được tải.
Lợi thế này đáng kể khi chỉ cần khối meta ở đầu, hay chỉ cần vài nghìn bản ghi đầu tiên để thử.
Chuẩn bị endpoint, header và phiên bản thư viện cho ijson đọc JSON lớn từ web
Phần này gom các quyết định trước khi chạy: header, nén, timeout và phiên bản.
Kiểm Content-Type và Content-Length
Trước khi lặp, đọc r.headers. Content-Type phải là application/json hoặc tương đương. Nếu máy chủ trả text/html, nhiều khả năng đó là trang lỗi hay trang đăng nhập, và ijson sẽ ném lỗi parse ngay byte đầu.
Content-Length cho biết kích thước dự kiến. Máy chủ lab gửi 40.304.951. Sau khi lặp xong, so số byte đã đọc với con số này để biết response có bị cắt giữa chừng không.
Nén gzip
Khi máy chủ nén, Content-Length là kích thước nén. ijson nhận byte đã giải nén nhờ decode_content. Bộ nhớ vẫn thấp vì giải nén cũng diễn ra theo từng khối.
Bài gzip và brotli khi web scraping giải thích cách requests xử lý nén. Brotli cần thư viện brotli được cài thêm. Máy chủ lab không nén, nên số liệu bộ nhớ trong bài là với byte thô.
Timeout cho luồng
timeout trong requests là thời gian chờ giữa hai lần nhận byte, không phải tổng thời gian. Với luồng dài, một request có thể kéo dài nhiều phút mà không vi phạm timeout. Đặt thêm giới hạn tổng bằng cách đo thời gian trong vòng lặp nếu job cần.
Phiên bản thư viện
Lab dùng Python 3.12.10, requests 2.34.2, ijson 3.6.0, psutil 7.2.2, cài trong venv riêng. Khóa phiên bản trong requirements.txt. API items và kvitems ổn định từ ijson 3, code trong bài không dùng tính năng mới hơn.
Đo bộ nhớ đúng cách
Đo bộ nhớ trong cùng tiến trình đã chạy cách khác trước đó sẽ sai, vì Python không trả hết bộ nhớ cho hệ điều hành. Lab chạy mỗi cách trong một tiến trình con riêng, đo RSS lúc bắt đầu và bộ nhớ đỉnh lúc kết thúc bằng psutil.
Trên Windows, psutil cho trường peak_wset là working set đỉnh của tiến trình. Đây là con số gần nhất với câu hỏi máy cần bao nhiêu RAM cho job này. Trên Linux, dùng resource.getrusage với ru_maxrss.
Dữ liệu chứa tiếng Việt
Tệp lab ghi tên sản phẩm có dấu với ensure_ascii bằng False, tức byte UTF-8 thật chứ không phải chuỗi thoát dạng \u. ijson đọc byte và giải mã UTF-8 đúng. Nếu máy chủ khai báo charset khác trong Content-Type, kiểm lại trước khi tin dữ liệu.
Thu dữ liệu theo luồng và đo bộ nhớ với ijson đọc JSON lớn từ web
Phần này ghi lại kết quả đo thật ngày 29/10/2026.
Bảng đo chính
355 MB và 30 MB
Cách đọc |
Bản ghi |
Tổng giá |
Giây |
RSS đầu MB |
Đỉnh MB |
|---|---|---|---|---|---|
response.json() |
300.000 |
149.879.795,83 |
0,83 |
28,9 |
355,4 |
ijson.items, gọi thẳng |
300.000 |
149.879.795,83 |
0,98 |
28,9 |
29,8 |
ijson.items qua proxy HTTP |
300.000 |
149.879.795,83 |
1,01 |
29,2 |
30,2 |
ijson.items qua proxy SOCKS5h |
300.000 |
149.879.795,83 |
1,01 |
28,9 |
29,9 |
Ba cách ijson cho cùng số bản ghi và cùng tổng giá với json.loads. Bộ nhớ đỉnh của json.loads là 355,4 MB cho tệp 40 MB, gấp gần chín lần kích thước tệp. ijson chỉ tăng chưa tới 1,5 MB so với lúc bắt đầu.
Tốc độ gần như ngang nhau
json.loads mất 0,83 giây, ijson mất 0,98 giây trên máy lab. ijson chậm hơn khoảng 18 phần trăm. Đổi lại, bộ nhớ giảm hơn mười lần. Với backend yajl2_c, cái giá về tốc độ nhỏ hơn nhiều người nghĩ.
Con số này đo với máy chủ cục bộ, mạng không phải nút cổ chai. Với API thật qua Internet, thời gian tải chiếm phần lớn và khác biệt giữa hai cách parse gần như biến mất.
Vì sao json.loads tốn gấp chín lần
response.json() giữ toàn bộ 40 MB byte trong response.content, rồi giải mã thành chuỗi Python, rồi dựng 300.000 từ điển, mỗi từ điển có sáu khóa, ba chuỗi thẻ, vài số. Mỗi đối tượng Python nhỏ cũng tốn hàng chục byte cho phần đầu đối tượng.
Hệ số gấp chín lần là của dữ liệu lab. Dữ liệu có nhiều chuỗi ngắn và nhiều đối tượng lồng sẽ có hệ số cao hơn. Dữ liệu chủ yếu là chuỗi dài có hệ số thấp hơn.
Khi nào json.loads vẫn là lựa chọn đúng
Không phải response nào cũng cần ijson. Với response dưới vài MB, json.loads nhanh hơn, code ngắn hơn, và bộ nhớ thêm vài chục MB không đáng kể. Thêm ijson vào mọi chỗ chỉ làm code khó đọc.
Quy tắc thực dụng: ước lượng kích thước response nhân với khoảng mười, so với RAM còn trống của máy chạy job chia cho số luồng chạy song song. Nếu con số vượt một nửa, chuyển sang ijson. Hệ số mười lấy từ đo lab và chỉ là điểm bắt đầu, nên đo lại với dữ liệu thật của mình.
Đo trên máy chạy thật
Máy phát triển thường nhiều RAM hơn máy chạy job. Một script chạy ổn trên laptop 16 GB có thể bị giết trên VPS 1 GB. Chạy bảng đo của bài trên chính máy đích, với một response thật, trước khi đưa job lên lịch chạy định kỳ.
Đọc qua proxy không đổi bộ nhớ
Đi qua proxy HTTP hay SOCKS5h, bộ nhớ đỉnh vẫn quanh 30 MB và thời gian tăng chưa tới 0,05 giây. Proxy chuyển byte theo luồng, không gom cả response. Phía client, ijson vẫn nhận từng khối như khi gọi thẳng.
Log proxy HTTP của lab ghi GET http://127.0.0.1:9760/big.json với xác thực đúng, vì máy chủ lab chạy HTTP thường. Log SOCKS5 ghi CONNECT tới 127.0.0.1 cổng 9760 với kiểu địa chỉ ipv4, vì URL dùng IP chứ không dùng tên miền.
SOCKS cần thêm PySocks
Lần chạy đầu qua socks5h báo lỗi InvalidSchema, thiếu phụ thuộc cho SOCKS. requests cần gói PySocks để dùng proxy SOCKS. Cài thêm PySocks rồi chạy lại thì thành công.
Lỗi này hay gặp khi chuyển script sang máy mới. Ghi PySocks vào requirements.txt nếu job có khả năng chạy qua SOCKS.
Mảng items khác mảng gốc
Tệp lab có gốc là đối tượng với meta và items. Nếu gốc là mảng trần, prefix đổi thành item. Lab cố ý dùng gốc là đối tượng vì phần lớn API thật bọc mảng trong một khóa như data, results hay items, kèm thông tin phân trang.
Đối soát số bản ghi, kiểu dữ liệu, giá trị thiếu và xuất xứ khi ijson đọc JSON lớn từ web
Parse theo luồng nghĩa là lỗi có thể xảy ra giữa chừng. Phần này bàn cách phát hiện và đối soát.
Response bị cắt giữa chừng
Luồng bị cắt
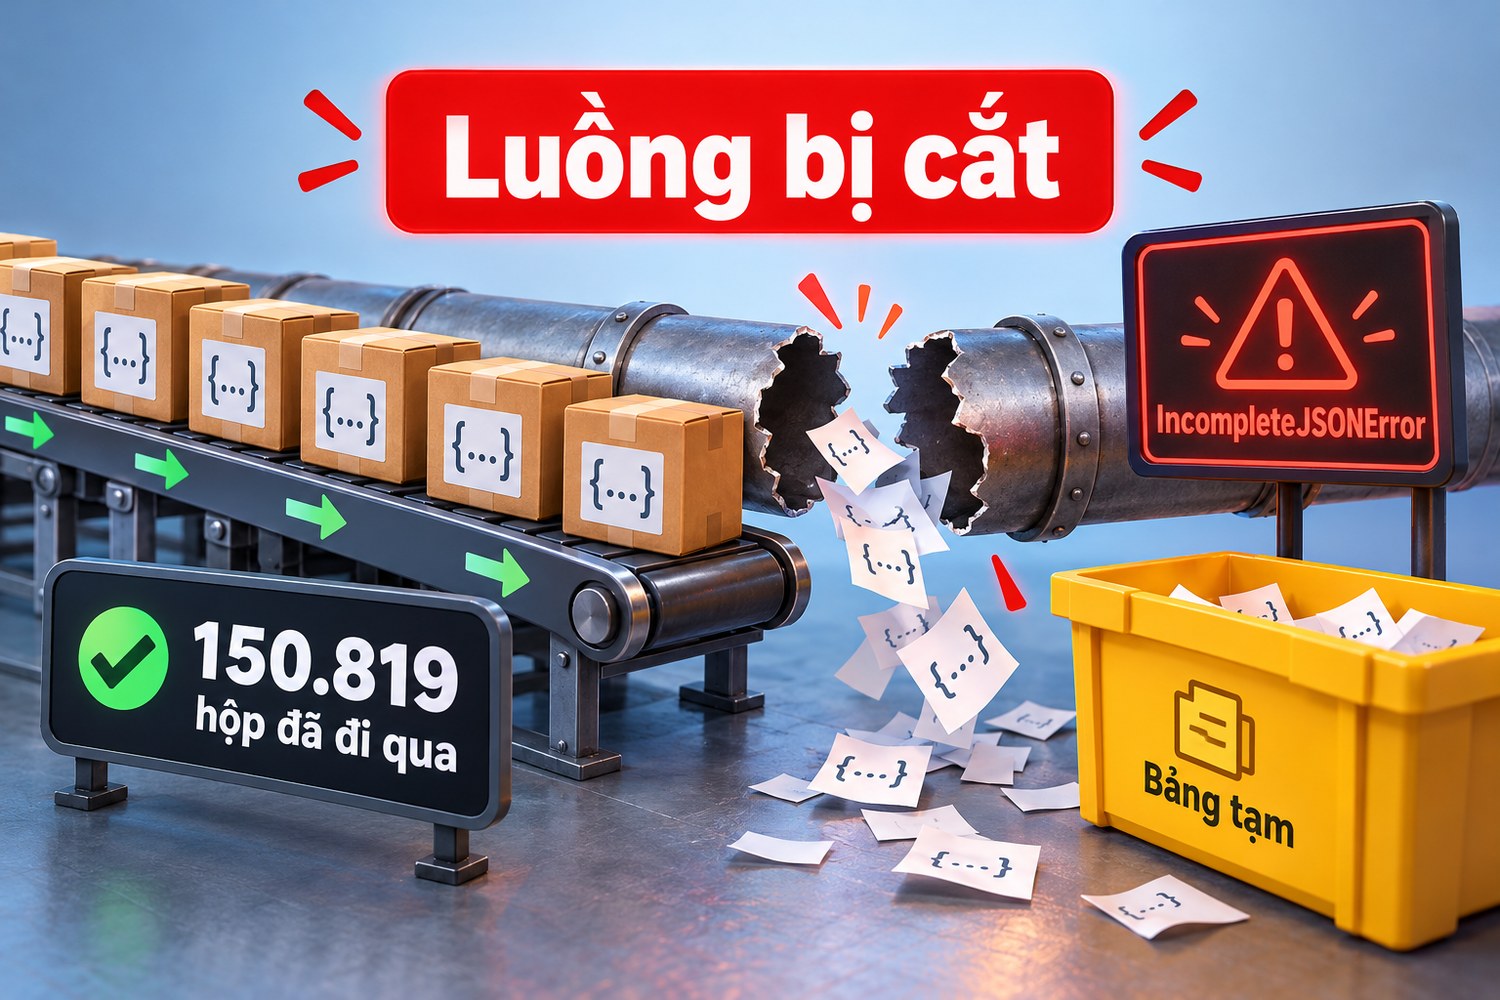
Lab tạo tệp trunc.json bằng cách cắt big.json ở giữa, 20.152.475 byte. Đây là mô phỏng kết nối đứt hoặc proxy cắt response. Rồi cho cả hai cách đọc tệp cụt.
Cách đọc |
Kết quả |
Bản ghi đã xử lý |
Đỉnh MB |
|---|---|---|---|
response.json() |
JSONDecodeError, chuỗi chưa đóng |
0 |
195,4 |
ijson.items |
IncompleteJSONError, premature EOF |
150.819 |
29,8 |
json.loads ném lỗi và không trả gì. ijson đã xử lý 150.819 bản ghi trước khi ném lỗi ở cuối luồng.
Bản ghi đã xử lý trước lỗi là con dao hai lưỡi
Với ijson, 150.819 bản ghi đã đi qua vòng lặp, có thể đã được ghi vào cơ sở dữ liệu. Nếu code không bắt lỗi và đánh dấu job là thất bại, anh em sẽ có nửa bảng mà tưởng là đủ.
Cách an toàn là ghi vào bảng tạm hoặc tệp tạm, chỉ đổi tên thành bảng chính khi vòng lặp kết thúc không lỗi và số bản ghi khớp kỳ vọng. Lỗi giữa chừng thì xóa phần tạm và chạy lại.
Đối soát số bản ghi
Nếu API trả tổng số bản ghi trong khối meta hay trong header, đọc nó và so với n sau vòng lặp. Nếu không có tổng, ít nhất so số byte đã đọc với Content-Length và xác nhận vòng lặp kết thúc bình thường.
Lab so n bằng 300.000 và tổng giá bằng kết quả json.loads. Hai phép so cùng khớp nên lab coi ijson cho kết quả đúng với dữ liệu này.
Kiểu dữ liệu của số
Không có use_float, giá trả về là Decimal. Cộng Decimal với float ném TypeError. Lỗi này thường xuất hiện khi chuyển code từ json.loads sang ijson mà quên tham số. Quyết định kiểu số một lần ở đầu và giữ nhất quán.
Số nguyên như id và stock luôn là int, không phụ thuộc use_float.
Giá trị thiếu
Bản ghi thiếu khóa thì từ điển ijson trả cũng thiếu khóa đó, giống json.loads. Dùng item.get thay vì item với dấu ngoặc vuông cho các trường không bắt buộc, và đếm số bản ghi thiếu từng trường.
Giá trị null trả về None. Phân biệt khóa thiếu với khóa có giá trị null nếu ý nghĩa của hai trường hợp khác nhau với dữ liệu của anh em.
Giữ xuất xứ của luồng
Ghi lại URL, thời điểm bắt đầu, header response, số byte đã đọc, số bản ghi, backend ijson và trạng thái kết thúc. Khi chạy lại sau và ra số khác, nhật ký này giúp biết do nguồn đổi hay do lần trước bị cắt.
Không thể giữ response thô nếu không muốn tốn bộ nhớ. Nếu cần tái lập, ghi luồng byte ra đĩa song song với việc parse, rồi parse lại từ tệp khi cần.
Lưu kết quả, giới hạn request và khi nào ijson đọc JSON lớn từ web cần proxy
Phần cuối bàn chuyện ghi kết quả, nhịp gọi và vị trí của proxy trong luồng dữ liệu lớn.
Ghi kết quả theo lô
Ghi từng bản ghi vào cơ sở dữ liệu là chậm. Gom thành lô vài nghìn bản ghi rồi ghi một lần. Bộ nhớ vẫn thấp vì chỉ giữ một lô, không giữ cả mảng.
Khi ghi ra tệp JSONL, ghi từng dòng ngay khi parse xong. Tệp JSONL đầu ra đọc lại được theo luồng mà không cần ijson nữa.
Kết nối dài và giới hạn của máy chủ
Một response 40 MB qua Internet có thể giữ kết nối nhiều giây hay nhiều phút. Một số máy chủ đặt giới hạn thời gian kết nối, cắt response dài. Đó là lúc tình huống tệp cụt trong lab xảy ra thật.
Nếu API hỗ trợ phân trang, dùng trang vừa phải thay vì một response khổng lồ. ijson hữu ích nhất khi nguồn chỉ cung cấp một tài liệu lớn duy nhất.
Nhịp gọi
Tải tệp lớn tốn băng thông của máy chủ nhiều hơn nhiều request nhỏ. Cache kết quả, dùng If-Modified-Since hay ETag nếu máy chủ hỗ trợ, và không tải lại tệp chưa đổi. Bài rate limit API khi dùng proxy có mẫu bộ đếm request.
Proxy không làm luồng chậm đi đáng kể
Lab đo thời gian qua proxy HTTP và SOCKS5h đều 1,01 giây, so với 0,98 giây gọi thẳng. Với proxy cục bộ, độ trễ thêm gần như bằng không. Với proxy qua Internet, độ trễ phụ thuộc vị trí proxy và băng thông, không phụ thuộc ijson.
Một điều cần nhớ: proxy có giới hạn thời gian kết nối riêng. Response dài qua proxy có thể bị proxy cắt, không phải máy chủ cắt. Khi gặp IncompleteJSONError qua proxy, thử gọi thẳng để biết lỗi nằm ở đâu.
Proxy HTTP thấy gì
Với URL http thường, proxy HTTP thấy toàn bộ URL và có thể đọc nội dung response. Với https, proxy chỉ thấy CONNECT tới tên máy và cổng 443. Dữ liệu lớn chứa thông tin nhạy cảm nên luôn đi qua https.
Với socks5h và URL có tên miền, proxy phân giải DNS. Lab dùng IP 127.0.0.1 nên proxy SOCKS ghi kiểu địa chỉ ipv4. Bài httpx proxy có ví dụ tương tự cho httpx, cũng hỗ trợ đọc theo luồng.
Khi nào cần proxy thật
Proxy cần khi máy chạy job nằm trong mạng nội bộ chỉ được ra Internet qua proxy. Trường hợp thứ hai là tổ chức yêu cầu lưu lượng ra ngoài đi qua một IP cố định để giám sát, hay để nguồn dữ liệu đưa IP đó vào danh sách cho phép. Cấu hình và mã hóa mật khẩu có ký tự đặc biệt có trong bài định dạng proxy.
Bài Web Scraping proxy là gì phân biệt các vai trò của proxy. Với ijson, proxy chỉ là đường đi của byte, parser không biết và không cần biết có proxy.
Khi máy chủ của nhóm đặt tại Việt Nam và cần IP thoát ổn định cho các job tải dữ liệu lớn, proxy tĩnh dễ quản lý hơn proxy xoay. Lý do đơn giản: đổi IP giữa một response dài sẽ làm đứt kết nối. ProxyVN có proxy dân cư tĩnh, datacenter, 4G và proxy xoay qua HTTP hoặc SOCKS5. Anh em có thể mua proxy Việt Nam tại trang chủ ProxyVN rồi khai báo vào requests theo tham số proxies.
Giới hạn suy luận của bài
Số liệu đến từ một máy lab Windows ngày 29/10/2026, với tệp tự sinh 40 MB phục vụ qua máy chủ cục bộ, không nén. Hệ số bộ nhớ gấp chín lần là của dữ liệu lab. Dữ liệu khác sẽ có hệ số khác.
Lab không đo với API thật qua Internet, không đo với response nén gzip, không thử backend python thuần và không thử proxy thương mại. Proxy trong lab là proxy cục bộ.
Checklist ijson đọc JSON lớn từ web
Checklist ijson
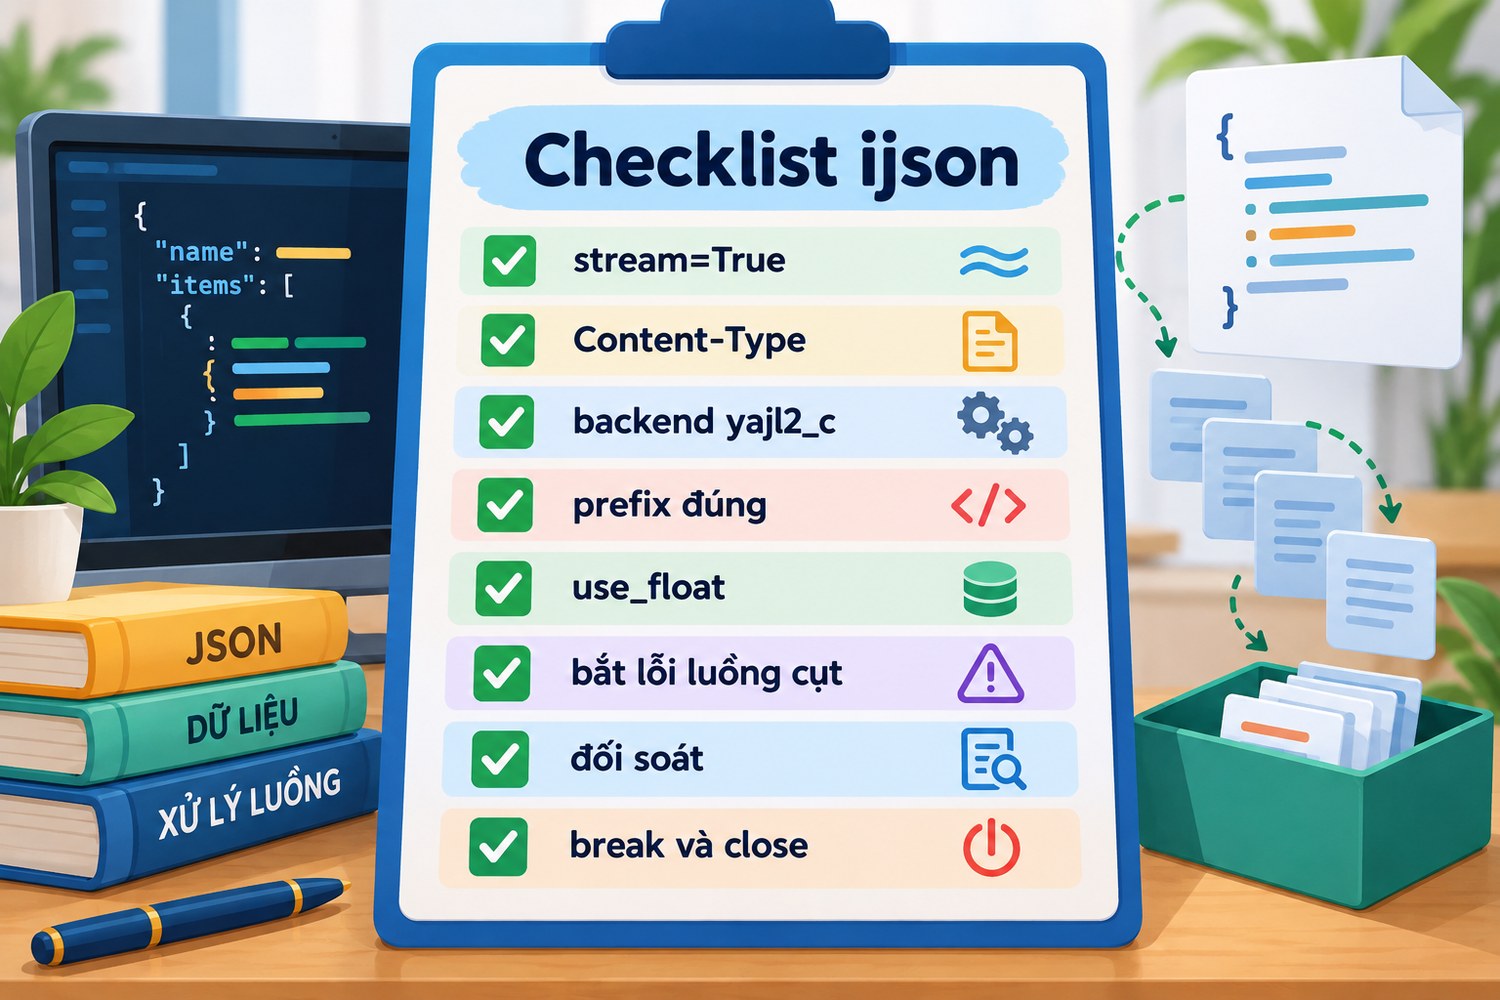
- Gọi requests với stream bằng True, đặt decode_content.
- Kiểm Content-Type trước khi lặp.
- In ijson.backend, mong đợi yajl2_c.
- Viết đúng prefix, đếm n sau vòng lặp.
- Chọn use_float hoặc giữ Decimal có chủ ý.
- Bắt IncompleteJSONError, ghi vào vùng tạm.
- Đối soát số bản ghi và số byte.
- Break và close khi đã đủ dữ liệu cần.
Câu hỏi thường gặp về ijson đọc JSON lớn từ web
Khi nào nên dùng ijson thay cho json.loads?
Khi response lớn so với RAM còn trống, khi chạy nhiều luồng song song, hoặc khi muốn dừng sớm. Response vài MB thì json.loads vẫn ổn.
ijson có chậm hơn nhiều không?
Với backend yajl2_c, lab đo chậm hơn khoảng 18 phần trăm trên máy chủ cục bộ. Qua Internet, khác biệt gần như biến mất.
Vì sao vòng lặp ijson không chạy lần nào?
Thường do prefix sai. Kiểm cấu trúc gốc, mảng trần dùng item, mảng dưới khóa items dùng items.item.
Vì sao cộng giá bị TypeError?
ijson trả Decimal mặc định. Thêm use_float bằng True hoặc chuyển đổi kiểu có chủ ý.
JSONL có cần ijson không?
Không. JSONL đọc từng dòng rồi json.loads từng dòng là đủ.
Đi qua proxy có làm tăng RAM không?
Không. Lab đo qua proxy HTTP và SOCKS5h đều quanh 30 MB, bằng gọi thẳng.
ijson đọc JSON lớn từ web và những điều cần nhớ
ijson đọc JSON lớn từ web giúp anh em xử lý từng bản ghi ngay khi về mà không nạp cả response vào RAM. Lab ngày 29/10/2026 với 300.000 bản ghi: json.loads đỉnh 355 MB, ijson khoảng 30 MB, kết quả giống hệt, chỉ chậm hơn chút. Viết đúng prefix, bắt lỗi luồng cụt, đối soát số bản ghi. Cần IP thoát ổn định cho job dùng ijson đọc JSON lớn từ web, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


