
GDELT DOC API truy vấn tin: mode, cửa sổ thời gian và độ phủ
GDELT DOC API truy vấn tin là cách tìm bài báo theo từ khóa, quốc gia nguồn và cửa sổ thời gian trong dữ liệu GDELT. Bài này viết cho người theo dõi tin trên nhiều nguồn. ProxyVN ghi trung thực: DOC API trả 429 gần như mọi lượt từ máy lab, nên lab đọc tệp Mentions công khai ngày 05/11/2026 và thấy 4637 URL trong hai giờ, chỉ 4 URL từ tên miền .vn.
GDELT DOC API truy vấn tin: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và giới hạn lab, vì phần API trong bài dựa nhiều vào tài liệu.
Bài toán cần giải
Một nhóm truyền thông muốn theo dõi bài viết về một chủ đề tại Việt Nam và khu vực. Họ gọi API, nhận danh sách bài, đếm số bài rồi viết "báo chí đưa tin tăng gấp đôi". Vài ngày sau họ nhận ra con số đổi theo cách đặt cửa sổ thời gian và danh sách bị cắt ở một mức cố định. Số đếm đó không nói điều họ nghĩ.
Đầu ra nghiệm thu
Đầu ra là dataset gồm URL, nguồn, quốc gia nguồn, ngôn ngữ và thời điểm GDELT thấy bài, cùng phép thử cửa sổ thời gian. Phép thử phải cho biết truy vấn có bị cắt bởi giới hạn bản ghi hay không. Nếu bị cắt, dataset không được dùng để đếm.
Ranh giới với RSS và tải bài báo
Bài thu thập RSS và Atom bằng Python đọc nguồn tin anh em tự chọn. Bài này dùng một chỉ mục toàn cầu do GDELT dựng, không tải nội dung bài báo. Output là danh sách URL và metadata. Việc mở từng bài và đọc nội dung là bước khác, có quy tắc riêng của từng website.
Giới hạn của lab cần nói ngay
Lab gọi DOC API với khoảng cách từ 8 tới 45 giây, phần lớn đều nhận HTTP 429 dù thông báo chỉ yêu cầu một lượt mỗi 5 giây. Lab dừng thử sau nhiều lần vì không muốn tạo thêm tải. Lab chưa nhận được danh sách bài báo nào từ DOC API. Dữ liệu thật trong bài đến từ tệp Mentions 15 phút công khai của GDELT, là tập dữ liệu khác, với máy chủ mô phỏng dạng artlist để kiểm logic.
Hiểu đúng hai nguồn
Tệp Mentions là danh sách lần nhắc tới sự kiện trong dữ liệu GDELT Events. DOC API là chỉ mục toàn văn với các mode riêng. Hai nguồn cùng hệ thống nhưng không cùng phạm vi. Mọi số trong bài về URL và tên miền chỉ mô tả tệp Mentions của hai giờ, không phải kết quả của DOC API.
Ai nên đọc
Bài hợp với nhà phân tích truyền thông, nhà nghiên cứu, kỹ sư dữ liệu dựng hệ thống theo dõi tin. Người cần số liệu thống kê chính xác về báo chí Việt Nam nên kết hợp nguồn trong nước. Bài không thay thế công cụ giám sát thương mại.
Những gì bài không làm
Bài không đánh giá chất lượng tin tức. Bài không đo sự quan tâm của công chúng. Bài không dùng mode hình ảnh. Bài không hướng dẫn vượt giới hạn gọi của GDELT.
Thuật ngữ dùng trong bài
Mode là loại đầu ra, như artlist hay timelinevol. Timespan là khoảng tính từ hiện tại. Seendate là thời điểm GDELT thấy bài, không phải ngày đăng. Sourcecountry là quốc gia của nguồn, không phải quốc gia trong nội dung. Coverage là những gì GDELT theo dõi được, không phải toàn bộ tin tức.
Truy vấn GDELT DOC với mode và time window theo nguồn, không coi coverage là toàn bộ tin tức với GDELT DOC API truy vấn tin
Phần này đi từ tài liệu tới lời gọi mẫu và các phản hồi thật lab nhận được.
Nguồn tài liệu đã đọc
Lab đọc bài giới thiệu GDELT DOC 2.0 API. Bài ghi API tìm trong cửa sổ trượt ba tháng gần nhất và theo dõi 65 ngôn ngữ. Tài liệu mô tả các toán tử truy vấn, tham số mode, format, timespan, startdatetime, enddatetime, maxrecords, sort. Phần tệp thô đọc từ trang dữ liệu GDELT.
Lời gọi mẫu
Endpoint là https://api.gdeltproject.org/api/v2/doc/doc. Tham số query chứa từ khóa và toán tử. Với mode artlist và format json, kết quả là danh sách bài. Ví dụ dưới gói trong hàm có giãn cách, vì giới hạn ở đây là điều đầu tiên anh em sẽ gặp.
import requests, time

s = requests.Session()
s.headers["User-Agent"] = "ProxyVN-docs-lab/1.0 (+https://proxy.vn/)"
G = "https://api.gdeltproject.org/api/v2/doc/doc"

def gd(**k):
    r = s.get(G, params=dict(format="json", **k), timeout=90)
    time.sleep(8)
    if r.status_code == 429:
        raise RuntimeError("429: " + r.text[:60])
    return r

r = gd(query='"air pollution" sourcecountry:VM', mode="artlist",
       maxrecords=75, timespan="3d")
print(r.status_code, r.text[:200])
Trên máy lab, đoạn này dừng ở 429 gần như mọi lần. Theo tài liệu, khi thành công response có mảng articles, mỗi mục gồm url, title, seendate, domain, language, sourcecountry và vài trường khác. Anh em phải chạy lại để xác nhận tên trường.
Thông báo 429 nói gì
Thân lỗi là văn bản thuần, yêu cầu giới hạn một request mỗi 5 giây, gợi ý người dùng lưu lượng lớn chuyển sang bộ dữ liệu ngrams. Lab đã giãn tới 45 giây và vẫn nhận 429. Có thể giới hạn tính chung theo dải IP hoặc còn quy tắc khác, lab không biết. Lý do có thể không nằm ở nhịp gọi của riêng anh em.
Thân 429 không phải JSON
Thân lỗi là văn bản, dù anh em xin format=json. Gọi r.json() sẽ ném lỗi giải mã và che mất nguyên nhân thật. Hàm đọc phải kiểm status trước, rồi mới parse. Với API công cộng dùng chung, kiểu phản hồi này khá phổ biến.
Hai phản hồi 200 lạ
Trong loạt thử, lab có hai lần lọt qua giới hạn. Với maxrecords=500, API trả HTTP 200 và văn bản A maximum of 250 records can be returned. Tức lỗi tham số đi kèm mã 200. Với query hanoi trong cửa sổ 01/11 tới 02/11, API trả HTTP 200 và thân chỉ là {}. Lab không rõ {} là không có kết quả hay lý do khác. Script phải xử lý cả hai ca.
def parse(r):
    t = r.text.strip()
    if not t.startswith("{"):
        raise ValueError("khong phai JSON: " + t[:80])
    j = r.json()
    return j.get("articles", [])
Hàm này trả danh sách rỗng khi thân là {}, và báo lỗi rõ khi nhận văn bản. Hai ca đều đã thấy thật trong lab.
Tôn trọng giới hạn
Lab dừng gọi sau nhiều lần 429. Tiếp tục gọi không giúp gì, và có thể làm tình hình tệ hơn. Dùng nhiều IP để vượt giới hạn là đi ngược yêu cầu của nhà cung cấp dịch vụ miễn phí này. Với nhu cầu lớn, GDELT đã nêu lối đi là bộ dữ liệu tải về và kênh liên hệ.
Chọn DOC mode và time window có hỗ trợ trong GDELT DOC API truy vấn tin
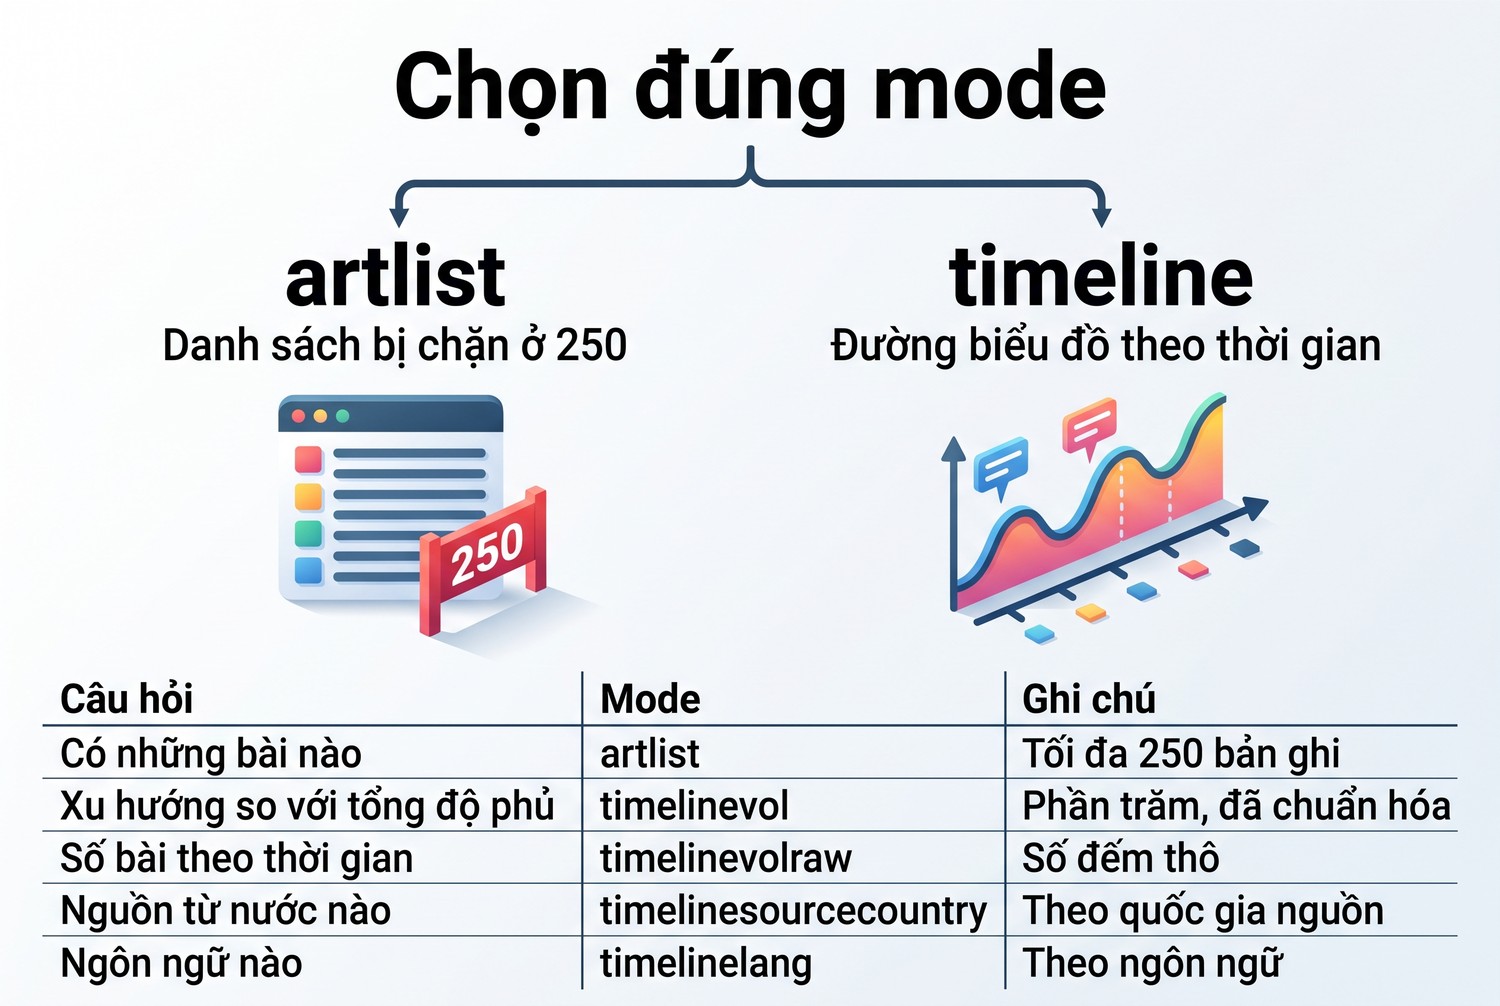
Chọn mode là chọn câu hỏi. Đừng dùng danh sách bài để trả lời câu hỏi về xu hướng.
Các mode chính
Chọn đúng mode
Theo tài liệu, mode artlist trả danh sách bài. Các mode timeline trả chuỗi thời gian: timelinevol theo phần trăm tổng độ phủ, timelinevolraw theo số đếm, timelinelang chia theo ngôn ngữ, timelinesourcecountry chia theo quốc gia nguồn, timelinetone theo sắc thái. Còn có các mode biểu đồ và ảnh.
Câu hỏi |
Mode |
Ghi chú |
|---|---|---|
Có những bài nào |
artlist |
Tối đa 250 bản ghi |
Xu hướng so với tổng độ phủ |
timelinevol |
Phần trăm, đã chuẩn hóa |
Số bài theo thời gian |
timelinevolraw |
Số đếm thô |
Nguồn từ nước nào |
timelinesourcecountry |
Theo quốc gia nguồn |
Ngôn ngữ nào |
timelinelang |
Theo ngôn ngữ |
Đếm bằng timeline, không đếm bằng artlist
Muốn biết số lượng bài, dùng timelinevolraw. Đếm độ dài danh sách artlist chỉ cho ra con số bị chặn tại 250. Muốn so giữa các thời điểm, timelinevol tốt hơn, vì đã chia cho tổng độ phủ. Nếu số bài toàn hệ thống tăng, số thô cũng tăng mà không phản ánh chủ đề.
Timespan
Tham số timespan nhận đơn vị phút, giờ, ngày, tuần, tháng theo tài liệu, ví dụ 3d hay 24h. Khoảng tính từ thời điểm hiện tại. Vì vậy cùng một lời gọi chạy lúc khác sẽ cho cửa sổ khác. Dataset cần lưu thời điểm gọi, nếu không sẽ không tái lập được.
Startdatetime và enddatetime
Cặp tham số này chốt khoảng cố định, dạng YYYYMMDDHHMMSS theo UTC. Lab khuyên dùng chúng cho mọi việc cần tái lập. Bài giới thiệu nói API tìm trong ba tháng gần nhất, nên khoảng cũ hơn có thể không có dữ liệu. Lab gửi một khoảng năm 2025 nhưng nhận 429, nên chưa xác nhận được hành vi.
Cửa sổ trượt ba tháng
Vì chỉ có ba tháng, nghiên cứu dài hạn không dùng DOC API đơn thuần được. Phải tự lưu dữ liệu đều đặn, hoặc dùng các bộ dữ liệu tải về. Một dự án bắt đầu hôm nay chỉ có thể nhìn lùi ba tháng. Điều này cần nói rõ ngay khi lập kế hoạch.
Múi giờ của cửa sổ
Mọi thời điểm trong GDELT tính theo UTC. Một ngày tại Việt Nam bắt đầu từ 17:00 UTC hôm trước. Nếu đặt khoảng theo ngày UTC rồi nói "ngày 01/11 tại Việt Nam", số sẽ lệch. Tệp thô của lab cũng dùng định dạng 20261105151500 theo UTC.
Định dạng trả về
Tham số format nhận json, csv, html, rss và các định dạng khác theo tài liệu. Với pipeline, json dễ xử lý. Với mode timeline, csv thường gọn hơn. Lab chỉ thử json.
Thiết kế query cùng output format và giới hạn record trong GDELT DOC API truy vấn tin
Phần này đi vào cú pháp truy vấn, và giới hạn 250 bản ghi là điểm mấu chốt.
Toán tử truy vấn
Tài liệu có cụm từ trong ngoặc kép, nhóm OR trong ngoặc đơn, dấu trừ để loại. Toán tử sourcecountry lọc quốc gia nguồn, sourcelang lọc ngôn ngữ, domain lọc tên miền, repeat yêu cầu từ khóa xuất hiện đủ số lần, near tìm các từ gần nhau, theme lọc theo chủ đề GKG. Lab chưa kiểm được từng toán tử.
Mã quốc gia là FIPS
Bài giới thiệu ghi sourcecountry nhận tên liền không dấu cách hoặc mã FIPS hai ký tự. Việt Nam theo FIPS là VM, không phải VN theo ISO. Trong brief, lab dùng sourcecountry:VM. Nhầm với ISO có thể cho kết quả của nước khác. Anh em nên kiểm mã trước khi chạy hàng loạt.
Từ khóa ngắn
Từ khóa quá ngắn hoặc quá phổ biến có thể bị từ chối theo tài liệu. Lab gửi query ha nhưng nhận 429 nên chưa thấy phản hồi. Cụm trong ngoặc kép giúp truy vấn chính xác hơn. Một truy vấn rộng cũng dễ chạm trần 250 hơn.
Giới hạn maxrecords
Mặc định theo tài liệu là 75, tối đa 250. Lab xác nhận trần 250 bằng thông báo thật. Điều này có nghĩa artlist chỉ cho tối đa 250 bài mỗi lời gọi, không có phân trang. Danh sách luôn là một phần nhỏ của truy vấn rộng.
Sort quyết định phần được thấy
Tham số sort có datedesc, dateasc, tonedesc, toneasc, hybridrel. Vì có trần 250, sort quyết định 250 bài nào anh em thấy. Với datedesc, anh em thấy các bài mới nhất của cửa sổ, và phần đầu cửa sổ bị bỏ. Đọc kết quả mà không biết sort là đọc thiếu ngữ cảnh.
Mô phỏng trần 250
Lab dựng máy chủ cục bộ trả dạng artlist từ 4637 URL thật của tệp Mentions, xếp theo thời gian giảm dần, cắt ở 250. Gọi một cửa sổ hai giờ thì nhận đủ 250 bản ghi, tất cả mang cùng một mốc 20261105T151500Z. Nghĩa là danh sách chỉ phủ khung 15 phút cuối, dù anh em xin hai giờ.
one = call(st, en)
print(len(one), one[0]["seendate"], one[-1]["seendate"])
# 250 20261105T151500Z 20261105T151500Z
Hàm call gọi máy chủ lab với startdatetime, enddatetime và maxrecords=250. Dòng chú thích là output thật của lab. Với API thật, phân bố có thể khác, nhưng nguyên lý giống nhau: nhận đúng 250 bản ghi là dấu hiệu đã bị cắt.
Phép thử bị cắt
Quy tắc rất đơn giản: nếu số bản ghi bằng maxrecords thì coi như bị cắt. Lúc đó không được đếm, không được kết luận "chỉ có 250 bài". Dataset nên có cột truncated cho mỗi truy vấn.
Chia cửa sổ để lấy thêm
Cách phổ biến là chia đôi cửa sổ khi chạm trần, rồi đệ quy. Lab cài đặt như dưới và thử trên máy chủ mô phỏng.
import datetime as D

def split(a, b, out):
    x = call(a, b)
    if len(x) < 250 or (b - a) <= D.timedelta(minutes=1):
        out.extend(x)
        return 1
    m = a + (b - a) / 2
    return 1 + split(a, m, out) + split(m, b, out)

got = []
n = split(st, en, got)
print(n, len(got), len({x["url"] for x in got}))
Kết quả thật của lab: 79 lời gọi, 2000 bản ghi, 2000 URL duy nhất, trên tổng 4637. Vẫn thiếu hơn một nửa.
Vì sao chia nhỏ vẫn thiếu
Tệp Mentions của lab chỉ có độ chia 15 phút, nên tám mốc chứa từ 502 tới 677 URL mỗi mốc. Cửa sổ nhỏ tới đâu thì một mốc vẫn trên 250, nên không thể tách tiếp. Tám mốc nhân 250 ra đúng 2000. Nếu seendate có độ chia thô, chia nhỏ cửa sổ có giới hạn của nó. Khi đó phải thu hẹp truy vấn theo ngôn ngữ, nguồn hoặc từ khóa.
Chi phí của việc chia
Với API thật ở một lượt mỗi 5 giây, 79 lời gọi mất hơn 6 phút trong điều kiện tốt. Máy lab còn không qua được lượt đầu. Vì vậy chiến lược chia cửa sổ cần được dùng tiết kiệm. Chia theo truy vấn hẹp hơn thường hiệu quả hơn chia theo thời gian.
Chuẩn hóa URL, source country và thời điểm quan sát của GDELT DOC API truy vấn tin
Phần này dùng dữ liệu thật từ tệp Mentions để làm rõ các trường cần giữ.
Tải tệp 15 phút
Dòng khác URL
Tệp lastupdate.txt liệt kê ba tệp mới nhất: export, mentions, gkg, kèm kích thước và MD5. Lab đọc qua HTTPS, vì http trả 301. Tên tệp theo mốc 15 phút, ví dụ 20261105151500.mentions.CSV.zip. Lab tải tám tệp, tức hai giờ.
import csv, io, zipfile, re

B = "https://data.gdeltproject.org/gdeltv2/"
t = s.get(B + "lastupdate.txt", timeout=60).text
last = re.search(r"/(\d{14})\.mentions", t).group(1)
r = s.get(B + last + ".mentions.CSV.zip", timeout=60)
z = zipfile.ZipFile(io.BytesIO(r.content))
rows = list(csv.reader(io.StringIO(z.read(z.namelist()[0]).decode("utf-8", "replace")), delimiter="\t"))
print(last, len(r.content), len(rows), len(rows[0]))
Output cho mốc 15:15 UTC là tệp 148955 byte, 4353 dòng, 16 cột. Tám tệp có từ 3020 tới 4353 dòng. Khối lượng này nhỏ, tải hằng ngày rất nhẹ.
Cột của tệp Mentions
Theo vị trí, lab dùng cột 0 mã sự kiện, cột 1 thời điểm sự kiện, cột 2 thời điểm nhắc, cột 3 loại nguồn, cột 4 tên nguồn, cột 5 URL, cột 11 độ tin cậy. Tổng 29080 dòng trong hai giờ đều có MentionType 1, tức web. Không có tiêu đề cột trong tệp, nên phải đặt theo tài liệu codebook.
Dòng khác URL
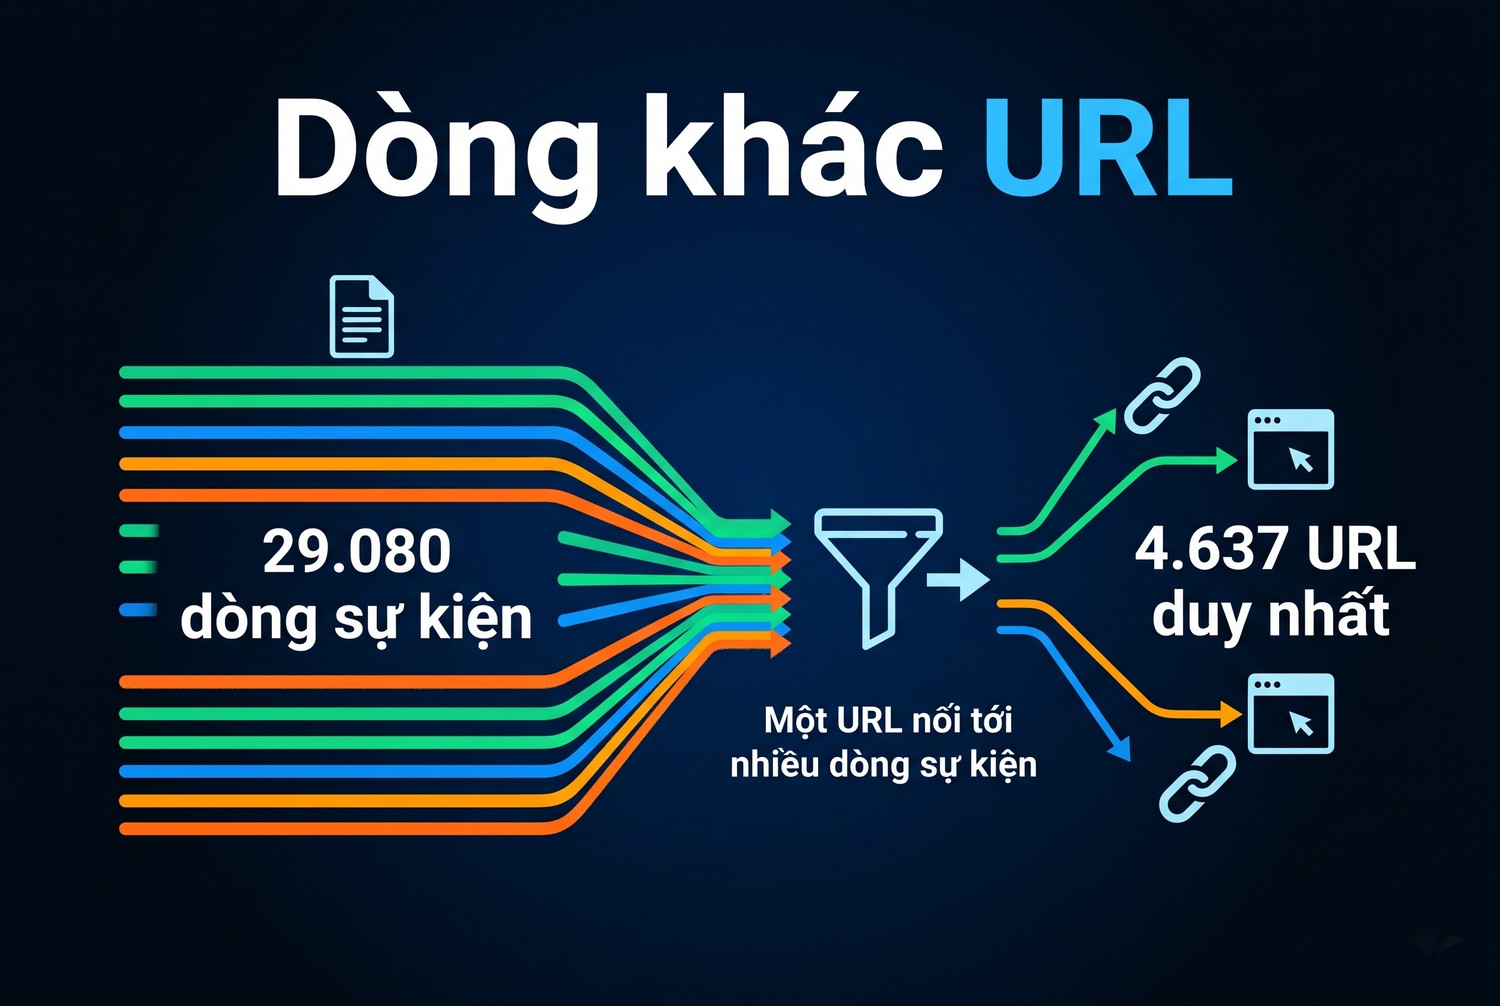
Từ 29080 dòng chỉ còn 4637 URL duy nhất, thuộc 1188 tên miền. Một bài nhắc nhiều sự kiện nên sinh nhiều dòng, trung bình hơn sáu dòng mỗi URL. Đếm dòng sẽ phóng đại gấp sáu lần. Khóa đếm bài là URL, không phải dòng.
Tên miền chiếm nhiều nhất
Trong 4637 URL, iheart.com có 233, indiatimes.com 69, prnewswire.com 55, thehindu.com 52, manilatimes.net 38, webindia123.com 32. Một vài nguồn cung cấp lượng URL lớn. Số đếm theo bài vì thế bị ảnh hưởng bởi cách một nguồn xuất bản, không chỉ bởi mức quan tâm.
Độ phủ tiếng Việt trong mẫu
Trong hai giờ của lab chỉ có 4 URL thuộc tên miền .vn, đều từ news.tuoitre.vn. Không URL nào có hanoi hay ha-noi trong đường dẫn. Mẫu rất nhỏ và là tệp Mentions, không phải chỉ mục DOC, nên không kết luận về toàn bộ GDELT. Nhưng nó đủ để nhắc rằng dữ liệu này có thể thưa với báo Việt Nam. Báo .com.vn hay đuôi khác không bị đếm trong con số 4 nếu không kết thúc bằng .vn, phép lọc của lab chỉ theo đuôi tên miền.
Seendate không phải ngày đăng
Trong tệp Mentions, thời điểm nhắc là lúc GDELT xử lý, theo mốc 15 phút. Ngày đăng thật của bài có thể sớm hơn. Trong artlist, seendate có ý nghĩa tương tự theo tài liệu. Báo cáo phải dùng chữ "được GDELT ghi nhận vào", không dùng "được đăng vào".
Thời điểm sự kiện khác thời điểm nhắc
Dòng đầu của lab có thời điểm sự kiện 20251105000000 và thời điểm nhắc 20261105151500, tức một bài hôm nay nhắc sự kiện một năm trước. Trong 29080 dòng, 146 dòng có ngày sự kiện khác ngày nhắc. Với theo dõi tin, cột thời điểm nhắc là cột cần dùng, và hai cột không được lẫn.
Độ tin cậy
Cột độ tin cậy có các giá trị 20 với 6915 dòng, 100 với 5063 dòng, 10 với 4191 dòng, 40 với 3598 dòng, 60 với 2461 dòng trong lần đếm của lab. Giá trị thấp nghĩa là liên kết giữa bài và sự kiện ít chắc hơn theo cách mã hóa của GDELT. Không lọc thì nhiễu lọt vào. Ngưỡng là quyết định của dự án.
Chuẩn hóa URL
URL có thể mang tham số theo dõi, bản di động hay http và https khác nhau. Trước khi khử trùng, anh em bỏ fragment và các tham số theo dõi đã biết, hạ chữ thường tên miền. Lưu cả URL gốc, vì bản chuẩn hóa chỉ để so sánh.
from urllib.parse import urlsplit, urlunsplit, parse_qsl, urlencode

DROP = {"utm_source", "utm_medium", "utm_campaign", "fbclid", "gclid"}

def canon(u):
    p = urlsplit(u)
    q = [(k, v) for k, v in parse_qsl(p.query) if k not in DROP]
    return urlunsplit(("https", p.netloc.lower(), p.path.rstrip("/"), urlencode(q), ""))

print(canon("HTTP://WWW.Example.com/a/?utm_source=x&id=7#top"))
Hàm in ra https://www.example.com/a?id=7. Danh sách DROP là tự chọn, anh em bổ sung theo dữ liệu thực tế.
Sourcecountry là nơi đặt nguồn
Sourcecountry cho biết nguồn đặt ở đâu theo GDELT, không phải bài viết về nước nào. Một báo Ấn Độ viết về Việt Nam có sourcecountry Ấn Độ. Muốn tin về Việt Nam, dùng từ khóa hoặc theme, không dùng sourcecountry. Hai cách đặt câu hỏi khác nhau dẫn tới hai bộ dữ liệu khác nhau.
Nêu giới hạn coverage, truncation trước khi so sánh nguồn tin trong GDELT DOC API truy vấn tin
Phần này giữ cho kết luận không vượt quá dữ liệu.
Ba lớp giới hạn
Ba lớp giới hạn
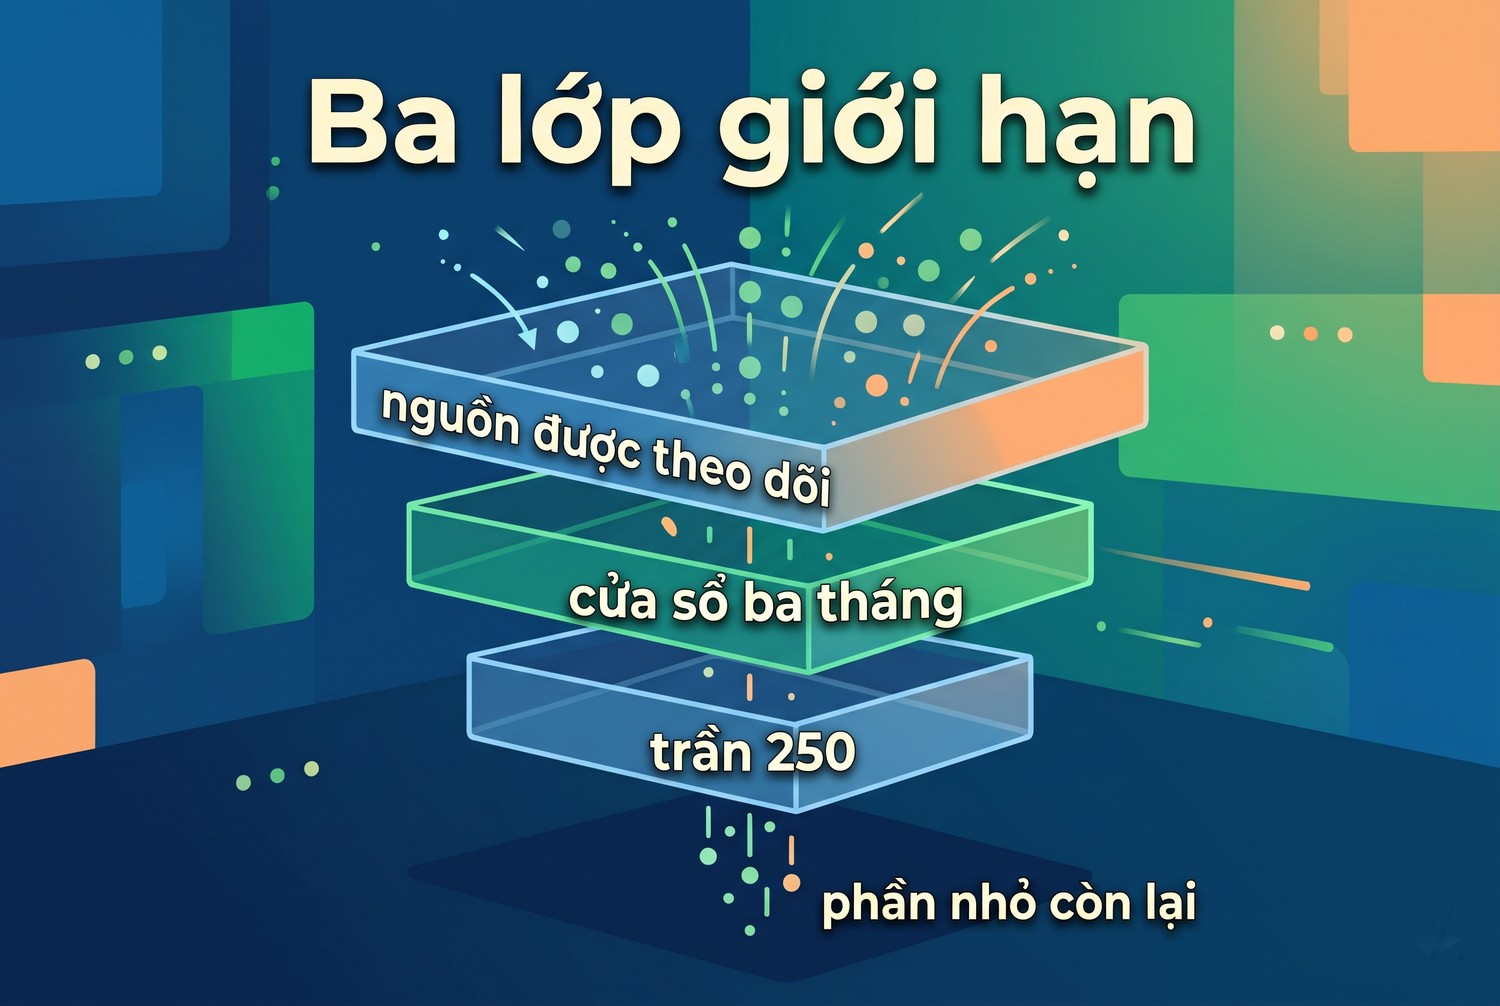
Lớp đầu là GDELT chỉ theo dõi những nguồn nó biết. Lớp hai là cửa sổ ba tháng. Lớp ba là trần 250 và sort. Một con số cuối cùng đi qua cả ba lớp này. Viết "báo chí đưa tin X lần" là đã bỏ qua cả ba lớp.
Câu nên viết và không nên viết
Nên viết: "Trong dữ liệu GDELT, ghi nhận 120 bài theo truy vấn Q trong cửa sổ W". Không nên viết: "Có 120 bài báo về chủ đề này". Không nên suy ra số người quan tâm từ số bài. Câu chính xác dài hơn một chút nhưng chịu được phản biện.
So hai nguồn tin
So số bài giữa hai nguồn trong GDELT chỉ cho thấy khác biệt trong phần được theo dõi. Một nguồn có thể bị thiếu vì cách GDELT phát hiện, không phải vì đăng ít. Trong mẫu của lab, iheart.com có 233 URL là vì mạng lưới trang địa phương, không phải vì một tòa soạn. Cần đọc tên miền trước khi kết luận.
So hai thời điểm
Dùng timelinevol để so giữa hai thời điểm, vì đã chuẩn hóa theo tổng. Trong tám mốc của lab, số dòng dao động từ 3020 tới 4353 chỉ trong hai giờ. Tổng độ phủ thay đổi theo giờ trong ngày, nên số thô không phải đơn vị tốt.
Ngôn ngữ và dịch máy
GDELT theo dõi nhiều ngôn ngữ và dịch để tìm kiếm theo tài liệu. Từ khóa tiếng Anh có thể khớp bài ngôn ngữ khác qua dịch máy. Vì vậy bài tiếng Việt có thể khớp truy vấn tiếng Anh. Lab không kiểm được chất lượng phần này. Với truy vấn tiếng Việt, anh em nên thử kèm sourcelang.
Nguồn bị thiếu không tự hiện ra
Dữ liệu không cho biết cái gì không có. Muốn đánh giá độ phủ, anh em chọn vài nguồn đã biết, kiểm xem GDELT có các bài cụ thể không. Phép kiểm tay vài chục bài là đủ để có một câu nhận định trung thực trong báo cáo. Lab chưa làm phép kiểm này.
Kết hợp với nguồn trực tiếp
Với báo Việt Nam, RSS của tòa soạn cho số trực tiếp hơn. GDELT hợp để nhìn phạm vi quốc tế. Hai nguồn bổ sung cho nhau, và dataset nên có cột source_system để không trộn lẫn.
Tệp Mentions dùng khi nào
Khi DOC API bị chặn hoặc cần lưu lâu dài, tệp 15 phút là lựa chọn ổn định, không có trần 250. Nhược điểm là không có tiêu đề bài, không tìm kiếm toàn văn, chỉ gồm bài gắn với sự kiện. Lab đã dùng đường này và chạy tốt. Tải đều đặn thì sẽ có lịch sử riêng vượt khỏi cửa sổ ba tháng.
Không tải bài tự động
Danh sách URL không cho quyền tải và tái sử dụng nội dung. Mỗi website có robots, điều khoản và bản quyền riêng. Nếu cần mở bài, anh em giữ nhịp, tôn trọng robots, và không lưu toàn văn khi không có quyền. Phần này nằm ngoài phạm vi GDELT.
Proxy có cần không
Không phải để vượt giới hạn của DOC API. Dịch vụ miễn phí này yêu cầu giảm nhịp, nên xoay IP là trái ý. Với 429 như lab gặp, cách đúng là dùng tệp thô, chờ, hoặc liên hệ theo thông báo. Cách đặt nhịp có ở bài rate limit API khi dùng proxy, lỗi này có ở bài lỗi 429 khi dùng proxy.
Khi mạng công ty bắt buộc
Nếu buộc đi qua cổng ra, chuỗi cấu hình theo định dạng proxy. Vai trò proxy trong thu thập có ở bài Web Scraping proxy là gì.
Các tác vụ khác cần IP ổn định thì anh em có thể mua proxy giá rẻ tại trang chủ ProxyVN.
Khóa phiên bản
Lab chạy Python 3.12.10, requests 2.34.2. API ở đường dẫn v2. Dữ liệu thô ghi theo mốc thời gian tệp. Cấu hình truy vấn ghi nguyên văn query, mode, sort, cửa sổ.
Đầu ra nghiệm thu dataset URL, source country, seen date và phép thử cửa sổ thời gian của GDELT DOC API truy vấn tin
Mục này chốt bảng và danh sách kiểm.
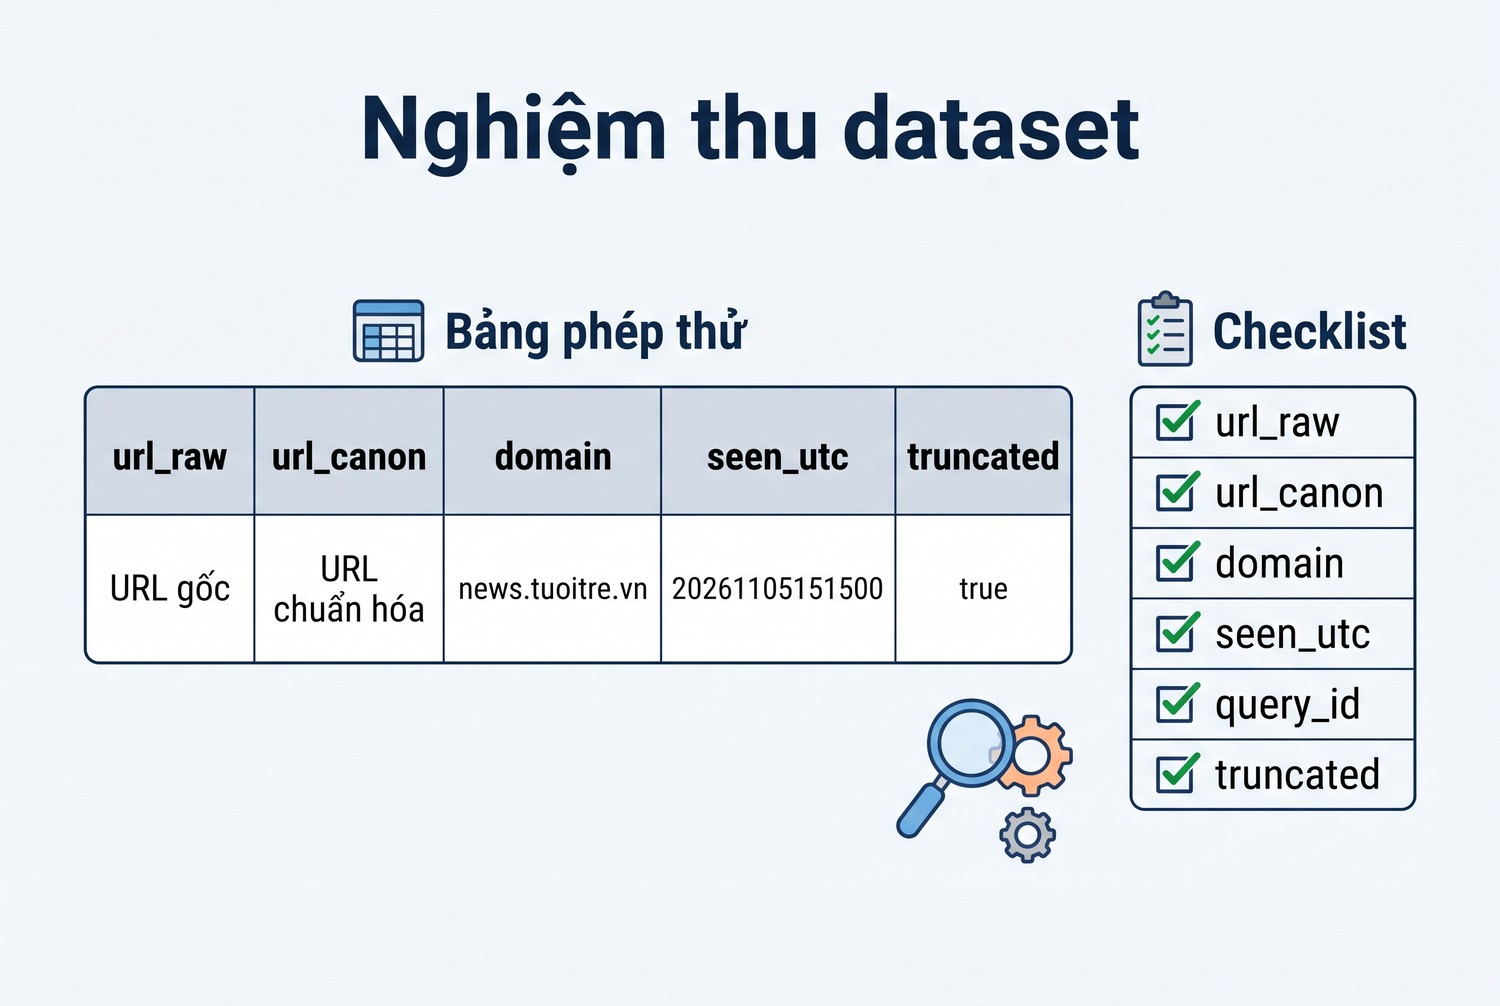
Schema của bảng
Nghiệm thu dataset
Cột |
Ví dụ |
Ghi chú |
|---|---|---|
url_raw |
URL gốc |
Giữ nguyên |
url_canon |
URL chuẩn hóa |
Khóa đếm |
domain |
news.tuoitre.vn |
Từ tệp Mentions |
sourcecountry |
VM |
Từ artlist, lab chưa thấy thật |
language |
Vietnamese |
Từ artlist, lab chưa thấy thật |
seen_utc |
20261105151500 |
Thời điểm GDELT ghi nhận |
query_id |
q01 |
Trỏ tới cấu hình |
truncated |
true |
Bằng maxrecords |
source_system |
gdelt_mentions |
Hoặc gdelt_doc |
Bảng phép thử cửa sổ
Phép thử |
Kết quả lab |
Nguồn |
|---|---|---|
maxrecords=500 |
Văn bản báo tối đa 250 |
API thật |
Cửa sổ hai giờ |
250, đều mốc 15:15 |
Mô phỏng từ URL thật |
Chia đôi cửa sổ |
79 lời gọi, 2000 trên 4637 |
Mô phỏng từ URL thật |
Khoảng 01/11 tới 02/11 |
200 với {} |
API thật |
Danh sách kiểm
- Mode: đếm dùng timeline, danh sách dùng artlist.
- Cửa sổ: khoảng cố định theo UTC, có lưu thời điểm gọi.
- Trần: bằng 250 thì gắn truncated.
- Khóa: đếm theo URL chuẩn hóa, không theo dòng.
- Câu chữ: dùng "ghi nhận trong GDELT".
- Nhịp: tôn trọng 429, không xoay IP.
Câu kết luận được phép viết
Từ lab có thể viết rằng trong hai giờ tệp Mentions có 4637 URL từ 1188 tên miền và chỉ 4 URL kết thúc bằng .vn. Trần 250 được xác nhận bằng thông báo thật. Không nên viết gì về nội dung artlist thật hay toán tử cụ thể, vì lab chưa nhận được kết quả.
Những gì lab chưa chạy
Lab chưa nhận được kết quả artlist hay timeline thành công. Tên trường của artlist, các toán tử và hành vi sort lấy từ tài liệu. Máy chủ mô phỏng dùng độ chia 15 phút của tệp Mentions, seendate thật có thể mịn hơn. Lab chưa đọc GKG và chưa kiểm độ phủ bằng tay.
Số bài trong GDELT là số được ghi nhận trong phạm vi nó theo dõi, qua cửa sổ và trần bản ghi. Nó không phải số bài của toàn bộ báo chí.
GDELT DOC API truy vấn tin: câu hỏi thường gặp
Các câu dưới đây gom những điểm hay bị hỏi.
Có cần khóa API không?
Không cần khóa. Nhưng có giới hạn nhịp, và lab nhận 429 dù đã giãn tới 45 giây.
Tôi lấy được hơn 250 bài một lần không?
Không. Lab thấy thông báo tối đa 250. Chia cửa sổ hoặc thu hẹp truy vấn.
Nhận đúng 250 bài nghĩa là gì?
Nhiều khả năng đã bị cắt. Không dùng số này để đếm.
Muốn đếm số bài dùng gì?
Dùng mode timelinevolraw, hoặc timelinevol nếu so theo thời gian.
API xem được bao xa?
Bài giới thiệu ghi cửa sổ trượt ba tháng. Lâu hơn thì phải tự lưu.
Sourcecountry:VM có phải tin về Việt Nam?
Không. Đó là nguồn đặt tại Việt Nam. Tin về Việt Nam dùng từ khóa hoặc theme.
Gặp 429 thì làm gì?
Dừng, giãn nhịp, dùng tệp thô, hoặc liên hệ theo thông báo. Không xoay IP.
Có thể kết luận báo chí Việt Nam đăng ít không?
Không. Mẫu rất nhỏ, và chỉ phản ánh phần GDELT theo dõi.
GDELT DOC API truy vấn tin và những điều cần nhớ
GDELT DOC API truy vấn tin hữu ích khi anh em chọn đúng mode, chốt cửa sổ UTC, gắn cờ khi chạm trần 250 và viết rõ phạm vi độ phủ thay vì nói về toàn bộ báo chí. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em tôn trọng giới hạn khi dùng GDELT DOC API truy vấn tin.


