
fsspec tầng lưu tệp crawl: một adapter cho local và remote
fsspec tầng lưu tệp crawl là cách cho parser đọc tệp qua một giao diện chung. Cùng một đoạn mã chạy được trên thư mục local, bộ nhớ, máy chủ HTTP hay kho đối tượng mà không đổi dòng nào. Downloader và parser không cần biết tệp nằm ở đâu. ProxyVN chạy fsspec thật với ba backend trên cùng fixture, đo số request, kiểm cache cùng đường dẫn, đọc theo Range và tìm ra một chỗ fsspec gộp lỗi mạng vào lỗi không có tệp.
fsspec tầng lưu tệp crawl: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và giới hạn.
Bài toán cần giải
Một nhóm có crawler ghi HTML ra ổ đĩa khi chạy thử, ra kho đối tượng khi chạy thật, và đôi khi đọc thẳng từ máy chủ lưu trữ nội bộ qua HTTP. Mỗi môi trường có một nhánh mã đọc tệp riêng. Parser được kiểm trên ổ đĩa nhưng hỏng trên kho thật vì khác chế độ mở tệp. Một tầng lưu tệp chung giải quyết chuyện này.
Đầu ra nghiệm thu
Đầu ra là một adapter nhỏ dùng fsspec, chạy cùng một hàm parse trên fixture local, memory và HTTP, cho cùng kết quả. Kèm theo là phép kiểm cache cùng đường dẫn: lần đọc thứ hai không gửi request, và cache trả dữ liệu cũ khi máy chủ đã đổi. Thêm bảng phân loại lỗi backend và lỗi parser.
Ranh giới với bài rclone
Bài về rclone trong blog nói về công cụ dòng lệnh đồng bộ tệp giữa các kho. fsspec là thư viện Python để mở tệp ngay trong mã. Hai thứ có thể cùng tồn tại: rclone chép tệp, fsspec đọc tệp. Bài này không bàn đồng bộ.
Không gắn proxy vào parser
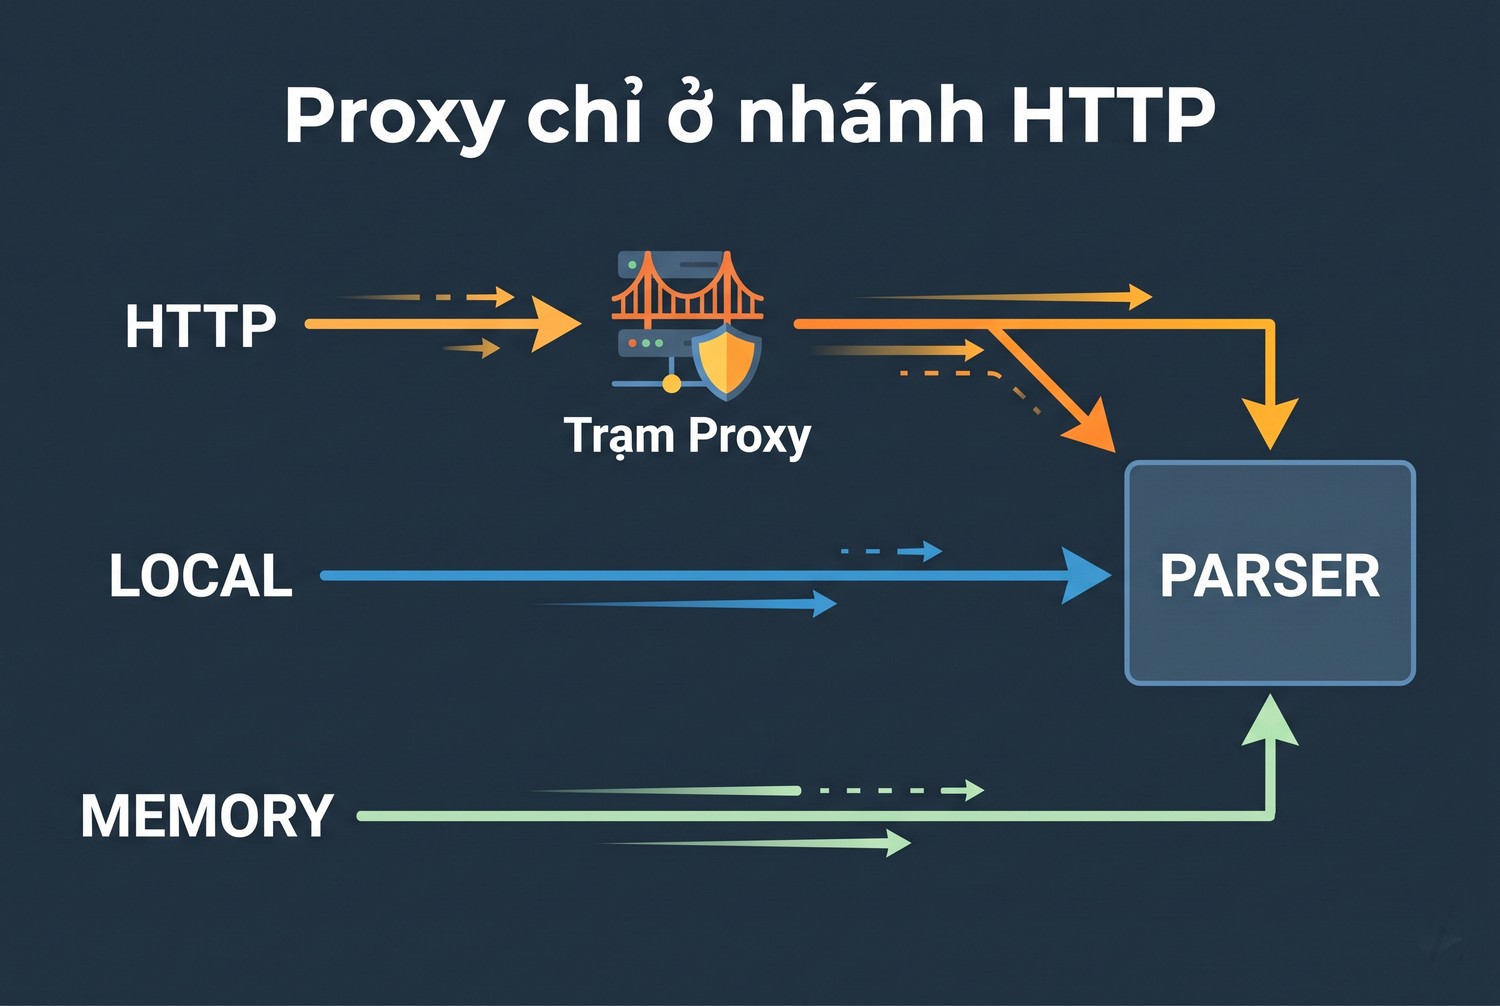
Parser là mã offline, không cần mạng. Proxy chỉ thuộc về backend HTTP khi tệp thật sự nằm trên máy chủ ngoài. Lab sẽ cho thấy cùng adapter, cấu hình proxy chỉ ảnh hưởng backend HTTP, còn local và memory không gửi gì qua proxy.
Giới hạn của lab
Lab chạy fsspec 2026.9.0 và aiohttp 3.14.5 thật. Máy chủ HTTP là máy chủ Python tự viết có hỗ trợ Range, cổng 9483. Proxy là một forward proxy tối giản tự viết, cổng 9484. Lab không dùng kho đối tượng thật, backend remote được phép duy nhất là máy chủ HTTP cục bộ.
Ai nên đọc bài này
Người viết crawler bằng Python cần chạy cùng mã trên máy dev và trên kho thật. Người đã có parser chạy tốt trên tệp local và cần đưa lên kho đối tượng. Người từng thấy lỗi không có tệp mà thật ra máy chủ đang hỏng.
fsspec tầng lưu tệp crawl: tách filesystem interface khỏi downloader
Phần này tóm tắt tài liệu chính thức và cách nghĩ về tầng lưu tệp.
Một giao diện cho nhiều backend
Trang Features of fsspec mô tả các tính năng giúp fsspec khác các lớp trừu tượng hệ thống tệp khác. Danh sách gồm tuần tự hóa, OpenFile, đệm và truy cập ngẫu nhiên, chế độ text và nén trong suốt, bộ nhớ, cache, nối chuỗi URL. Mỗi backend được chọn bằng tiền tố trong URL.
OpenFile là chỗ giữ chỗ
Tài liệu nêu lớp OpenFile cho phép mô tả cách mở một tệp, ở local, remote hay trong kho nén, kèm nén và chế độ text. Bản thân OpenFile không chứa tệp đang mở. Chỉ khi vào khối with mới tạo đối tượng tệp thật.
of = fsspec.open(url, "rb")   # chua mo gi
with of as f:                  # luc nay moi mo
    data = f.read()
Tuần tự hóa được
Tài liệu nêu OpenFile tuần tự hóa được vì không chứa tệp đang mở. Lab pickle một OpenFile trỏ tới HTTP, giải tuần tự, mở lại và parse được. Điều này giúp gửi công việc cho worker khác mà chỉ cần truyền OpenFile, không truyền nội dung.
Đệm và truy cập ngẫu nhiên
Tài liệu nêu fsspec dùng đệm theo khối cho tệp remote, nên seek rồi đọc một đoạn nhỏ không cần tải cả tệp. Với HTML nhỏ thì không đáng kể. Với tệp lưu trữ lớn, như WARC hay Parquet, đây là điểm quyết định.
Text và nén trong suốt
Tài liệu nêu fsspec áp dụng chế độ text và giải nén trong suốt. Tham số compression bằng infer suy kiểu nén từ đuôi tệp. Parser không cần biết tệp có nén hay không.
Cache bằng cách bọc filesystem
Tài liệu nêu hai cơ chế cache cục bộ, đều bọc một filesystem đích: simplecache và filecache chép cả tệp, blockcache chỉ tải các khối được đọc. Cache có thể tạm thời theo tiến trình hoặc nằm ở thư mục cố định.
Nối chuỗi URL
Tài liệu nêu có thể nối các tầng bằng dấu hai chấm kép, ví dụ simplecache nối với gcs, hoặc zip nối với simplecache nối với gcs. Tham số cho từng tầng truyền theo tên giao thức. Adapter của lab dùng đúng cách này để bật cache mà không đổi mã parse.
Tính năng |
Ý nghĩa cho crawl |
|---|---|
OpenFile |
Truyền tệp cho worker mà không mở |
compression infer |
Parser đọc được tệp gz |
simplecache, filecache |
Đọc lại không tải lại |
blockcache |
Tệp lớn chỉ tải phần cần |
URL chaining |
Bật cache bằng tiền tố |
fsspec tầng lưu tệp crawl: mở fixture local qua filesystem và OpenFile
Phần này dựng fixture, hàm parse và adapter.
Fixture
Lab có bốn tệp: hai trang sản phẩm, một trang lỗi không có giá, một tệp nhị phân lớn 1MB để thử Range, và một trang nén gzip. Cùng nội dung được đặt ở ba nơi: thư mục local, filesystem memory và máy chủ HTTP.
Hàm parse không biết backend
Hàm parse chỉ nhận một đối tượng tệp, đọc, tìm tiêu đề và giá. Nó không mở tệp, không biết URL.
def parse(f):
    html = f.read()
    if isinstance(html, bytes): html = html.decode("utf-8")
    t = re.search(r"<title>(.*?)</title>", html)
    pr = re.search(r"class=price>(\d+)<", html)
    if not pr: raise ValueError("khong thay gia")
    return t.group(1), int(pr.group(1))
Không thấy giá thì ném ValueError. Đây là lỗi của parser, phân biệt với lỗi của backend ở phần sau.
Adapter
Adapter giữ gốc URL và tùy chọn lưu trữ, mở tệp theo đường dẫn tương đối và gọi parse.
class Store:
    def __init__(self, root, **opts):
        self.root, self.opts = root.rstrip("/"), opts
    def open(self, rel, mode="rb", **kw):
        return fsspec.open(f"{self.root}/{rel}", mode, **self.opts, **kw)
    def parse(self, rel, **kw):
        with self.open(rel, **kw) as f:
            return parse(f)
Toàn bộ khác biệt giữa môi trường nằm ở chuỗi gốc và tùy chọn khi khởi tạo.
Ba backend
Ba adapter khác nhau ở gốc URL: file cộng đường dẫn thư mục, memory với tiền tố crawl, http tới máy chủ lab.
stores = {"local": Store("file://.../fixture"),
          "memory": Store("memory://crawl"),
          "http": Store("http://127.0.0.1:9483")}
Kết quả trên ba backend
Ba backend một kết quả
Cùng hai trang, cùng hàm parse, ba backend cho cùng kết quả. Cột cuối là số request HTTP mà máy chủ lab nhận được.
[local] p/1: ('Bàn phím cơ', 450000) p/2: ('Chuột', 390000) | request HTTP: 0
[memory] p/1: ('Bàn phím cơ', 450000) p/2: ('Chuột', 390000) | request HTTP: 0
[http] p/1: ('Bàn phím cơ', 450000) p/2: ('Chuột', 390000) | request HTTP: 4
Hai trang trên HTTP tốn bốn request. Phần sau giải thích vì sao.
Mỗi tệp HTTP tốn hai request
Log máy chủ cho thấy mỗi lần mở tệp, fsspec gửi một HEAD để biết kích thước rồi một GET để lấy nội dung. Với hàng nghìn tệp nhỏ, số request gấp đôi. Nếu máy chủ tính giới hạn theo request, con số này cần tính trước. Cache ở phần sau giảm được phần này.
Memory cho kiểm thử
Filesystem memory sống trong tiến trình, mất khi tiến trình kết thúc. Nó hợp cho test đơn vị của parser: nạp fixture bằng pipe, chạy parser qua adapter, không chạm đĩa hay mạng. Test chạy nhanh và không phụ thuộc thư mục làm việc.
Đường dẫn local trên Windows
Lab chạy trên Windows, đường dẫn thư mục được đổi gạch chéo ngược thành gạch chéo xuôi rồi ghép với tiền tố file. fsspec chấp nhận dạng này. Mã chuyển đường dẫn nên nằm trong adapter, đừng để rải rác trong parser.
fsspec tầng lưu tệp crawl: đổi sang backend remote bằng cùng interface
Phần này đi sâu vào HTTP, nén, chế độ text và proxy.
Nén suy từ đuôi tệp
Trang gz được parse đúng trên cả ba backend khi truyền compression bằng infer. Không truyền tham số này, parser nhận byte nén và ném lỗi giải mã.
[http] gz infer: ('Tai nghe', 250000)
[http] gz KHONG infer: UnicodeDecodeError 'utf-8' codec can't decode byte 0x8b in position 1
Byte 0x8b ở vị trí 1 là dấu hiệu của tệp gzip. Thấy lỗi này, kiểm tham số nén trước khi nghi parser.
Chế độ text
Mở bằng rt kèm encoding, đối tượng tệp trả chuỗi thay vì byte. Lab mở cùng trang tiếng Việt với hai encoding.
[http] rt utf-8: str
[http] rt latin-1 (sai): Bà n phÃm cÆ¡Encoding sai không báo lỗi, chỉ ra chữ vỡ. Parser nhận chuỗi vỡ vẫn chạy và ghi dữ liệu sai. Với HTML, đọc ở chế độ nhị phân rồi giải mã theo charset của trang an toàn hơn đoán encoding khi mở.
Proxy chỉ gắn ở backend HTTP
Proxy chỉ ở nhánh HTTP
Lab tạo adapter HTTP với tùy chọn proxy trỏ tới forward proxy lab. fsspec chuyển tham số này cho aiohttp ở mỗi request. Proxy thấy cả HEAD lẫn GET với URL đầy đủ.
qua proxy: ('Chuột', 390000) | proxy thay: [('HEAD', 'http://127.0.0.1:9483/p/2.html'), ('GET', 'http://127.0.0.1:9483/p/2.html')]
local/memory qua proxy: 0 request
Parse trên local và memory không gửi gì qua proxy.
Vì sao đặt proxy ở adapter
Đặt proxy ở biến môi trường của cả tiến trình thì mọi thư viện HTTP đều có thể đi qua proxy, kể cả lệnh gọi tới kho nội bộ. Đặt ở tùy chọn của adapter HTTP thì chỉ đúng backend cần proxy mới dùng. Kho nội bộ đi thẳng, không tốn băng thông proxy.
Tùy chọn khác của aiohttp
Tham số client_kwargs của HTTPFileSystem chuyển xuống phiên aiohttp. Muốn dùng biến môi trường thì bật trust_env. Lab dùng tham số proxy trực tiếp vì rõ ràng hơn và kiểm được bằng log. Thông tin đăng nhập proxy không ghi vào log của adapter.
Kho đối tượng
Với kho đối tượng như S3, fsspec dùng gói riêng như s3fs. Adapter chỉ đổi gốc URL sang s3 và thêm tùy chọn khóa. Lab không có kho thật nên không chạy ca này. Cấu trúc adapter giữ nguyên, đó là mục đích của tầng lưu tệp.
Ghi qua adapter
Lab chỉ đọc. Ghi qua fsspec dùng cùng hàm open với chế độ wb. Với kho đối tượng, tệp chỉ xuất hiện khi đóng, nên ghi dở rồi chết không để lại tệp hỏng. Với local, ghi dở thì có tệp dở. Adapter nên ghi vào tên tạm rồi đổi tên cho local.
fsspec tầng lưu tệp crawl: kiểm cache, random access và chế độ text binary
Phần này là phép kiểm cache cùng đường dẫn, tài sản chính thứ hai của bài.
simplecache: lần hai không tải lại
Cache trả dữ liệu cũ
Adapter bọc HTTP bằng simplecache với thư mục cache cố định. Lần đọc đầu tốn hai request, lần hai không tốn request nào, thư mục cache có một tệp.
cst = Store("simplecache::http://127.0.0.1:9483",
            simplecache={"cache_storage": "cache"})
# simplecache lan 1 request: 2 | lan 2: 0 | tep trong cache: 1
Tên tệp trong cache là mã băm của đường dẫn, không phải tên gốc.
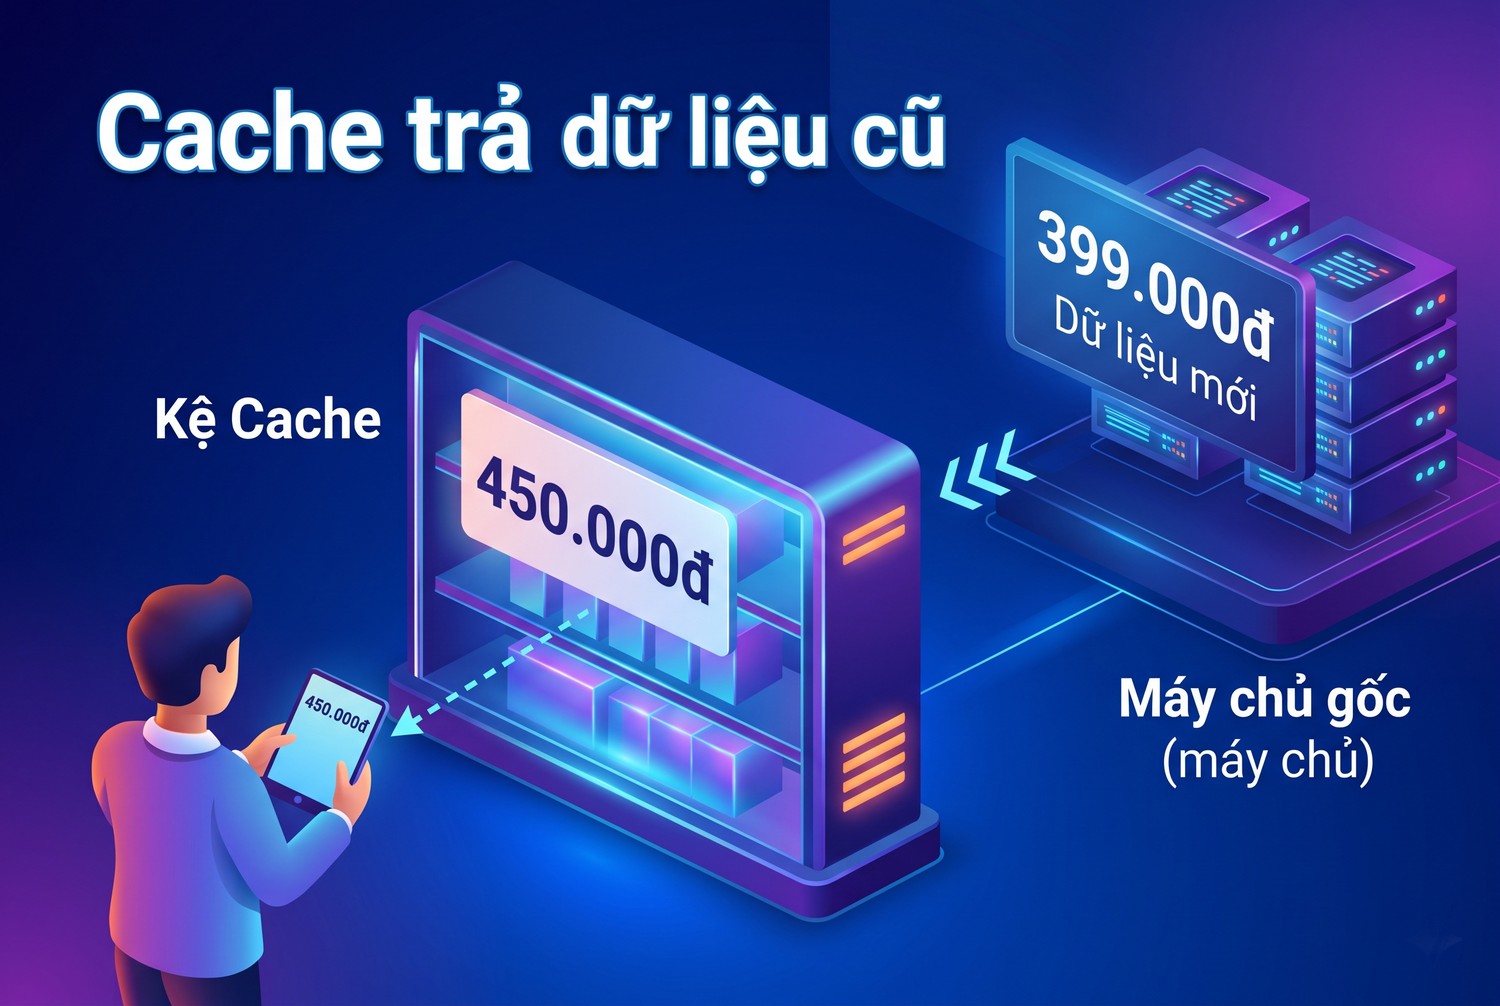
Cache trả dữ liệu cũ
Lab đổi giá trang p/1 trên máy chủ từ 450.000 xuống 399.000. Đọc qua simplecache vẫn ra giá cũ, đọc thẳng HTTP ra giá mới.
server doi gia -> simplecache tra: ('Bàn phím cơ', 450000) | http truc tiep: ('Bàn phím cơ', 399000)simplecache không kiểm máy chủ có đổi không. Với dữ liệu crawl thay đổi theo ngày, simplecache chỉ hợp cho tệp không đổi, như HTML đã lưu trữ.
filecache có hạn
filecache cho phép đặt expiry_time tính bằng giây. Lab đặt một giây: lần hai trong hạn không request, sau 1,5 giây đọc lại tốn hai request. Thư mục cache có tệp dữ liệu và tệp metadata tên cache.
filecache expiry 1s: lan 2 request 0 | sau 1.5s request 2Với HTML đọc nhiều lần trong một job, đặt hạn bằng thời lượng job là hợp lý.
Cache theo đường dẫn
Cache khóa theo đường dẫn đầy đủ. Đọc thêm trang p/2 qua cùng simplecache, thư mục cache có hai tệp. Hai backend khác nhau mà trùng đường dẫn tương đối sẽ không đụng nhau, vì đường dẫn đầy đủ gồm cả gốc URL.
Đọc theo Range
Lab mở tệp 1MB qua HTTP với block_size 64KB, seek tới byte 500.000, đọc 16 byte. Máy chủ nhận một HEAD và một GET có Range từ 500.000 tới 565.551.
random access: doc 16 byte o 500000 -> [32, 33, 34, 35] | request: [('HEAD', None), ('GET', 'bytes=500000-565551')]Chỉ một khối được tải. Byte đọc được khớp nội dung fixture.
Máy chủ phải hỗ trợ Range
Máy chủ lab trả 206 với Content-Range và Accept-Ranges. Máy chủ không hỗ trợ Range sẽ trả cả tệp, fsspec vẫn đọc được nhưng tải hết. Kiểm header Accept-Ranges của máy chủ trước khi dựa vào truy cập ngẫu nhiên.
blockcache
Lab mở cùng tệp qua blockcache, đọc cùng vị trí. Máy chủ nhận Range từ 0 tới 1.048.575, tức một khối 1MiB mặc định chứa vị trí cần đọc. Với tệp nhỏ hơn khối, blockcache tải cả tệp. Tài liệu nêu blockcache cần hệ điều hành hỗ trợ tệp thưa, lab chạy được trên Windows trong ca này.
Chọn cache cho từng loại tệp
HTML thô đã lưu trữ không đổi: simplecache hoặc filecache không hạn. Trang đang crawl có thể đổi: không cache, hoặc filecache có hạn ngắn. Tệp lưu trữ lớn chỉ đọc một phần: blockcache. Chọn ở adapter, parser không đổi.
fsspec tầng lưu tệp crawl: tách lỗi backend mạng khỏi lỗi parser
Phần này là phát hiện quan trọng nhất của lab.
Ba loại lỗi cần phân biệt
Tệp không có thì bỏ qua và ghi lại. Máy chủ lỗi hoặc mạng hỏng thì thử lại sau. Parser không đọc được nội dung thì sửa parser. Ba loại cần ba cách xử lý. Gộp chúng làm crawler bỏ qua tệp đáng lẽ phải thử lại.
Kết quả thật
Lab gọi adapter HTTP với tệp không tồn tại, đường dẫn máy chủ trả 500, trang không có giá, và một cổng không có máy chủ.
[p/khong-co.html] FileNotFoundError
[err500] FileNotFoundError
[p/bad.html] ValueError -> parser: khong thay gia
[cong dong] FileNotFoundError
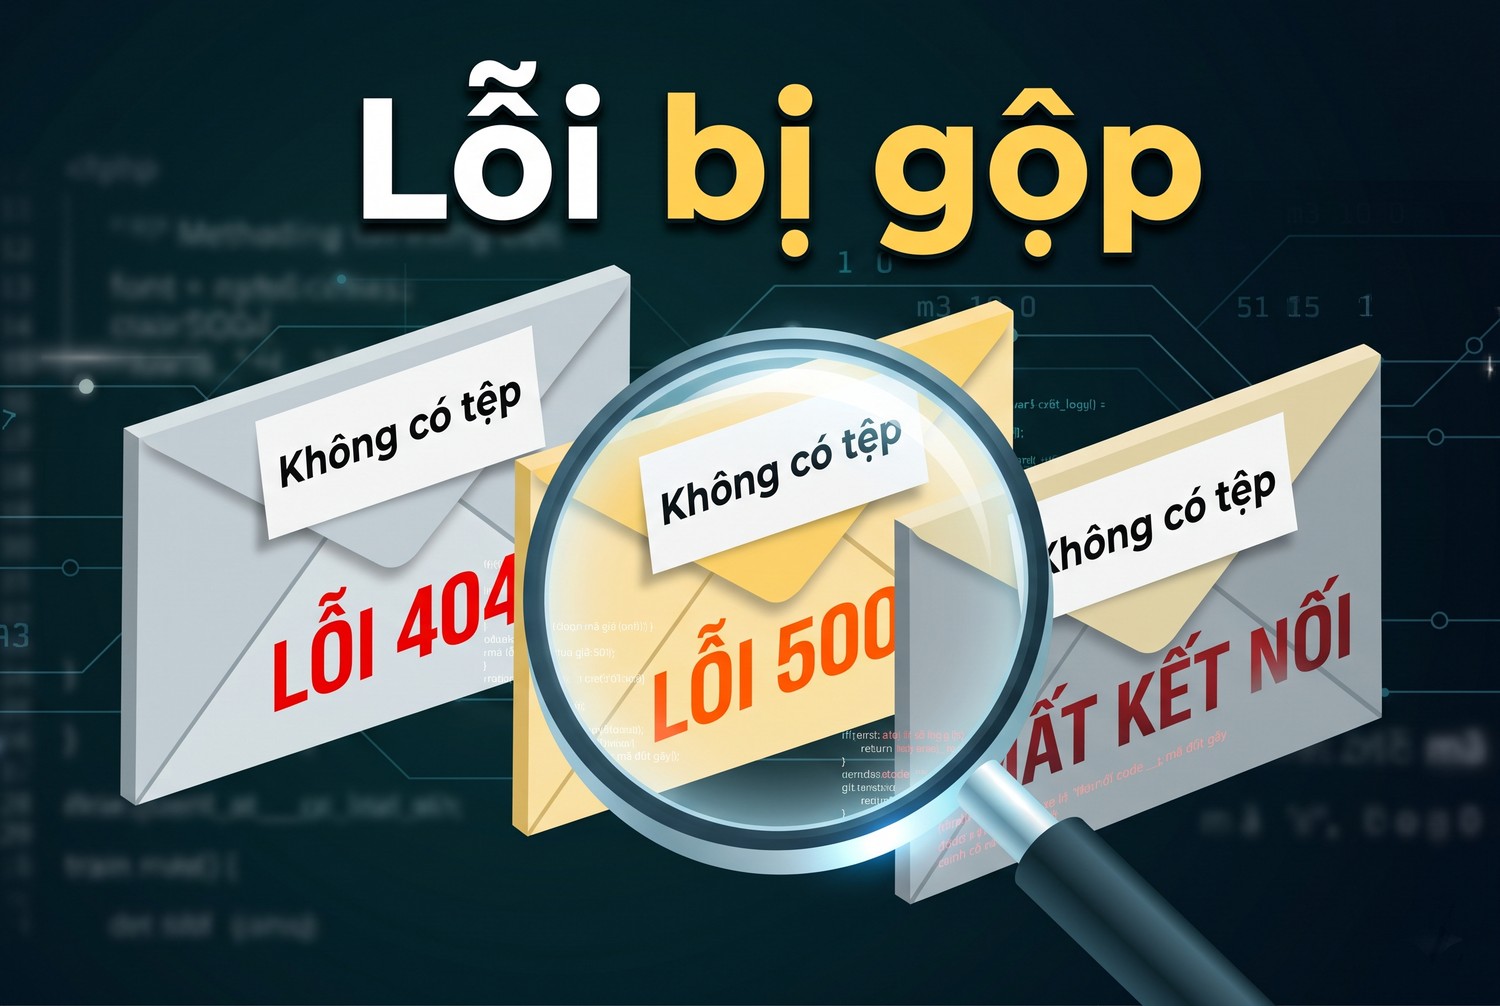
Lỗi 500 và lỗi không kết nối được đều thành FileNotFoundError, giống tệp không có.
Nguyên nhân nằm trong cause
Lỗi bị gộp
Đọc thuộc tính cause của ngoại lệ thì thấy lỗi gốc của aiohttp.
err500 -> FileNotFoundError | cause: ClientResponseError 500
khong-co.html -> FileNotFoundError | cause: ClientResponseError 404
x -> FileNotFoundError | cause: ClientConnectorError Cannot connect to host 127.0.0.1:9
Lý do: khi mở tệp, fsspec gọi info để lấy kích thước, và bước này đổi mọi lỗi thành không có tệp.
exists cũng sai
Hàm exists trên đường dẫn trả 500 trả về False. Mã kiểu nếu không tồn tại thì bỏ qua sẽ lặng lẽ bỏ qua mọi tệp trên máy chủ đang hỏng. Đây là bẫy dễ dính nhất khi chuyển từ local sang HTTP.
cat không đổi lỗi
Gọi thẳng cat hoặc cat_file trên filesystem HTTP, lỗi 500 ra ClientResponseError với status 500. Cách đọc này không đi qua bước info như open. Vậy cùng một đường dẫn, hai hàm đọc cho hai loại ngoại lệ khác nhau.
Cách gọi |
404 |
500 |
Không kết nối |
|---|---|---|---|
fsspec.open rồi read |
FileNotFoundError |
FileNotFoundError |
FileNotFoundError |
fs.exists |
False |
False |
Không thử |
fs.cat |
Không thử |
ClientResponseError 500 |
Không thử |
parse trang lỗi |
ValueError |
Phân loại trong adapter
Adapter nên bắt FileNotFoundError và đọc cause để phân loại lại.
def classify(e):
    c = e.__cause__ or e.__context__
    if isinstance(c, aiohttp.ClientResponseError):
        return "khong_co" if c.status == 404 else "may_chu_loi"
    if isinstance(c, aiohttp.ClientConnectionError):
        return "mang_loi"
    return "khong_co"
Hàm này là ví dụ triển khai, viết theo hành vi quan sát với fsspec 2026.9.0. Bản sau có thể đổi cách bọc lỗi, nên test lại khi nâng cấp.
Lỗi parser giữ nguyên
ValueError của parser đi ra ngoài adapter mà không bị đổi, vì nó xảy ra sau khi tệp đã mở. Adapter không nên bắt lỗi này. Để nó lên tới job, nơi ghi lại tệp nào làm parser hỏng.
Thử lại theo loại
Máy chủ lỗi và mạng lỗi thì thử lại với khoảng chờ tăng dần. Không có tệp thì ghi lại, không thử. Parser lỗi thì đưa tệp vào danh sách cần xem. Ba danh sách này cho biết sáng hôm sau phải sửa gì.
Đếm lỗi theo loại mỗi lượt
Cuối mỗi lượt, adapter báo số tệp đọc được, số không có, số máy chủ lỗi, số mạng lỗi và số parser lỗi. Nếu số không có tăng vọt trong khi số tệp ghi vẫn bình thường, nghi ngay bẫy gộp lỗi. Con số này cũng cho biết lượt sau cần thử lại bao nhiêu tệp.
Thử lại không làm bẩn cache
Khi một tệp lỗi được thử lại qua simplecache, cache chưa có bản nào nên vẫn tải từ máy chủ. Nhưng nếu lần trước máy chủ trả một trang lỗi với mã 200, trang lỗi đó đã nằm trong cache và sẽ được trả mãi. Parser báo lỗi trên tệp trong cache thì xóa tệp cache đó trước khi thử lại.
Kiểm tra sau khi nâng cấp
Hành vi bọc lỗi phụ thuộc phiên bản fsspec và aiohttp. Đưa bốn ca của lab vào test tích hợp: 404, 500, không kết nối, trang không có giá. Mỗi lần nâng cấp, chạy test này. Nếu kết quả phân loại đổi, sửa hàm classify trước khi triển khai.
fsspec tầng lưu tệp crawl: đưa adapter vào pipeline hằng ngày
Phần này nối adapter của lab với cách một crawler thật dùng nó.
Cấu hình theo môi trường
Gốc URL và tùy chọn lưu trữ nên đọc từ cấu hình, không viết cứng trong mã. Môi trường dev dùng thư mục local, môi trường kiểm thử dùng memory, môi trường thật dùng kho đối tượng hoặc máy chủ HTTP nội bộ. Mã parser và mã job giữ nguyên, chỉ tệp cấu hình đổi. Đây là lý do có adapter.
Một adapter cho đọc, một cho ghi
Downloader ghi HTML vào kho, parser đọc từ kho. Hai việc có quyền khác nhau. Tách thành hai adapter với hai bộ khóa giúp parser không có quyền ghi đè dữ liệu thô. Một lỗi trong parser không thể làm hỏng HTML gốc.
Đường dẫn tương đối thống nhất
Adapter nhận đường dẫn tương đối như p/1.html. Quy tắc đặt đường dẫn nằm ở một chỗ, thường là hàm biến URL trang thành đường dẫn lưu. Nếu mỗi nơi tự ghép đường dẫn, sẽ có lúc một bên thêm gạch chéo đầu, một bên không, và cache coi đó là hai tệp khác nhau.
Test parser bằng memory
Test đơn vị nạp fixture vào filesystem memory rồi chạy adapter. Không cần thư mục tạm, không cần máy chủ. Test chạy trong vài mili giây và cho cùng kết quả trên mọi máy. Lab đã chứng minh memory cho cùng kết quả parse với local và HTTP.
Test tích hợp bằng HTTP cục bộ
Test tích hợp dựng một máy chủ HTTP cục bộ như lab, có cả đường dẫn trả 404, 500 và Range. Test này bắt được những chỗ khác biệt của backend remote mà memory không có, như bẫy FileNotFoundError. Chạy nó mỗi khi nâng cấp fsspec hoặc aiohttp.
Ghi log theo backend
Log của adapter ghi backend, đường dẫn, kích thước, thời gian đọc và loại lỗi nếu có. Khi crawler chậm, log cho biết chậm ở kho hay ở parser. Không ghi tùy chọn lưu trữ vào log, vì chúng có thể chứa khóa truy cập hoặc thông tin proxy.
Đóng phiên HTTP
HTTPFileSystem giữ một phiên aiohttp dùng lại giữa các lần đọc. Fsspec cũng cache chính đối tượng filesystem theo tham số. Job ngắn thì không cần lo. Job chạy lâu nên tạo adapter một lần và dùng lại, đừng tạo mới cho mỗi tệp, để không mở quá nhiều kết nối.
Song song
Đọc nhiều tệp song song có thể dùng nhiều luồng gọi adapter, hoặc dùng API bất đồng bộ của fsspec. Lab không thử song song. Với kho đối tượng, song song giúp nhiều; với máy chủ HTTP nhỏ, song song quá mức làm máy chủ trả 500, và lỗi đó lại bị gộp thành không có tệp.
Khi nào không nên dùng fsspec
Nếu crawler chỉ chạy một môi trường và chỉ đọc local, thêm một lớp trừu tượng không đem lại gì. Nếu cần tính năng riêng của một kho, như version ID của đối tượng, có thể phải gọi thư viện riêng của kho đó. Adapter vẫn dùng được cho phần đọc thông thường.
fsspec tầng lưu tệp crawl: đầu ra nghiệm thu và phần chưa chạy
Phần này gom tiêu chí đạt, tệp đầu ra và những gì còn phải kiểm.
Danh sách kiểm tra
Adapter đạt khi mọi dòng dưới đây đúng.
- Hàm parse nhận đối tượng tệp, không mở tệp, không biết URL.
- Cùng fixture cho cùng kết quả trên local, memory và HTTP.
- Nén suy từ đuôi tệp, HTML đọc nhị phân rồi giải mã theo charset.
- Cache chọn theo loại tệp, không dùng simplecache cho trang đang đổi.
- Proxy chỉ gắn ở tùy chọn của backend HTTP.
- Lỗi FileNotFoundError được phân loại lại theo cause.
- Không dùng exists để quyết định bỏ qua tệp trên HTTP.
- Có test chạy adapter trên memory trong bộ test đơn vị.
Tệp đầu ra của lab
Lab có run.py chạy toàn bộ kịch bản, err.py cho phần phân loại lỗi, thư mục fixture, hai thư mục cache. Mọi số request trong bài đếm từ log của máy chủ lab.
Những gì lab chưa chạy
Chưa chạy kho đối tượng thật, s3fs, gcsfs, chưa ghi qua adapter, chưa thử HTTPS, xác thực proxy, giao dịch, FUSE. Proxy lab chỉ chuyển HTTP thường, không làm CONNECT. Hành vi bọc lỗi là của fsspec 2026.9.0.
Kiểm lại trên kho thật
Đổi gốc URL sang kho đối tượng được phép, chạy lại phần parse và cache. Với kho đối tượng, kiểm cách s3fs báo lỗi khi kho trả 500 hay 503, có bị gộp vào FileNotFoundError như HTTP không.
Proxy ở đâu trong luồng này
Proxy thuộc backend HTTP khi tải trang từ website ngoài, không thuộc parser hay kho nội bộ. Với website được phép thu thập, đôi khi cần IP Việt Nam để nhận đúng trang trong nước. Khi đó anh em có thể mua proxy tại trang chủ ProxyVN và đặt vào tùy chọn của adapter HTTP. Vai trò proxy có ở bài Web Scraping proxy là gì, cách ghi chuỗi proxy ở bài định dạng proxy.
Lỗi proxy cũng bị gộp
Lab không thử proxy hỏng, nhưng theo cơ chế quan sát được, lỗi kết nối tới proxy khi mở tệp cũng sẽ đi qua bước info. Nhiều khả năng nó thành FileNotFoundError với cause là lỗi kết nối. Hàm phân loại ở trên sẽ xếp nó vào mạng lỗi. Anh em nên thử ca này với proxy thật.
fsspec tầng lưu tệp crawl: câu hỏi thường gặp
Các câu dưới đây gom những điểm anh em hay hỏi.
Có cần fsspec nếu chỉ đọc tệp local?
Không bắt buộc. Lợi ích đến khi cùng mã phải chạy trên nhiều backend, hoặc cần test parser bằng filesystem memory.
Vì sao mỗi tệp HTTP tốn hai request?
fsspec gửi HEAD để lấy kích thước rồi GET để lấy nội dung. Lab thấy bốn request cho hai trang. Dùng cache để giảm khi đọc lại.
simplecache có tự làm mới không?
Không. Lab thấy cache trả giá cũ sau khi máy chủ đổi. Dùng filecache với expiry_time nếu tệp có thể đổi. Với HTML đã lưu trữ và không bao giờ đổi, simplecache là lựa chọn đơn giản và tiết kiệm request nhất.
Vì sao lỗi 500 lại báo không có tệp?
Khi mở tệp, fsspec gọi info và đổi lỗi thành FileNotFoundError. Lỗi gốc nằm trong cause. Phân loại lại trong adapter.
Proxy đặt ở đâu?
Ở tùy chọn proxy của adapter HTTP. Lab thấy proxy nhận đúng request HTTP, còn local và memory không đi qua proxy.
Có thể đọc tệp zip trên HTTP không?
Tài liệu nêu có thể nối zip với backend khác bằng dấu hai chấm kép, kể cả kèm cache. Lab không thử ca này. Với kho lưu trữ dạng nén của crawler, đây là cách đọc từng tệp bên trong mà không giải nén cả kho.
Encoding nên xử lý ở đâu?
Ở parser, sau khi đọc byte. HTML tự khai báo charset, parser đọc khai báo đó rồi giải mã. Lab thấy mở bằng encoding sai không báo lỗi mà chỉ ra chữ vỡ.
Bài có chạy kho đối tượng thật không?
Không. Lab chạy fsspec thật trên local, memory và máy chủ HTTP cục bộ. Kho đối tượng cần kiểm riêng, nhất là cách thư viện của kho đó báo lỗi máy chủ và lỗi mạng khi mở tệp qua adapter.
fsspec tầng lưu tệp crawl và những điều cần nhớ
fsspec tầng lưu tệp crawl giúp parser chạy cùng mã trên local, memory và HTTP, miễn là adapter lo phần chọn backend, cache, proxy và phân loại lỗi. Hãy nhớ lỗi 500 bị gộp vào FileNotFoundError, simplecache không tự làm mới, proxy chỉ gắn ở HTTP. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em chạy lại fsspec tầng lưu tệp crawl trên kho đang dùng.


