
FRED API vintage dữ liệu: observation date và bản sửa số liệu
FRED API vintage dữ liệu là cách hỏi "lúc đó người ta biết con số nào", thay vì chỉ lấy con số mới nhất. Bài này viết cho người phân tích chuỗi kinh tế cần tái lập kết quả. ProxyVN không có khóa FRED, nên đã gọi tệp CSV công khai của ALFRED ngày 05/11/2026 và thấy cùng một quý GDP có sáu giá trị theo sáu thời điểm.
FRED API vintage dữ liệu: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và những gì bài không làm, vì dữ liệu kinh tế rất dễ bị đọc thành dự báo.
Bài toán cần giải
Một nhóm viết báo cáo muốn kiểm lại một nhận định cũ: tăng trưởng quý 3/2023 đã được công bố bao nhiêu vào thời điểm đó. Họ tải chuỗi GDP mới nhất, lấy quý 3/2023 và thấy con số khác hẳn bài báo năm 2023. Họ tưởng bài báo sai. Thật ra chuỗi đã được sửa nhiều lần, và con số họ tải hôm nay chưa từng tồn tại vào tháng 10/2023.
Đầu ra nghiệm thu
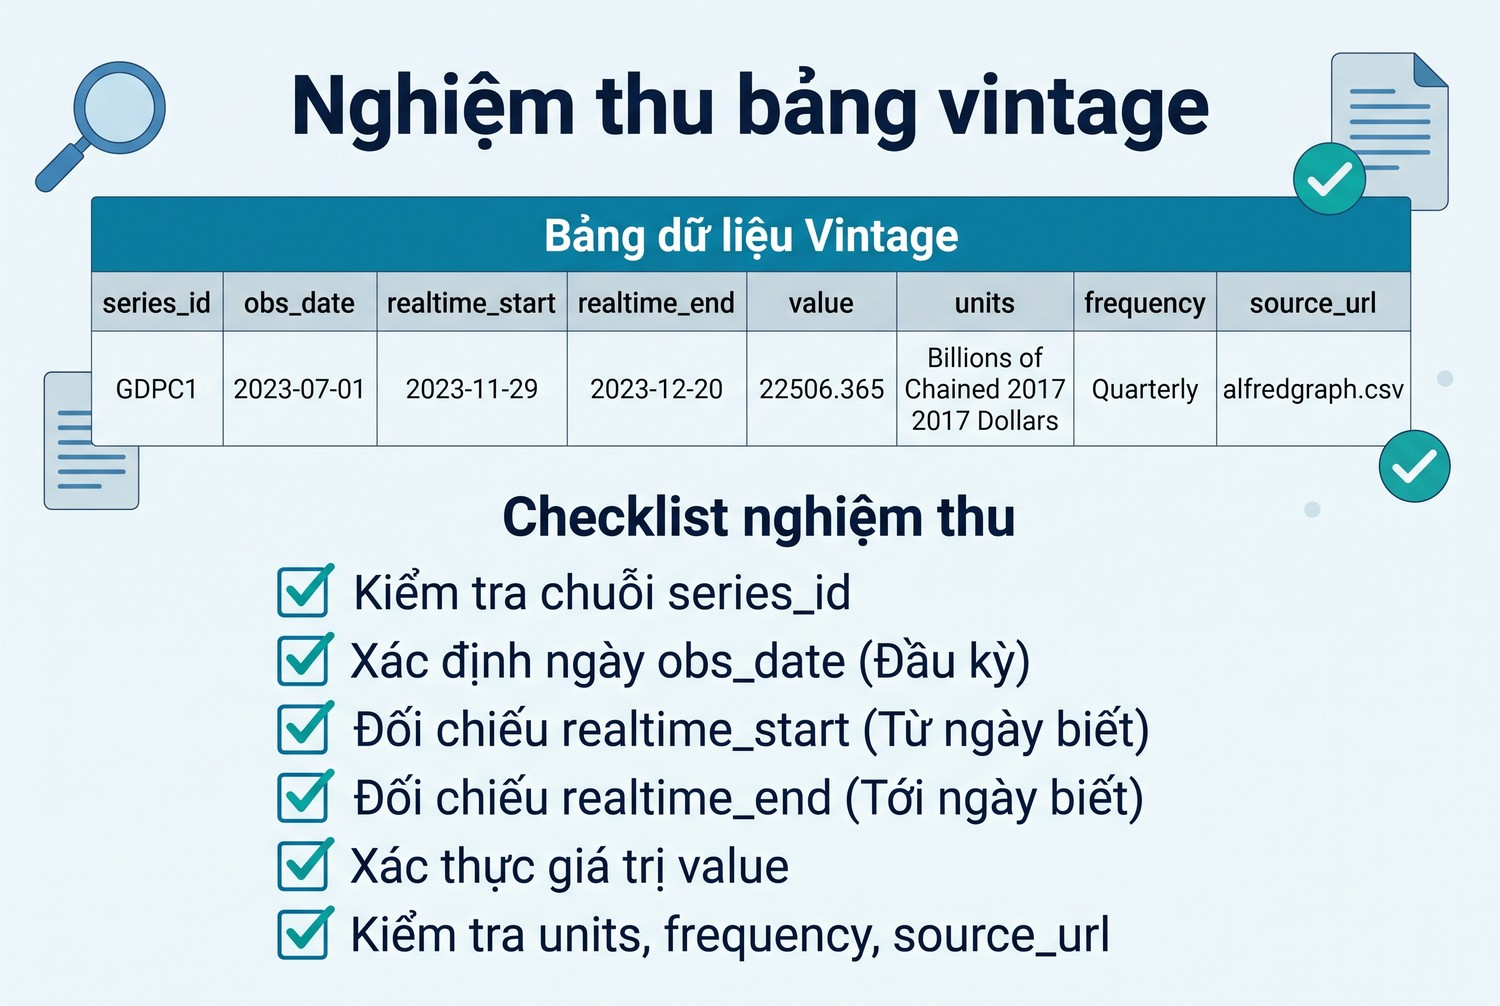
Đầu ra là bảng gồm series, observation date, realtime start, realtime end, giá trị, đơn vị và tần suất. Đi kèm là một ví dụ bản sửa số liệu có thật. Người đọc bảng phải trả lời được hai câu: số này nói về thời kỳ nào, và số này được biết từ ngày nào.
Ranh giới với World Bank và Eurostat
Bài World Bank API và bài Eurostat API lấy chỉ tiêu theo quốc gia hoặc dataset, thường chỉ quan tâm bản hiện hành. Bài này quan tâm mô hình phiên bản của dữ liệu. Cùng một quan sát có nhiều giá trị theo thời gian biết được, và đó là điểm riêng của FRED cùng ALFRED.
Không phải dự báo hay lời khuyên đầu tư
Bài không đưa dự báo kinh tế, không gợi ý đầu tư, không đánh giá chính sách. Các số GDP, thất nghiệp, việc làm chỉ dùng để minh họa cách dữ liệu được sửa. Một lần sửa số không nói lên nền kinh tế tốt hay xấu.
Giới hạn của lab cần nói ngay
FRED API yêu cầu khóa, lab không có khóa và không đăng ký tài khoản. Lời gọi không khóa trả HTTP 400 với thông điệp Variable api_key is not set. Vì vậy các đoạn gọi API trong bài là ví dụ theo tài liệu, chưa chạy thành công. Số liệu thật lấy từ tệp CSV công khai của ALFRED, là ứng dụng vintage của cùng nhà cung cấp.
Ai nên đọc
Bài hợp với người phân tích kinh tế, nhà báo dữ liệu, sinh viên nghiên cứu cần tái lập, kỹ sư dựng kho dữ liệu vĩ mô. Người chỉ cần vẽ biểu đồ hiện tại có thể dùng số mới nhất, nhưng vẫn nên ghi ngày tải.
Thuật ngữ dùng trong bài
Observation date là thời kỳ mà số đo nói tới, ví dụ quý 3/2023. Realtime period là khoảng thời gian một giá trị được coi là số hiện hành. Vintage date là ngày một phiên bản chuỗi xuất hiện. First release là lần công bố đầu. Revision là bản sửa. Hai trục thời gian này là ý chính của cả bài.
Hai trục thời gian
Hãy hình dung một bảng có hàng là thời kỳ và cột là ngày biết. Khi anh em tải số mới nhất, anh em chỉ nhìn cột ngoài cùng bên phải. Khi nghiên cứu lại một quyết định trong quá khứ, cột cần nhìn là cột của ngày đó. Tải một cột mà gọi là cả bảng là nguồn của mọi nhầm lẫn.
Thu FRED series và phân biệt observation date với realtime vintage trong FRED API vintage dữ liệu
Phần này đi qua tài liệu API và đường lấy dữ liệu thật mà lab dùng được.
Nguồn tài liệu đã đọc
Lab đọc trang tổng quan FRED API, trang Real-Time Periods, trang series/observations và điều khoản dùng API. Phần dữ liệu đến từ ALFRED tại alfred.stlouisfed.org.
Tham số của series/observations
Tài liệu mô tả realtime_start và realtime_end để chọn cửa sổ thời gian biết. Tham số observation_start và observation_end chọn thời kỳ. Tham số vintage_dates chọn một danh sách ngày cụ thể. Tham số output_type chọn cách trình bày nhiều vintage. Đây là bốn tham số cần hiểu trước khi viết code.
import os, requests

r = requests.get("https://api.stlouisfed.org/fred/series/observations", params={
    "series_id": "GDPC1",
    "api_key": os.environ["FRED_API_KEY"],
    "file_type": "json",
    "observation_start": "2023-07-01",
    "observation_end": "2023-07-01",
    "realtime_start": "2023-10-01",
    "realtime_end": "2024-12-31",
}, timeout=60)
print(r.json()["observations"])
Đoạn này là ví dụ theo tài liệu, chưa chạy vì thiếu khóa. Mỗi dòng observations có realtime_start, realtime_end, date, value. Với cửa sổ như trên, cùng date có thể hiện nhiều dòng, mỗi dòng ứng với một khoảng thời gian số đó có hiệu lực.
Gọi không khóa
Lab gọi /fred/series?series_id=GDPC1&file_type=json và nhận HTTP 400 với error_code 400, thông điệp Variable api_key is not set kèm liên kết tới trang khóa. Thông điệp này rõ ràng, nên script có thể bắt ngay. Khóa đọc từ biến môi trường, không ghi vào notebook chia sẻ.
Bẫy lớn nhất: tham số bị bỏ qua
Lab thử tệp CSV của trang FRED thường với id=GDPC1 và vintage_date. Bốn ngày 2024-01-01, 2024-12-31, 2025-12-31, 2026-11-01 đều trả 319 dòng, dòng cuối là quý 3/2026 giá trị 24611.077. Thậm chí vintage 1990 vẫn trả HTTP 200 với dữ liệu mới. Tham số vintage_date bị bỏ qua mà không có cảnh báo nào, và tiêu đề cột vẫn chỉ là GDPC1.
Đường đúng là ALFRED
Cùng tham số đó gọi vào alfred.stlouisfed.org/graph/alfredgraph.csv thì khác hẳn. Tiêu đề cột thành GDPC1_20240101, dòng cuối là quý 3/2023, giá trị 22490.692. Hậu tố ngày trong tên cột là bằng chứng phiên bản. Một quy tắc đơn giản: nếu tên cột không có ngày vintage thì không phải dữ liệu vintage.
import csv, io, requests, time

s = requests.Session()
s.headers["User-Agent"] = "ProxyVN-docs-lab/1.0 (+https://proxy.vn/)"
A = "https://alfred.stlouisfed.org/graph/alfredgraph.csv"

def vintage(sid, d):
    r = s.get(A, params={"id": sid, "vintage_date": d}, timeout=60)
    r.raise_for_status()
    rows = list(csv.reader(io.StringIO(r.text)))
    assert rows[0][1].startswith(sid + "_"), rows[0]
    time.sleep(3)
    return rows[0][1], dict(rows[1:])

h, x = vintage("GDPC1", "2023-10-26")
print(h, len(x), x["2023-07-01"])
Output thật là GDPC1_20231026, 307 dòng, 22491.567. Dòng assert chặn đúng bẫy vừa nêu: gọi nhầm tệp FRED thường thì tên cột không có hậu tố và script dừng ngay.
Giới hạn khoảng quan sát
Tham số cosd và coed cắt khoảng thời kỳ trong CSV. Lab thử từ 2019-01-01 tới 2023-12-31 và nhận tệp 431 byte thay vì hơn 6 KB. Với chuỗi dài, cách này giảm tải rõ rệt. Khi chỉ so vài quý thì không cần tải cả lịch sử từ 1947.
Vintage không rơi đúng ngày phát hành
Lab gọi vintage 2023-10-28, một ngày thứ Bảy, và nhận cột GDPC1_20231028 với giá trị quý 3 là 22491.567, đúng bằng bản 26/10. Như vậy tên cột theo ngày hỏi, còn số là bản có hiệu lực tại ngày đó. Hai ngày khác nhau có thể cùng một phiên bản. Muốn biết các ngày phát hành thật, API có series/vintagedates theo tài liệu.
Ngày ngoài phạm vi
Vintage 1980-01-01 trả 404, có lẽ vì GDPC1 chưa có bản lưu từ thời điểm đó. Vintage 2030-01-01 trả 200 với tên cột GDPC1_20261105, tức bị đưa về ngày hiện tại. Script nên chặn ngày tương lai trước khi gọi. Series không tồn tại trả 404.
Chọn series ID và khoảng observation date trong FRED API vintage dữ liệu
Lab chọn ba chuỗi có tính chất sửa số khác nhau, để anh em thấy mức độ không đồng đều.
Ba chuỗi trong lab
Ba chuỗi khác nhau
GDPC1 là GDP thực của Mỹ theo quý. PAYEMS là số việc làm phi nông nghiệp theo tháng. UNRATE là tỷ lệ thất nghiệp theo tháng. Mỗi chuỗi có lịch công bố và kiểu sửa khác nhau, nên một chính sách chung cho mọi chuỗi là không ổn. Trang ALFRED của GDPC1 ghi đơn vị là Billions of Chained 2017 Dollars, điều chỉnh mùa vụ theo tỷ lệ năm, tần suất quý.
Observation date là ngày đầu kỳ
Trong CSV, quý 3/2023 mang nhãn 2023-07-01, không phải ngày cuối quý hay ngày công bố. Tháng 6/2025 của UNRATE là 2025-06-01. Người mới hay hiểu đây là ngày số được phát hành. Lúc ghép với dữ liệu khác, phải quy về đúng kỳ, không ghép theo ngày.
Số lịch sử cũng tăng theo vintage
Số dòng của GDPC1 tăng dần: 286 ở vintage 27/07/2018, 307 ở vintage 2023, 310 ở vintage 09/2024, 314 ở vintage 09/2025, 319 ở vintage 10/2026. Mỗi quý thêm một dòng. Dòng cuối trong mỗi vintage luôn là số còn non, sắp bị sửa. Nếu chỉ xem biểu đồ, anh em không nhận ra được điều đó.
Chọn khoảng theo câu hỏi
Câu hỏi "quý 3/2023 được biết là bao nhiêu" chỉ cần một observation date và nhiều vintage. Câu hỏi "chuỗi trông thế nào vào tháng 10/2023" cần một vintage và cả chuỗi. Câu hỏi "người ta sửa nhiều cỡ nào" cần nhiều cả hai. Xác định câu hỏi trước thì số lời gọi giảm đi rất nhiều.
Mã chuỗi là khóa
Series ID ổn định hơn tên hiển thị. Tuy vậy một chuỗi có thể bị ngừng hoặc thay bằng chuỗi khác khi nguồn đổi phân loại. Bảng nên giữ ID, tên đầy đủ và ngày kiểm. Đừng dùng tên mô tả làm khóa, nhất là khi tên có năm gốc như "Chained 2017 Dollars".
Ghi chú mùa vụ
Nhiều chuỗi có hai phiên bản, điều chỉnh mùa vụ và không điều chỉnh. PAYEMS có điều chỉnh mùa vụ. Chuỗi không điều chỉnh có ID khác. So nhầm hai bản sẽ cho ra dao động lớn trông như tin tức. Cột seasonal_adjustment cần có trong bảng metadata của series.
Đặt realtime, vintage scope theo câu hỏi nghiên cứu của FRED API vintage dữ liệu
Phần này chốt ba kiểu câu hỏi và ba cách lấy dữ liệu tương ứng.
Kiểu một: số hiện hành
Dùng khi vẽ biểu đồ hôm nay. Không truyền realtime, mặc định là ngày gọi. Vẫn nên ghi ngày tải, vì bảng tải hôm nay khác bảng tải quý sau. Với kiểu này, câu chú thích đúng là "theo số liệu tính tới ngày tải".
Kiểu hai: số tại một thời điểm
Dùng khi tái lập một quyết định hoặc một mô hình. Anh em đặt realtime_start và realtime_end cùng một ngày, hoặc gọi ALFRED với một vintage_date. Mọi số trong tập đều là số được biết tại ngày đó. Nghiên cứu dự báo mà dùng số đã sửa sẽ vô tình cho mô hình biết tương lai.
Kiểu ba: lịch sử sửa số
Dùng khi đo độ tin cậy của lần công bố đầu. Anh em lấy nhiều vintage cho một khoảng quan sát. Tài liệu có output_type để chọn cách trình bày, ví dụ theo vintage. Lab mô phỏng kiểu này bằng cách gọi ALFRED nhiều lần với ngày khác nhau.
Bảng chọn nhanh
Câu hỏi |
Cách lấy |
Bẫy cần tránh |
|---|---|---|
Biểu đồ hôm nay |
Mặc định |
Quên ghi ngày tải |
Số biết tại ngày X |
realtime hoặc vintage_date |
Gọi nhầm tệp FRED thường |
Mức sửa số của một kỳ |
Nhiều vintage |
So qua lần đổi năm gốc |
Kiểm mô hình quá khứ |
Vintage theo từng thời điểm |
Dùng số đã sửa |
Lỗi nhìn trước tương lai
Một mô hình kiểm thử trên quá khứ bằng chuỗi mới nhất đang dùng thông tin chưa ai có lúc đó. Số quý 3/2023 đã sửa chỉ xuất hiện về sau. Kết quả kiểm thử nhờ vậy đẹp hơn thực tế. Bài không bàn chuyện mô hình, chỉ nhắc rằng lỗi này bắt nguồn từ việc bỏ qua trục thời gian thứ hai.
Cửa sổ realtime theo tài liệu
Trang Real-Time Periods giải thích rằng mọi dữ liệu trong FRED gắn với một khoảng thời gian thực. Mặc định khoảng đó là ngày hôm nay. Với FRED mặc định chỉ có dữ liệu hiện hành, với ALFRED thì có lịch sử. Chuỗi không có lịch sử lưu sẽ trả ít vintage hơn anh em tưởng, nên phải kiểm trước.
Lấy danh sách vintage
Khi có khóa, endpoint series/vintagedates trả mọi ngày một chuỗi được sửa. Danh sách đó là đầu vào cho vòng lặp. Không có khóa thì lab dùng các ngày đã biết từ lịch công bố của GDP. Lab chọn 26/10, 29/11, 21/12/2023 ứng với ba lần công bố của quý 3/2023.
r = requests.get("https://api.stlouisfed.org/fred/series/vintagedates", params={
    "series_id": "GDPC1", "api_key": os.environ["FRED_API_KEY"],
    "file_type": "json", "realtime_start": "2023-01-01", "realtime_end": "2023-12-31",
}, timeout=60)
print(r.json()["vintage_dates"])
Đoạn này theo tài liệu, chưa chạy. Anh em dùng nó để thay danh sách ngày viết tay.
So giá trị cùng observation qua hai vintage với FRED API vintage dữ liệu
Đây là phần cốt lõi: ví dụ bản sửa số liệu có thật.
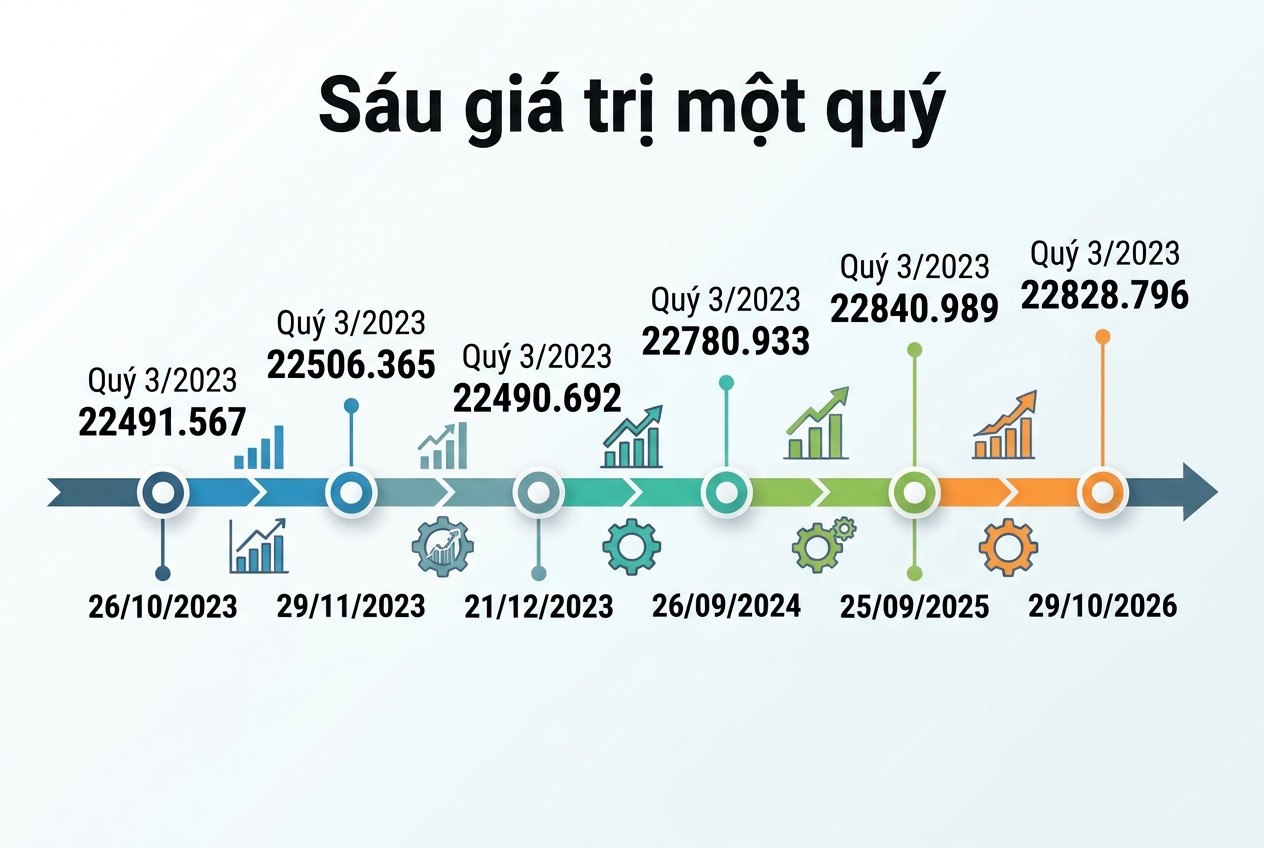
Quý 3/2023 qua sáu vintage
Sáu giá trị một quý
Bảng dưới là output thật của ALFRED cho GDPC1. Cột cuối do lab tính: tỷ lệ tăng so với quý trước, quy về năm, từ hai số trong cùng vintage.
Vintage |
Quý 2/2023 |
Quý 3/2023 |
Tăng quy năm do lab tính |
|---|---|---|---|
26/10/2023 |
22225.350 |
22491.567 |
4.9% |
29/11/2023 |
22225.350 |
22506.365 |
5.2% |
21/12/2023 |
22225.350 |
22490.692 |
4.9% |
26/09/2024 |
22539.418 |
22780.933 |
4.4% |
25/09/2025 |
22580.499 |
22840.989 |
4.7% |
29/10/2026 |
22577.556 |
22828.796 |
4.5% |
Đọc bảng này
Trong ba tháng đầu, chỉ quý 3 thay đổi, quý 2 đứng yên. Tới vintage tháng 9/2024, cả hai quý nhảy lên hơn 300 tỷ, do đợt sửa theo năm. Mức tăng trưởng đi từ 4.9 lên 5.2, về 4.9, rồi 4.4, 4.7, 4.5. Không có con số nào "sai" tại thời điểm của nó. Chúng là các ước tính ở các mức thông tin khác nhau.
Mức sửa theo giá trị và theo tăng trưởng
Giá trị quý 3 từ lần đầu tới bản mới nhất tăng khoảng 337 tỷ đô la, tức khoảng 1.5 phần trăm. Tăng trưởng quy năm chỉ lệch 0.4 điểm phần trăm. Hai cách đo đó kể hai câu chuyện khác nhau, vì sửa cấp độ khác sửa tốc độ. Báo cáo cần nói rõ đang so cái gì.
Hàm so hai vintage
Hàm dưới gộp hai vintage theo observation date, tính chênh theo giá trị và phần trăm.
def compare(sid, d1, d2, dates):
    h1, a = vintage(sid, d1)
    h2, b = vintage(sid, d2)
    for k in dates:
        x, y = float(a[k]), float(b[k])
        print(k, x, y, round(y - x, 3), round((y / x - 1) * 100, 3))

compare("GDPC1", "2023-10-26", "2026-10-29", ["2023-04-01", "2023-07-01"])
Với hai ngày đó, quý 2/2023 đổi từ 22225.350 lên 22577.556 và quý 3/2023 từ 22491.567 lên 22828.796. Cột phần trăm cho biết mức sửa cấp độ.
Quý 2/2018 sửa nhỏ
Vintage 27/07/2018 cho quý 2/2018 là 18507.200, vintage 29/08/2018 là 18514.595. Đây là lần sửa thứ hai thông thường, chỉ khoảng 7 tỷ. Không phải lần sửa nào cũng lớn. Đo mức sửa trên nhiều kỳ mới có ý nghĩa, một ví dụ chỉ để minh họa cơ chế.
Đổi năm gốc phá so sánh trực tiếp
Quý 1/1947 có giá trị 2033.061 ở vintage 2018 và 2019, nhưng 2182.681 ở mọi vintage từ 10/2023. Quý cách đây gần 80 năm không có thêm thông tin mới. Thứ thay đổi là năm gốc của đô la cố định, từ 2012 sang 2017 theo tên đơn vị hiện tại. Khi đổi năm gốc, so cấp độ giữa hai vintage là so hai đơn vị khác nhau. Lúc đó nên so tốc độ tăng.
PAYEMS: dấu của tháng có thể đổi
Vintage 01/08/2025 cho tháng 5, 6, 7/2025 là 159452, 159466, 159539 nghìn người. Vintage 02/10/2026 cho cùng ba tháng là 158498, 158478, 158542. Mức chênh gần một triệu việc làm đến từ các đợt sửa, trong đó có sửa chuẩn hằng năm theo cách nhà thống kê gọi. Quan trọng hơn, tháng 6 ở bản cũ tăng 14 nghìn, còn ở bản mới giảm 20 nghìn.
Tháng |
Vintage 01/08/2025 |
Vintage 02/10/2026 |
Đổi so tháng trước, bản cũ |
Bản mới |
|---|---|---|---|---|
05/2025 |
159452 |
158498 |
không tính |
không tính |
06/2025 |
159466 |
158478 |
+14 |
-20 |
07/2025 |
159539 |
158542 |
+73 |
+64 |
UNRATE gần như không đổi
Lab so hai vintage đầu và cuối năm 2026 cho tháng 6, 11, 12/2025: 4.1, 4.5, 4.4 ở cả hai. Tỷ lệ thất nghiệp theo chuỗi này ổn định hơn nhiều trong mẫu của lab. Số dòng khác nhau 936 và 945 do thêm tháng mới. Vì vậy mức quan tâm vintage phụ thuộc chuỗi, không nên áp một quy tắc chung.
Bảng so mức sửa
Khi cần so nhiều chuỗi, anh em dùng tỷ lệ, không dùng giá trị. Một con số trăm tỷ trong GDP nhỏ hơn nhiều so với vài nghìn trong một chuỗi nhỏ. Bài không kết luận chuỗi nào đáng tin hơn, vì lab chỉ đọc vài kỳ.
Giữ unit, frequency và cờ thiếu, không suy ra dự báo kinh tế từ FRED API vintage dữ liệu
Phần này giữ những cột giúp người đọc không hiểu sai.
Đơn vị đi theo vintage
Đơn vị đổi theo vintage
Đơn vị của chuỗi có thể đổi theo thời gian, như ví dụ năm gốc. Vì vậy bảng metadata nên có thêm cột vintage, không phải một đơn vị cho cả chuỗi. Khi có khóa, endpoint series với realtime cho biết metadata tại thời điểm đó theo tài liệu. Lab chỉ đọc tên đơn vị hiện tại trên trang ALFRED.
Tần suất và phép gộp
GDPC1 theo quý, PAYEMS theo tháng. Tài liệu có tham số frequency và aggregation_method để gộp. Gộp phía nguồn tiện, nhưng số trong bảng không còn là số gốc. Bảng cần ghi rõ đã gộp thế nào. Lab không gộp.
Giá trị thiếu là dấu chấm
Tài liệu FRED biểu diễn giá trị thiếu bằng dấu chấm trong response API. CSV của lab có thể để ô trống. Script phải đọc được cả hai và đổi thành None, không đổi thành 0. Lab đọc UNRATE vintage 01/11/2026 và thấy đúng một ô trống trong 945 dòng: tháng 10/2025, nằm giữa 4.4 của tháng 9 và 4.5 của tháng 11. Ô đó không phải số 0 và không nên nội suy thành số thật.
def to_num(v):
    v = (v or "").strip()
    if v in ("", "."):
        return None
    return float(v)

print(to_num("22491.567"), to_num("."), to_num(""))
Hàm in 22491.567, None, None. Chỉ vài dòng nhưng tránh được lỗi cộng trung bình sai.
Không suy ra dự báo
Từ mức sửa của quá khứ không thể nói số sắp tới sẽ được sửa lên hay xuống. Bài cũng không dùng các số trên để nhận xét về kinh tế Mỹ. Trong báo cáo, câu đúng là "số quý 3/2023 đã được sửa từ X lên Y", không phải "kinh tế tốt hơn người ta nghĩ".
Ghi nguồn gốc của số
FRED là nơi tổng hợp, số GDP đến từ cơ quan thống kê của Mỹ. Điều khoản nhắc việc dùng dữ liệu theo quy định của bên thứ ba. Một số chuỗi có bản quyền riêng và giới hạn phân phối lại. Trước khi công bố lại, anh em xem ghi chú nguồn trên trang chuỗi.
Cột trạng thái cho kỳ mới
Kỳ cuối của mỗi vintage là số sơ bộ. Bảng nên có cột is_latest_obs_in_vintage. Biểu đồ có thể vẽ nét đứt cho các kỳ gần nhất, nhắc người đọc rằng phần đó còn được sửa.
Lưu vintage, đường tải và vai trò proxy với FRED API vintage dữ liệu
Phần này nói về cách lưu trữ để tự có lịch sử, và tại sao proxy không đóng vai trò gì đáng kể.
Mô hình bảng hai trục
Bảng dài có các cột series_id, obs_date, realtime_start, realtime_end, value. Một dòng mới chỉ được thêm khi giá trị đổi, và dòng cũ đóng realtime_end lại. Đây chính là mô hình của tài liệu FRED, và nó tương tự các bảng lịch sử trong kho dữ liệu.
def upsert(tbl, sid, obs, val, today):
    cur = [r for r in tbl if r["sid"] == sid and r["obs"] == obs and r["end"] is None]
    if cur and cur[0]["val"] == val:
        return "giu"
    if cur:
        cur[0]["end"] = today
    tbl.append({"sid": sid, "obs": obs, "val": val, "start": today, "end": None})
    return "moi"

t = []
print(upsert(t, "GDPC1", "2023-07-01", 22491.567, "2023-10-26"))
print(upsert(t, "GDPC1", "2023-07-01", 22491.567, "2023-10-28"))
print(upsert(t, "GDPC1", "2023-07-01", 22506.365, "2023-11-29"))
print(t)
Output là moi, giu, moi, và bảng có hai dòng, dòng đầu đóng tại 2023-11-29. Dự án tự chạy upsert hằng ngày sẽ có lịch sử riêng của mình kể cả với nguồn không có ALFRED.
Một phiên bản tự lưu khác ALFRED thế nào
Bảng tự chạy upsert ghi ngày anh em nhìn thấy số, còn ALFRED ghi ngày nguồn công bố. Nếu job chạy muộn hai ngày, realtime_start của anh em muộn hơn hai ngày. Với nghiên cứu cần chính xác tới ngày, nguồn có vintage chính thức tốt hơn. Với dashboard nội bộ, bảng tự lưu thường đủ dùng.
Nguồn không có vintage
Nhiều nguồn thống kê chỉ cho số mới nhất. Muốn có lịch sử, cách duy nhất là tự chụp lại đều đặn từ hôm nay. Bộ dữ liệu ECB, World Bank hay Eurostat trong cụm này đều có thể lưu theo cách đó. Lịch sử bắt đầu từ ngày anh em bắt đầu lưu, nên càng sớm càng có giá trị.
Kiểm tra bảng hai trục
Phép kiểm cơ bản là với một series và một obs_date, các khoảng realtime không được chồng nhau và chỉ có một dòng đang mở. Anh em chạy phép kiểm này sau mỗi lần nạp. Vi phạm thường đến từ việc chạy hai job cùng lúc. Lỗi loại này không làm hỏng biểu đồ ngay, nhưng làm truy vấn theo ngày trả hai giá trị.
Truy vấn theo ngày biết
Muốn biết số tại ngày D, anh em lọc các dòng có start nhỏ hơn hoặc bằng D, và end rỗng hoặc lớn hơn D. Câu lọc này là thứ làm bảng hai trục đáng giá. Trong ví dụ upsert ở trên, ngày 2023-11-01 trả 22491.567, ngày 2023-12-01 trả 22506.365.
Lịch tải
Chuỗi quý chỉ đổi vào ngày công bố, nên tải theo lịch phát hành là đủ. Tải hằng ngày cho vài chục chuỗi cũng nhẹ, nhưng không cần thiết. API có endpoint theo release để biết ngày công bố, lab chưa thử.
Nghỉ giữa lượt gọi
Lab nghỉ ba giây giữa các lần tải ALFRED. Tệp CSV là tính năng của trang web, không phải API có cam kết, nên không phù hợp cho pipeline sản xuất. Có khóa thì dùng API, vì đó là kênh chính thức và có điều khoản rõ ràng.
Proxy có cần không
Không. Khóa API miễn phí cho nhu cầu thông thường, và giới hạn gắn với khóa. Đổi IP không giải quyết gì. Điều khoản yêu cầu dùng đúng mục đích. Cách đặt nhịp có ở bài rate limit API khi dùng proxy.
Khi mạng công ty bắt buộc
Nếu buộc đi qua cổng ra, khai báo ở session, chuỗi theo định dạng proxy. Phần so vintage chạy offline. Vai trò proxy trong thu thập có ở bài Web Scraping proxy là gì.
Tác vụ khác cần IP Việt Nam thì anh em có thể mua proxy uy tín tại trang chủ ProxyVN.
Khóa phiên bản
Lab chạy Python 3.12.10, requests 2.34.2. Ghi rõ endpoint CSV đã dùng, vì tính năng của trang web có thể đổi không báo trước. Khi chuyển sang API, chạy lại một vài vintage để so với bảng cũ.
Đầu ra nghiệm thu bảng series, observation, realtime start, end và bản sửa số liệu của FRED API vintage dữ liệu
Mục này chốt bảng và danh sách kiểm.
Schema của bảng
Nghiệm thu bảng vintage
Cột |
Ví dụ thật |
Ghi chú |
|---|---|---|
series_id |
GDPC1 |
Khóa |
obs_date |
2023-07-01 |
Đầu kỳ |
realtime_start |
2023-11-29 |
Từ ngày biết |
realtime_end |
2023-12-20 |
Tới ngày biết |
value |
22506.365 |
None khi thiếu |
units |
Billions of Chained 2017 Dollars |
Theo vintage |
frequency |
Quarterly |
Theo chuỗi |
source_url |
alfredgraph.csv |
Kênh lấy |
Danh sách kiểm
- Tên cột: có hậu tố ngày vintage, nếu không thì không phải vintage.
- Hai trục: có cả obs_date và realtime.
- Năm gốc: không so cấp độ qua lần đổi năm gốc.
- Giá trị thiếu: đọc dấu chấm và ô trống thành None.
- Kỳ cuối: đánh dấu là số sơ bộ.
- Lời diễn giải: không suy ra dự báo.
Câu kết luận được phép viết
Từ lab có thể viết rằng quý 3/2023 của GDPC1 có sáu giá trị khác nhau qua sáu vintage. Tháng 6/2025 của PAYEMS đổi dấu thay đổi giữa hai vintage. Tệp FRED thường bỏ qua vintage_date. Không nên viết rằng chuỗi nào sai, hoặc xu hướng sửa số sẽ tiếp tục.
Những gì lab chưa chạy
Lab chưa gọi được FRED API với khóa, chưa chạy realtime_start, output_type, vintagedates, series, release. Cột realtime_end ví dụ trong bảng do lab suy từ ngày vintage kế tiếp, không phải API trả. Lab chỉ đọc ba chuỗi, vài kỳ.
Có hai trục thời gian: kỳ mà số nói tới và ngày mà người ta biết số đó. Tải một cột rồi gọi là cả bảng là nguồn của mọi nhầm lẫn.
FRED API vintage dữ liệu: câu hỏi thường gặp
Các câu dưới đây gom những điểm hay bị hỏi.
Có lấy vintage mà không cần khóa được không?
Lab lấy được qua tệp CSV của ALFRED. Pipeline thật nên dùng API có khóa.
Vì sao số quý 3/2023 tôi tải khác bài báo cũ?
Số đã được sửa nhiều lần. Dùng vintage cùng thời điểm bài báo.
Observation date 2023-07-01 có phải ngày công bố không?
Không. Đó là đầu kỳ của quý 3/2023. Ngày công bố nằm ở trục realtime.
Có nên so giá trị GDP giữa hai vintage?
Được, nếu cùng năm gốc. Khác năm gốc thì so tốc độ tăng.
Tệp fredgraph.csv có nhận vintage_date không?
Trong lab, tham số bị bỏ qua, mọi ngày đều trả dữ liệu mới nhất.
Vintage ngày nghỉ trả gì?
Bản có hiệu lực tại ngày đó, tên cột mang ngày hỏi.
Lần sửa có phải do số cũ sai không?
Không nhất thiết. Số đầu dựa trên thông tin chưa đủ, các bản sau bổ sung.
Proxy có giúp gì không?
Hầu như không. Giới hạn gắn với khóa, cần gì thì xin khóa của mình.
FRED API vintage dữ liệu và những điều cần nhớ
FRED API vintage dữ liệu giúp anh em trả lời đúng câu "lúc đó biết gì" khi tách observation date khỏi realtime, kiểm hậu tố vintage và không so qua đổi năm gốc. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em ghi rõ ngày biết số khi dùng FRED API vintage dữ liệu.


