
Eurostat API bằng Python: giải mã chiều, đơn vị và cờ trạng thái
Eurostat API bằng Python là cách lấy số liệu thống kê châu Âu như tỷ lệ thất nghiệp hay tăng trưởng GDP theo từng chiều phân loại: quốc gia, giới tính, nhóm tuổi, đơn vị và thời gian. Khó khăn không nằm ở việc gọi API, vì API công khai và không cần khóa, mà nằm ở việc giải mã phản hồi JSON-stat thành bảng đọc được. ProxyVN đã gọi thật API ngày 29/10/2026, ghi lại cấu trúc phản hồi, cờ trạng thái, ô thiếu, mã lỗi và thời gian từng truy vấn.
Eurostat API bằng Python: mục tiêu dữ liệu, quyền và phạm vi truy cập
Phần này làm rõ API trả về loại dữ liệu gì, ai được dùng và bài này giới hạn ở đâu. Chốt phạm vi trước giúp anh em không lấy về cả trăm nghìn ô số liệu khi chỉ cần vài chục.
Eurostat cung cấp gì qua API
Eurostat là cơ quan thống kê của Liên minh châu Âu. API thống kê của Eurostat trả dữ liệu theo từng dataset, mỗi dataset có một mã ngắn. Ví dụ une_rt_a là tỷ lệ thất nghiệp theo năm, namq_10_gdp là tài khoản quốc gia theo quý.
Trang giới thiệu API của Eurostat mô tả hai nhóm API chính: API thống kê trả JSON-stat và API SDMX trả cấu trúc dữ liệu theo chuẩn SDMX. Bài này dùng API thống kê cho phần dữ liệu và gọi thử một điểm cuối SDMX cho phần metadata.
Dữ liệu là số liệu tổng hợp, không có thông tin cá nhân. Mỗi ô số liệu là giao điểm của một tổ hợp chiều, ví dụ tỷ lệ thất nghiệp của Đức, tổng cả hai giới, tuổi 15 tới 74, năm 2024.
Quyền truy cập và khóa API
Lab gửi mọi request mà không có khóa hay header xác thực. Truy vấn hợp lệ trả mã 200. Điều này khớp với tài liệu, vốn không yêu cầu đăng ký để đọc dữ liệu công bố.
Không có khóa không có nghĩa là gọi bao nhiêu cũng được. Tài liệu có nhắc tới cơ chế trả lời bất đồng bộ cho truy vấn lớn, nghĩa là máy chủ có cách tự bảo vệ khi bị hỏi quá nhiều. Anh em nên lọc chiều ngay trong truy vấn để mỗi request nhỏ gọn.
Khi dùng số liệu Eurostat trong báo cáo, ghi rõ mã dataset, ngày cập nhật lấy từ trường updated và ngày truy vấn. Người đọc sau này sẽ biết số liệu thuộc đợt công bố nào.
Khác gì World Bank
World Bank trả từng quan sát dạng một dòng với quốc gia, năm và giá trị. Eurostat trả một khối nhiều chiều nén lại: danh sách chiều, kích thước từng chiều, rồi một từ điển giá trị đánh số theo vị trí phẳng. Không thể dùng lại bộ đọc World Bank rồi đổi URL.
Eurostat còn có cờ trạng thái cho từng ô, như đứt chuỗi thời gian hay định nghĩa khác. World Bank trong lần thử của bài trước không có cờ nào khác rỗng. Vì vậy phần lớn bài này dành cho việc giải mã chiều và đọc cờ.
Proxy không đổi quốc gia trong số liệu
Quốc gia của số liệu nằm trong tham số geo của truy vấn, không phụ thuộc IP người gọi. Lab so từ điển giá trị khi gọi trực tiếp và khi gọi qua proxy cục bộ, hai kết quả giống nhau.
Bài web scraping proxy là gì nói về những trường hợp IP ảnh hưởng tới nội dung trang. Với API thống kê công khai như Eurostat, IP không quyết định nội dung.
Đầu ra của bài này
Bài hướng tới ba đầu ra. Thứ nhất là một dataset nhỏ gồm 4 khu vực và 7 năm. Thứ hai là hàm chuyển cấu trúc chiều thành bảng phẳng. Thứ ba là bảng kiểm tra ô thiếu và cờ trạng thái kèm nhãn giải thích.
Bài không đưa nhận định kinh tế nào. Con số tỷ lệ thất nghiệp xuất hiện chỉ để minh họa cách đọc dữ liệu, không để so sánh nước này tốt hơn nước kia.
Eurostat API bằng Python: giải mã chiều phân loại và đơn vị theo endpoint hiện hành
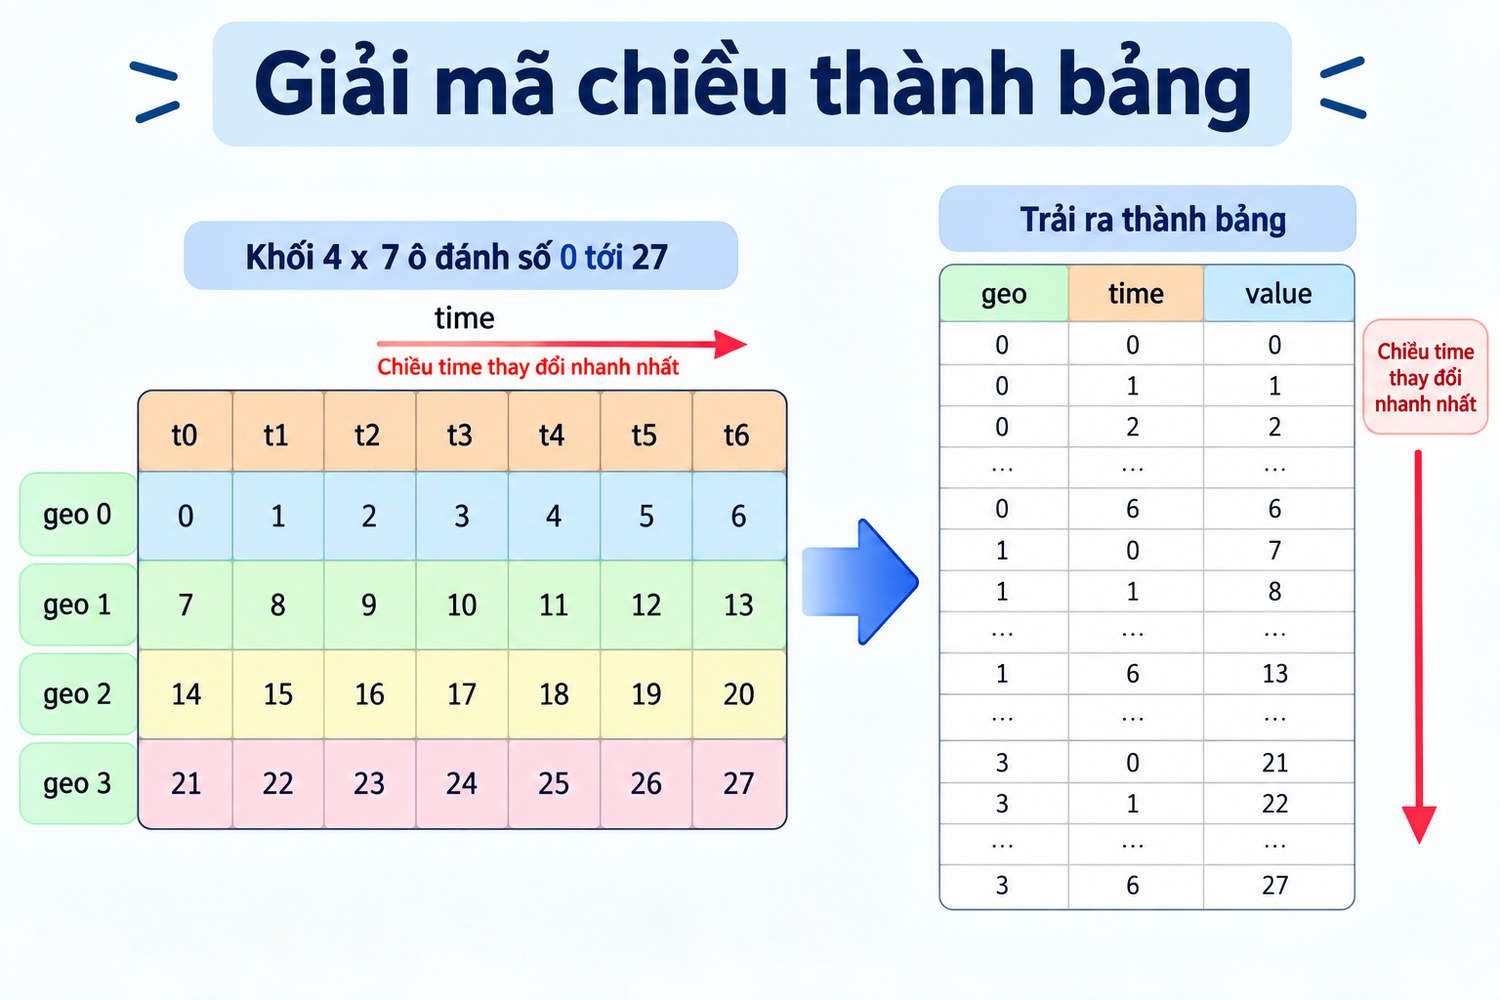
Giải mã chiều thành bảng
Đây là phần cốt lõi. Hiểu cách JSON-stat đánh số ô số liệu thì mọi dataset Eurostat đều đọc được bằng cùng một hàm.
Gọi một dataset nhỏ
Lab lấy tỷ lệ thất nghiệp theo năm của Đức, Pháp, Hy Lạp và khối EU27 từ năm 2019, tổng cả hai giới, tuổi 15 tới 74, đơn vị phần trăm lực lượng lao động.
import requests
B = "https://ec.europa.eu/eurostat/api/dissemination/statistics/1.0/data"
q = {"format": "JSON", "lang": "EN", "geo": ["DE", "FR", "EL", "EU27_2020"],
     "sex": "T", "age": "Y15-74", "unit": "PC_ACT", "sinceTimePeriod": "2019"}
r = requests.get(f"{B}/une_rt_a", params=q, timeout=60)
j = r.json()
Kết quả: mã 200 trong 1,435 giây, Content-Type application/json, thân phản hồi 3871 byte. Trường label là "Unemployment by sex and age - annual data", trường updated là 2026-10-26T23:00:00+0100.
Ba trường quyết định cấu trúc
Phản hồi có các khóa version, class, label, source, updated, value, status, id, size, dimension và extension. Ba khóa quan trọng nhất là id, size và value.
Trường id là danh sách tên chiều theo đúng thứ tự: freq, age, unit, sex, geo, time. Trường size là số giá trị của từng chiều theo cùng thứ tự: 1, 1, 1, 1, 4, 7. Nhân lại được 28, đúng bằng 4 khu vực nhân 7 năm.
Trường value là từ điển với khóa là chuỗi số từ 0 tới 27. Mỗi khóa là vị trí phẳng của một ô trong khối nhiều chiều. Lab nhận đủ 28 giá trị, không ô nào thiếu.
Thứ tự trong chiều không theo thứ tự truy vấn
Lab gửi geo theo thứ tự DE, FR, EL, EU27_2020. Trong phản hồi, chiều geo có index EU27_2020 là 0, DE là 1, EL là 2, FR là 3. Thứ tự do API quyết định, không theo thứ tự anh em gửi.
Vì vậy code phải đọc index trong dimension, không được giả định ô đầu tiên là nước gửi đầu tiên. Đây là lỗi dễ mắc nhất khi tự viết bộ giải mã.
Hàm chuyển khối nhiều chiều thành bảng
Cách giải mã là sắp xếp nhãn của mỗi chiều theo index, rồi duyệt tích Descartes theo đúng thứ tự id. Vị trí trong vòng lặp chính là khóa phẳng trong value.
import itertools
def decode(j):
    ids = j["id"]
    cats = [sorted(j["dimension"][d]["category"]["index"].items(), key=lambda kv: kv[1]) for d in ids]
    rows = []
    for flat, combo in enumerate(itertools.product(*cats)):
        v = j["value"].get(str(flat)); f = j.get("status", {}).get(str(flat), "")
        rows.append({**{d: c[0] for d, c in zip(ids, combo)}, "value": v, "flag": f})
    return rows
Hàm trả 28 dòng. Dòng đầu là EU27_2020 năm 2019 với giá trị 6,8. Chiều cuối cùng trong id, ở đây là time, thay đổi nhanh nhất, đúng với quy ước của định dạng JSON-stat.
Ô không có khóa trong value là ô thiếu, phải giữ là None chứ không được coi là 0.
Đơn vị là một chiều, không phải chú thích
Ở Eurostat, đơn vị nằm trong chiều unit. Lab chọn PC_ACT, nhãn tiếng Anh là "Percentage of population in the labour force". Cùng dataset này còn có đơn vị nghìn người và phần trăm dân số.
Nếu bỏ quên tham số unit, phản hồi sẽ chứa nhiều đơn vị lẫn nhau, và một cột value có cả phần trăm lẫn nghìn người. Luôn giữ cột unit trong bảng kết quả, kể cả khi chỉ chọn một đơn vị.
Lab thử gọi với lang=FR. Nhãn đơn vị đổi thành "Pourcentage de la population active", còn mã PC_ACT và giá trị 3,5 cho Đức năm 2024 giữ nguyên. Nên lưu mã chiều để ghép dữ liệu, dùng nhãn chỉ để hiển thị.
Bảng chiều của dataset mẫu
Chiều |
Nhãn chiều |
Giá trị đã chọn |
Nhãn giá trị |
|---|---|---|---|
freq |
Time frequency |
A |
Annual |
age |
Age class |
Y15-74 |
From 15 to 74 years |
unit |
Unit of measure |
PC_ACT |
Percentage of population in the labour force |
sex |
Sex |
T |
Total |
geo |
Geopolitical entity (reporting) |
EU27_2020, DE, EL, FR |
European Union 27, Germany, Greece, France |
time |
Time |
2019 tới 2025 |
7 năm |
Bảng này lấy từ trường dimension của phản hồi. Giữ bảng chiều cùng file dữ liệu giúp người đọc hiểu mỗi cột mã nghĩa là gì mà không phải tra lại tài liệu.
Chuẩn bị truy vấn, mã dataset và phiên bản khi gọi Eurostat API bằng Python
Một truy vấn Eurostat tốt lọc chiều ngay từ đầu. Phần này đi qua mã dataset, tham số lọc, tham số thời gian và phiên bản điểm cuối.
Tìm mã dataset
Mã dataset hiển thị trên trang duyệt dữ liệu của Eurostat, thường ngắn như une_rt_a hay namq_10_gdp. Điểm cuối SDMX dataflow cho metadata của một dataset. Lab gọi dataflow của une_rt_a, nhận mã 200 với Content-Type application/vnd.sdmx.structure+xml trong 0,301 giây.
Metadata SDMX là XML, dài và nhiều tầng. Với nhu cầu đọc số liệu, phần dimension trong phản hồi JSON-stat thường đã đủ để biết các giá trị hợp lệ của mỗi chiều.
Tham số lọc theo chiều
Mỗi chiều là một tham số truy vấn, tên chiều viết thường. Muốn chọn nhiều giá trị, lặp lại tham số, ví dụ geo=DE&geo=FR. Với requests, truyền danh sách vào params là thư viện tự lặp tham số.
URL thật lab gửi kết thúc bằng geo=DE&geo=FR&geo=EL&geo=EU27_2020&sex=T&age=Y15-74&unit=PC_ACT&sinceTimePeriod=2019. Ghi URL này vào log giúp tái lập đúng truy vấn sau này.
Tham số thời gian
Trang API Statistics trong hướng dẫn chi tiết của Eurostat liệt kê sinceTimePeriod, untilTimePeriod và lastTimePeriod. Tài liệu ghi không được dùng nhiều tham số thời gian cùng lúc, trừ cặp sinceTimePeriod và untilTimePeriod.
Dữ liệu quý dùng mã dạng 2024-Q1. Lab gọi GDP quý với sinceTimePeriod=2024-Q1 và nhận 10 quý cho mỗi nước, tức tới quý gần nhất đã công bố lúc chạy.
Định dạng và ngôn ngữ
Tham số format=JSON cho JSON-stat. Tham số lang chọn ngôn ngữ nhãn, lab thử EN và FR. Mã chiều không đổi theo ngôn ngữ, chỉ nhãn đổi.
Nên cố định lang=EN trong mã chạy định kỳ. Nếu để mặc định và mặc định thay đổi, nhãn trong file kết quả sẽ đổi ngôn ngữ mà không ai để ý.
Phiên bản điểm cuối
Đường dẫn API thống kê lab dùng có đoạn statistics/1.0/data. Điểm cuối SDMX có đoạn sdmx/2.1. Hai con số này là phiên bản của hai API khác nhau, không lẫn được.
Trang hướng dẫn bắt đầu với API thống kê có ví dụ URL đầy đủ. Khi copy ví dụ cũ, kiểm tra lại đoạn phiên bản, vì Eurostat từng đổi hệ thống phát hành dữ liệu.
Kích thước khi không lọc
Lab gọi une_rt_a không lọc gì ngoài ngôn ngữ. Phản hồi nặng 508.300 byte, mất 3,088 giây, size là 1, 7, 3, 3, 38, 23. Khối này có 55.062 vị trí nhưng chỉ 39.726 giá trị.
So với 3871 byte của truy vấn có lọc, chênh hơn 130 lần. Lọc trong truy vấn rẻ hơn nhiều so với tải hết rồi lọc bằng pandas.
Thu dữ liệu Eurostat API bằng Python theo trạng thái trả lời đúng nguồn
Eurostat không phân trang kiểu trang 1, trang 2. Truy vấn trả trọn khối dữ liệu, hoặc trả cảnh báo xử lý bất đồng bộ khi truy vấn quá lớn. Phần này nói về cả hai trường hợp và các mã lỗi.
Không có tham số page
Khác World Bank, phản hồi JSON-stat không có metadata page hay pages. Một truy vấn là một khối. Muốn lấy dữ liệu lớn theo từng phần, anh em tự chia theo chiều, ví dụ mỗi request một nước hoặc một khoảng năm.
Chia theo geo là cách tự nhiên nhất. Mỗi nước một request, mỗi phản hồi nhỏ, và lỗi ở một nước không làm hỏng cả lô.
Trả lời bất đồng bộ cho truy vấn lớn
Tài liệu ghi khi truy vấn quá lớn, API có thể trả JSON có warning với status 413 và nhãn ASYNCHRONOUS_RESPONSE. API không báo khi file sẵn sàng, người gọi phải gửi lại cùng truy vấn để kiểm tra.
Lab chưa gặp phản hồi này. Truy vấn lớn nhất lab gửi là cả dataset une_rt_a, 508 KB, vẫn trả 200 ngay. Phần xử lý bất đồng bộ dưới đây dựa trên tài liệu, chưa chạy thật.
def fetch(url, params, tries=6, wait=20):
    for i in range(tries):
        j = requests.get(url, params=params, timeout=120).json()
        w = j.get("warning", {})
        if w.get("status") != 413: return j
        time.sleep(wait * (i + 1))
    raise TimeoutError("Eurostat chua tra file sau nhieu lan thu")
Mã lỗi khi dataset không tồn tại
Lab gọi dataset tên khong_co_dataset. API trả mã 404 với thân JSON có error, id 100 và nhãn ERR_NOT_FOUND_4 báo dataset không có để phát hành. Khác World Bank, Eurostat dùng mã HTTP đúng nghĩa cho lỗi này.
Code nên đọc cả mã HTTP lẫn trường error trong thân. Ghi nguyên nhãn lỗi vào log giúp biết ngay là sai mã dataset chứ không phải lỗi mạng.
Mã lỗi khi chiều không tồn tại
Lab thêm tham số foo=bar. API trả mã 400, id 150, nhãn INVALID_QUERY_DIMENSION báo chiều FOO không được định nghĩa. Lỗi này xuất hiện khi gõ sai tên chiều, ví dụ country thay cho geo.
Với lỗi 400 và 404, retry không có ích. Sửa truy vấn rồi mới gửi lại.
Giá trị chiều sai trả 200 với khối rỗng
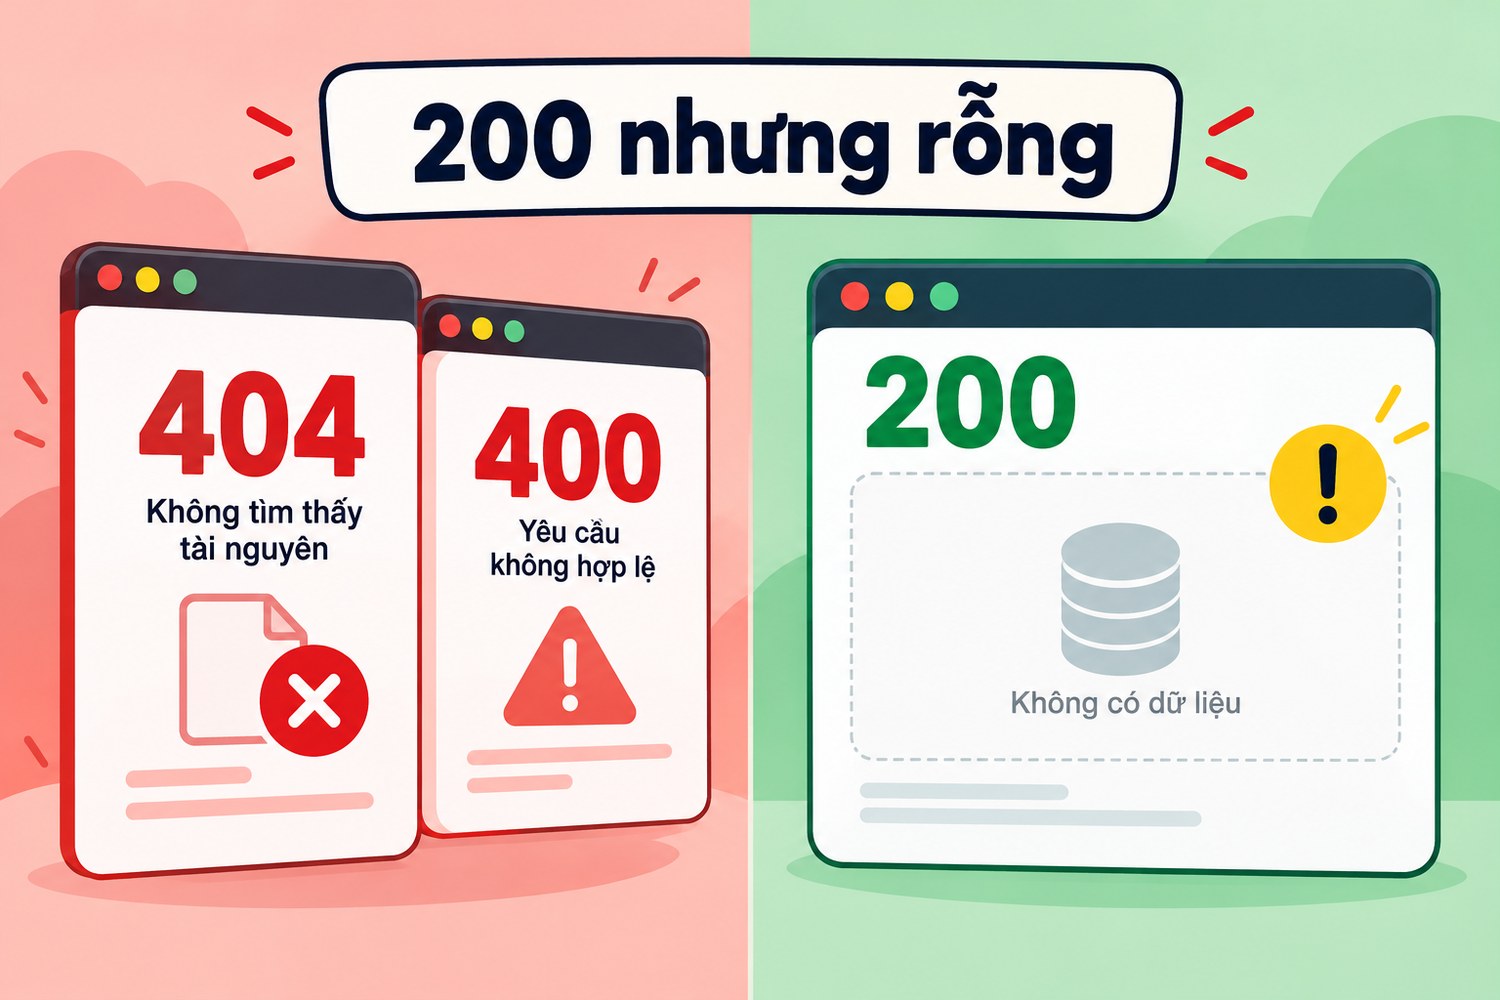
200 nhưng rỗng
Đây là chỗ dễ sai. Lab gọi geo=XX, mã không tồn tại. API trả 200, value là từ điển rỗng, và size của chiều geo là 0. Không có lỗi nào được báo.
Nếu code chỉ kiểm tra mã 200, nó sẽ ghi một file rỗng và báo thành công. Cách kiểm tra là xem len(value) và các phần tử của size. Bất kỳ chiều nào có size bằng 0 là truy vấn đã lọc sai.
Mã 200 với value rỗng nghĩa là bộ lọc không khớp, cần dừng và sửa truy vấn.
Thời gian phản hồi
Truy vấn nhỏ mất 1,435 giây lần đầu, truy vấn GDP quý 0,728 giây, gọi lại truy vấn nhỏ trong cùng phiên 0,317 giây. Truy vấn cả dataset mất 3,088 giây.
Lab dùng timeout 60 giây và không gặp lần nào hết thời gian chờ. Với truy vấn lớn có thể chuyển sang bất đồng bộ, timeout dài hơn và vòng chờ như hàm trên là hợp lý.
Chia lô theo quốc gia
Khi cần dữ liệu cho cả chục nước và nhiều năm, lab đề xuất chia mỗi nước một request rồi gộp bảng sau khi giải mã. Mỗi phản hồi nhỏ, dễ kiểm tra, và một nước lỗi chỉ cần chạy lại riêng nước đó.
Sau khi gộp, kiểm tra lại tổng số dòng bằng tổng của từng phần. Cũng nên kiểm tra mọi phần có cùng giá trị updated. Nếu một phần được tải trước đợt cập nhật và phần khác tải sau, bảng gộp sẽ trộn hai đợt công bố.
Lab chưa chạy lô nhiều nước theo cách này. Phần đề xuất dựa trên cấu trúc phản hồi đã quan sát, không phải số đo thời gian thật cho cả lô.
Đối soát ID, kiểu dữ liệu, giá trị thiếu và cờ khi dùng Eurostat API bằng Python
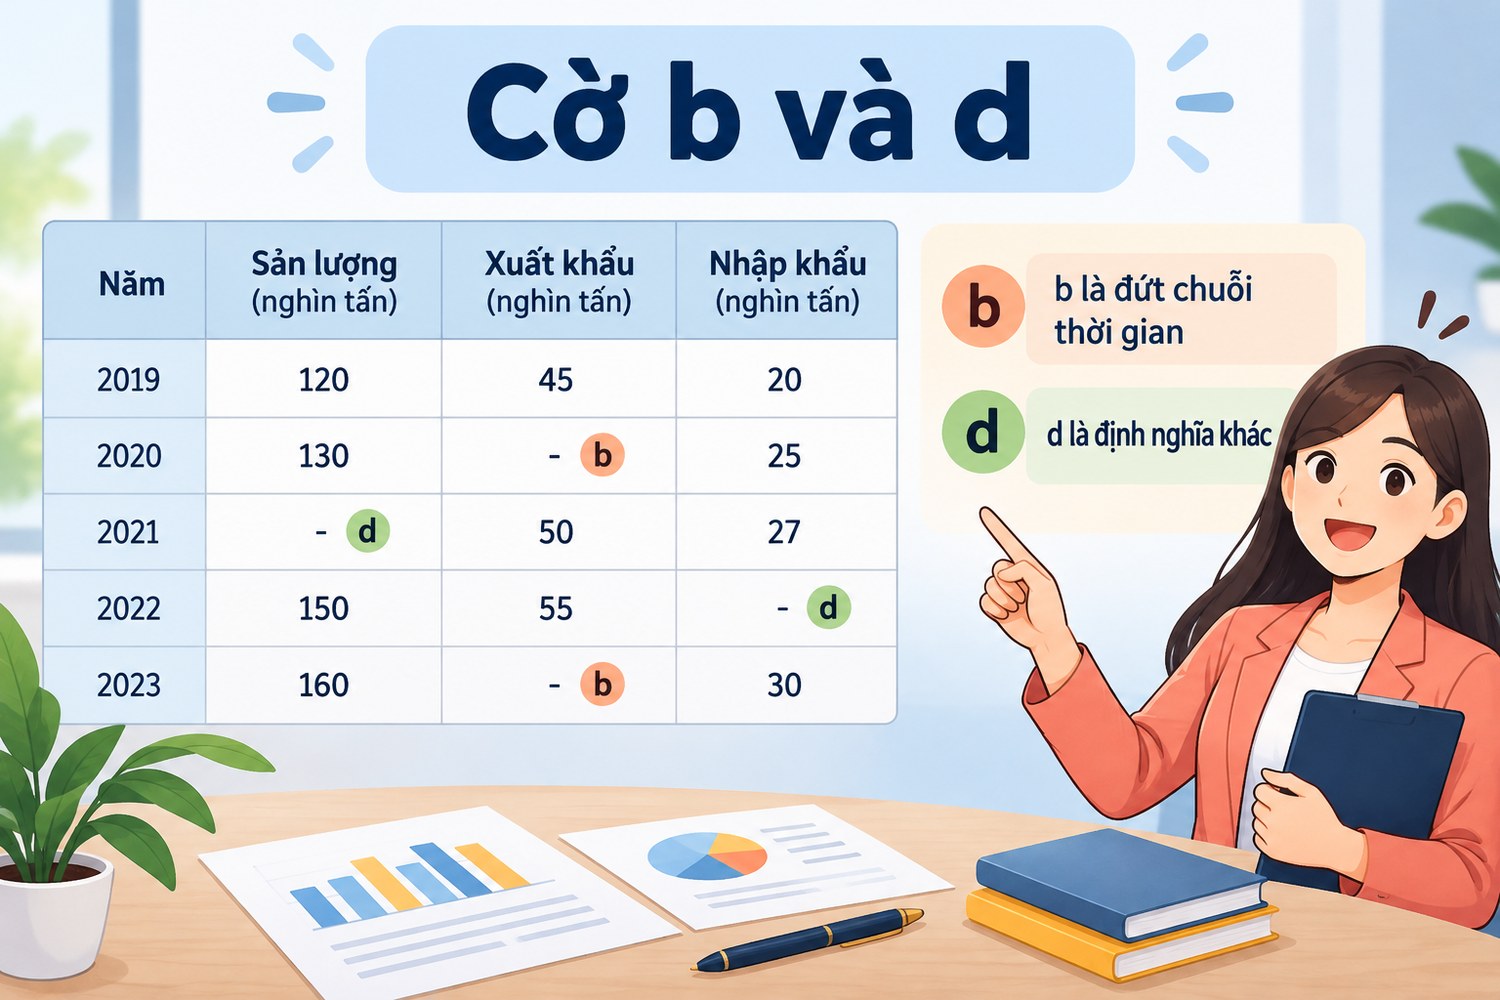
Cờ b và d
Giải mã xong, bước tiếp theo là kiểm tra từng ô có đúng không và mang cờ gì. Đây là phần mà bộ đọc World Bank không có.
Cờ trạng thái nằm ở trường status
Trường status là từ điển cùng kiểu khóa với value. Trong dataset mẫu, status có sáu khóa: vị trí 8 mang cờ b, vị trí 23 tới 27 mang cờ d. Các vị trí khác không có cờ.
Nhãn của cờ nằm ở extension.status.label. Với dataset mẫu, b là "break in time series", nghĩa là đứt chuỗi thời gian, còn d là "definition differs (see metadata)", nghĩa là định nghĩa khác, cần xem metadata.
Ô nào mang cờ
Sau khi giải mã, vị trí 8 là Đức năm 2020 với giá trị 3,6 và cờ b. Vị trí 23 tới 27 là Pháp từ 2021 tới 2025 với cờ d. Nghĩa là số liệu Pháp những năm này có định nghĩa khác chuẩn chung.
Nếu vẽ biểu đồ không kèm cờ, người xem sẽ so số liệu Pháp với các nước khác như thể cùng định nghĩa. Giữ cột flag cạnh cột value để người phân tích tự quyết định.
Cờ trong toàn dataset
Trong cả dataset une_rt_a, lab đếm 1500 ô cờ b, 717 ô cờ u, 630 ô cờ d và 12 ô cờ bu. Cờ u là "low reliability", độ tin cậy thấp. Cờ bu là vừa đứt chuỗi vừa độ tin cậy thấp.
Danh sách nhãn cờ khác nhau giữa các truy vấn. Truy vấn nhỏ chỉ trả nhãn cho b và d, vì chỉ hai cờ đó xuất hiện. Code nên đọc nhãn từ từng phản hồi thay vì viết cứng một bảng nhãn.
Ô thiếu và ô có cờ nhưng không có số
Toàn dataset có 55.062 vị trí và 39.726 giá trị, tức 15.336 vị trí không có số. Trong đó có 183 vị trí mang cờ nhưng không có giá trị. Đây là ô bị ẩn số nhưng vẫn ghi lý do.
Lab gọi thêm số người thất nghiệp tuổi 15 tới 24 ở Bulgaria, đơn vị nghìn người. Chiều time có 23 năm từ 2003 tới 2025 nhưng chỉ 17 giá trị. Trường extension.positions-with-no-data ghi time là các vị trí 0 tới 5, tức 2003 tới 2008.
Kiểm tra số dòng
Số dòng sau giải mã phải bằng tích các phần tử của size. Dataset mẫu là 28. Số giá trị khác None phải bằng số khóa trong value. Hai phép so này bắt được lỗi giải mã sai thứ tự chiều.
Lab thêm một phép kiểm tra tay: tra Đức năm 2024 bằng truy vấn riêng chỉ một ô, nhận 3,5. So với giá trị cùng ô trong bảng giải mã, hai số khớp nhau.
Kiểu dữ liệu và xuất xứ
Cột time là chuỗi, vì có dạng 2024 lẫn 2024-Q1. Không ép sang số nguyên như với World Bank. Cột value là số thực hoặc None. Cột flag là chuỗi, rỗng khi không có cờ.
Mỗi file kết quả nên ghi kèm mã dataset, trường updated, URL truy vấn và ngày chạy. Lab ghi CSV với các cột freq, age, unit, sex, geo, time, value và flag. Bài JSON và CSV khi crawl dữ liệu bàn thêm cách giữ JSON gốc song song với CSV.
Lưu kết quả, giới hạn request và khi nào Eurostat API bằng Python thực sự cần proxy
Phần cuối nói về lưu trữ, nhịp gọi và vai trò của proxy. Với API công khai này, proxy chỉ cần khi mạng của anh em không ra được Internet trực tiếp.
Cờ provisional trong dữ liệu quý
Lab gọi GDP quý của Đức, Pháp và Ý, đơn vị thay đổi phần trăm so với quý trước, đã điều chỉnh mùa vụ. Phản hồi có 30 giá trị, không ô thiếu. Mười vị trí đầu, toàn bộ là chuỗi của Đức, mang cờ p với nhãn "provisional".
Cờ p nghĩa là số tạm tính, sẽ còn sửa. File lưu hôm nay và file lưu tháng sau có thể khác nhau ở đúng những ô này. Lưu trường updated cùng file giúp giải thích khác biệt.
Lưu theo đợt cập nhật
Cả hai dataset lab gọi có updated là 2026-10-26T23:00:00+0100. Đặt tên file theo mã dataset và giá trị updated, ví dụ une_rt_a_2026-10-26.csv. Khi updated đổi mới cần tải lại.
Một bộ nhớ đệm theo URL, hết hạn sau một ngày, đủ cho đa số nhu cầu. Lab không thấy header Cache-Control, ETag hay Last-Modified trong phản hồi, nên không thể dựa vào cache HTTP mà phải tự quản.
Nhịp gọi hợp lý
Tài liệu không công bố số request tối đa. Cách an toàn là gọi tuần tự, dùng lại Session, chia truy vấn lớn theo chiều và nghỉ giữa các request. Gửi song song hàng chục request tới API công khai dễ làm máy chủ chuyển sang chế độ bất đồng bộ.
Bài rate limit API khi dùng proxy giải thích vì sao đổi IP để gửi nhanh hơn không phải cách xử lý giới hạn của API.
Thử qua proxy lab
Lab dựng proxy HTTP cục bộ có xác thực ở cổng 9702 và gọi lại truy vấn nhỏ qua proxy. Kết quả là mã 200 trong 1,285 giây, từ điển value giống hệt khi gọi trực tiếp. Gọi trực tiếp trong cùng phiên mất 0,317 giây vì đã có kết nối sẵn.
px = {"https": "http://user1:p%40ss%232026@127.0.0.1:9702"}
r = requests.get(f"{B}/une_rt_a", params=q, proxies=px, timeout=60)
Proxy chỉ đổi đường đi. Số liệu, cờ và nhãn không đổi. Mật khẩu proxy có ký tự đặc biệt phải mã hóa phần trăm, bài định dạng proxy có cách chuyển.
Khi nào proxy thực sự cần
Proxy cần khi máy chạy pipeline nằm trong mạng chỉ cho ra ngoài qua proxy, hoặc khi tường lửa đầu ra chỉ mở cho một IP cố định. Khi đó proxy là đường đi bắt buộc chứ không phải công cụ tăng tốc.
Proxy không mở khóa dataset nào, không lấy được số chưa công bố và không xóa cờ trạng thái. Xoay IP không giúp gì với API này vì nội dung không phụ thuộc IP.
Chọn loại proxy khi cần
Với pipeline dữ liệu cần một đường ra ổn định, proxy datacenter hoặc proxy dân cư tĩnh có IP cố định là đủ. ProxyVN có proxy dân cư tĩnh, proxy datacenter, proxy 4G và proxy xoay, hỗ trợ HTTP và SOCKS5. Anh em có thể mua proxy tốc độ cao tại ProxyVN rồi khai báo vào tham số proxies như đoạn mã trên.
Nếu pipeline dùng DuckDB để gộp nhiều file kết quả, bài DuckDB xử lý dữ liệu crawl JSONL có cách đọc nhiều file một lần.
Giới hạn suy luận của bài
Lab gọi API thật ngày 29/10/2026 từ Windows 10 ở Việt Nam, Python 3.12.10 và requests 2.34.2. Thời gian đo phụ thuộc mạng lúc đó. Lab chưa gặp phản hồi bất đồng bộ 413, nên đoạn xử lý bất đồng bộ dựa trên tài liệu.
Lab chỉ thử hai dataset. Danh sách cờ và nhãn có thể khác ở dataset khác. Proxy trong lab là proxy cục bộ, chưa thử proxy thương mại. Bài không rút ra kết luận kinh tế nào từ số liệu.
Checklist Eurostat API bằng Python
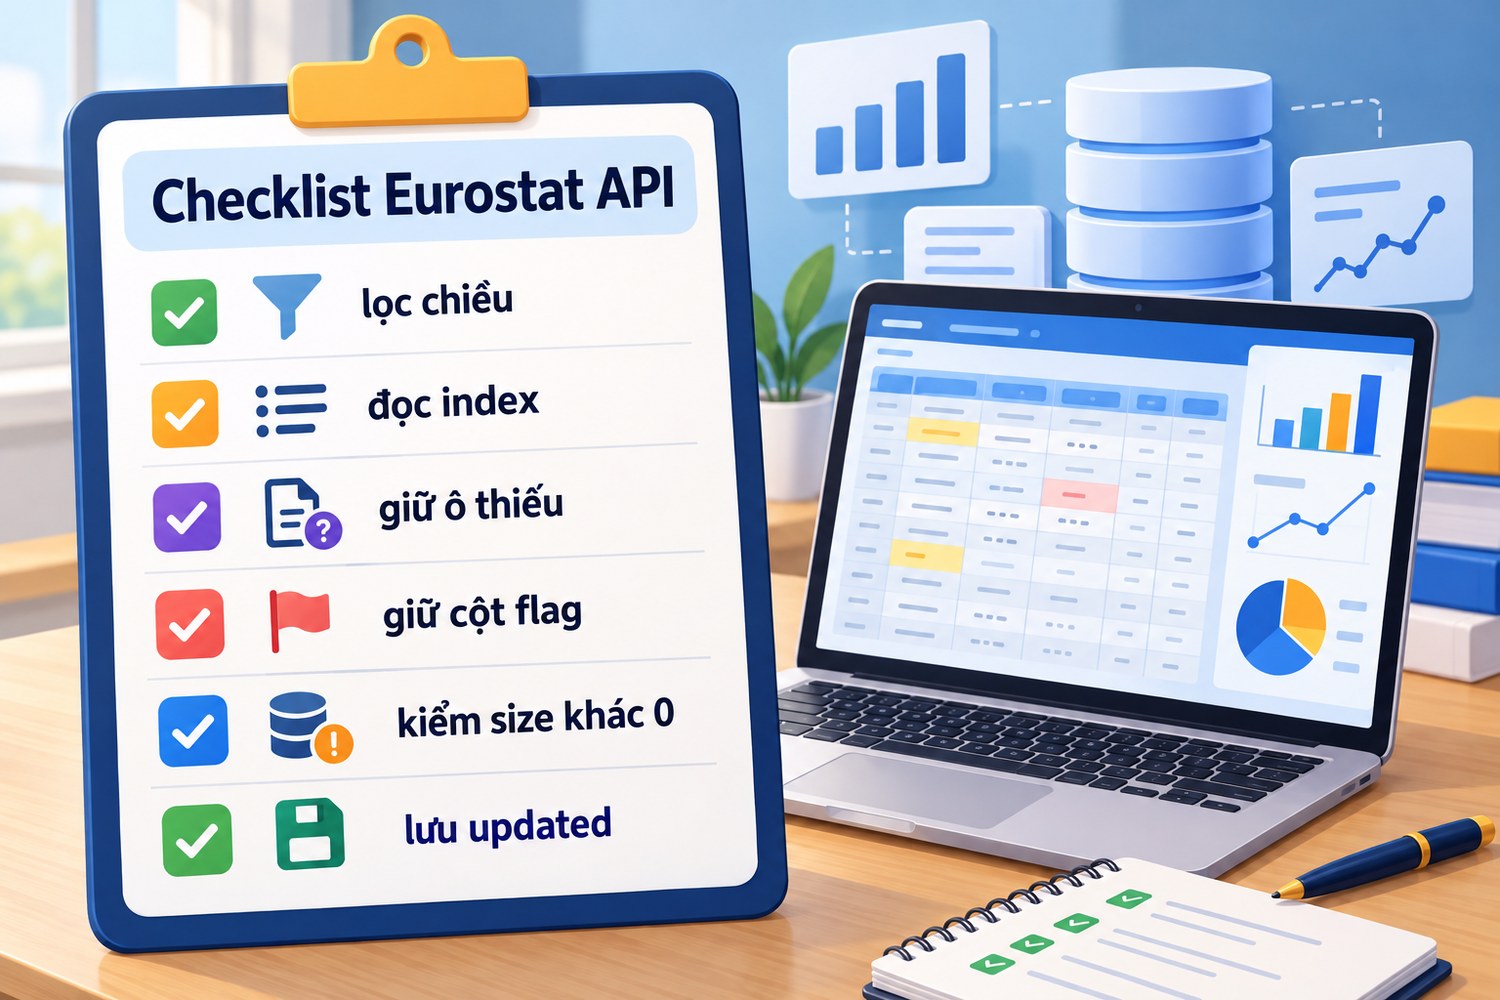
Checklist Eurostat API
- Lọc chiều ngay trong truy vấn, đừng tải cả dataset.
- Đọc index trong dimension, không giả định theo thứ tự gửi.
- Giải mã theo thứ tự id, chiều cuối thay đổi nhanh nhất.
- Giữ ô thiếu là None, giữ cột flag cạnh value.
- Đọc nhãn cờ từ extension.status của từng phản hồi.
- Kiểm tra size không có số 0 và value không rỗng.
- Lưu mã dataset, updated và URL truy vấn cùng file.
- Xử lý warning 413 bằng cách chờ rồi gửi lại.
Câu hỏi thường gặp về Eurostat API bằng Python
Có cần tài khoản để gọi API không?
Không. Lab gọi mọi truy vấn không kèm khóa, truy vấn hợp lệ trả 200.
Vì sao số liệu của tôi bị lệch nước?
Có thể code giả định thứ tự geo theo thứ tự gửi. API sắp xếp lại, ví dụ EU27_2020 đứng đầu. Luôn đọc index trong dimension.
Có nên dùng thư viện bọc sẵn không?
Có các thư viện cộng đồng đọc Eurostat và JSON-stat. Bài viết tay để thấy rõ cấu trúc. Khi dùng thư viện, kiểm tra nó có giữ cột cờ trạng thái không, vì nhiều bộ đọc bỏ qua trường status.
Cờ d có nghĩa số liệu sai không?
Không. Cờ d nghĩa là định nghĩa khác chuẩn chung, cần đọc metadata. Số liệu vẫn được công bố, nhưng so sánh với nước khác cần thận trọng.
Vì sao truy vấn trả 200 mà không có số?
Bộ lọc không khớp giá trị nào, ví dụ geo=XX. Kiểm tra size, nếu có chiều bằng 0 thì sửa bộ lọc.
Dùng proxy châu Âu có nhanh hơn không?
Lab không đo proxy châu Âu. Qua proxy cục bộ, kết quả giống nhau và chỉ khác thời gian bắt tay. Bài Crossref API bằng Python có cách đo thời gian cho một API công khai khác.
Eurostat API bằng Python và những điều cần nhớ
Eurostat API bằng Python không khó gọi nhưng dễ đọc sai: thứ tự chiều do API quyết định, ô thiếu không có khóa trong value, và cờ trạng thái nằm ở một trường riêng. Lab ngày 29/10/2026 giải mã 28 ô thất nghiệp, tìm 6 ô mang cờ b và d, xác nhận geo sai trả 200 với khối rỗng còn chiều sai trả 400. Giữ cột flag và trường updated trong mọi file kết quả. Cần đường ra mạng ổn định cho Eurostat API bằng Python, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


