
Europe PMC API full text status: tách abstract và quyền toàn văn
Europe PMC API full text status là việc xác định một bài báo trong Europe PMC có những gì: chỉ metadata, có abstract, có toàn văn đọc được trên web, hay có toàn văn XML được phép tải qua API. Bốn trạng thái này dễ bị gộp làm một, và pipeline thường đoán sai từ một PMID hay một PMCID. ProxyVN gọi API thật cho sáu accession, so hai kiểu kết quả lite và core, rồi thử tải toàn văn XML để ghi lại phản hồi của từng loại quyền.
Europe PMC API full text status: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và ranh giới với bài arXiv.
Bài toán cần giải
Một nhóm khai phá văn bản y sinh có danh sách vài nghìn PMID. Họ muốn tải toàn văn để chạy mô hình trích xuất. Script đầu tiên gọi fullTextXML cho mọi bài có PMCID, và nhận về rất nhiều lỗi 500. Nhóm nghĩ máy chủ đang hỏng. Thật ra phần lớn các bài đó không thuộc tập được phép tải.
Đầu ra nghiệm thu
Đầu ra là bảng accession gồm nguồn, PMID, PMCID, DOI, các cờ isOpenAccess, inEPMC, inPMC, hasPDF, license, danh sách đường dẫn toàn văn theo mức truy cập, và kết quả gọi fullTextXML kèm mã trạng thái. Mỗi dòng có trạng thái cuối: chỉ metadata, có abstract, đọc được trên web, hoặc tải được XML.
Ranh giới với bài arXiv
Blog đã có bài arXiv API bằng Python. arXiv là kho preprint với quy tắc tải riêng. Bài này nói về Europe PMC, nơi gom bài báo y sinh từ nhiều nguồn với nhiều mức quyền khác nhau. Trọng tâm là quyền toàn văn, không phải cách tìm kiếm.
Không suy toàn văn từ abstract
Có abstract không có nghĩa có toàn văn. Đọc được miễn phí trên web không có nghĩa được tải hàng loạt qua API. Bài giữ bốn trạng thái tách biệt và không cho phép pipeline nâng trạng thái chỉ vì một trường gần nghĩa.
Giới hạn của lab
Lab gọi API thật tại www.ebi.ac.uk/europepmc/webservices/rest ngày 05/11/2026, 15 lượt gọi chính và 3 lượt kiểm lại, cách nhau 1 giây, không dùng tài khoản. Trang trợ giúp trên europepmc.org trả 403 cho công cụ tự động, nên lab đọc đặc tả OpenAPI do chính API cung cấp. Lab không vượt trang kiểm tra nào.
Ai nên đọc
Người làm khai phá văn bản y sinh, tổng quan hệ thống hay xây kho tài liệu nội bộ. Người viết pipeline tải toàn văn từ Europe PMC. Người đang gặp lỗi 500 khi gọi fullTextXML và chưa rõ vì sao.
Phân biệt metadata abstracts và quyền full text Europe PMC trong Europe PMC API full text status
Phần này tóm tắt đặc tả API và các trường liên quan tới quyền.
Nguồn tài liệu đọc được
Đặc tả OpenAPI của Europe PMC REST API trả HTTP 200 và mô tả mọi endpoint. Lab đọc phần search, fullTextXML, references, citations và các tham số. Đặc tả trỏ tới tài liệu tham chiếu PDF cho danh sách trường tìm kiếm.
Endpoint search
Endpoint search nhận query, resultType, format, pageSize, cursorMark, sort và synonym. Đặc tả ghi pageSize mặc định 25, tối đa 1000. Phân trang dùng cursorMark: lần đầu để trống hoặc dấu sao, các lần sau dùng nextCursorMark trả về.
Endpoint fullTextXML
Đặc tả mô tả endpoint fullTextXML để lấy toàn văn XML cho tập Open Access trong các bài có toàn văn. Đặc tả ghi mọi bài có toàn văn đều có ID bắt đầu bằng PMC, kèm ví dụ PMC3257301. Hai ý quan trọng nằm ngay trong câu mô tả: chỉ tập Open Access, và ID phải là PMCID.
Use this module to retrieve the full text in XML format for the Open Access subset of our full text publications. (Europe PMC REST API)
Bốn cờ trạng thái
Bản ghi có bốn cờ dạng Y hoặc N: isOpenAccess, inEPMC, inPMC, hasPDF. isOpenAccess nói bài thuộc tập Open Access. inEPMC nói Europe PMC có toàn văn. inPMC nói bài có trong PubMed Central. hasPDF nói có bản PDF. Bốn cờ trả lời bốn câu hỏi khác nhau.
Trường license
Bản ghi core có trường license khi bài có giấy phép mở, ví dụ cc by. Với bài không thuộc tập Open Access, trường này trống. Giấy phép quyết định được làm gì với toàn văn, không chỉ được tải hay không.
Danh sách đường dẫn toàn văn
fullTextUrlList liệt kê các đường dẫn toàn văn kèm availability như Open access, Free hoặc Subscription required, kèm documentStyle như html, pdf, doi và site như Europe_PMC hay DOI. Đây là thông tin cho người đọc trên web, không phải cam kết về API.
Các cờ khác trong bản ghi
Bản ghi còn có hasSuppl cho tài liệu bổ sung, hasTextMinedTerms cho thuật ngữ đã được khai phá, hasBook cho sách. Cả năm bản ghi thật trong lab đều có hasTextMinedTerms là Y, kể cả bài chỉ có abstract. Cờ này nói về dữ liệu khai phá của Europe PMC, không nói gì về quyền toàn văn.
Endpoint khác cùng họ
Đặc tả còn có supplementaryFiles, bookXML, references, citations, databaseLinks và labsLinks. Mỗi endpoint có điều kiện riêng. Bài này chỉ bàn fullTextXML vì đó là chỗ quyền toàn văn được thực thi. Các endpoint khác nên được kiểm bằng cùng phương pháp trước khi đưa vào pipeline.
Bốn trạng thái của bài
Lab dùng bốn trạng thái. Chỉ metadata là khi không có abstract. Có abstract là khi có abstractText nhưng không có toàn văn trong Europe PMC. Đọc được trên web là khi inEPMC là Y nhưng không thuộc Open Access. Tải được XML là khi isOpenAccess là Y, có PMCID và fullTextXML trả 200.
Phân biệt source ID, PMID và PMCID của record trong Europe PMC API full text status
Một bài trong Europe PMC có nhiều ID. Phần này giải thích ID nào dùng vào việc gì.
id và source
Mỗi bản ghi có cặp id và source. Với bài từ MEDLINE, source là MED và id là PMID. Với preprint, source là PPR và id bắt đầu bằng PPR. Cặp này là khóa chính trong Europe PMC, PMID chỉ là một trường hợp.
PMID
PMID là ID của PubMed. Bài có PMID là bài có bản ghi trong PubMed, không nói gì về toàn văn. Bài A5 trong lab có PMID 38366636, inEPMC là N, chỉ có đường dẫn toàn văn Subscription required qua DOI.
PMCID
PMCID bắt đầu bằng PMC, là ID trong kho toàn văn. Bài có PMCID có toàn văn trong PubMed Central và Europe PMC, nhưng chưa chắc thuộc tập Open Access. Ba bài A1, A2, A3 trong lab đều có PMCID, chỉ A1 thuộc Open Access.
ID của preprint
Preprint A4 có id PPR961396, source PPR, không có PMID, không có PMCID. Trường fullTextIdList của nó lại chứa PPR961396. Như vậy fullTextIdList không chỉ chứa PMCID. Mã đọc trường này rồi gọi fullTextXML sẽ gọi bằng ID mà endpoint không hỗ trợ.
DOI là cầu nối
Mọi bài trong lab đều có DOI. DOI dùng để ghép với Crossref, DataCite hay danh sách trích dẫn. Lab tìm bài A2 bằng truy vấn DOI:"10.1038/nature12373" và nhận về PMID 23903748, PMCID PMC4221854.
Bảng ID của sáu accession
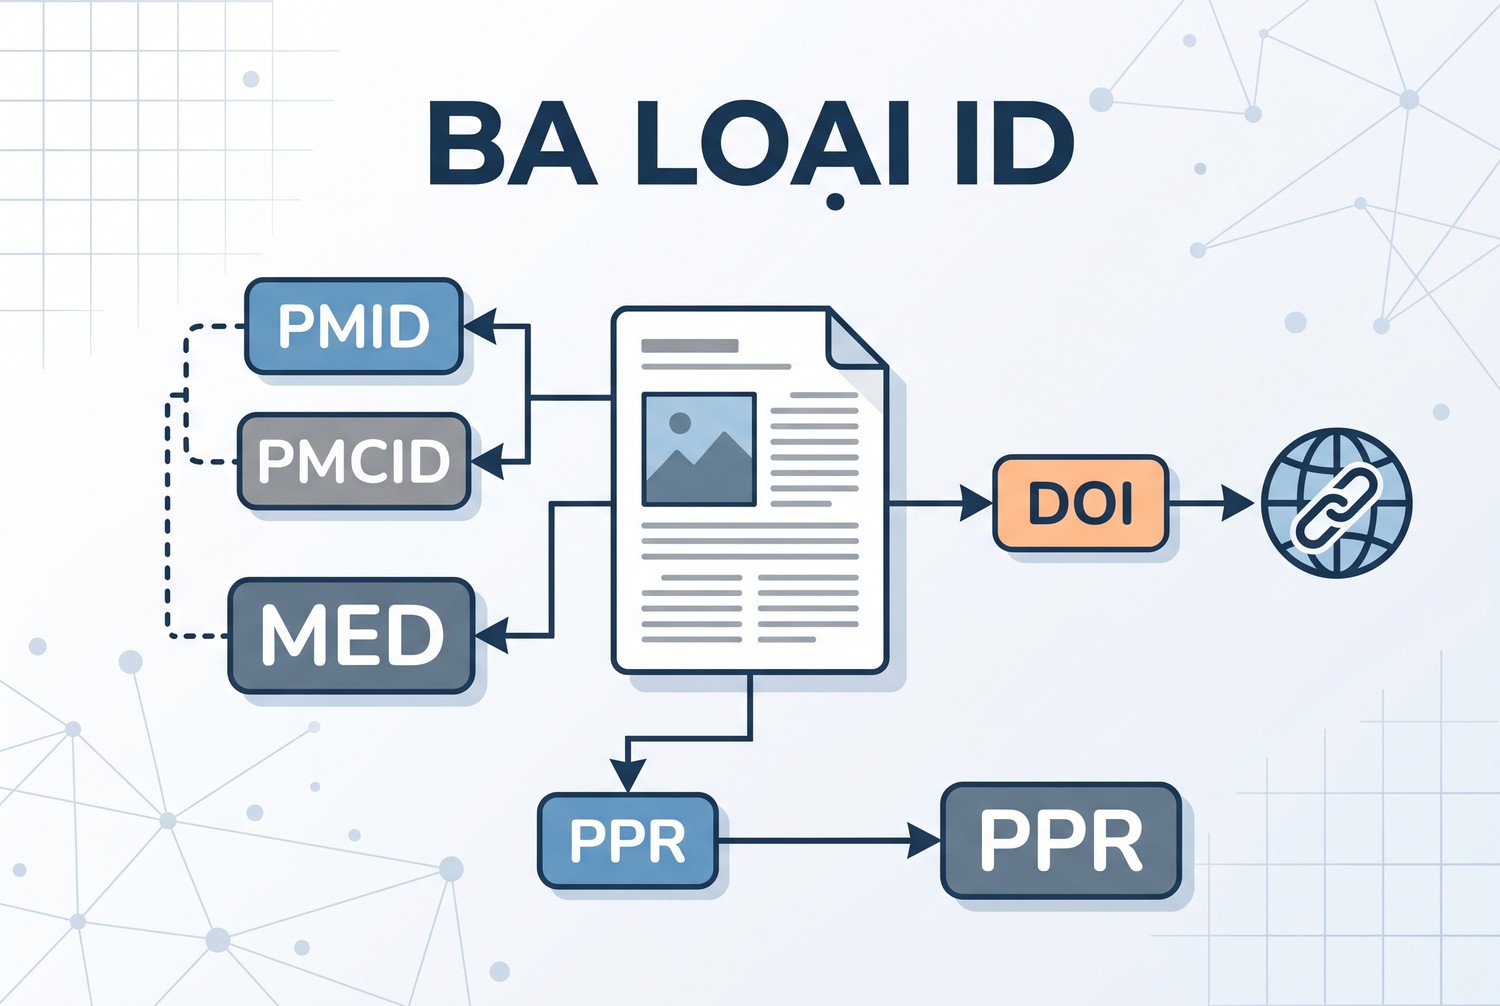
Ba loại ID
Nhãn |
source |
id |
PMID |
PMCID |
|---|---|---|---|---|
A1 bài mẫu của tài liệu |
MED |
22253597 |
22253597 |
PMC3257301 |
A2 bài Nature theo DOI |
MED |
23903748 |
23903748 |
PMC4221854 |
A3 trong Europe PMC, không OA |
MED |
36340057 |
36340057 |
PMC9602880 |
A4 preprint |
PPR |
PPR961396 |
không có |
không có |
A5 chỉ có abstract |
MED |
38366636 |
38366636 |
không có |
A6 PMCID không tồn tại |
PMC |
PMC0000001 |
không có |
PMC0000001 |
Cách chọn accession
A1 là ví dụ trong chính đặc tả. A2 tìm theo DOI. A3, A4, A5 tìm bằng truy vấn có trường lọc như IN_EPMC, OPEN_ACCESS, SRC, HAS_FT, HAS_ABSTRACT và PUB_YEAR, lấy kết quả đầu tiên. A6 là ID bịa để xem phản hồi khi ID sai.
Quy mô của từng nhóm
Truy vấn chọn A3 với IN_EPMC:y AND OPEN_ACCESS:n AND SRC:MED AND PUB_YEAR:2020 có 137326 kết quả. Truy vấn chọn A5 với IN_EPMC:n AND HAS_ABSTRACT:y AND PUB_YEAR:2024 có 598701 kết quả. Truy vấn preprint có toàn văn năm 2024 có 6226 kết quả. Bài có toàn văn trên web mà không thuộc Open Access là một nhóm rất lớn, không phải ca hiếm.
Năm xuất bản
A1 xuất bản năm 2012, A2 năm 2013, A3 năm 2020, A4 và A5 năm 2024. Năm không quyết định quyền. A1 cũ nhất lại là bài duy nhất tải được XML qua endpoint này. Pipeline không nên dùng năm làm tín hiệu cho trạng thái toàn văn.
Truy vấn theo cặp id và source
Để lấy lại đúng một bản ghi, lab dùng truy vấn EXT_ID:{id} AND SRC:{source}. Truy vấn chỉ bằng số có thể khớp nhầm nguồn khác. Cặp id và source là cách gọi một bản ghi không mơ hồ.
Chọn resultType lite/core cho metadata cần dùng trong Europe PMC API full text status
Phần này so hai kiểu kết quả cho cùng bản ghi.
Ba giá trị của resultType
Đặc tả liệt kê idlist chỉ trả ID và nguồn, lite trả metadata chính, core trả đầy đủ metadata. Lab gọi mỗi bản ghi bằng core, rồi gọi lại bằng lite để so tập trường.
lite thiếu gì
Với A1, bản lite thiếu 25 trường so với core, trong đó có abstractText, license, fullTextUrlList, authorList, affiliation, grantsList, meshHeadingList và journalInfo. Các cờ isOpenAccess, inEPMC, inPMC, hasPDF có ở cả hai.
Bẫy license trong lite
Bản lite của mọi bản ghi trong lab đều không có trường license. Mã đọc license từ kết quả lite sẽ thấy None và kết luận bài không có giấy phép mở. A1 có license cc by trong core nhưng None trong lite. Kiểm quyền phải dùng core.
Bẫy abstract trong lite
Bản lite không có abstractText cho mọi bản ghi, kể cả bài có abstract. Pipeline dùng lite để đếm bài có abstract sẽ ra con số 0. Trạng thái có abstract chỉ xác định được từ core.
def search(q, rt="core", n=1):
    r = get("/search", query=q, resultType=rt, format="json", pageSize=n)
    return r.json()["resultList"]["result"], r.json().get("hitCount")

core, _ = search("PMCID:PMC3257301")
lite, _ = search("EXT_ID:22253597 AND SRC:MED", rt="lite")
missing = sorted(set(core[0]) - set(lite[0]))
Kích thước response
Trong nhật ký, response search core cho một bản ghi có kích thước khoảng 5900 tới 10500 byte, còn response lite cho một bản ghi khoảng 900 tới 1200 byte. Với trang 1000 bản ghi, khác biệt này thành vài megabyte mỗi trang. Dùng lite cho bước lọc giúp giảm đáng kể dữ liệu tải về.
Khi nào dùng lite
lite đủ khi chỉ cần lọc theo cờ Open Access, năm, nguồn và lấy danh sách ID. Response nhỏ hơn, tải nhanh hơn với trang 1000 bản ghi. Sau bước lọc, gọi core cho những bản ghi cần license và abstract.
Bảng so sánh trường
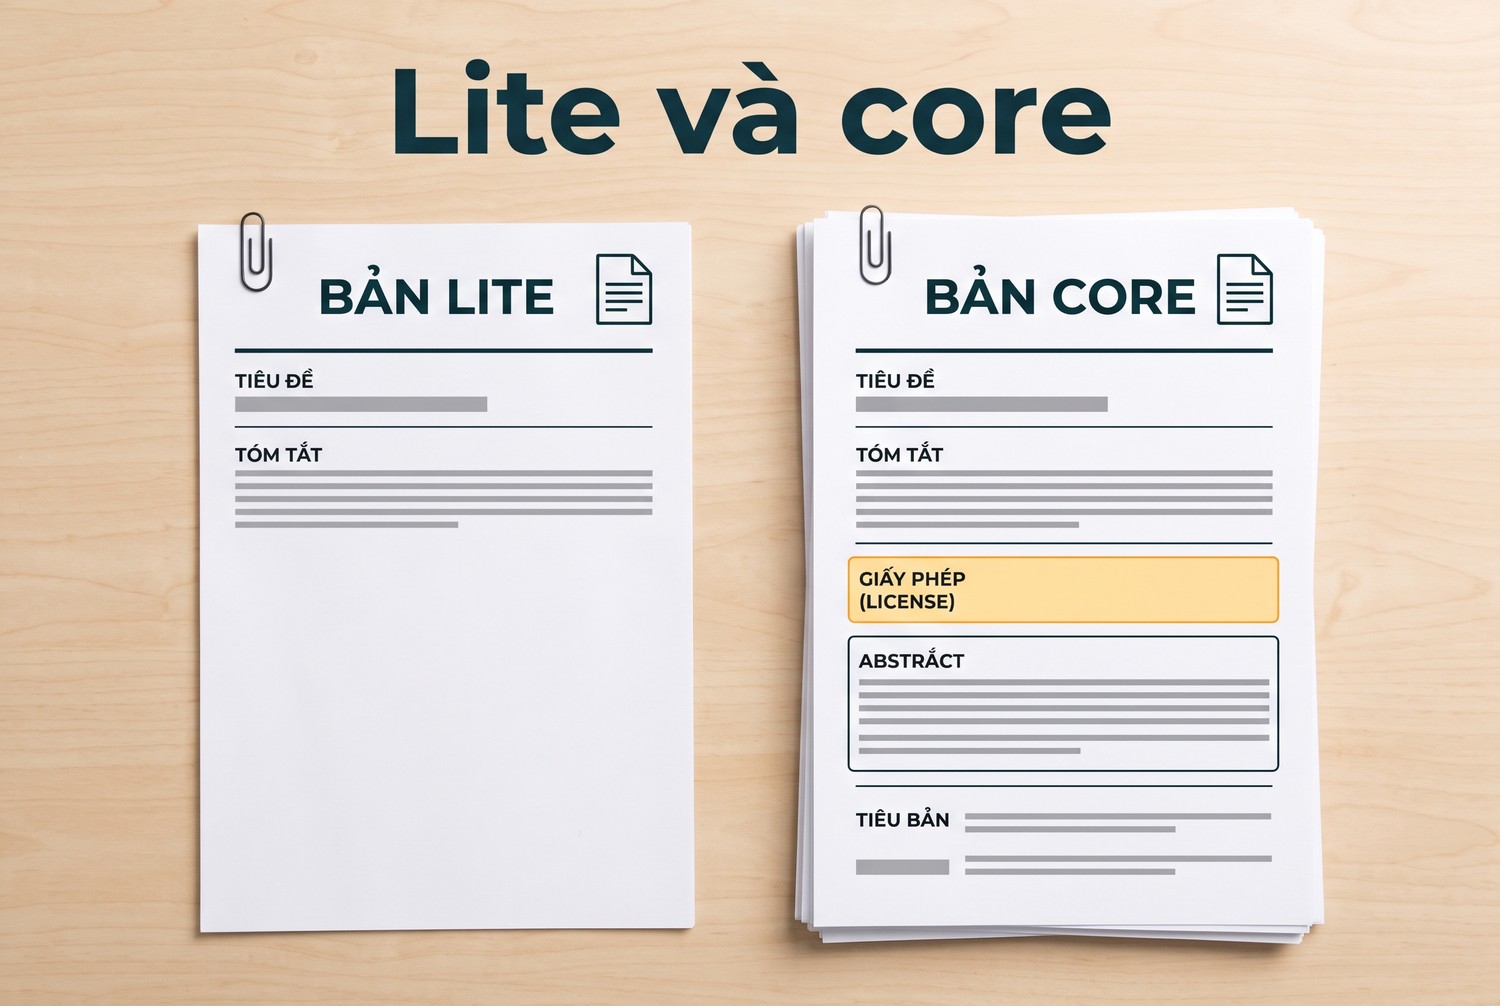
Lite và core
Trường |
lite |
core |
|---|---|---|
id, source, pmid, pmcid, doi |
có |
có |
isOpenAccess, inEPMC, inPMC, hasPDF |
có |
có |
license |
không |
có khi có giấy phép mở |
abstractText |
không |
có khi bài có abstract |
fullTextUrlList |
không |
có |
authorList, affiliation |
không |
có |
Số trường thiếu khác nhau
Số trường lite thiếu so với core khác nhau giữa các bản ghi: 25 với A1, 16 với preprint A4. Lý do là core chỉ trả trường có dữ liệu. So sánh nên làm theo tên trường cần dùng, không theo số trường.
Kiểm availability/license trước fullTextXML trong Europe PMC API full text status
Phần này là kết quả chính: ai tải được toàn văn XML.
A1 thuộc Open Access
A1 có isOpenAccess Y, license cc by, fullTextUrlList có Open access html và pdf trên Europe_PMC. fullTextXML trả HTTP 200, application/xml, 159879 byte. Gốc XML là article, có phần body với 136 đoạn văn. Phần license trong XML ghi bài phân phối theo giấy phép Creative Commons Attribution.
A2 đọc được nhưng không Open Access
A2 có isOpenAccess N, inEPMC Y, inPMC Y, hasPDF Y, license trống. fullTextUrlList có html và pdf trên Europe_PMC với availability Free. fullTextXML trả HTTP 500 với thân JSON ghi Internal Server Error. Gọi lại sau đó vẫn 500.
A3 tương tự A2
A3 có cùng tổ hợp cờ: không Open Access, có trong Europe PMC, có PDF, không license. fullTextUrlList ghi Free cho html và pdf. fullTextXML cũng trả 500. Hai bài của hai nhà xuất bản khác nhau cho cùng một kết quả.
A6 không tồn tại
PMC0000001 không tồn tại. fullTextXML trả HTTP 500 với thân JSON cùng cấu trúc, chỉ khác timestamp và đường dẫn. Từ phía client, bài không có quyền tải và ID không tồn tại trông giống hệt nhau.
A4 preprint
Preprint A4 có isOpenAccess Y, license cc by, fullTextIdList là PPR961396 nhưng không có PMCID. Lab không gọi fullTextXML trong lượt chính. Lượt kiểm lại gọi PPR961396/fullTextXML và nhận 500. Đúng như đặc tả, endpoint này chỉ nhận PMCID.
A5 chỉ có abstract
A5 có abstract trong core, inEPMC N, chỉ có đường dẫn Subscription required qua DOI. Không có PMCID nên không gọi fullTextXML. Đây là trạng thái có abstract: đủ cho phân tích abstract, không có toàn văn từ Europe PMC.
Bảng kết quả theo quyền
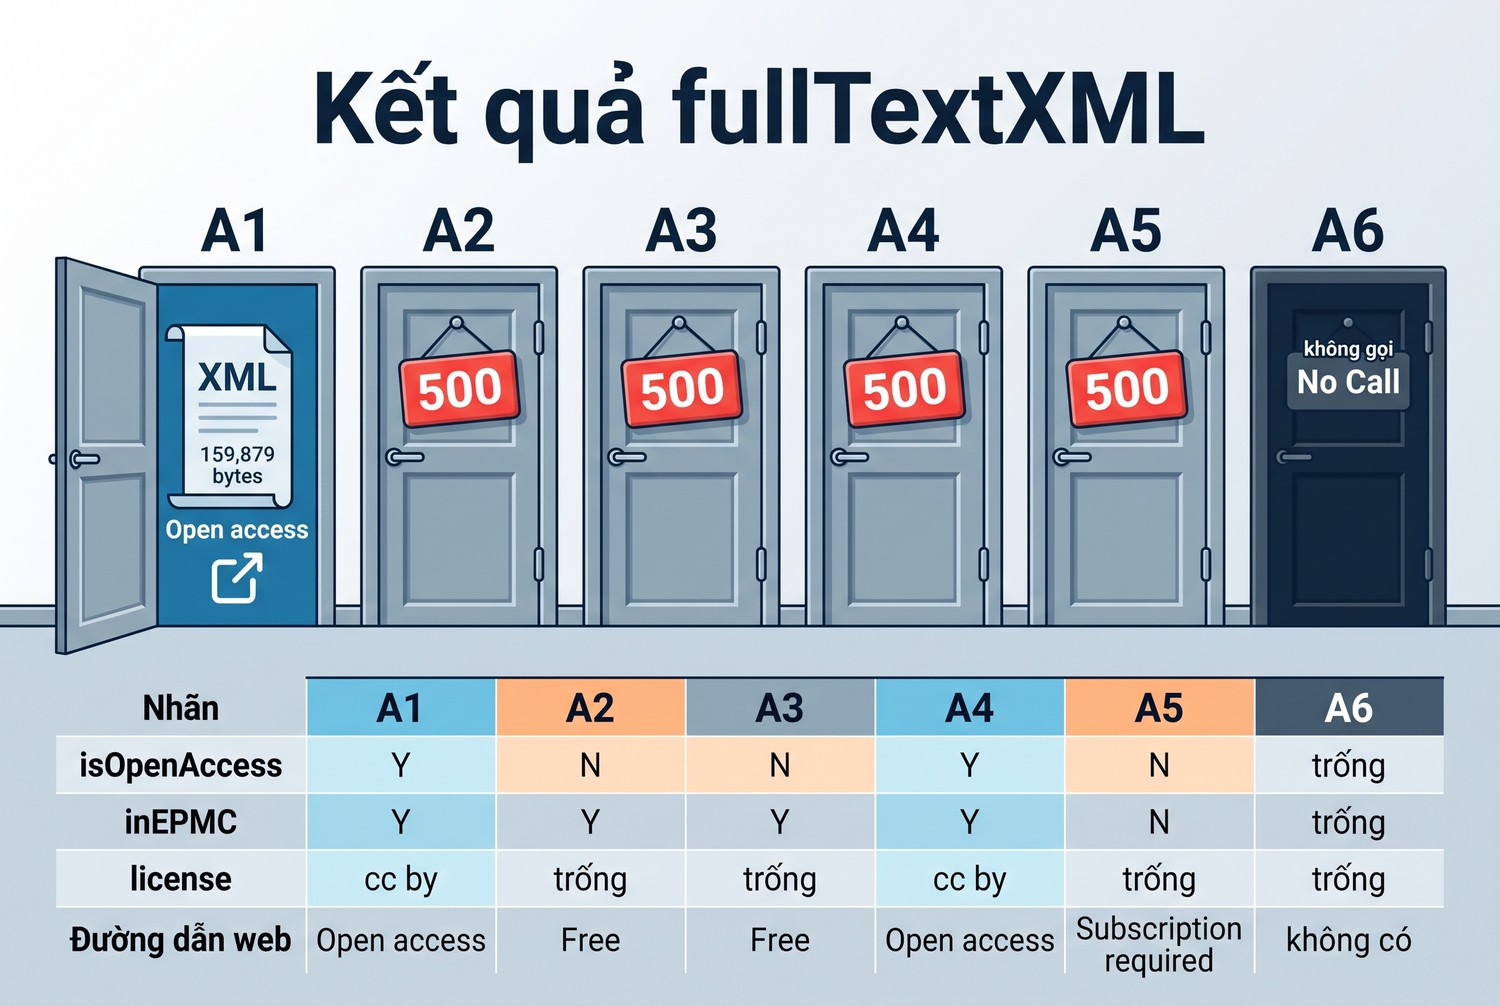
Kết quả fullTextXML
Nhãn |
isOpenAccess |
inEPMC |
license |
Đường dẫn web |
fullTextXML |
Trạng thái cuối |
|---|---|---|---|---|---|---|
A1 |
Y |
Y |
cc by |
Open access |
200, 159879 B |
tải được XML |
A2 |
N |
Y |
trống |
Free |
500 |
đọc được trên web |
A3 |
N |
Y |
trống |
Free |
500 |
đọc được trên web |
A4 |
Y |
Y |
cc by |
Open access |
500 (ID PPR) |
tải được trên web, không qua endpoint này |
A5 |
N |
N |
trống |
Subscription required |
không gọi |
có abstract |
A6 |
trống |
trống |
trống |
không có |
500 |
không tồn tại |
Thời gian phản hồi
Lượt fullTextXML trả 200 của A1 mất khoảng 3,3 giây cho gần 160 nghìn byte. Các lượt trả 500 mất từ 0,3 tới 1 giây. Thời gian không đủ để phân biệt các ca, nhưng cho biết tải toàn văn chậm hơn nhiều so với tìm kiếm. Pipeline lớn cần tính thời gian này vào kế hoạch chạy.
Loại nội dung của response lỗi
Response 200 có Content-Type là application/xml. Response 500 có Content-Type là application/json với các trường timestamp, status, error và path. Mã đọc kiểm Content-Type trước khi parse XML sẽ không bao giờ cố parse thân lỗi JSON như XML.
500 không phải lỗi máy chủ thật
Ba ca A2, A3, A6 và ca PPR đều trả 500, còn A1 trả 200 ngay trong cùng phút. Máy chủ không hỏng. Mã 500 ở đây là cách API phản hồi khi không có toàn văn Open Access cho ID đó. Thử lại nhiều lần không thay đổi kết quả và chỉ tốn lượt gọi.
Free khác Open access
A2 và A3 có availability Free trên web nhưng không thuộc tập Open Access. Free nghĩa là người đọc mở được trên trang. Open access với license nghĩa là được dùng theo giấy phép, gồm cả tải qua API. Pipeline phải đọc đúng chữ, không coi Free là Open access.
Lưu trạng thái không có quyền toàn văn và không suy từ abstract trong Europe PMC API full text status
Phần này mô tả cách ghi kết quả để không ai hiểu nhầm về sau.
Quyết định trước khi gọi
Pipeline nên quyết định có gọi fullTextXML hay không từ bản ghi core: chỉ gọi khi isOpenAccess là Y, có PMCID và license không trống. Với sáu accession trong lab, quy tắc này chỉ gọi A1, đúng bài duy nhất trả 200. Nó tránh được bốn lượt 500.
def full_text_status(c):
    if not c.get("abstractText") and c.get("inEPMC") != "Y":
        return "chi metadata"
    if c.get("isOpenAccess") == "Y" and c.get("pmcid") and c.get("license"):
        return "can tai XML"
    if c.get("inEPMC") == "Y":
        return "doc duoc tren web"
    return "co abstract"
Ghi lý do không tải
Với mỗi bài không tải, ghi lý do: không thuộc Open Access, không có PMCID, không có license, hoặc fullTextXML trả lỗi. Lý do cụ thể giúp người dùng bảng biết có cách nào khác để lấy toàn văn hợp lệ, như xin quyền nhà xuất bản hay dùng dịch vụ của thư viện.
Không đánh dấu thành công từ abstract
Bài A5 có abstract dài, đủ để chạy mô hình trên abstract. Nhưng trạng thái của nó là có abstract, không phải có toàn văn. Báo cáo của nhóm nên tách số bài phân tích toàn văn với số bài chỉ phân tích abstract.
Lưu XML kèm license
Khi tải được XML, lưu kèm license từ bản ghi core và đoạn license trong XML. Hai nguồn trong lab khớp nhau với A1. Nếu không khớp, giữ cả hai và ghi chú. Giấy phép cc by yêu cầu ghi nguồn khi dùng lại.
Kiểm XML có body
Lab kiểm XML có phần body và đếm đoạn văn. A1 có 136 đoạn. XML trả 200 nhưng không có body, ví dụ chỉ có phần front, nên được coi là chưa có toàn văn. Lab chưa gặp ca này nhưng mã đã kiểm.
Bảng trạng thái cho người dùng cuối
Người dùng bảng thường không cần biết bốn cờ. Họ cần một cột trạng thái bằng lời: tải được XML, đọc được trên web, chỉ có abstract, chỉ có metadata, không tìm thấy. Thêm một cột đường dẫn web cho ba trạng thái đầu, để người cần đọc toàn văn biết mở ở đâu.
Cập nhật trạng thái theo thời gian
Trạng thái của một bài có thể đổi. Bài đang trong thời gian cấm công bố có thể được mở sau đó, preprint có thể có bản PMC khi được xuất bản. Lưu ngày kiểm trạng thái và kiểm lại định kỳ cho những bài chưa tải được.
Ghi nhật ký gọi
Mỗi lượt gọi được ghi đường dẫn, tham số, mã trạng thái, số byte, loại nội dung, thời gian và thời điểm. Nhật ký cho thấy thân lỗi 500 luôn khoảng 150 byte dạng JSON, còn XML thật cỡ trăm nghìn byte. Kích thước và loại nội dung là tín hiệu rẻ để phân loại.
Đầu ra nghiệm thu Europe PMC API full text status: bảng accession availability license và kết quả tải theo quyền nguồn
Phần này gom đầu ra thành bản ghi có thể lưu.
Tệp đầu ra
Lab sinh result.json gồm phiên bản Python và requests cùng số kết quả của ba truy vấn chọn ứng viên. Tệp có sáu dòng accession với cờ, license, đường dẫn, so sánh lite với core và kết quả fullTextXML. Nhật ký 15 lượt gọi nằm cuối tệp. out2.txt ghi ba lượt kiểm lại.
Danh sách kiểm tra
Danh sách nghiệm thu
- Mỗi accession có cặp id và source, PMID, PMCID, DOI.
- Quyền được đọc từ core, không từ lite.
- isOpenAccess, inEPMC, license được ghi riêng.
- Free và Open access được tách.
- fullTextXML chỉ gọi khi có PMCID và Open Access.
- Mã 500 được ghi là không có toàn văn Open Access, không thử lại vô hạn.
- Mỗi bài có trạng thái cuối và lý do.
Những gì lab chưa chạy
Chưa thử phân trang cursorMark với nhiều trang. Chưa thử định dạng XML và DC của search. Chưa thử endpoint supplementaryFiles, references, citations, bookXML. Chưa thử bộ tải hàng loạt Open Access của Europe PMC. Chưa đọc trang trợ giúp trên europepmc.org vì trang đó chặn công cụ tự động.
Câu kết luận được phép viết
Câu được phép viết là: trong lab, chỉ bài có isOpenAccess Y và PMCID tải được fullTextXML, còn bài Free, preprint theo ID PPR và ID không tồn tại đều nhận 500. Câu không được phép viết là: mọi lỗi 500 của Europe PMC đều do quyền. Lab chỉ có sáu accession.
Vận hành pipeline tải toàn văn với Europe PMC API full text status
Phần này chuyển kết quả lab thành quy tắc cho pipeline chạy thật.
Lọc trước bằng truy vấn
Thay vì tải bản ghi rồi lọc, đưa điều kiện vào truy vấn: OPEN_ACCESS:y cùng các điều kiện khác. Số bản ghi trả về chỉ gồm bài có thể tải. Với danh sách PMID sẵn có, ghép điều kiện này với danh sách ID theo từng nhóm nhỏ.
Gửi email liên hệ
Đặc tả có tham số email để đăng ký địa chỉ liên hệ với EBI cho tin tức về dịch vụ. Pipeline thật của nhóm nên dùng tham số này hoặc User-Agent có liên hệ. Lab không gửi email nào.
Không thử lại 500 vô hạn
Với fullTextXML, mã 500 trong lab là kết quả ổn định của một ID không có toàn văn Open Access. Pipeline thử lại tối đa một lần sau vài giây, rồi ghi trạng thái. Thử lại nhiều lần làm tăng tải cho máy chủ mà không có lợi gì.
Nhịp gọi trong lab
Lab nghỉ 1 giây giữa các lượt và không gặp mã 429 hay lỗi giới hạn nào. Đây là quan sát với 18 lượt gọi, không phải giới hạn công bố. Với hàng nghìn lượt, giữ nhịp chậm, gửi liên hệ và lưu kết quả để không gọi lại.
Gom ID theo nhóm
Truy vấn search nhận toán tử OR giữa nhiều điều kiện. Thay vì gọi một lượt cho mỗi PMID, có thể gom vài chục PMID vào một truy vấn với OR và pageSize phù hợp. Lab chưa thử cách này, nên chỉ nêu như hướng làm và cần kiểm độ dài truy vấn tối đa trước.
Tải hàng loạt
Với hàng chục nghìn bài Open Access, Europe PMC có kênh tải hàng loạt riêng. Gọi fullTextXML từng bài phù hợp cho danh sách nhỏ. Lab chưa thử kênh tải hàng loạt nên không mô tả chi tiết.
Tôn trọng giấy phép
Toàn văn cc by cho phép dùng lại có ghi nguồn. Các giấy phép khác có thể cấm dùng thương mại hay sửa đổi. Pipeline lưu license cùng XML để người dùng sau biết được làm gì, đặc biệt khi dữ liệu được dùng huấn luyện mô hình.
Tách bước tải và bước xử lý
Bước tải gọi API và lưu XML vào thư mục theo PMCID. Bước xử lý đọc XML từ đĩa, không gọi mạng. Khi mô hình trích xuất thay đổi, chỉ chạy lại bước xử lý. Cách tách này cũng giúp đếm chính xác bao nhiêu bài thật sự có toàn văn.
Đọc toàn văn XML
XML của A1 có gốc article theo cấu trúc JATS thường dùng cho bài báo: phần front chứa metadata, phần body chứa nội dung, tài liệu tham khảo nằm trong ref-list, hình nằm trong fig. Mã trích xuất nên đọc đoạn văn trong body và bỏ qua bảng, hình nếu chưa cần. Đếm đoạn body như lab là phép kiểm nhanh XML có đủ nội dung.
Dữ liệu cho huấn luyện mô hình
Nếu toàn văn được dùng để huấn luyện mô hình, nhóm cần đọc kỹ giấy phép của từng bài và chính sách của Europe PMC về khai phá văn bản. Lưu license theo từng bài giúp lọc tập huấn luyện theo giấy phép về sau. Bài không có license mở không nên vào tập này chỉ vì đọc được trên web.
Báo cáo con số trung thực
Báo cáo cuối nên ghi tổng số PMID đầu vào, số bài có PMCID, số bài Open Access, số bài tải được XML và số bài chỉ có abstract. Năm con số này cho thấy phạm vi thật của phân tích. Một con số duy nhất như số bài đã xử lý dễ gây hiểu nhầm.
Proxy ở đâu trong luồng
API của Europe PMC không cần IP riêng, và quyền toàn văn không đổi theo IP. Proxy chỉ có vai trò khi hạ tầng của nhóm phải đi ra Internet qua một điểm cố định. Khi cần IP tại Việt Nam cho phần tải, anh em có thể mua proxy tại trang chủ ProxyVN. Vai trò của proxy có ở bài Web Scraping proxy là gì, cách ghi chuỗi cấu hình có ở bài định dạng proxy.
Không vượt trang kiểm tra
Trang europepmc.org trả 403 cho công cụ tự động trong lab. Đó là chính sách của trang web, không phải lỗi cần vượt. API trên www.ebi.ac.uk mới là kênh dành cho máy. Pipeline chỉ dùng API.
Europe PMC API full text status: câu hỏi thường gặp
Các câu dưới đây gom những điểm hay bị hỏi.
Có PMCID là tải được toàn văn không?
Không. Trong lab, ba bài có PMCID, chỉ một bài thuộc Open Access tải được fullTextXML.
Vì sao fullTextXML trả 500?
Trong lab, 500 xuất hiện với bài không Open Access, với ID preprint và với ID không tồn tại.
Free có phải Open access không?
Không. Free là đọc được trên web, Open access kèm license mới cho tải qua API.
Nên dùng lite hay core?
core khi cần license, abstract và đường dẫn toàn văn. lite thiếu cả ba trong lab.
Preprint tải toàn văn thế nào?
Preprint A4 có ID PPR và không có PMCID, fullTextXML không nhận ID này. Lab chưa thử kênh khác.
Có abstract thì có toàn văn không?
Không. Bài A5 có abstract nhưng không có toàn văn trong Europe PMC.
Có cần khóa API không?
Không. Lab gọi API không xác thực và không gặp giới hạn nào ở mức 1 lượt mỗi giây.
Europe PMC API full text status và những điều cần nhớ
Europe PMC API full text status phải xác định từ bản ghi core, với isOpenAccess, PMCID và license, trước khi gọi fullTextXML. Lab cho thấy chỉ bài Open Access tải được XML, còn bài Free, preprint và ID sai đều nhận 500 giống nhau. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em lưu bốn trạng thái riêng khi làm việc với Europe PMC API full text status.


