
Docling xử lý tài liệu web: giữ bảng, bố cục và provenance
Docling xử lý tài liệu web là cách đưa PDF, Word hay HTML đã tải về qua một bộ phân tích bố cục. Kết quả là tài liệu có cấu trúc: heading, đoạn văn, bảng có hàng cột, kèm tọa độ của từng khối trên trang. Khác với trích chữ thuần theo trang, Docling cố hiểu tài liệu được trình bày thế nào. ProxyVN chạy thử ngày 29/10/2026 với Docling 2.145.0 trên ba PDF tự tạo. Bảng được trích đúng từng ô, nhưng thứ tự đọc của bản báo cáo hai cột bị xáo: tiêu đề nằm giữa, mục 3 đứng trước mục 2. Bài ghi lại cách phát hiện và sửa bằng tọa độ provenance.
Docling xử lý tài liệu web: mục tiêu dữ liệu, quyền và phạm vi truy cập
Phần đầu chốt Docling dùng cho việc gì, đầu ra cần gì và ranh giới với các công cụ PDF khác.
Docling là gì
Docling là thư viện Python mã nguồn mở, ban đầu do IBM Research phát triển, nay thuộc dự án Docling. Docling đọc PDF, DOCX, PPTX, XLSX, HTML, ảnh và vài định dạng khác, rồi dựng một đối tượng DoclingDocument thống nhất cho mọi định dạng.
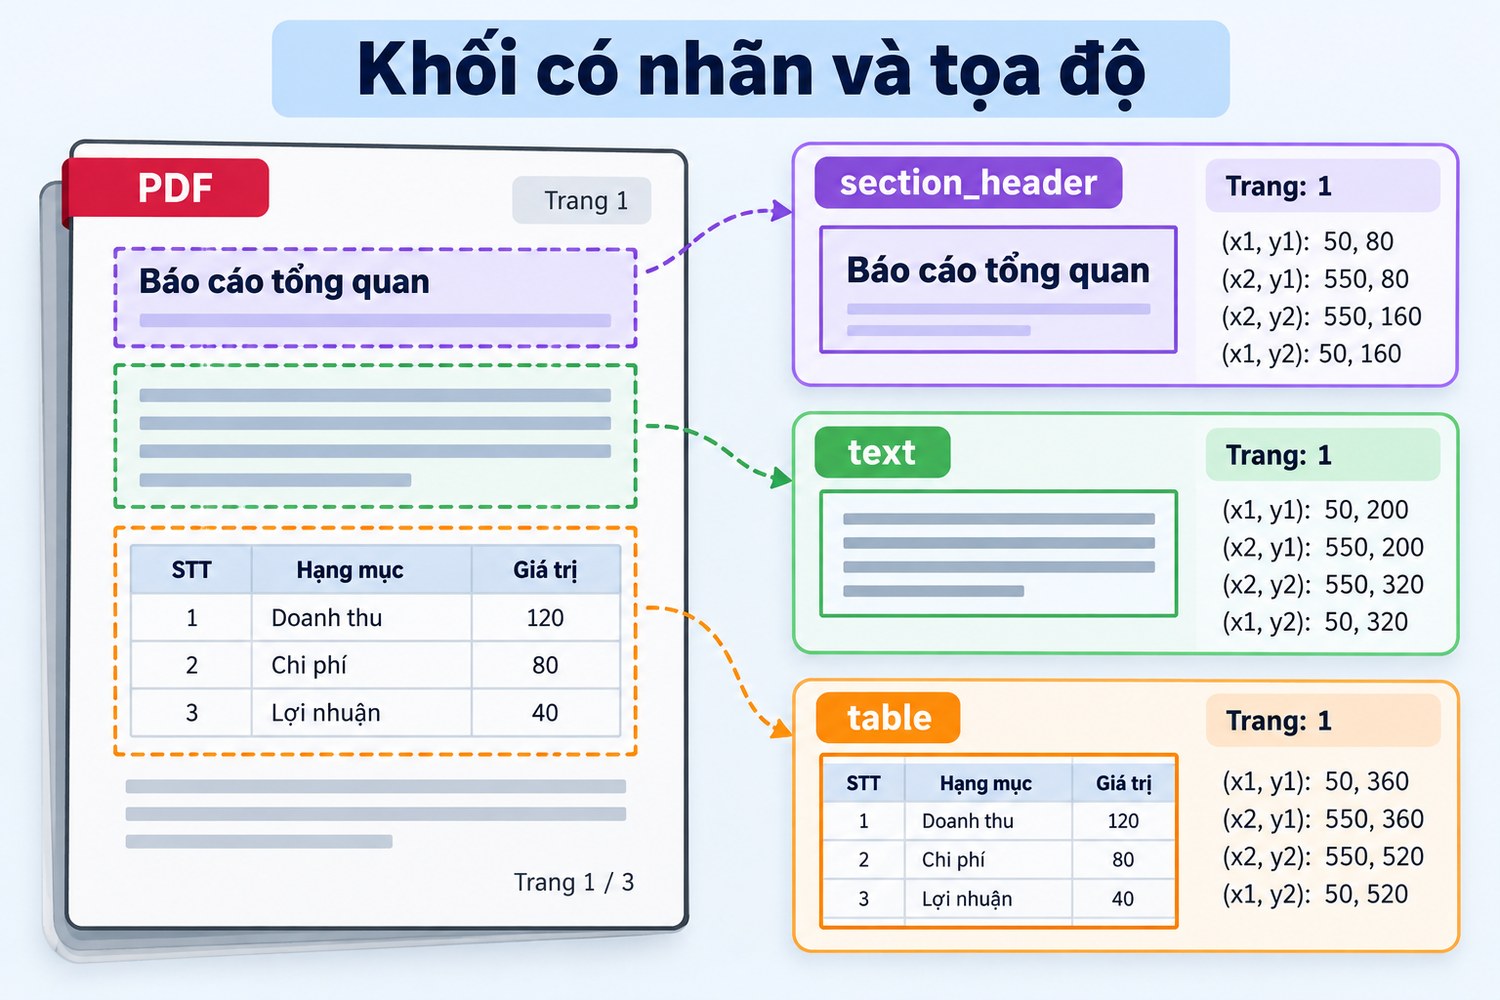
Với PDF, Docling dùng mô hình học máy để nhận dạng bố cục: đâu là tiêu đề, đâu là đoạn văn, đâu là bảng, đâu là hình. Bảng được đưa qua một mô hình riêng để dựng lưới hàng cột. Kết quả xuất được Markdown, HTML, JSON và văn bản thuần.
Đầu ra mà bài này hướng tới
Đầu ra cho mỗi tài liệu gồm ba thứ. Tệp Markdown để đọc và đưa vào RAG. Tệp JSON đầy đủ của DoclingDocument, giữ nhãn và tọa độ từng khối. Bảng đối soát ghi số heading, số bảng, hình dạng bảng, thứ tự đọc và các điểm lệch so với tài liệu gốc.
Phần provenance là thứ phân biệt bài này với trích chữ thường. Mỗi khối có số trang và hộp tọa độ, nên người đọc có thể quay về đúng chỗ trên PDF gốc để kiểm.
Tài liệu web là tài liệu đã tải
Tài liệu web ở đây là PDF hay tệp văn phòng anh em đã tải hợp lệ từ website: báo cáo thường niên, tài liệu kỹ thuật, biểu mẫu công khai. Bài bắt đầu từ tệp trên đĩa. Việc tải tuân theo robots.txt và điều khoản của nguồn, như mọi bài thu thập dữ liệu khác.
Docling có thể nhận URL và tự tải. Bài khuyên tách bước tải ra code riêng để lưu tệp gốc, kiểm Content-Type và cấu hình mạng rõ ràng.
Dữ liệu lab là dữ liệu giả lập
Lab tạo ba PDF bằng reportlab với font Arial có dấu tiếng Việt. Tệp report.pdf là báo cáo một trang có tiêu đề, hai cột văn bản và một bảng kết quả trải ngang phía dưới. Tệp lattice.pdf là bảng giá giả lập có kẻ lưới. Tệp scan.pdf là ảnh chụp của lattice.pdf nhúng lại, không có lớp chữ.
Mỗi đoạn văn trong report.pdf mở đầu bằng nhãn như CỘT TRÁI đoạn 1 hay CỘT PHẢI đoạn 2. Nhãn này giúp lab kiểm thứ tự đọc bằng một phép tìm chuỗi đơn giản.
Quyền với tài liệu nguồn
Phân tích bố cục không đổi quyền với nội dung. Báo cáo của doanh nghiệp vẫn thuộc doanh nghiệp. Tài liệu có giấy phép mở thì dùng theo giấy phép. Ghi URL nguồn và ngày tải cạnh mỗi tệp kết quả.
Ranh giới với trích chữ thuần
Bài trích văn bản PDF sau web crawl bàn việc lấy chữ theo trang và theo tọa độ. Đầu ra là chuỗi văn bản, bảng thành các dòng chữ rời rạc. Docling thì trả bảng thành lưới ô và gắn nhãn loại cho từng khối.
Trích chữ thuần nhanh, nhẹ, không cần mô hình. Docling chậm hơn, nặng hơn nhiều, nhưng giữ được cấu trúc. Chọn theo việc cần làm, không theo công cụ nào mới hơn.
Ranh giới với công cụ chuyên trích bảng
Công cụ chuyên trích bảng chỉ làm một việc là tìm bảng và dựng ô. Docling làm cả tài liệu: heading, đoạn, danh sách, bảng, hình, chú thích. Khi chỉ cần bảng từ hàng nghìn PDF cùng khuôn, công cụ chuyên dụng thường nhanh hơn. Khi cần cả tài liệu có cấu trúc, Docling phù hợp hơn.
Ai cần Docling
Nhóm làm RAG trên tài liệu doanh nghiệp cần heading để chia đoạn và bảng còn đọc được. Nhóm số hóa cần chuyển kho PDF cũ sang định dạng có cấu trúc. Người làm kiểm định cần biết mỗi câu trích ra nằm ở trang nào, chỗ nào trên PDF.
Cả ba đều cần thứ tự đọc đúng. Đó là điểm lab kiểm kỹ nhất.
Docling xử lý tài liệu web: giữ cấu trúc bảng, khối và provenance thay cho trích text đơn thuần
Khối có nhãn và tọa độ
Phần này đi qua cách gọi Docling và kết quả trên ba PDF.
Gọi DocumentConverter
from docling.document_converter import DocumentConverter, PdfFormatOption
from docling.datamodel.base_models import InputFormat
from docling.datamodel.pipeline_options import PdfPipelineOptions
po = PdfPipelineOptions()
po.do_ocr = False
po.do_table_structure = True
conv = DocumentConverter(format_options={
    InputFormat.PDF: PdfFormatOption(pipeline_options=po)})
res = conv.convert("report.pdf")
doc = res.document
md = doc.export_to_markdown()
data = doc.export_to_dict()
Lab tắt OCR vì hai trong ba PDF có lớp chữ thật, và để thấy rõ Docling xử lý bản scan thế nào khi không có OCR. Bật nhận dạng cấu trúc bảng để có lưới ô.
Lần chạy đầu tải mô hình
Lần chạy đầu với report.pdf mất 57,54 giây, phần lớn là tải trọng số mô hình bố cục và mô hình bảng từ Hugging Face. Docling in cảnh báo đang gửi request không xác thực tới Hugging Face Hub. Các lần sau dùng bộ nhớ đệm.
Khi đã có mô hình, khởi tạo bộ chuyển đổi mất 0,19 giây, lần chuyển đầu trong tiến trình mất 10,74 giây vì phải nạp mô hình vào bộ nhớ, lần chuyển thứ hai cùng tệp mất 3,61 giây. Hai lần cho Markdown giống hệt từng ký tự.
Kết quả trên ba PDF
Tệp |
Trạng thái |
Giây |
Khối chữ |
Bảng |
Hình dạng bảng |
|---|---|---|---|---|---|
report.pdf |
SUCCESS |
57,54 lần đầu |
9 |
1 |
4 x 4 |
lattice.pdf |
SUCCESS |
3,98 |
3 |
1 |
5 x 5 cộng tiêu đề |
scan.pdf |
SUCCESS |
4,45 |
0 |
1 |
0 x 0 |
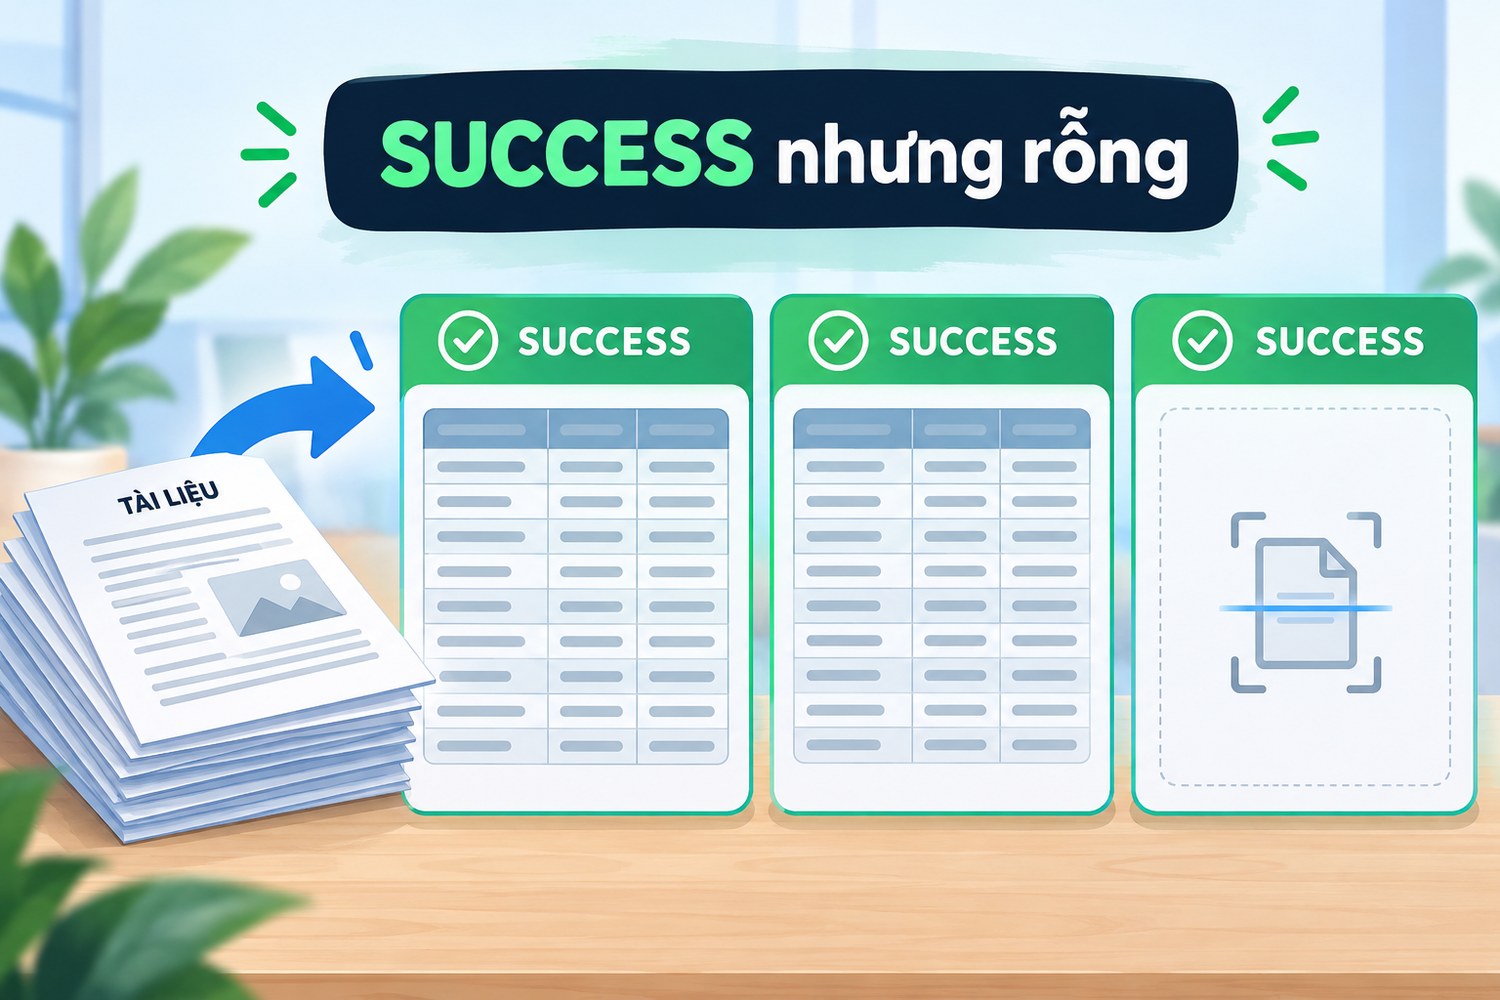
Cả ba đều báo SUCCESS. Đây là điểm cần chú ý: SUCCESS với scan.pdf không có nghĩa là có nội dung.
Bảng được trích đúng
Bảng của lattice.pdf ra DataFrame 5 hàng 5 cột, với hàng tiêu đề Gói, Quốc gia, Luồng, Giá tháng, Băng thông được nhận đúng thành tên cột. Mọi ô khớp với đáp án, kể cả chữ có dấu và số kiểu Việt Nam như 1.200.000.
Bảng của report.pdf ra 4 hàng 4 cột với nội dung đúng, nhưng tên cột là 0, 1, 2, 3, còn hàng Loại proxy, Trung vị, P95, Tỷ lệ lỗi nằm trong dữ liệu thay vì làm tiêu đề. Hai bảng cùng kẻ lưới, cùng font, khác nhau ở chỗ bảng report có nền xám cho hàng đầu.
Heading và đoạn văn
report.pdf có bốn heading, Docling nhận đủ bốn với nhãn section_header. Mọi heading đều ra Markdown cấp hai, kể cả tiêu đề tài liệu vốn to hơn hẳn các heading mục. Docling không phân biệt cấp heading theo cỡ chữ trong lab này.
Đoạn văn mở đầu và ghi chú cuối của lattice.pdf ra đúng nhãn text, không bị gom vào bảng. Đây là điểm Docling làm tốt hơn các công cụ đoán bảng bằng khoảng trắng.
Bản scan không có nội dung
scan.pdf ra 0 khối chữ, Markdown rỗng. Mô hình bố cục vẫn nhận ra có một bảng trên trang và ghi hộp tọa độ của nó, nhưng bảng có 0 hàng 0 cột vì không có chữ để điền.
Khi bật OCR, Docling sẽ chạy nhận dạng chữ trên ảnh. Lab không bật OCR nên không có số liệu về chất lượng OCR với tiếng Việt. Job hàng loạt phải kiểm số khối chữ bằng 0, không tin vào trạng thái SUCCESS.
Chuẩn bị đầu vào, mô hình và phiên bản khi dùng Docling xử lý tài liệu web
Phần này gom các quyết định trước khi chạy hàng loạt: cài đặt, mô hình, OCR và tài nguyên máy.
Cài đặt nặng
Cài docling từ pip kéo theo torch và nhiều phụ thuộc học máy. Trên máy lab, cài vào venv riêng mất vài phút và kéo theo torch 2.15.0. Đây là khác biệt lớn so với thư viện trích chữ chỉ vài MB.
Đặt Docling trong môi trường riêng, không trộn với môi trường của crawler. Khi cập nhật torch cho việc khác, Docling không bị ảnh hưởng.
Mô hình tải từ Hugging Face
Trọng số mô hình bố cục và mô hình bảng được tải khi chạy lần đầu, lưu vào thư mục đệm của Hugging Face trong thư mục người dùng. Máy chạy job phải ra được Internet tới Hugging Face ở lần đầu, hoặc anh em tải trước rồi chép mô hình vào máy.
Với máy chủ không có Internet, tải mô hình trên máy khác rồi trỏ Docling tới thư mục đó theo tài liệu. Đây là cách làm chuẩn cho môi trường cách ly.
OCR bật hay tắt
OCR làm chậm đáng kể và cần mô hình OCR riêng. Với PDF có lớp chữ, OCR không cần. Lab tắt OCR và phân loại trước: PDF có lớp chữ đi nhánh không OCR, PDF ảnh đi nhánh có OCR.
Phân loại bằng cách trích chữ nhanh bằng pdfminer hay pypdfium2. Trang ra rỗng là trang ảnh. Cách này rẻ hơn nhiều so với chạy Docling hai lần.
Tài nguyên máy
Docling chạy được trên CPU, như lab đã làm, không cần GPU. Thời gian vài giây mỗi trang trên CPU là chấp nhận được với vài trăm tài liệu, nhưng chậm với hàng chục nghìn. GPU tăng tốc mô hình bố cục và bảng.
Bộ nhớ cũng đáng kể vì mô hình nằm trong RAM. Không chạy quá nhiều tiến trình Docling song song trên máy nhỏ.
Phiên bản
Lab dùng Python 3.12.10, docling 2.145.0, docling-core 2.105.0, docling-parse 7.24.1, torch 2.15.0. Docling cập nhật nhanh, nhiều bản mỗi tháng. Khóa phiên bản trong requirements.txt và ghi phiên bản vào mỗi tệp kết quả.
Hành vi thứ tự đọc mà lab ghi nhận có thể đổi ở bản sau. Đó là thêm lý do phải ghi phiên bản.
HTML và DOCX không cần mô hình bố cục
Với HTML và DOCX, cấu trúc đã có sẵn trong tệp: thẻ heading, thẻ bảng, kiểu đoạn. Docling đọc trực tiếp, không cần mô hình bố cục. Lab chỉ thử PDF, nơi phân tích bố cục là việc khó nhất.
Thu kết quả và kiểm thứ tự đọc khi dùng Docling xử lý tài liệu web
Thứ tự đọc bị xáo
Phần này ghi lại phát hiện quan trọng nhất của lab: thứ tự đọc của bản báo cáo hai cột.
Thứ tự đúng của report.pdf
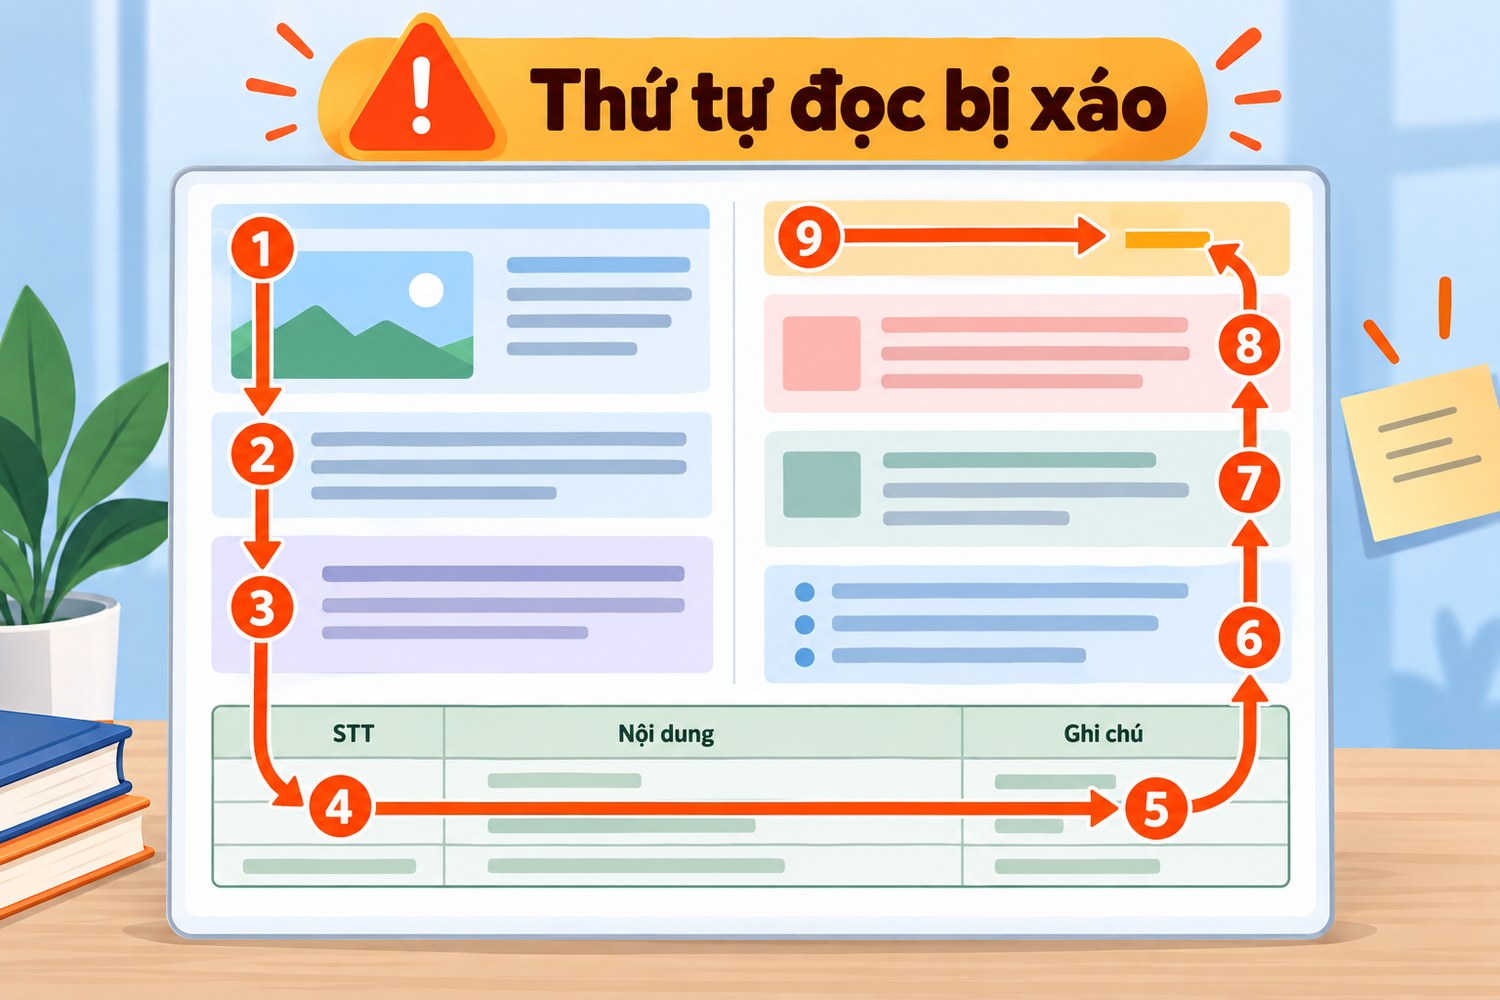
Người đọc report.pdf sẽ bắt đầu từ tiêu đề Báo cáo thử nghiệm proxy quý 3. Tiếp theo là mục 1 Phạm vi ở cột trái, rồi mục 2 Phương pháp ở cột phải. Sau cùng là mục 3 Kết quả với bảng trải ngang phía dưới và dòng ghi chú.
pdfminer trích chữ thuần cho thứ tự hai cột đúng: CỘT TRÁI đoạn 1, CỘT TRÁI đoạn 2, CỘT PHẢI đoạn 1, CỘT PHẢI đoạn 2, rồi tới bảng.
Thứ tự Docling trả về
Vị trí trong Markdown |
Khối |
Tọa độ trên |
Tọa độ trái |
|---|---|---|---|
1 |
1. Phạm vi |
711,9 |
46,0 |
2 |
CỘT TRÁI đoạn 1 |
689,1 |
46,0 |
3 |
CỘT TRÁI đoạn 2 |
653,1 |
46,0 |
4 |
3. Kết quả |
310,0 |
46,0 |
5 |
Ghi chú |
207,2 |
46,0 |
6 |
Báo cáo thử nghiệm proxy quý 3 |
790,8 |
157,6 |
7 |
2. Phương pháp |
711,9 |
313,6 |
8 |
CỘT PHẢI đoạn 1 |
689,1 |
313,6 |
9 |
CỘT PHẢI đoạn 2 |
653,1 |
313,6 |
Docling đọc hết mọi khối có mép trái ở 46, từ trên xuống, gồm cả cột trái và phần dưới trải ngang. Rồi mới tới tiêu đề có mép trái ở 157,6. Cuối cùng là cột phải ở 313,6. Bảng nằm giữa mục 3 và ghi chú.
Hệ quả cho người đọc và cho RAG
Markdown mở đầu bằng mục 1, nhảy sang mục 3 và bảng, rồi mới tới tiêu đề tài liệu, rồi mục 2. Người đọc sẽ bối rối. Với RAG, đoạn chia theo heading sẽ ghép mục 3 với ghi chú, ghép tiêu đề với mục 2. Câu trả lời dựa trên các đoạn đó có thể lẫn ngữ cảnh.
Đây là lỗi im lặng. Trạng thái SUCCESS, số heading đúng, bảng đúng. Chỉ phép kiểm thứ tự mới phát hiện.
Kiểm thứ tự bằng nhãn
Lab đặt nhãn trong từng đoạn nên kiểm rất dễ. Với tài liệu thật không có nhãn, kiểm bằng số mục: heading đánh số 1, 2, 3 phải xuất hiện theo thứ tự tăng. Report.pdf ra 1, 3, rồi tiêu đề không số, rồi 2, sai thứ tự.
Phép kiểm này bắt được phần lớn lỗi thứ tự ở báo cáo có mục đánh số. Tài liệu không đánh số cần so với trích chữ thuần hoặc xem tay trên mẫu.
Sắp lại bằng tọa độ provenance
Mỗi khối trong DoclingDocument có prov với số trang và hộp tọa độ gồm trái, trên, phải, dưới. Gốc tọa độ ở góc dưới trái trang, nên giá trị trên lớn hơn nghĩa là khối nằm cao hơn.
Một quy tắc sắp đơn giản cho bố cục hai cột: xác định dải dọc mà cả hai cột cùng có chữ. Khối trên dải là phần đầu, khối dưới dải là phần cuối, còn trong dải thì đọc cột trái trước cột phải. Quy tắc này sửa được report.pdf, nhưng phải hiệu chỉnh cho từng loại bố cục.
Hàm sắp lại theo tọa độ
def reading_order(doc, page_w=595.0, split=0.5):
    top = lambda t: -t.prov[0].bbox.t
    right = [t for t in doc.texts if t.prov[0].bbox.l >= page_w * split]
    band_top = max(t.prov[0].bbox.t for t in right)
    band_bot = min(t.prov[0].bbox.b for t in right)
    head, left, below = [], [], []
    for t in doc.texts:
        b = t.prov[0].bbox
        if t in right:
            continue
        if b.b > band_top:
            head.append(t)
        elif b.t < band_bot:
            below.append(t)
        else:
            left.append(t)
    return (sorted(head, key=top) + sorted(left, key=top)
            + sorted(right, key=top) + sorted(below, key=top))
Hàm lấy các khối ở nửa phải trang làm cột phải, rồi dùng mép trên và mép dưới của cột phải để xác định dải hai cột. Khối nằm hẳn trên dải là phần đầu, nằm hẳn dưới dải là phần cuối, còn lại thuộc cột trái. Mỗi nhóm sắp theo chiều dọc rồi ghép theo thứ tự đầu, trái, phải, cuối.
Lab chạy hàm này trên JSON của report.pdf. Kết quả đúng thứ tự người đọc: tiêu đề, mục 1 với hai đoạn cột trái, mục 2 với hai đoạn cột phải, mục 3, ghi chú.
Vì sao phiên bản đầu của hàm sai
Bản nháp đầu của lab chia khối theo độ rộng: khối rộng hơn 60 phần trăm trang là khối trải ngang. Cách đó bắt được tiêu đề nhưng bỏ sót heading 3. Kết quả, vì heading này ngắn, chỉ rộng từ 46 tới 113 điểm, nên bị xếp vào cột trái. Bảng trải ngang không nằm trong danh sách khối chữ nên không giúp được. Nếu muốn đặt bảng đúng chỗ, phải xử lý thêm danh sách doc.tables theo cùng quy tắc tọa độ.
Bài học: phân nhóm theo vị trí dọc so với dải hai cột ổn định hơn phân nhóm theo độ rộng khối. Quy tắc vẫn chỉ đúng cho bố cục một vùng hai cột mỗi trang, tài liệu phức tạp hơn cần quy tắc khác.
Vì sao không sửa luôn ở Docling
Docling có mô hình thứ tự đọc riêng và có thể cải thiện ở bản sau. Sửa bằng hậu xử lý trên provenance là cách an toàn vì không phụ thuộc bản nào. Ghi rõ quy tắc sắp lại vào tài liệu pipeline, và giữ thứ tự gốc của Docling trong JSON để so sánh khi nâng cấp.
Đặt kỳ vọng đúng
Một PDF một trang tự dựng không đại diện cho mọi báo cáo. Docling có thể xử lý đúng nhiều bố cục hai cột khác. Bài không kết luận Docling luôn sai thứ tự. Bài chỉ kết luận rằng thứ tự đọc phải được kiểm, vì lab đã thấy nó sai mà không có cảnh báo nào.
Đối soát cấu trúc, kiểu dữ liệu, giá trị thiếu và xuất xứ với Docling xử lý tài liệu web
Phần này biến các phát hiện thành phép kiểm tự động cho từng tài liệu.
Đếm khối theo nhãn
Mỗi khối chữ có nhãn như section_header, text, list_item, caption. Đếm số khối mỗi nhãn và ghi vào bảng đối soát. report.pdf có hai nhãn: section_header và text. Tài liệu có danh sách mà không có list_item nào là dấu hiệu Docling gộp danh sách vào đoạn văn.
Bảng: tiêu đề hay dữ liệu
Kiểm tên cột của DataFrame. Tên cột là số 0, 1, 2, 3 nghĩa là Docling không nhận được hàng tiêu đề. Khi đó lấy hàng đầu làm tiêu đề nếu nó trông giống tiêu đề, ví dụ mọi ô là chữ trong khi các hàng sau có số.
Lab gặp đúng tình huống này với bảng report.pdf. Sau khi nâng hàng đầu lên làm tiêu đề, bảng 3 hàng 4 cột khớp đáp án.
Mọi ô là chuỗi
Ô trong DataFrame là chuỗi. 0,4% là chuỗi, 1.200.000 là chuỗi. Chuyển kiểu theo quy tắc của tài liệu: dấu phẩy thập phân và dấu chấm hàng nghìn kiểu Việt Nam khác kiểu Anh. Quyết định một lần cho mỗi nguồn tài liệu.
Khối rỗng và trang ảnh
SUCCESS nhưng rỗng
Đếm khối chữ trên mỗi trang. Trang có 0 khối chữ trong tài liệu có lớp chữ là trang ảnh lẫn vào, cần OCR. Bảng có hộp tọa độ mà 0 ô là bảng trên ảnh, như scan.pdf.
Ghi rõ trong bảng đối soát: tài liệu nào có trang ảnh, trang số mấy, đã OCR hay chưa. Người dùng kết quả cần biết phần nào bị thiếu.
Giữ provenance khi xuất Markdown
Markdown mất tọa độ. Khi đưa vào RAG, mỗi đoạn nên mang theo số trang và hộp tọa độ từ JSON, để câu trả lời trích được nguồn cụ thể như trang 1, góc trên trái. Bài RAG với ChromaDB và dữ liệu web bàn cách lưu metadata như vậy cạnh đoạn văn.
Bài JSON và CSV khi crawl dữ liệu bàn cách tổ chức tệp đi kèm. Với Docling, JSON đầy đủ là bản gốc, Markdown là bản dẫn xuất.
Heading cùng cấp
Mọi heading ra cấp hai trong lab, kể cả tiêu đề tài liệu. Khi chia đoạn theo cấp heading, tiêu đề sẽ bị coi ngang hàng với mục. Hậu xử lý: khối section_header đầu tiên của trang đầu, nằm cao nhất, thường là tiêu đề, nâng lên cấp một.
Quy tắc này dựa trên tọa độ, nên phải chạy trên JSON có provenance, không chạy được trên Markdown.
Lưu kết quả, giới hạn request và khi nào Docling xử lý tài liệu web cần proxy
Phần cuối bàn chuyện lưu trữ, mạng và vị trí của proxy với một công cụ chạy cục bộ.
Lưu ba tầng
Lưu tệp gốc, JSON của DoclingDocument và Markdown. Khi đổi quy tắc hậu xử lý thứ tự hay tiêu đề, chạy lại từ JSON mà không cần chạy lại mô hình. Khi nâng cấp Docling, chạy lại từ tệp gốc và so JSON mới với cũ.
Docling chạy cục bộ
Sau khi có mô hình, việc phân tích tài liệu diễn ra trên máy, không gửi nội dung đi đâu. Đây là lợi thế lớn với tài liệu nội bộ so với dịch vụ phân tích tài liệu trên mây.
Mạng chỉ cần ở hai chỗ: tải tài liệu nguồn, và tải mô hình lần đầu từ Hugging Face. Lab ghi nhận cảnh báo request không xác thực tới Hugging Face Hub ở lần tải mô hình.
Tải tài liệu tôn trọng nguồn
Khi tải hàng loạt PDF từ website, nghỉ giữa các request, đặt User-Agent rõ ràng, dùng If-Modified-Since để không tải lại tệp chưa đổi. Bài rate limit API khi dùng proxy có mẫu bộ đếm request.
Proxy ở bước tải và bước lấy mô hình
Máy chủ trong mạng doanh nghiệp thường chỉ ra Internet qua proxy. Khi đó cả bước tải tài liệu lẫn bước Docling tải mô hình từ Hugging Face đều phải đi qua proxy. Thư viện Hugging Face đọc biến môi trường HTTPS_PROXY như requests.
Lab không chạy Docling qua proxy, vì máy lab ra Internet trực tiếp. Bước phân tích tài liệu không cần proxy vì không có lưu lượng mạng.
Khi nào cần proxy thật
Proxy cần khi máy chạy pipeline nằm trong mạng nội bộ chỉ được ra Internet qua proxy. Trường hợp thứ hai là tổ chức yêu cầu lưu lượng ra ngoài đi qua một IP cố định để giám sát, hay để website nguồn đưa IP đó vào danh sách cho phép. Cấu hình và mã hóa mật khẩu có ký tự đặc biệt có trong bài định dạng proxy.
Bài Web Scraping proxy là gì phân biệt các vai trò của proxy. Bài proxy cho RAG pipeline bàn vị trí proxy khi tài liệu web đi vào hệ thống hỏi đáp.
Khi máy chủ của nhóm đặt tại Việt Nam và cần IP thoát ổn định cho job tải tài liệu, proxy tĩnh dễ quản lý hơn proxy xoay. ProxyVN có proxy dân cư tĩnh, datacenter, 4G và proxy xoay qua HTTP hoặc SOCKS5. Anh em có thể mua proxy Việt Nam tại trang chủ ProxyVN rồi khai báo vào biến môi trường HTTPS_PROXY của máy chạy pipeline.
Giới hạn suy luận của bài
Số liệu đến từ ba PDF một trang tự tạo, chạy Docling 2.145.0 trên CPU ngày 29/10/2026. Lỗi thứ tự đọc được ghi nhận với một bố cục cụ thể, không đại diện cho mọi PDF hai cột. Thời gian chạy phụ thuộc máy và có thể khác nhiều trên máy có GPU.
Lab không bật OCR, không thử HTML, DOCX hay PPTX, không thử tài liệu nhiều trang, không chạy qua proxy. Nhận xét về hàng tiêu đề bảng chỉ dựa trên hai bảng.
Checklist Docling xử lý tài liệu web
Checklist Docling
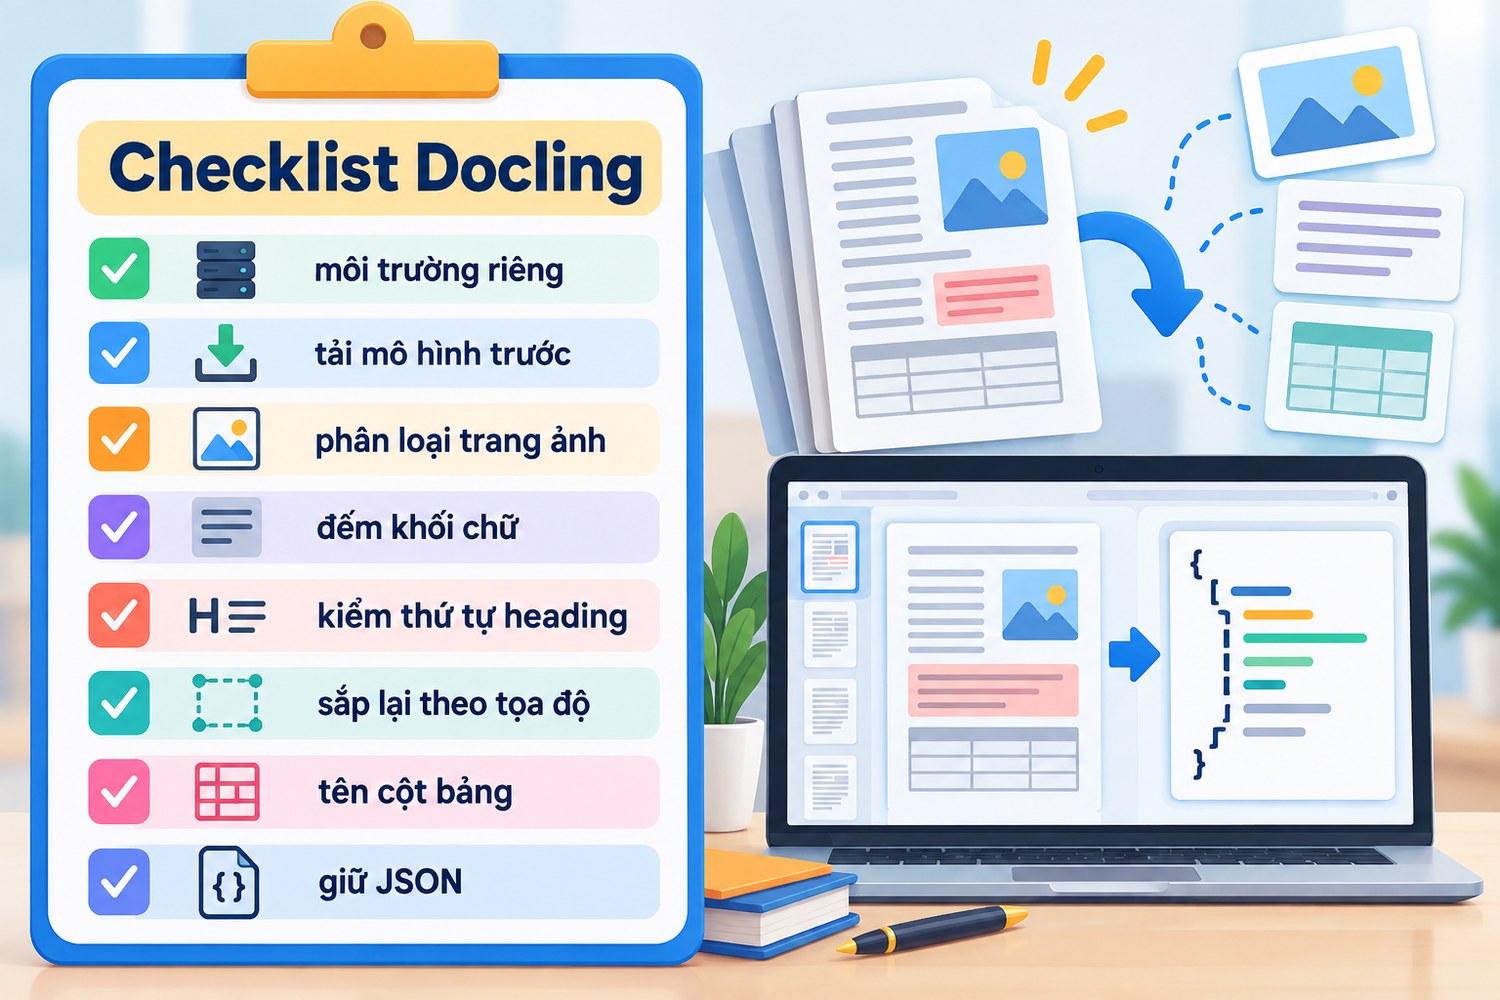
- Cài Docling trong môi trường riêng, khóa phiên bản.
- Tải mô hình trước cho máy không có Internet.
- Phân loại trang có chữ và trang ảnh, bật OCR có chủ ý.
- Không tin trạng thái SUCCESS, đếm khối chữ.
- Kiểm thứ tự đọc bằng số mục heading.
- Sắp lại bằng tọa độ provenance khi cần.
- Kiểm tên cột bảng, nâng hàng tiêu đề nếu cần.
- Lưu JSON đầy đủ, Markdown là bản dẫn xuất.
Câu hỏi thường gặp về Docling xử lý tài liệu web
Docling có cần GPU không?
Không. Lab chạy trên CPU, vài giây mỗi trang sau khi mô hình đã nạp. GPU giúp nhanh hơn.
Vì sao lần chạy đầu rất lâu?
Docling tải mô hình từ Hugging Face ở lần đầu. Lab đo 57,54 giây cho lần đầu, 3,61 giây cho lần chạy nóng.
Docling có đọc được PDF scan không?
Cần bật OCR. Không OCR, lab thấy bản scan ra 0 khối chữ dù trạng thái là SUCCESS.
Thứ tự đọc có luôn đúng không?
Không, trong lab. Bản báo cáo hai cột ra sai thứ tự. Kiểm bằng số mục heading và sắp lại bằng tọa độ.
Docling khác trích chữ thuần ở đâu?
Docling gắn nhãn khối, dựng bảng thành lưới ô và giữ tọa độ. Trích chữ thuần chỉ trả chuỗi văn bản.
Có gửi tài liệu lên mạng không?
Không. Phân tích chạy cục bộ. Mạng chỉ dùng để tải tài liệu nguồn và tải mô hình lần đầu.
Docling xử lý tài liệu web và những điều cần nhớ
Docling xử lý tài liệu web cho anh em tài liệu có cấu trúc thay vì chuỗi chữ rời: heading, bảng có ô, tọa độ từng khối. Lab ngày 29/10/2026 trích đúng mọi ô bảng, nhưng thứ tự đọc của bản hai cột bị xáo và bản scan ra rỗng dù báo SUCCESS. Kiểm thứ tự, dùng provenance để sửa, giữ JSON làm bản gốc. Cần IP thoát ổn định cho máy chủ tải tài liệu trước khi chạy Docling xử lý tài liệu web, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


