
dlt incremental API ingestion: cursor, bản đến muộn và lag
dlt incremental API ingestion là cách dùng thư viện dlt để gọi một API nhiều lần, mỗi lần chỉ lấy phần bản ghi mới kể từ lần trước, nhờ một cursor được lưu lại giữa các lượt chạy. Cursor thường là trường thời gian cập nhật. Cách này tiết kiệm request, nhưng bản ghi đến muộn có thể lọt khỏi cửa sổ và không bao giờ được nạp. ProxyVN chạy dlt 1.32.0 ngày 03/11/2026 với một API giả lập có phân trang, nạp hai lượt có bản trùng mốc và bản đến muộn. Sau đó lab thử tham số lag, rồi xóa thư mục cục bộ để xem state có được khôi phục không. Bài ghi lại cursor sau từng lượt và những bản ghi bị bỏ sót.
dlt incremental API ingestion: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và ranh giới với dbt.
Bài toán
Một API của đối tác trả danh sách sản phẩm và giá, có tham số since để lọc theo thời gian cập nhật. Nhóm dữ liệu cần nạp API này vào kho mỗi giờ. Gọi lại toàn bộ mỗi lần thì tốn quota và chậm. Gọi theo since thì phải nhớ lần trước đã tới đâu, và phải xử lý những bản ghi được cập nhật nhưng hiện ra muộn.
Đầu ra nghiệm thu
Đầu ra gồm hai lượt nạp, lượt thứ hai có bản ghi đến muộn và bản ghi trùng mốc thời gian với lượt trước, kèm state cursor sau mỗi lượt để đối soát. Đối soát phải chỉ ra bản ghi nào đã vào kho, bản ghi nào lọt mất, và vì sao.
Ranh giới với dbt incremental
dlt làm việc ở tầng nạp: gọi nguồn, quyết định lấy gì, ghi vào kho. dbt làm việc ở tầng biến đổi: đọc bảng đã có trong kho, ghi bảng mới. Cursor của dlt quyết định request gửi đi có tham số since bằng bao nhiêu. Điều kiện lọc của dbt quyết định câu SELECT đọc dòng nào. Hai cơ chế có bẫy giống nhau với bản đến muộn, nhưng nằm ở hai chỗ khác nhau.
Phiên bản đã khóa
Lab dùng dlt 1.32.0 với đích DuckDB, requests, Python 3.12 trên Windows. API giả lập chạy ở cổng 9461, đọc dữ liệu từ một tệp JSON có thể sửa giữa các lượt. Mỗi lượt nạp chạy trong một tiến trình riêng để mô phỏng việc khởi động lại.
Tài liệu đã đọc
Trang Incremental loading trong tài liệu dlt mô tả write_disposition, primary_key và cách dùng dlt.sources.incremental. Lab chỉ dùng những tham số có trong trang đó, và kiểm hành vi của từng tham số bằng chạy thật.
Vì sao không tự viết logic cursor
Tự viết thì cần lưu mốc vào đâu đó, đọc lại khi bắt đầu, cập nhật sau khi nạp xong, và xử lý trường hợp nạp lỗi giữa chừng. Mỗi bước đều có chỗ sai. dlt gói cả chuỗi này lại, và quan trọng hơn, chỉ cập nhật state khi lượt nạp thành công. Lượt lỗi không đẩy cursor lên.
Ai nên đọc
Người nạp dữ liệu từ API vào kho và đang tự viết logic nhớ mốc thời gian. Người dùng dlt và thấy số dòng trong kho ít hơn trong API mà không rõ vì sao. Người cần giải thích cho đối tác vì sao API của họ nên trả cả bản ghi có thời gian bằng mốc since.
Lưu cursor nguồn API bằng dlt và nạp dữ liệu tăng dần với dlt incremental API ingestion
Trước khi viết mã, cần nắm ba khái niệm của dlt.
Resource và write_disposition
Resource là một hàm sinh dữ liệu, khai báo bằng decorator dlt.resource. write_disposition cho biết cách ghi vào kho: append thêm dòng, replace thay cả bảng, merge gộp theo khóa. Với dữ liệu có thể cập nhật như giá sản phẩm, merge là lựa chọn phù hợp.
Merge cần kho hỗ trợ
Merge cần kho đích có khả năng cập nhật dòng theo khóa. DuckDB hỗ trợ, các kho phổ biến khác cũng vậy. Với đích dạng tệp như Parquet trên ổ đĩa, merge có thể không khả dụng hoặc hoạt động khác. Lab chỉ dùng DuckDB nên không khẳng định cho đích khác.
primary_key
primary_key là cột dùng để nhận ra cùng một bản ghi. Với merge, bản ghi mới có cùng khóa sẽ thay bản cũ trong kho. Lab dùng id của sản phẩm. Không có primary_key, merge không biết gộp theo gì.
dlt.sources.incremental
incremental là đối tượng theo dõi giá trị lớn nhất của một trường qua các lượt. Khai báo nó làm tham số mặc định của resource, dlt tự lưu giá trị lớn nhất sau mỗi lượt và đưa lại cho resource ở lượt sau qua thuộc tính last_value và start_value.
State lưu ở đâu
State của incremental nằm trong state của pipeline. dlt ghi state ra thư mục cục bộ của pipeline và đồng thời ghi vào một bảng đặc biệt trong kho đích. Lab sẽ kiểm cả hai chỗ.
Lọc phía client vẫn hữu ích
Ngay cả khi resource truyền since cho API, dlt vẫn kiểm từng bản ghi so với cursor. Nếu API lỗi và trả cả dữ liệu cũ, dlt loại những bản cũ hơn cursor. Lớp lọc này là lưới an toàn, không thay được việc lọc phía API vì chi phí request đã xảy ra.
Cursor không tự lọc phía API
incremental không tự thêm tham số vào request. Resource phải tự đọc start_value và truyền vào API. Nếu quên truyền, API trả toàn bộ dữ liệu, dlt vẫn lọc phía client và loại bản ghi cũ hơn cursor, nhưng mọi request vẫn tốn như gọi toàn bộ.
Chọn source cursor và write disposition theo bản dlt trong dlt incremental API ingestion
Phần này trình bày API giả lập và resource.
API giả lập
API nhận since và page, trả tối đa ba bản ghi mỗi trang kèm số trang tiếp theo. Điều kiện lọc là updated_at lớn hơn hoặc bằng since. Dữ liệu sắp theo updated_at rồi theo id. Mỗi request được ghi vào api.log để biết resource đã gọi gì.
Điều kiện lớn hơn hoặc bằng là quan trọng. Nếu API dùng lớn hơn hẳn, bản ghi có updated_at bằng đúng mốc since sẽ bị bỏ qua. Lab chọn lớn hơn hoặc bằng và để dlt xử lý trùng lặp.
Resource
@dlt.resource(name="items", primary_key="id", write_disposition="merge")
def items(updated_at=dlt.sources.incremental(
        "updated_at", initial_value="2026-11-01T00:00:00Z")):
    page = 1
    while page:
        r = requests.get("http://127.0.0.1:9461/items",
                         params={"since": updated_at.start_value, "page": page},
                         timeout=5).json()
        yield r["data"]
        page = r["next"]
initial_value là mốc cho lượt đầu tiên. Mỗi trang được yield ngay khi nhận, dlt gom lại và theo dõi giá trị updated_at lớn nhất.
Pipeline
p = dlt.pipeline(pipeline_name="gia_api",
                 destination=dlt.destinations.duckdb("gia_api.duckdb"),
                 dataset_name="raw", pipelines_dir="pipes")
p.run(items())
pipelines_dir đặt thư mục cục bộ chứa state, để lab có thể xóa nó sau. Tên pipeline là khóa để dlt tìm lại state ở lượt sau.
Yield theo trang
Resource yield từng trang thay vì gom hết rồi yield một lần. dlt xử lý từng trang khi nhận, không giữ toàn bộ dữ liệu trong bộ nhớ. Với API trả hàng trăm nghìn bản ghi, cách này tránh tràn bộ nhớ. Cursor vẫn được tính đúng trên toàn bộ dữ liệu của lượt.
Đọc state sau mỗi lượt
Sau p.run, lab đọc p.state, đi vào sources, resources, items, incremental, updated_at. Ở đó có last_value, start_value và unique_hashes. Đây là ba con số cần đối soát.
unique_hashes là gì
Khử trùng ở ranh giới
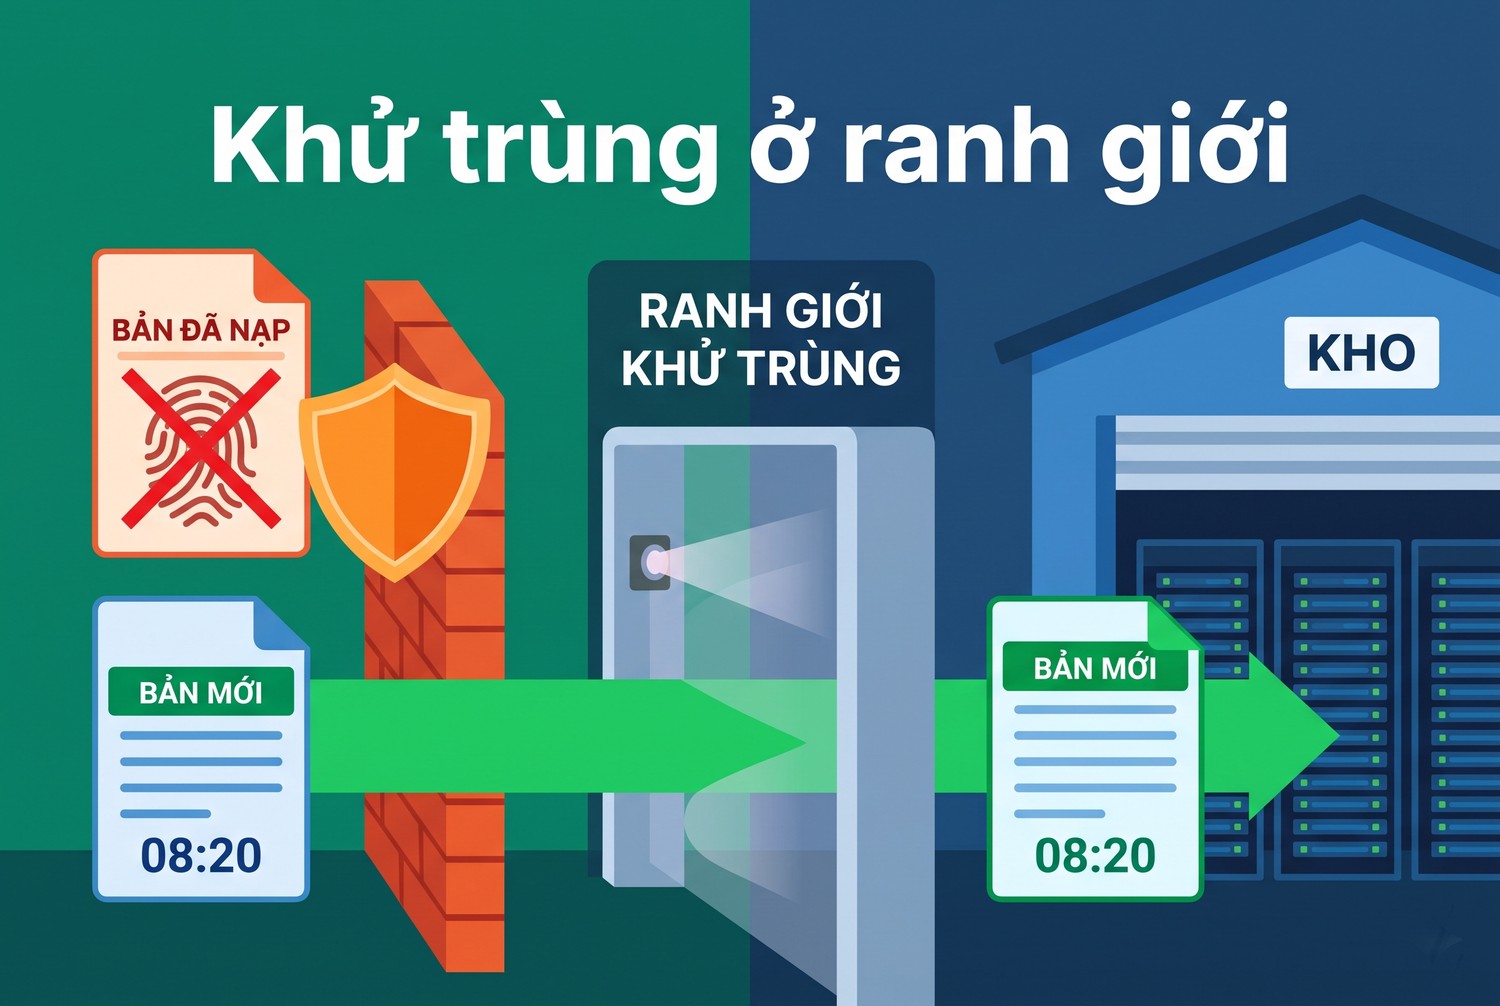
unique_hashes là danh sách mã băm của những bản ghi có updated_at bằng đúng last_value. Lượt sau, khi API trả lại các bản ghi ở đúng mốc này do điều kiện lớn hơn hoặc bằng, dlt so mã băm và bỏ những bản đã nạp. Nhờ vậy không có bản ghi nào bị nạp hai lần chỉ vì nằm ở ranh giới.
initial_value chỉ dùng một lần
initial_value chỉ có tác dụng ở lượt đầu tiên, khi chưa có state. Từ lượt sau, dlt dùng last_value đã lưu. Sửa initial_value trong mã sau khi pipeline đã chạy không làm gì cả. Muốn nạp lại từ một mốc cũ hơn, phải đặt lại state hoặc dùng tên pipeline mới.
Thời gian hiển thị theo giờ máy
Khi đọc bảng trong DuckDB, cột updated_at hiện theo múi giờ của máy, trong lab là giờ Đông Dương cộng 7. Bản ghi 08:00 UTC hiện thành 15:00. Giá trị lưu trữ không đổi, chỉ cách hiển thị khác. Khi so với API, nhớ quy về cùng múi giờ.
Thiết kế khóa chính cùng trường tăng dần của API fixture cho dlt incremental API ingestion
Phần này mô tả dữ liệu hai lượt.
Hai lượt mô phỏng hai lần chạy
Hai lượt nạp trong lab cách nhau vài giây, nhưng dữ liệu được dựng để mô phỏng hai lần chạy cách nhau một ngày. Tệp dữ liệu được sửa giữa hai lượt. API đọc lại tệp ở mỗi request, nên lượt sau thấy dữ liệu mới. Cách dựng này cho kết quả lặp lại được mỗi lần chạy lab.
Lượt 1
API có năm sản phẩm, id 1 tới 5, updated_at từ 08:00 tới 08:20 ngày 02/11, cách nhau 5 phút. Cursor bắt đầu ở initial_value 01/11.
Lượt 2
Dữ liệu API thay đổi. Sản phẩm 2 đổi giá thành 222.000, updated_at 08:00 ngày 03/11. Sản phẩm 6 mới, updated_at 08:20 ngày 02/11, bằng đúng mốc lớn nhất của lượt 1. Sản phẩm 7 mới, updated_at 08:12 ngày 02/11, nhỏ hơn mốc lớn nhất, mô phỏng bản ghi đến muộn. Sản phẩm 8 mới, updated_at 08:05 ngày 03/11.
Bản đến muộn xảy ra thế nào
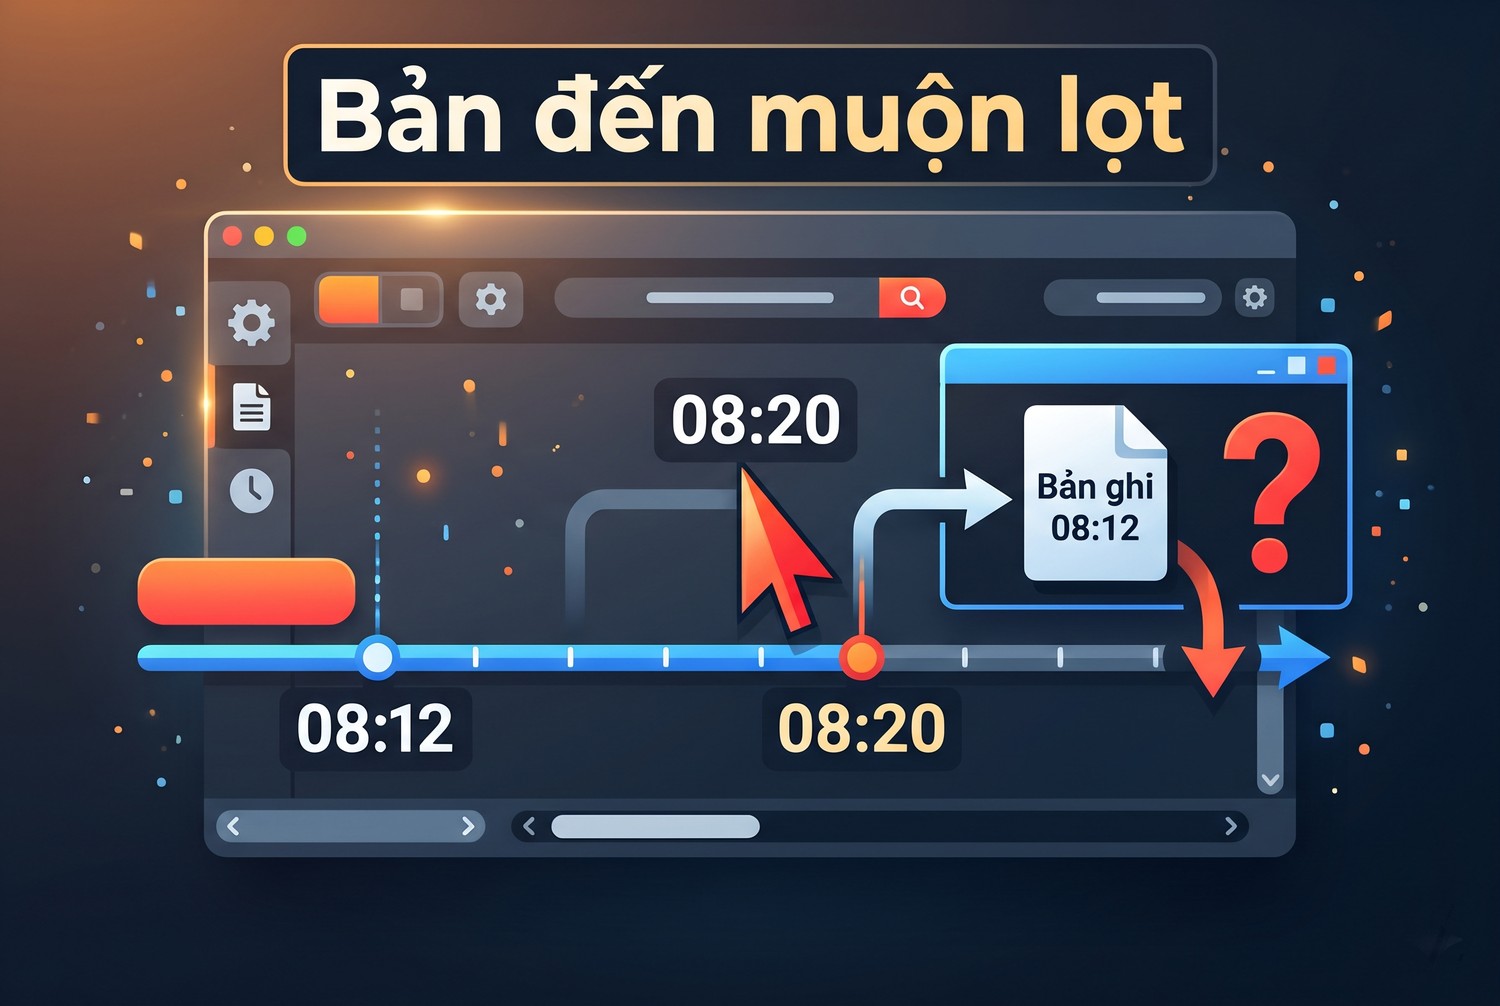
Trong hệ thống thật, bản ghi đến muộn xuất hiện khi nguồn ghi updated_at theo thời điểm sự kiện, nhưng bản ghi chỉ hiện trong API sau khi một tiến trình phía nguồn xử lý xong. Bản ghi có thời điểm 08:12 có thể chỉ hiện trong API lúc 08:30. Lượt nạp chạy lúc 08:25 đã đẩy cursor lên 08:20 và không bao giờ quay lại.
Sắp xếp ổn định phía API
API giả lập sắp theo updated_at rồi theo id. Sắp ổn định giúp phân trang không bỏ sót hay lặp bản ghi khi nhiều bản có cùng mốc. API sắp theo một trường không duy nhất có thể trả cùng bản ghi ở hai trang khác nhau, hoặc bỏ qua bản ghi nằm giữa hai trang. Nên hỏi đối tác API cách họ sắp trước khi tin phân trang.
Bản trùng mốc
Sản phẩm 6 có updated_at bằng đúng mốc 08:20 của sản phẩm 5. Nếu API lọc lớn hơn hẳn, sản phẩm 6 bị bỏ. Nếu API lọc lớn hơn hoặc bằng, sản phẩm 5 được trả lại và cần khử trùng. Lab kiểm cả hai khía cạnh.
Kết quả đúng phải là gì
Sau lượt 2, kho đúng có tám sản phẩm. Sản phẩm 2 giá 222.000. Sản phẩm 6, 7, 8 có mặt. Không sản phẩm nào xuất hiện hai lần.
Chọn trường cursor
Trường cursor phải tăng khi bản ghi thay đổi. updated_at đáp ứng điều đó. Trường created_at thì không: sản phẩm đổi giá vẫn giữ created_at cũ và sẽ không bao giờ được nạp lại. id tăng dần chỉ phù hợp với dữ liệu không bao giờ sửa, như nhật ký sự kiện.
Nạp hai lượt có bản ghi đến muộn hoặc timestamp bằng nhau với dlt incremental API ingestion
Phần này đọc kết quả hai lượt.
Lượt 1
Cursor trước khi gọi là initial_value. API nhận since bằng 01/11, trả hai trang: id 1, 2, 3 rồi 4, 5. dlt nạp năm dòng. State sau lượt: last_value bằng 08:20 ngày 02/11, unique_hashes có một mã, ứng với sản phẩm 5.
Lượt 2
Cursor trước khi gọi là 08:20. API nhận since bằng 08:20, trả id 5, 6, 2 ở trang 1 và id 8 ở trang 2. dlt nạp ba dòng. Sản phẩm 5 bị loại nhờ unique_hashes. State sau lượt: last_value bằng 08:05 ngày 03/11.
Bảng sau lượt 2
id |
Giá |
updated_at (UTC) |
Có trong kho |
|---|---|---|---|
1 |
101.000 |
02/11 08:00 |
có |
2 |
222.000 |
03/11 08:00 |
có, đã cập nhật |
3 |
103.000 |
02/11 08:10 |
có |
4 |
104.000 |
02/11 08:15 |
có |
5 |
105.000 |
02/11 08:20 |
có, không nạp lại |
6 |
106.000 |
02/11 08:20 |
có |
7 |
107.000 |
02/11 08:12 |
không |
8 |
108.000 |
03/11 08:05 |
có |
Sản phẩm 2 được cập nhật
Sản phẩm 2 đổi giá và updated_at mới hơn cursor, nên API trả nó ở lượt 2. Merge thay dòng cũ giá 102.000 bằng dòng mới giá 222.000. Kho không giữ giá cũ. Nếu cần lịch sử giá, phải dùng write_disposition append rồi khử trùng ở tầng biến đổi, hoặc dùng chiến lược giữ lịch sử của dlt.
Sản phẩm 6 vào được nhờ điều kiện bằng
Sản phẩm 6 có cùng mốc với sản phẩm 5. API trả nó vì dùng lớn hơn hoặc bằng. dlt nạp nó vì mã băm khác sản phẩm 5. Đây là sự phối hợp đúng giữa API và dlt.
Sản phẩm 7 lọt mất
Bản đến muộn lọt
Sản phẩm 7 có updated_at 08:12, nhỏ hơn cursor 08:20. API không trả nó vì since bằng 08:20. Không có lỗi, không có cảnh báo. Kho có bảy sản phẩm trong khi API có tám.
Lượt 3 khi không có gì mới
Chạy lượt 3 trong tiến trình mới, dữ liệu API không đổi. Cursor đọc lại là 08:05 ngày 03/11, chứng tỏ state được giữ giữa các tiến trình. API trả sản phẩm 8, bản ghi ở đúng mốc. dlt loại nó nhờ unique_hashes, không có dòng nào được nạp.
Không có cảnh báo khi thiếu dữ liệu
dlt không biết API có bao nhiêu bản ghi, nên không thể cảnh báo khi kho thiếu sản phẩm 7. Cách duy nhất để phát hiện là đối soát: hỏi API tổng số bản ghi, hoặc gọi lại toàn bộ định kỳ rồi so với kho. Lab phát hiện được vì biết trước dữ liệu, môi trường thật thì không.
Số request mỗi lượt
api.log cho thấy lượt 1 gọi hai trang, lượt 2 gọi hai trang, lượt 3 gọi một trang. Không lượt nào gọi lại toàn bộ dữ liệu. Đây là lợi ích của incremental: số request tỷ lệ với lượng dữ liệu mới, không với tổng dữ liệu.
Đối soát cursor state và dữ liệu sau restart với dlt incremental API ingestion
Phần này thử tham số lag và khôi phục state.
Tham số lag
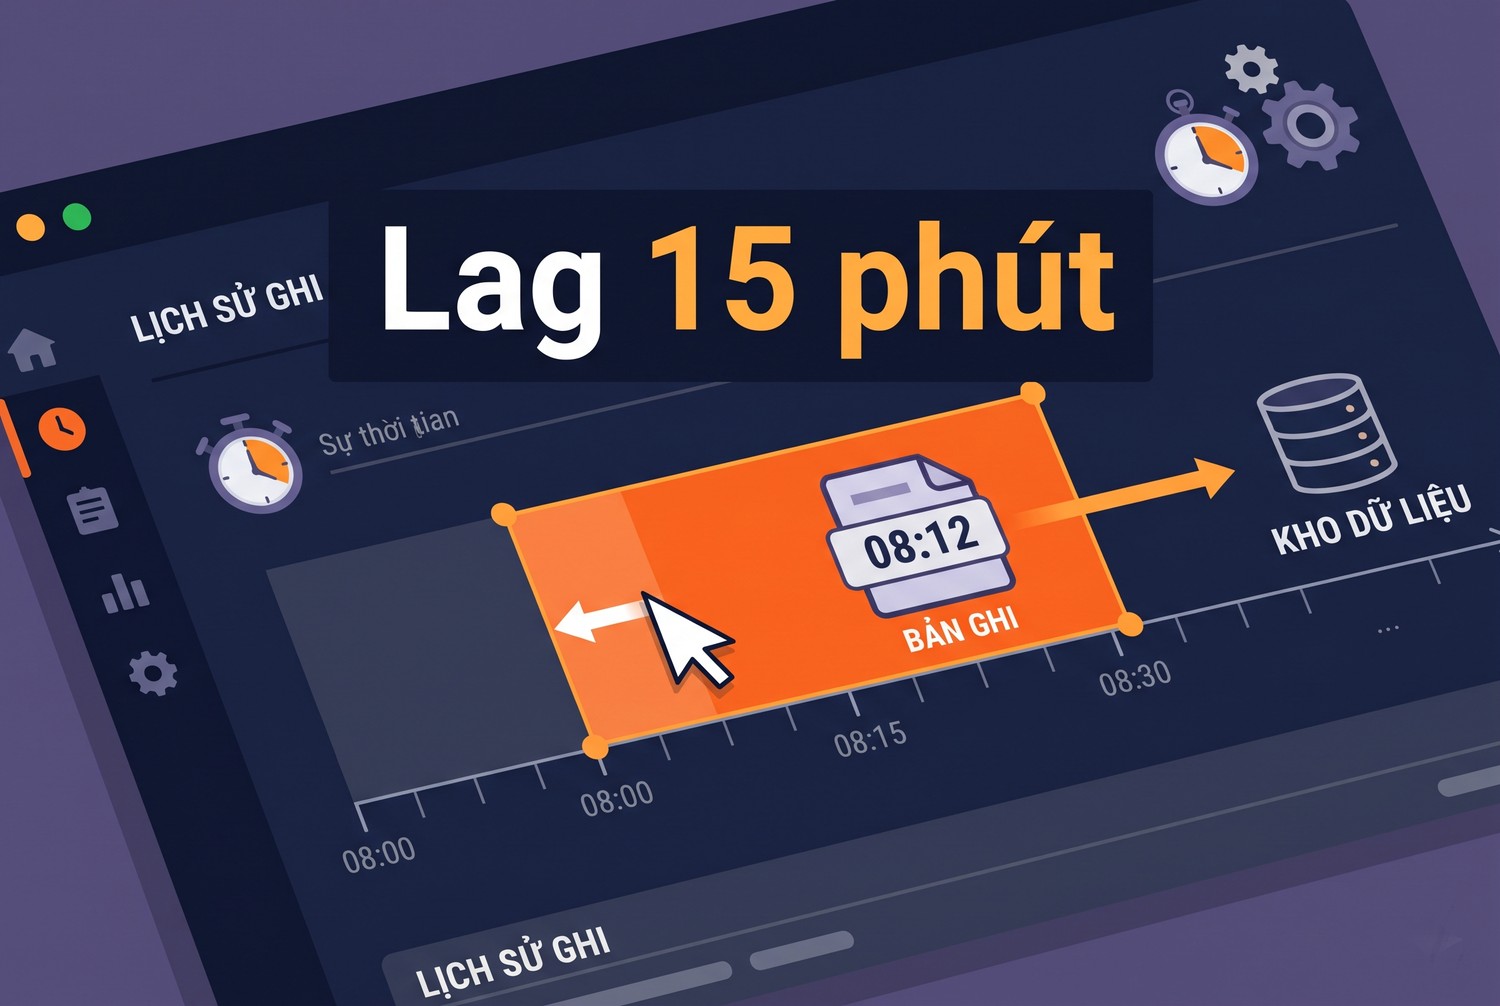
incremental có tham số lag, tính bằng giây với cursor kiểu thời gian. Khi đặt lag, start_value ở lượt sau bằng last_value trừ đi lag. Cửa sổ lấy dữ liệu lùi lại một đoạn, đủ để bắt những bản ghi đến muộn trong khoảng đó.
Chạy lại với lag 15 phút
Lag 15 phút
Lab dựng pipeline thứ hai tên gia_api_lag với lag bằng 900 giây, chạy lại đúng hai lượt dữ liệu như trên. Lượt 1 giống hệt: năm dòng, last_value 08:20.
Lượt 2, cursor trước khi gọi là 08:05, tức 08:20 trừ 15 phút. API trả ba trang: id 3, 7, 4, rồi 5, 6, 2, rồi 8. dlt chuẩn hóa bảy dòng và gộp theo khóa. Kho có đủ tám sản phẩm, kể cả sản phẩm 7.
Cái giá của lag
Với lag, unique_hashes bằng 0 ở mọi lượt: dlt không khử trùng theo mã băm nữa. Bản ghi trong cửa sổ lùi được gửi lại và gộp bằng merge. Lượt 2 xử lý bảy dòng thay vì ba. Lượt 3, khi không có gì mới, cursor lùi về 07:50 ngày 03/11, API trả sản phẩm 2 và 8, dlt xử lý hai dòng, merge giữ nguyên kết quả.
Không có bản trùng trong kho, nhờ merge theo primary_key. Nhưng mỗi lượt đều gọi lại một phần dữ liệu cũ. Lag càng lớn, phần gọi lại càng nhiều.
Đo độ trễ của nguồn
Muốn chọn lag, cần biết bản ghi thường hiện ra muộn bao lâu so với updated_at. Một cách đo là ghi thêm thời điểm nạp vào mỗi dòng, rồi so với updated_at. Phân bố chênh lệch cho biết lag nên đặt ở mức nào để bắt được phần lớn bản trễ mà không gọi lại quá nhiều.
Lag chỉ bắt được trễ trong cửa sổ
Sản phẩm 7 trễ 8 phút so với mốc lớn nhất, nằm trong cửa sổ 15 phút. Bản ghi trễ hơn 15 phút vẫn lọt. Lag không loại bỏ vấn đề, chỉ đẩy ranh giới ra xa. Chọn lag dựa trên độ trễ thực tế đo được của nguồn, không đoán.
Lag và unique_hashes không đi cùng nhau
Với lag, dlt chủ động gửi lại các bản ghi trong cửa sổ lùi, nên việc loại bản trùng bằng mã băm không còn ý nghĩa. dlt dựa vào merge để gộp. Điều này có nghĩa là lag chỉ an toàn khi write_disposition là merge. Với append, lag sẽ tạo bản trùng trong kho.
Bảng so hai cấu hình
Cấu hình |
Lượt 2 dòng xử lý |
Sản phẩm 7 |
Lượt 3 dòng xử lý |
Khử trùng |
|---|---|---|---|---|
Không lag |
3 |
lọt |
0 |
unique_hashes |
Lag 900 giây |
7 |
có |
2 |
merge theo id |
Xóa thư mục cục bộ rồi chạy lại
Lab xóa thư mục pipes/gia_api, nơi chứa state cục bộ, rồi chạy lượt 4 với dữ liệu không đổi. Cursor trước khi gọi vẫn là 08:05 ngày 03/11. API chỉ được gọi với since bằng mốc này. Không có lượt nạp lại toàn bộ.
State có phiên bản
Mỗi lần state thay đổi, dlt ghi một dòng mới vào bảng state kèm số phiên bản. Lượt 3 không nạp gì nên không có phiên bản mới. Bảng chỉ có hai dòng, ứng với lượt 1 và lượt 2. Đọc bảng này cho biết cursor đã đi qua những mốc nào theo thời gian.
State được lấy từ kho đích
Bảng _dlt_pipeline_state trong schema raw của DuckDB có hai phiên bản state, từ lượt 1 và lượt 2. Khi thư mục cục bộ mất, dlt đọc state mới nhất từ bảng này. Đây là lý do mất máy chạy pipeline không làm mất cursor, miễn là kho đích còn.
Nạp lại toàn bộ khi cần
Khi phát hiện kho thiếu dữ liệu, cách sửa là nạp lại toàn bộ hoặc một khoảng thời gian. dlt cho đặt lại state của resource hoặc dùng initial_value và end_value để nạp một khoảng cố định. Lab chưa thử hai cách này. Với merge theo primary_key, nạp lại không tạo bản trùng, chỉ tốn request.
Khi kho đích bị dựng lại
Ngược lại, nếu ai đó xóa bảng đích hay dựng lại kho mà giữ thư mục cục bộ, state cục bộ vẫn nói cursor ở 03/11. Lượt sau sẽ chỉ nạp dữ liệu mới, và kho mới thiếu toàn bộ lịch sử. Lab chưa thử ca này, nhưng đây là điều cần nhớ khi dọn dẹp kho.
Đầu ra nghiệm thu: hai lượt nạp có bản ghi đến muộn và state cursor đối soát của dlt incremental API ingestion
Phần cuối gom kết quả thành bộ bàn giao.
Bộ bàn giao
Bộ bàn giao gồm api.py, run.py, hai tệp dữ liệu cho hai lượt, hai tệp kho DuckDB, api.log và tệp state.json. Người nhận chạy lại theo thứ tự, phải thấy pipeline không lag thiếu sản phẩm 7, pipeline lag 900 giây đủ tám sản phẩm, và xóa thư mục cục bộ không làm cursor quay về initial_value.
Tiêu chí đạt
Bản ghi trùng mốc được nạp đúng một lần. Bản ghi đến muộn trong ngưỡng được nạp. Chạy lại khi không có gì mới không tạo dòng thừa. State khôi phục được sau khi mất thư mục cục bộ.
Một lượt lỗi thì sao
Nếu API lỗi ở trang thứ hai, requests ném ngoại lệ, p.run thất bại, state không được cập nhật. Lượt sau bắt đầu lại từ cursor cũ và gọi lại trang một. Lab chưa cài lỗi giữa chừng, nhưng đây là hành vi dlt mô tả trong tài liệu và là lý do không nên tự lưu cursor trước khi nạp xong.
Quy tắc khi nạp API tăng dần
Dùng trường thời gian cập nhật làm cursor. Yêu cầu API lọc lớn hơn hoặc bằng. Truyền start_value vào request, không để dlt lọc phía client. Dùng merge với primary_key. Đo độ trễ của nguồn rồi đặt lag tương ứng. Định kỳ chạy đối soát số bản ghi giữa API và kho.
Khi nào cần proxy với dlt incremental API ingestion
dlt gọi API bằng requests trong resource của bạn. Proxy, nếu cần, cấu hình ở requests hoặc qua biến môi trường. Phần ghi vào kho không cần proxy nếu kho nằm trong mạng nội bộ.
Một số API đối tác chỉ cho phép gọi từ danh sách IP đăng ký trước. Khi đó máy chạy pipeline cần một IP cố định. Nếu cần IP tĩnh tại Việt Nam cho mục đích đó, anh em có thể mua proxy tĩnh Việt Nam tại trang chủ ProxyVN. Proxy không tăng quota của API, không thay khóa API, và không làm cursor đúng hơn. Vai trò hợp lệ của proxy được giải thích ở bài Web Scraping proxy là gì.
Cấu hình proxy không vào state
State của dlt được ghi vào kho đích và thư mục cục bộ. Đừng đưa chuỗi proxy có mật khẩu vào bất kỳ giá trị nào resource lưu trong state. Đặt proxy qua biến môi trường hoặc tệp bí mật của dlt. Cách viết chuỗi proxy đúng định dạng có trong bài định dạng proxy.
Quota của API
Nhiều API giới hạn số request mỗi giờ. Lag lớn làm mỗi lượt gọi lại nhiều trang hơn, ăn vào quota. Cân bằng giữa bắt bản đến muộn và tiết kiệm quota là quyết định riêng cho từng nguồn. Có thể dùng lag nhỏ cho lượt hằng giờ và một lượt nạp lại cửa sổ rộng mỗi đêm.
Những gì lab chưa thử
Lab chưa thử cursor kiểu số nguyên, chưa thử end_value để nạp lại một khoảng cố định, chưa thử REST API source có sẵn của dlt với cấu hình phân trang khai báo. Lab cũng chưa thử API lọc lớn hơn hẳn để xem sản phẩm 6 bị bỏ, chỉ suy luận từ cách lọc. Hành vi lag có thể khác ở bản dlt khác.
Checklist dlt incremental API ingestion
Checklist
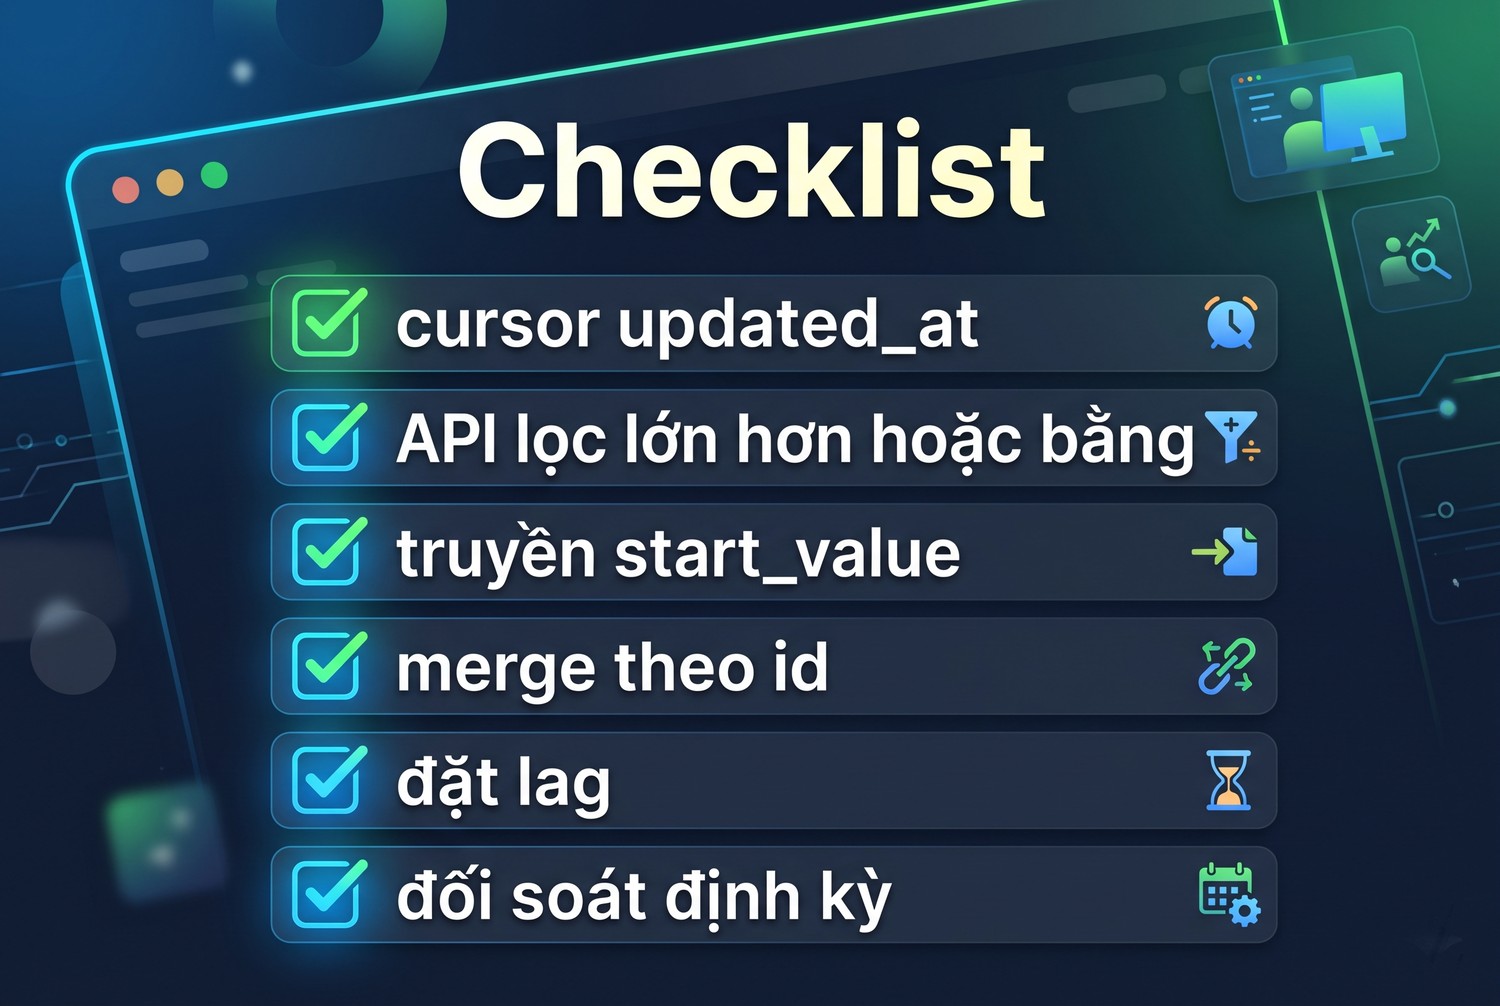
- Cursor là updated_at, không phải created_at.
- API lọc lớn hơn hoặc bằng since.
- Resource truyền start_value vào request.
- write_disposition merge với primary_key.
- Đo độ trễ nguồn, đặt lag phù hợp.
- Biết lag tắt unique_hashes và gọi lại một phần dữ liệu.
- Kho đích giữ bảng _dlt_pipeline_state để khôi phục.
- Đối soát số bản ghi giữa API và kho định kỳ.
Câu hỏi thường gặp về dlt incremental API ingestion
dlt lưu cursor ở đâu?
Trong state của pipeline, ghi ở thư mục cục bộ và ở bảng _dlt_pipeline_state trong kho đích.
Vì sao bản ghi đến muộn bị mất?
Vì updated_at của nó nhỏ hơn cursor. Lab cho thấy sản phẩm 7 với mốc 08:12 lọt khi cursor đã ở 08:20.
unique_hashes dùng để làm gì?
Để bỏ những bản ghi ở đúng mốc cursor đã nạp ở lượt trước, khi API trả lại chúng do lọc lớn hơn hoặc bằng.
lag có bắt được mọi bản đến muộn không?
Không. Chỉ bắt được bản trễ trong cửa sổ lag. Lab đặt 15 phút, bắt được bản trễ 8 phút.
Xóa thư mục pipeline có mất cursor không?
Không, nếu kho đích còn. Lab xóa thư mục cục bộ, dlt đọc lại state từ kho và giữ cursor 08:05 ngày 03/11.
Nạp API có cần proxy không?
Chỉ khi API đòi IP cố định hoặc mạng công ty bắt đi qua proxy.
dlt incremental API ingestion và những điều cần nhớ
dlt incremental API ingestion tiết kiệm request nhờ cursor, nhưng chỉ nạp đủ khi API và cursor phối hợp đúng. Lab trên dlt 1.32.0 cho thấy unique_hashes xử lý tốt bản trùng mốc, bản đến muộn thì lọt nếu không có lag, và lag 15 phút bắt được nó với cái giá gọi lại một phần dữ liệu. State được khôi phục từ kho đích khi mất thư mục cục bộ. Cần IP tĩnh để gọi API đối tác trước khi chạy dlt incremental API ingestion, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


