
dbt incremental cho dữ liệu web: upsert crawl và so full refresh
dbt incremental cho dữ liệu web là cách chỉ xử lý phần bản ghi crawl mới mỗi lần chạy, rồi gộp vào bảng đích theo khóa sản phẩm, thay vì dựng lại cả bảng từ đầu. Cách này nhanh và rẻ, nhưng dễ bỏ sót bản cập nhật đến muộn hay để lọt bản trùng. ProxyVN chạy dbt-core 1.12.6 với dbt-duckdb 1.11.1 ngày 03/11/2026, nạp ba lần dữ liệu crawl có cài sẵn bản trùng và bản đến muộn, rồi so ba cách viết model với kết quả full refresh. Bài ghi lại chỗ nào khớp, chỗ nào lệch và vì sao.
dbt incremental cho dữ liệu web: mục tiêu và phạm vi không lặp
Phần này chốt bài toán và đầu ra.
Bài toán
Một crawler giá ghi mỗi lần tải trang thành một dòng trong bảng raw_prices. Cùng một sản phẩm có thể xuất hiện nhiều lần: mỗi ngày một lần, có khi hai lần trong một lượt nếu crawler đi qua hai trang danh mục. Báo cáo cần bảng gọn, mỗi sản phẩm một dòng với giá mới nhất.
Dựng lại bảng gọn từ toàn bộ raw mỗi ngày thì đúng nhưng tốn dần theo thời gian. Model incremental chỉ xử lý dòng mới. Câu hỏi là làm sao để kết quả incremental giống kết quả dựng lại từ đầu.
Đầu ra nghiệm thu
Đầu ra gồm bảng raw có nhiều phiên bản cho cùng sản phẩm, và kết quả so từng model incremental với model full refresh. Model đạt khi không có dòng nào khác nhau. Model trượt phải chỉ ra được sản phẩm nào lệch và vì sao.
Ranh giới với dlt và crawler
Bài không bàn cách tải trang, không bàn cursor khi gọi API như dlt làm ở tầng nạp. Ở đây dữ liệu đã nằm trong kho. dbt làm việc ở tầng biến đổi: đọc bảng raw, ghi bảng đích. Cursor của dlt quyết định lấy gì từ nguồn, điều kiện lọc của dbt quyết định xử lý gì từ bảng raw.
Phiên bản đã khóa
Lab dùng dbt-core 1.12.6, dbt-duckdb 1.11.1, dbt-adapters 1.24.5, Python 3.12 trên Windows. Kho là một tệp DuckDB. Chiến lược incremental là delete+insert, có sẵn trên adapter DuckDB. Adapter khác có thể có chiến lược khác như merge, kết quả với bản trùng có thể khác.
Ai nên đọc
Người đã có pipeline crawl nạp vào kho và đang dùng dbt để làm sạch. Người thấy bảng đích có sản phẩm trùng hoặc giá cũ mà không rõ nguyên nhân. Người định chuyển model từ table sang incremental vì thời gian chạy tăng dần.
Vì sao không dùng snapshot
dbt có tính năng snapshot để giữ lịch sử thay đổi của từng khóa. Bài toán ở đây khác: bảng raw đã giữ toàn bộ lịch sử vì crawler chỉ thêm dòng. Cái cần là bảng gọn với giá mới nhất. Snapshot phù hợp hơn khi nguồn là bảng bị ghi đè và bạn muốn tự giữ lịch sử.
Lỗi đường dẫn kho khi chạy lần đầu
Lần chạy đầu, cả ba model báo Catalog Error, không thấy bảng raw_prices. Nguyên nhân là đường dẫn path trong profiles.yml được tính theo thư mục đang đứng khi gọi dbt, không theo thư mục dự án. dbt mở một tệp kho khác, rỗng. Sửa đường dẫn là chạy được. Lỗi này không liên quan incremental, nhưng tốn thời gian nếu không biết.
Mô hình incremental upsert bản ghi crawl theo business key và thời gian cập nhật với dbt incremental cho dữ liệu web
Trước khi viết model, cần nắm cách dbt chạy một model incremental.
Hai chế độ của một model
Theo trang Incremental models trong tài liệu dbt, model incremental chạy lần đầu như một bảng bình thường: chọn toàn bộ, ghi bảng đích. Từ lần sau, macro is_incremental trả về đúng, và phần điều kiện bên trong khối if được thêm vào truy vấn để chỉ lấy dòng mới.
Cùng một tệp SQL có hai hành vi. Lần đầu và lần chạy với cờ full-refresh dùng phần không có điều kiện. Các lần còn lại dùng phần có điều kiện.
unique_key và delete+insert
unique_key là cột dùng để nhận ra cùng một bản ghi giữa bảng đích và phần dữ liệu mới. Với chiến lược delete+insert, dbt xóa khỏi bảng đích mọi dòng có khóa nằm trong phần dữ liệu mới, rồi chèn phần dữ liệu mới vào. Kết quả là upsert theo khóa.
Chiến lược này không tự khử trùng bên trong phần dữ liệu mới. Nếu phần mới có hai dòng cùng khóa, cả hai đều được chèn. Lab sẽ cho thấy điều đó.
Business key của dữ liệu crawl
Khóa của dữ liệu crawl thường là mã sản phẩm của website nguồn, không phải URL. URL có thể đổi khi website đổi cấu trúc, có thể mang tham số theo dõi. Lab dùng product_id. Nếu website không có mã sản phẩm ổn định, cần chuẩn hóa URL trước khi dùng làm khóa.
Hai mốc thời gian
Mỗi dòng raw có updated_at là thời điểm giá được ghi nhận khi tải trang, và ingested_at là thời điểm dòng được nạp vào kho. Thông thường hai mốc gần nhau. Khi crawler chạy lại một lô cũ hoặc một máy crawl bị trễ, updated_at có thể cũ hơn nhiều so với ingested_at.
Chọn mốc nào làm điều kiện lọc là quyết định quan trọng nhất của bài.
Thứ tự sắp xếp khi khử trùng
Khi hai dòng cùng sản phẩm có cùng updated_at, row_number cần tiêu chí phụ để chọn. Lab dùng ingested_at giảm dần, nghĩa là dòng nạp sau thắng. Không có tiêu chí phụ, kho có thể chọn ngẫu nhiên giữa hai dòng, và mỗi lần chạy ra kết quả khác nhau. Lỗi kiểu này rất khó tìm vì không lặp lại được.
Ba model đem so
Model thứ nhất lọc theo updated_at, kiểu thường thấy trong ví dụ. Model thứ hai lọc theo ingested_at, khử trùng trong phần mới và chặn bản cũ ghi đè bản mới. Model thứ ba giống model thứ hai nhưng bỏ bước chặn. Model đối chứng là bảng thường, dựng lại từ toàn bộ raw mỗi lần.
Chọn business key và cột cập nhật của bảng raw trong dbt incremental cho dữ liệu web
Phần này mô tả bảng raw và ba lần nạp.
Cấu trúc bảng raw
Bảng raw_prices có năm cột: product_id, url, price, updated_at, ingested_at. Mỗi lần crawl ghi thêm dòng, không sửa dòng cũ. Đây là kiểu bảng chỉ thêm, phổ biến với dữ liệu crawl vì giữ được lịch sử giá.
Lần nạp 1
Năm sản phẩm từ 1 tới 5, giá 100.001 tới 100.005 đồng, updated_at sáng 01/11, ingested_at 9 giờ 01/11. Sau lần chạy dbt đầu tiên, cả ba model và bảng đối chứng đều có năm dòng giống nhau.
Lần nạp 2
Bốn dòng mới, ingested_at 9 giờ 02/11. Sản phẩm 2 đổi giá thành 222.000. Sản phẩm 6 mới xuất hiện. Sản phẩm 3 có hai dòng trong cùng lô, giá 333.000 lúc 8 giờ 02 và 333.500 lúc 8 giờ 03, mô phỏng crawler gặp sản phẩm này ở hai trang danh mục.
Lần nạp 3
Hai dòng đến muộn, ingested_at 9 giờ 03/11. Sản phẩm 4 có giá 444.000 với updated_at 20 giờ 01/11, mô phỏng máy crawl bị kẹt hàng đợi rồi đẩy kết quả lên sau hai ngày. Sản phẩm 2 có giá 199.000 với updated_at 23 giờ 01/11, cũ hơn bản 222.000 đã có.
Kết quả đúng phải là gì
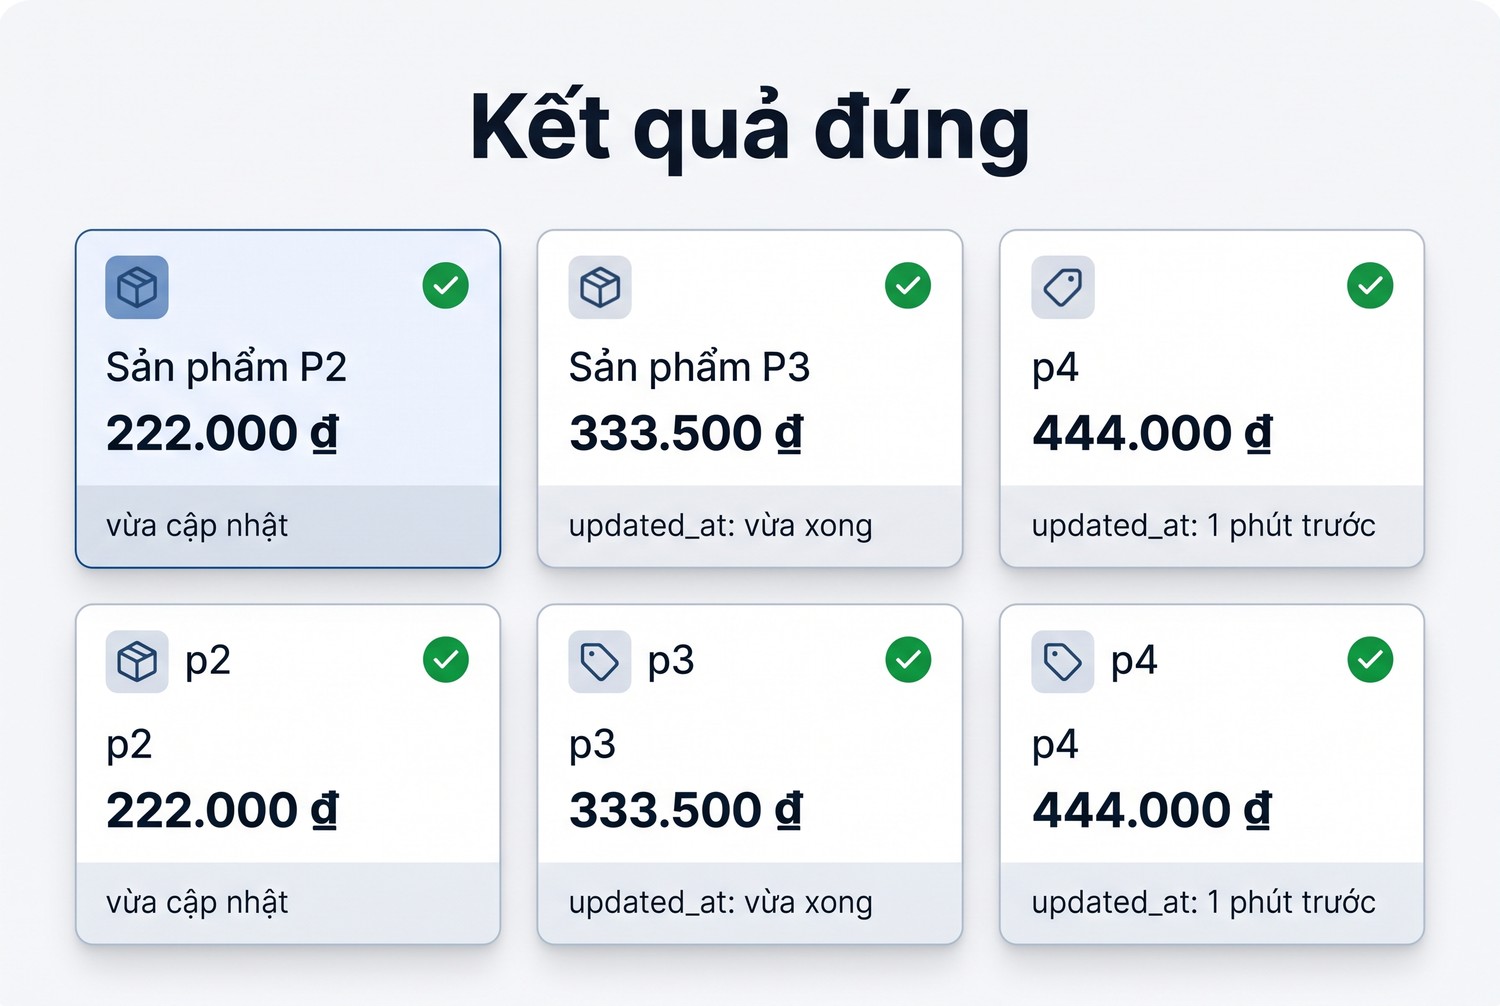
Kết quả đúng
Sau ba lần nạp, bảng đúng có sáu sản phẩm. Sản phẩm 2 giá 222.000 vì đó là bản có updated_at mới nhất. Sản phẩm 3 giá 333.500 vì bản 8 giờ 03 mới hơn bản 8 giờ 02. Sản phẩm 4 giá 444.000 vì bản đến muộn vẫn mới hơn bản sáng 01/11. Bảng đối chứng dựng từ toàn bộ raw cho đúng kết quả này.
Bảng đối chứng
{{ config(materialized='table') }}
select product_id, url, price, updated_at, ingested_at from (
  select *, row_number() over (
    partition by product_id order by updated_at desc, ingested_at desc) rn
  from {{ source('raw', 'raw_prices') }}) where rn = 1
Mỗi sản phẩm giữ một dòng có updated_at lớn nhất. Khi hai dòng cùng updated_at, giữ dòng nạp sau. Model này luôn đúng nhưng đọc toàn bộ raw mỗi lần chạy.
Dữ liệu thật hay gặp gì
Trong dữ liệu crawl thật, bản trùng trong cùng lô xuất hiện khi crawler theo nhiều đường tới cùng sản phẩm: trang danh mục, trang tìm kiếm, trang khuyến mãi. Bản đến muộn xuất hiện khi chạy nhiều máy crawl song song, một máy bị chậm, hoặc khi chạy lại một lô bị lỗi hôm trước. Lab dựng đúng hai tình huống này.
Đếm chi phí đọc
Trong lab, raw chỉ có 11 dòng nên không thấy khác biệt thời gian. Với bảng raw tăng vài triệu dòng mỗi tháng, bảng đối chứng đọc lại toàn bộ lịch sử mỗi ngày. Model incremental chỉ đọc phần mới. Đó là lý do chính để dùng incremental, và cũng là lý do phải kiểm nó cẩn thận.
Viết incremental filter cùng unique_key theo adapter trong dbt incremental cho dữ liệu web
Phần này trình bày mã của hai model chính.
Model lọc theo updated_at
{{ config(materialized='incremental', unique_key='product_id',
          incremental_strategy='delete+insert') }}
select product_id, url, price, updated_at, ingested_at
from {{ source('raw', 'raw_prices') }}
{% if is_incremental() %}
where updated_at > (select max(updated_at) from {{ this }})
{% endif %}
Đây là mẫu gần với ví dụ cơ bản trong tài liệu. this trỏ tới bảng đích hiện có. Điều kiện chỉ lấy dòng có updated_at lớn hơn giá trị lớn nhất đã có.
Model lọc theo ingested_at
{{ config(materialized='incremental', unique_key='product_id',
          incremental_strategy='delete+insert') }}
with src as (
  select product_id, url, price, updated_at, ingested_at
  from {{ source('raw', 'raw_prices') }}
  {% if is_incremental() %}
  where ingested_at > (select max(ingested_at) from {{ this }})
  {% endif %}
),
dedup as (
  select *, row_number() over (
    partition by product_id order by updated_at desc, ingested_at desc) rn
  from src)
select product_id, url, price, updated_at, ingested_at from dedup where rn = 1
{% if is_incremental() %}
  and not exists (select 1 from {{ this }} t
                  where t.product_id = dedup.product_id
                    and t.updated_at > dedup.updated_at)
{% endif %}
Ba thay đổi so với model đầu
Thay đổi thứ nhất: lọc theo ingested_at, nên mọi dòng mới nạp đều được xem xét, kể cả dòng có updated_at cũ. Thay đổi thứ hai: khử trùng trong phần mới bằng row_number, nên mỗi sản phẩm chỉ còn một dòng trước khi delete+insert. Thay đổi thứ ba: điều kiện not exists bỏ dòng mới nếu bảng đích đã có bản mới hơn của cùng sản phẩm.
Vì sao cần bước chặn
Không có bước chặn, delete+insert xóa bản đang có rồi chèn bản trong phần mới, bất kể bản nào mới hơn. Bản cũ đến muộn sẽ ghi đè bản mới. Model thứ ba trong lab bỏ đúng bước này để kiểm.
Điều kiện lọc phụ thuộc adapter
Cú pháp select max từ this chạy được trên DuckDB và hầu hết kho phổ biến. Nhưng hiệu năng thì khác. Một số kho tính tiền theo lượng dữ liệu quét, và truy vấn max trên bảng đích lớn không có phân vùng có thể tốn không ít. Nên đặt phân vùng hoặc chỉ mục trên cột dùng để lọc.
Cột ingested_at phải do kho hoặc lệnh nạp ghi
Điều kiện lọc theo ingested_at chỉ đúng khi cột này tăng dần theo thứ tự nạp. Nếu crawler tự ghi ingested_at bằng đồng hồ máy của nó, các máy lệch giờ sẽ làm mốc không còn tăng dần. Nên để lệnh nạp vào kho ghi cột này, dùng một đồng hồ duy nhất. Lab ghi giá trị cố định cho từng lần nạp để mô phỏng điều đó.
Hai lần nạp cùng mốc thời gian
Điều kiện lớn hơn mốc lớn nhất sẽ bỏ qua dòng có ingested_at bằng đúng mốc đó. Nếu một lần nạp bị chia thành hai đợt cùng mốc thời gian, và dbt chạy giữa hai đợt, đợt sau sẽ bị bỏ qua. Cách phòng là ghi mốc có độ chính xác cao, hoặc lọc lớn hơn hoặc bằng rồi dựa vào khử trùng để xử lý dòng lặp.
Chiến lược merge
Một số adapter hỗ trợ chiến lược merge, dùng câu MERGE của SQL. Với merge, phần mới có hai dòng cùng khóa thường làm câu lệnh lỗi thay vì chèn trùng. Lab chưa thử merge trên DuckDB, nên không khẳng định hành vi. Dù dùng chiến lược nào, khử trùng trong phần mới vẫn là việc nên làm.
Nạp bản cập nhật đến muộn và bản ghi trùng với dbt incremental cho dữ liệu web
Phần này đọc kết quả sau ba lần nạp.
Kết quả model lọc theo updated_at
Bảng đích có bảy dòng cho sáu sản phẩm. Sản phẩm 3 xuất hiện hai lần, giá 333.000 và 333.500. Sản phẩm 4 vẫn giá 100.004, bản 444.000 đến muộn không được nạp. Sản phẩm 2 đúng giá 222.000.
Bản trùng lọt vào bảng đích
Ở lần nạp 2, phần mới có hai dòng sản phẩm 3. delete+insert xóa dòng cũ của sản phẩm 3 rồi chèn cả hai dòng mới. Kiểm khóa trùng trên bảng đích ra đúng một khóa: sản phẩm 3 có 2 dòng.
Đây là lỗi im lặng. dbt báo chạy thành công. Báo cáo đọc bảng này sẽ đếm sản phẩm 3 hai lần, hoặc hiện giá ngẫu nhiên giữa hai dòng.
Bản đến muộn bị bỏ sót
Ở lần nạp 3, giá trị lớn nhất của updated_at trong bảng đích là 8 giờ 03 ngày 02/11. Bản sản phẩm 4 có updated_at 20 giờ ngày 01/11, nhỏ hơn, nên điều kiện lọc loại nó. Không có lỗi, không có cảnh báo, giá sản phẩm 4 trong bảng đích dừng ở 100.004 mãi mãi, trừ khi chạy full refresh.
Điều kiện lọc là lời hứa về dữ liệu
Điều kiện updated_at lớn hơn mốc lớn nhất ngầm hứa rằng dữ liệu luôn đến theo đúng thứ tự thời gian. Dữ liệu crawl không giữ lời hứa đó. Mỗi điều kiện lọc trong model incremental nên được đọc như một giả định về nguồn, và giả định đó cần được kiểm bằng dữ liệu thật trước khi tin.
Bản cũ đến muộn được bỏ qua đúng
Bản sản phẩm 2 giá 199.000 có updated_at 23 giờ 01/11, cũng nhỏ hơn mốc lớn nhất, nên cũng bị loại. Lần này loại là đúng, vì bản 222.000 mới hơn. Model lọc theo updated_at đúng với bản cũ đến muộn nhưng sai với bản mới đến muộn. Nó không phân biệt được hai trường hợp.
Lỗi im lặng nguy hiểm hơn lỗi chạy
Cả hai lỗi của model đầu đều không làm dbt báo lỗi. Lệnh chạy xanh, số dòng hợp lý, không có gì gây chú ý. Người dùng báo cáo chỉ nhận ra khi so giá với website. Đây là lý do cần một phép kiểm độc lập với chính model, như so với full refresh.
Kết quả model lọc theo ingested_at
Bảng đích có sáu dòng cho sáu sản phẩm. Sản phẩm 3 giá 333.500. Sản phẩm 4 giá 444.000. Sản phẩm 2 giá 222.000. Khớp từng dòng với bảng đối chứng.
Kết quả model không có bước chặn
Model thứ ba có sáu dòng, không trùng khóa, sản phẩm 4 đúng. Nhưng sản phẩm 2 giá 199.000. Bản cũ đến muộn đã ghi đè bản mới, đúng như dự đoán khi bỏ bước chặn.
Bảng tổng hợp
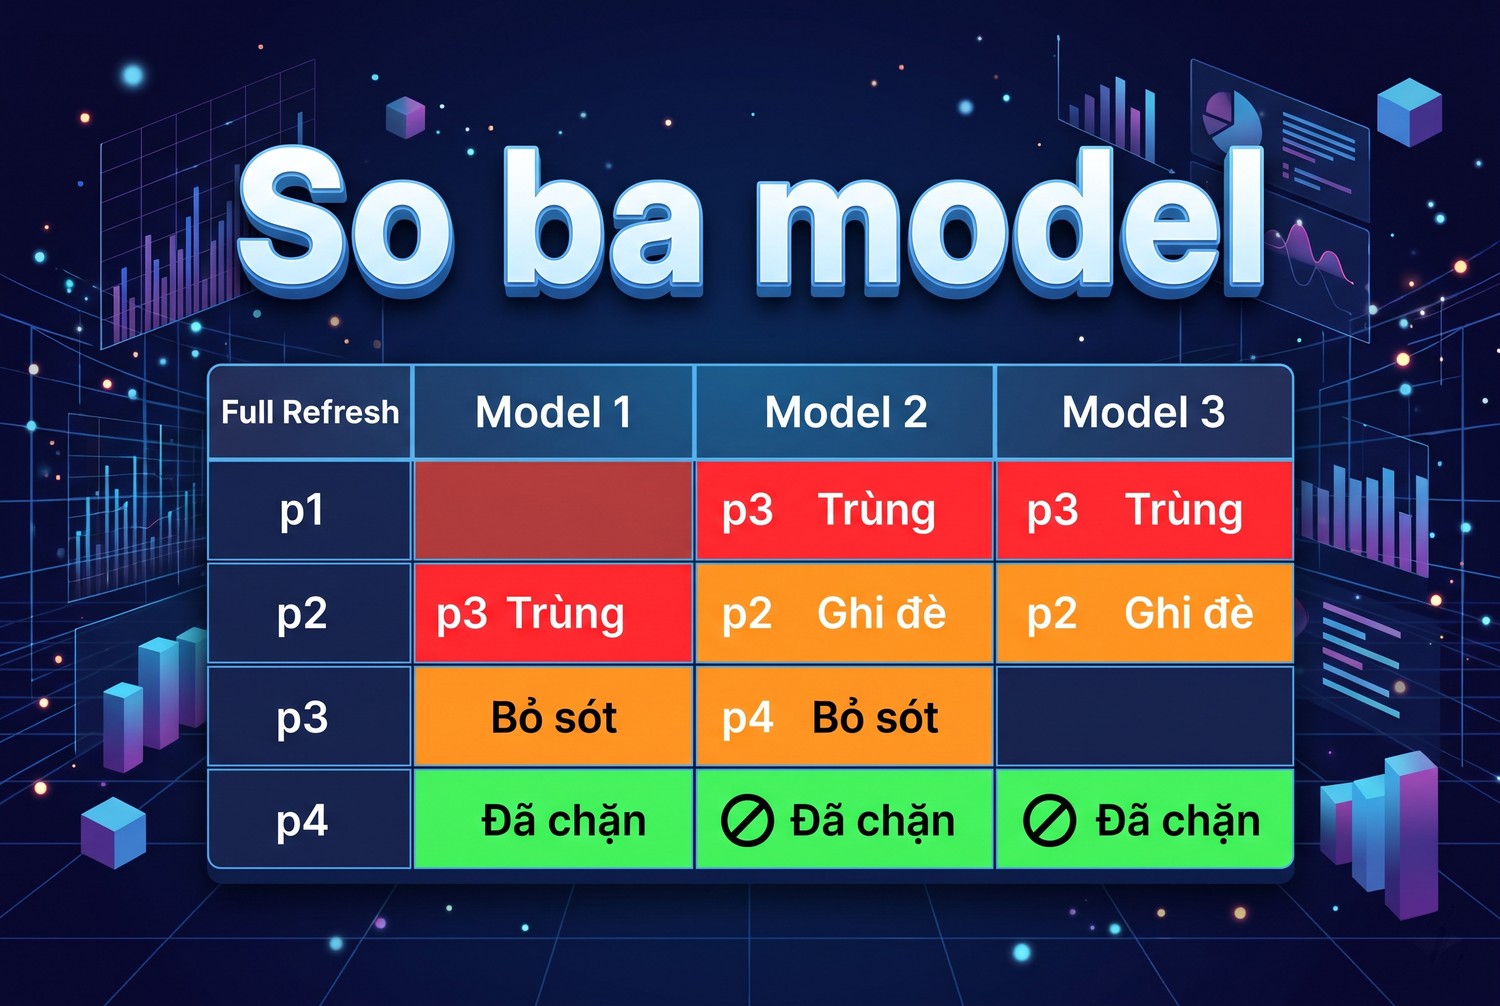
So ba model
Model |
Trùng khóa |
Sản phẩm 3 |
Sản phẩm 4 |
Sản phẩm 2 |
So với full refresh |
|---|---|---|---|---|---|
Lọc updated_at |
có, sản phẩm 3 |
333.000 và 333.500 |
100.004 |
222.000 |
lệch 2 sản phẩm |
Lọc ingested_at, có chặn |
không |
333.500 |
444.000 |
222.000 |
khớp |
Lọc ingested_at, không chặn |
không |
333.500 |
444.000 |
199.000 |
lệch sản phẩm 2 |
Full refresh |
không |
333.500 |
444.000 |
222.000 |
đối chứng |
So incremental result với full refresh để tìm bản ghi bị bỏ sót trong dbt incremental cho dữ liệu web
Phần này biến phép so thành công cụ kiểm thường xuyên.
Đối chứng phải đúng trước
Phép so chỉ có nghĩa khi bảng đối chứng đúng. Lab kiểm bảng đối chứng bằng tay: sáu sản phẩm, giá khớp với phân tích ở phần kết quả đúng. Nếu bảng đối chứng có lỗi, mọi phép so sẽ dẫn sai hướng. Viết bảng đối chứng đơn giản nhất có thể, không tối ưu.
Truy vấn so
select coalesce(a.product_id, b.product_id), a.price, b.price
from gia_theo_updated a full outer join gia_full b using (product_id)
where a.price is distinct from b.price
   or a.product_id is null or b.product_id is null
Với model lọc theo updated_at, truy vấn trả hai dòng: sản phẩm 3 giá 333.000 so với 333.500, sản phẩm 4 giá 100.004 so với 444.000. Với model có chặn, truy vấn không trả dòng nào.
Full outer join để bắt cả thiếu lẫn thừa
Phép nối ngoài đầy đủ bắt được ba loại lệch: sản phẩm có ở model mà không có ở đối chứng, có ở đối chứng mà không có ở model, và có ở cả hai nhưng giá khác. is distinct from xử lý đúng giá trị NULL, khác với phép so bằng thông thường.
Bản trùng làm phép so phức tạp
Khi model có khóa trùng, phép nối sinh nhiều dòng hơn. Sản phẩm 3 trong lab chỉ hiện một dòng lệch vì một trong hai giá trùng với đối chứng. Nên kiểm khóa trùng riêng trước, bằng truy vấn group by có having count lớn hơn 1.
Full refresh model lọc theo updated_at
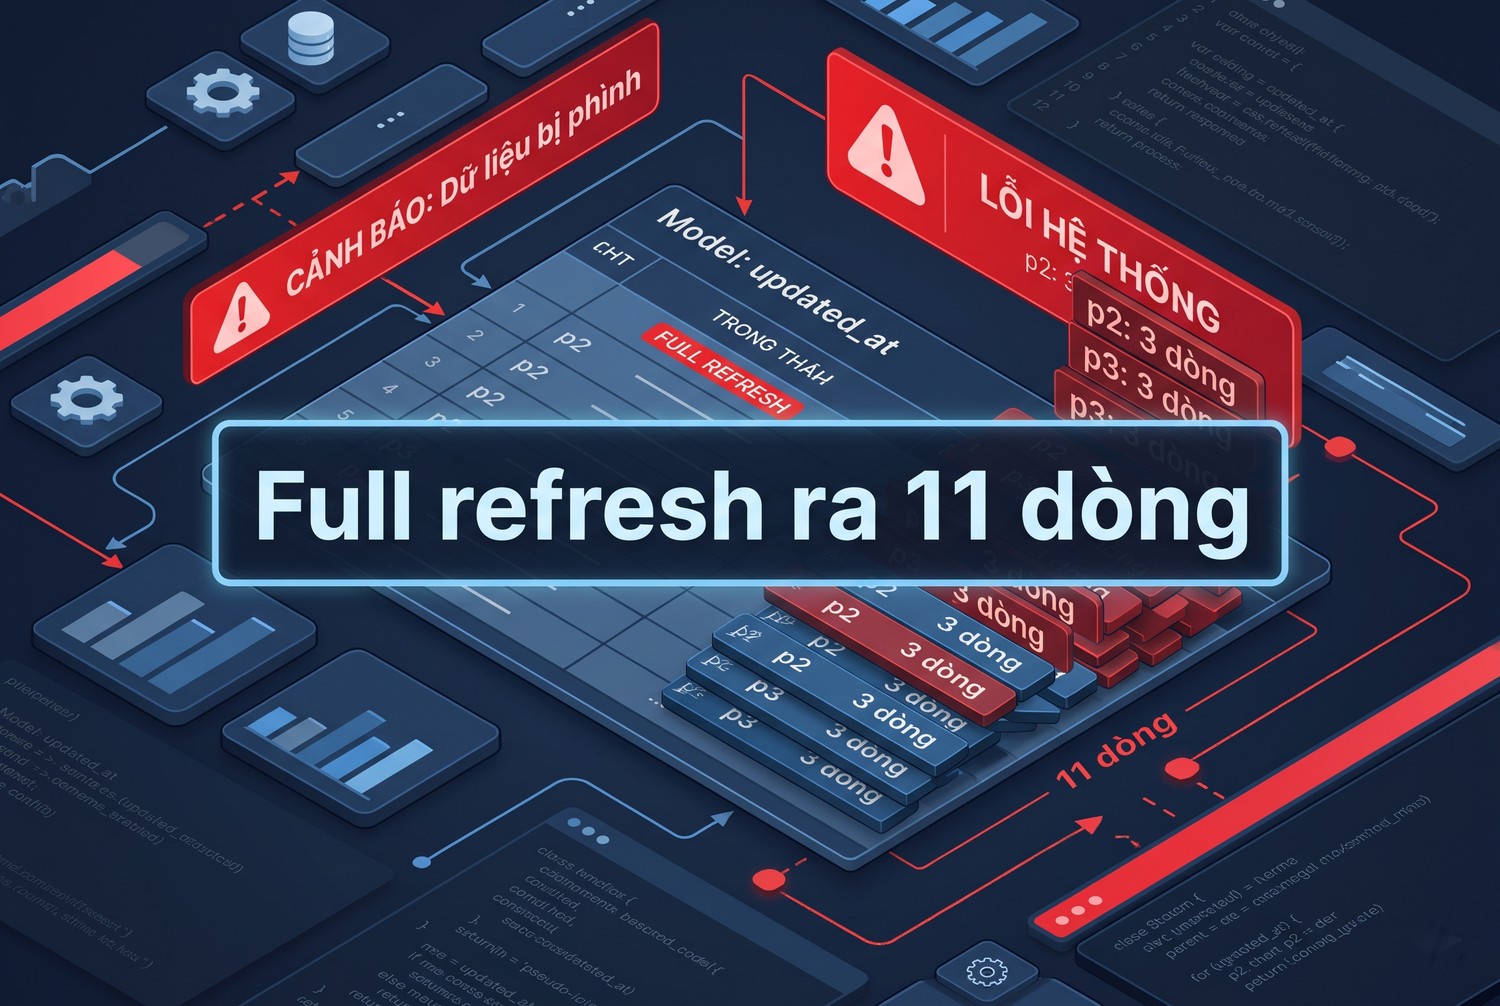
Full refresh ra 11 dòng
Lab chạy model lọc theo updated_at với cờ full-refresh. Bảng đích ra 11 dòng, bằng đúng số dòng raw. Sản phẩm 2 có ba dòng, sản phẩm 3 có ba dòng, sản phẩm 4 có hai dòng.
Lý do: ở chế độ full refresh, khối if bị bỏ qua, model chỉ còn câu select toàn bộ raw. unique_key không được dùng để khử trùng. Model này vốn chỉ đúng nhờ delete+insert ở chế độ incremental, và hỏng hẳn khi dựng lại từ đầu.
Model nên cho cùng kết quả ở hai chế độ
Model lọc theo ingested_at có bước khử trùng nằm ngoài khối if. Ở chế độ full refresh, nó vẫn giữ một dòng mỗi sản phẩm, cho kết quả giống bảng đối chứng. Đây là tính chất cần có: chạy incremental nhiều lần hay full refresh một lần đều ra cùng bảng.
So theo mẫu thay vì toàn bảng
Với bảng đích lớn, có thể so trên một mẫu sản phẩm cố định, ví dụ 1.000 mã chọn ngẫu nhiên một lần rồi giữ nguyên. Model đối chứng chỉ tính cho 1.000 mã đó, rẻ hơn nhiều so với dựng lại cả bảng. Mẫu cố định giúp so sánh giữa các tuần có ý nghĩa.
Lịch kiểm định kỳ
Không cần so với full refresh mỗi ngày, vì như vậy mất lợi ích của incremental. Có thể so mỗi tuần, hoặc so trên một mẫu sản phẩm. Khi phép so có dòng lệch, chạy full refresh để sửa bảng đích và tìm nguyên nhân trong model.
Ghi lại mỗi lần lệch
Mỗi khi phép so phát hiện lệch, nên ghi lại ngày, sản phẩm lệch và nguyên nhân tìm được. Sau vài lần, danh sách này cho thấy nguồn nào hay gửi dữ liệu đến muộn, máy crawl nào hay lặp. Thông tin đó giúp sửa tận gốc ở crawler thay vì chỉ vá ở model.
Biến phép so thành test của dbt
dbt cho viết test bằng SQL, đạt khi truy vấn trả về không dòng nào. Truy vấn so ở trên có thể đặt thành một test riêng, chạy theo lịch hằng tuần. Lab chạy phép so bằng Python ngoài dbt để đọc kết quả trực tiếp, chưa đặt thành test.
Đầu ra nghiệm thu: bảng raw nhiều phiên bản và kết quả incremental so với full refresh của dbt incremental cho dữ liệu web
Phần cuối gom kết quả thành bộ bàn giao.
Bộ bàn giao
Bộ bàn giao gồm dự án dbt với bốn model, tệp lab.py nạp ba lần và so kết quả, tệp kho DuckDB sau lần chạy cuối. Người nhận chạy lại lab.py, phải thấy model có chặn khớp đối chứng, model lọc updated_at lệch sản phẩm 3 và 4, model không chặn lệch sản phẩm 2.
Tiêu chí đạt
Model incremental không có khóa trùng. Phép so với full refresh không trả dòng nào sau mọi lần nạp đã cài lỗi. Chạy model với cờ full-refresh ra cùng kết quả với chạy incremental.
Khi nào chạy full refresh
Chạy full refresh khi phép so có dòng lệch, khi sửa logic model, và khi thêm cột mới vào model. Với model viết đúng như lab, full refresh chỉ tốn thời gian, không đổi kết quả. Với model viết sai, full refresh có thể làm kết quả tệ hơn, như model lọc updated_at ra 11 dòng.
Quy tắc viết model cho dữ liệu crawl
Lọc theo thời điểm nạp, không theo thời điểm ghi nhận giá. Khử trùng trong phần mới trước khi gộp. Chặn bản cũ ghi đè bản mới bằng so sánh updated_at với bảng đích. Đặt bước khử trùng ngoài khối is_incremental để chế độ full refresh vẫn đúng.
Khi nào cần proxy với dbt incremental cho dữ liệu web
dbt chỉ đọc và ghi kho dữ liệu, không tải trang web, nên không cần proxy. Nếu kho nằm trên đám mây và mạng công ty bắt đi qua proxy, đó là cấu hình mạng của tiến trình dbt, giống mọi ứng dụng khác.
Proxy liên quan tới bước crawl đổ dữ liệu vào bảng raw. Bản cập nhật đến muộn trong lab mô phỏng đúng tình huống một máy crawl bị chặn, thử lại nhiều lần rồi mới đẩy kết quả lên. Với website được phép thu thập, khi cần IP ổn định tại Việt Nam để crawler không bị kẹt, anh em có thể mua proxy tĩnh Việt Nam tại trang chủ ProxyVN. Proxy không sửa model dbt và không khử trùng thay bạn. Vai trò hợp lệ của proxy được giải thích ở bài Web Scraping proxy là gì.
Ghi cấu hình crawler vào bảng raw
Nếu dùng nhiều cấu hình mạng khác nhau, nên có cột ghi nhãn cấu hình trong bảng raw, không ghi chuỗi proxy có mật khẩu. Khi bảng đích có giá lạ, nhãn này giúp biết dòng đó đến từ máy crawl nào. Cách viết chuỗi proxy đúng định dạng cho crawler có trong bài định dạng proxy.
Xóa dữ liệu raw cũ
Bảng raw chỉ thêm sẽ phình ra theo thời gian. Nếu xóa dòng raw cũ để tiết kiệm, model đối chứng không còn dựng lại đúng được nữa, vì thiếu lịch sử. Trước khi xóa, cần chắc rằng bảng đích incremental đã đúng, và chấp nhận rằng từ đó full refresh sẽ chỉ phản ánh phần raw còn giữ.
Những gì lab chưa thử
Lab chưa thử chiến lược merge và microbatch, chưa thử kho khác DuckDB, chưa thử bảng raw lớn để đo thời gian. Lab cũng chưa thử snapshot của dbt, một cách khác để giữ lịch sử thay đổi theo khóa. Kết luận về bản trùng chỉ áp dụng cho delete+insert trên dbt-duckdb 1.11.1.
Checklist dbt incremental cho dữ liệu web
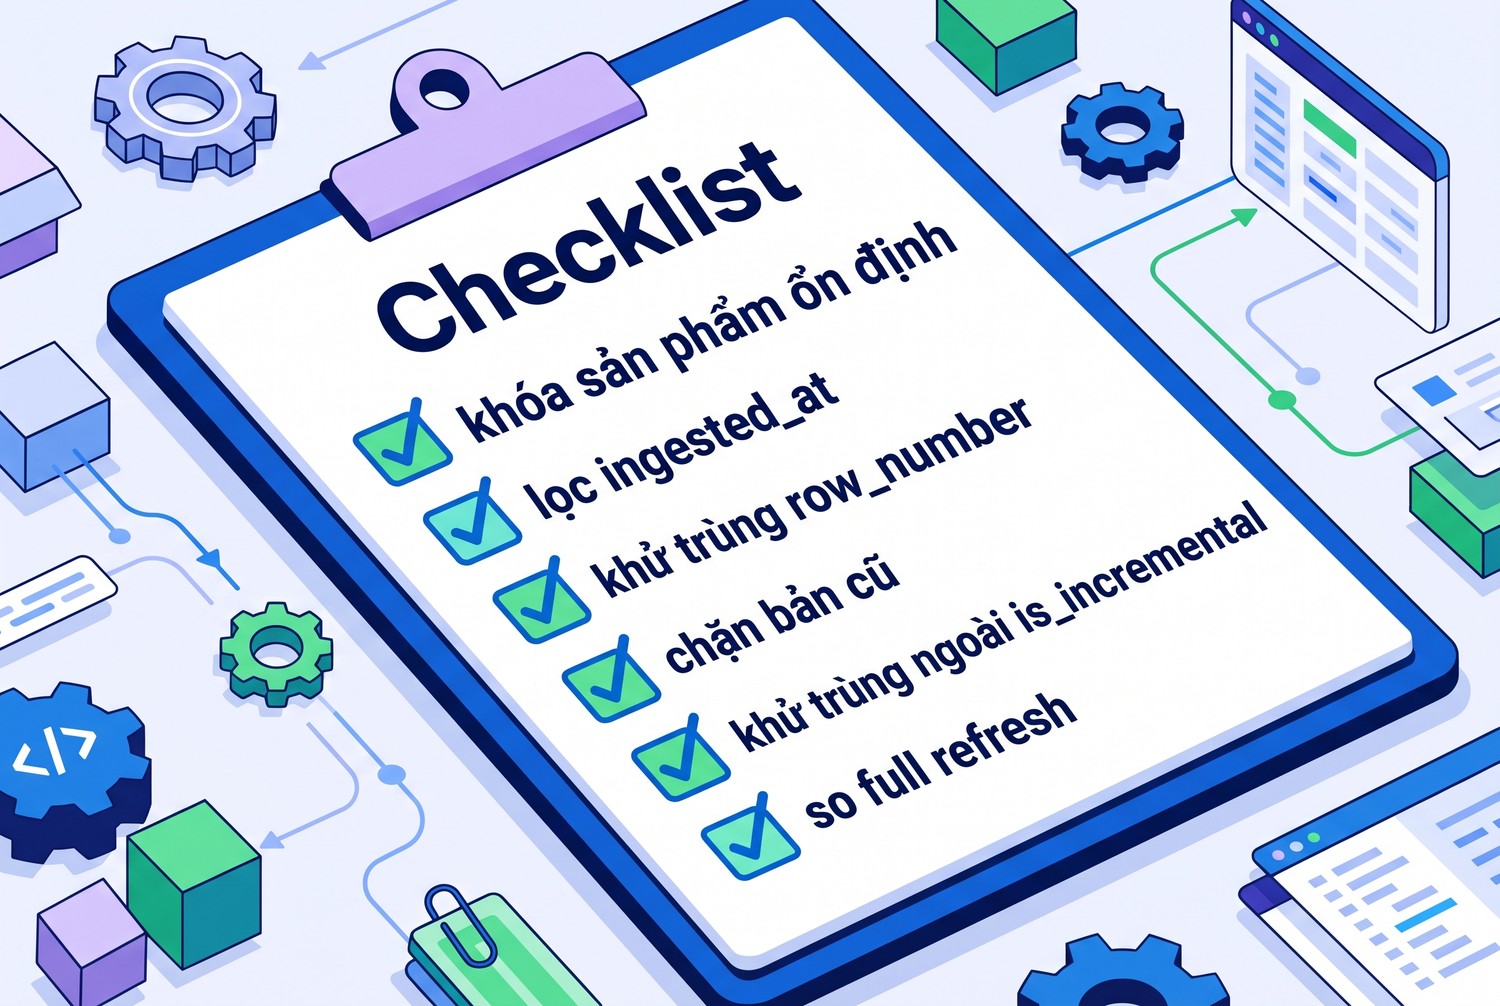
Checklist
- Khóa là mã sản phẩm ổn định, không phải URL thô.
- Lọc theo ingested_at, không theo updated_at.
- Khử trùng trong phần mới bằng row_number.
- Chặn bản cũ ghi đè bản mới bằng not exists.
- Bước khử trùng nằm ngoài khối is_incremental.
- Kiểm khóa trùng trên bảng đích.
- So với full refresh theo lịch, dùng full outer join.
- Đường dẫn kho trong profiles.yml tính theo thư mục chạy lệnh.
Câu hỏi thường gặp về dbt incremental cho dữ liệu web
unique_key có tự khử trùng không?
Không với delete+insert. Lab cho thấy hai dòng cùng khóa trong một lô đều được chèn vào bảng đích.
Vì sao lọc theo updated_at bỏ sót dữ liệu?
Bản cập nhật đến muộn có updated_at nhỏ hơn mốc lớn nhất trong bảng đích nên bị điều kiện lọc loại.
Lọc theo ingested_at có đủ không?
Chưa. Cần thêm bước chặn để bản cũ đến muộn không ghi đè bản mới. Lab bỏ bước này thì sản phẩm 2 về giá cũ.
Full refresh có sửa được mọi lỗi không?
Chỉ khi model khử trùng ngoài khối is_incremental. Model lọc updated_at chạy full refresh ra 11 dòng, trùng nhiều hơn.
Bao lâu nên so với full refresh?
Mỗi tuần hoặc theo mẫu là hợp lý. Có dòng lệch thì chạy full refresh và sửa model.
dbt có cần proxy không?
Không. Chỉ bước crawl nạp bảng raw mới có thể cần.
dbt incremental cho dữ liệu web và những điều cần nhớ
dbt incremental cho dữ liệu web tiết kiệm thời gian chạy nhưng chỉ đúng khi điều kiện lọc và khử trùng được viết cho dữ liệu crawl. Lab trên dbt-duckdb 1.11.1 cho thấy lọc theo updated_at để lọt bản trùng và bỏ sót bản đến muộn, còn lọc theo ingested_at kèm khử trùng và bước chặn thì khớp full refresh. So định kỳ với full refresh là cách duy nhất để biết model còn đúng. Cần IP tĩnh cho bước crawl đổ vào bảng raw trước khi chạy dbt incremental cho dữ liệu web, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


