
Common Crawl index và WARC range: lấy đúng một trang từ kho lớn
Common Crawl index và WARC range là cách lấy đúng một bản ghi trang web từ kho crawl khổng lồ mà không tải cả tệp. Bài này viết cho người cần vài nghìn trang lịch sử từ Common Crawl. ProxyVN chạy thật ngày 05/11/2026: máy chủ index trả 504, nên lab dò thẳng tệp cluster.idx bằng Range, rồi lấy 10184 byte từ một tệp WARC 914 MB và khớp digest.
Common Crawl index và WARC range: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và ranh giới với các bài WARC và CDX đã có.
Bài toán cần giải
Một nhóm làm nghiên cứu ngôn ngữ cần nội dung vài nghìn URL đã được Common Crawl lưu. Họ tải một tệp WARC gần 1 GB, mở ra và thấy hàng chục nghìn trang không liên quan. Muốn hết danh sách thì phải tải hàng terabyte. Thứ họ cần chỉ là đúng vài kilobyte trong đó.
Đầu ra nghiệm thu
Đầu ra là bảng bản ghi index gồm URL, thời điểm, filename, offset, length, digest, cùng phép kiểm rằng record tải về đúng là record trong index. Một dòng chỉ được đánh dấu đạt khi target URI, ngày và SHA1 của payload đều khớp. Kiểm chỉ theo HTTP 206 thì chưa đủ.
Ranh giới với WARC writer và Internet Archive CDX
Bài lưu website dạng WARC nói về tự ghi tệp WARC khi crawl. Bài Internet Archive CDX API tra kho của Wayback Machine. Bài này dùng index của Common Crawl để tìm một đoạn trong tệp WARC có sẵn, không tự crawl, không dùng Wayback. Mã tự lưu WARC không xuất hiện ở đây.
Giới hạn của lab
Lab chỉ lấy một URL là trang FAQ của chính Common Crawl, trong crawl CC-MAIN-2026-39. Lab không tải toàn bộ tệp WARC. Máy chủ index.commoncrawl.org trả 504 suốt thời gian chạy, nên phần gọi index qua HTTP trong bài là theo tài liệu, còn phần dò tệp cluster.idx là phần lab chạy thật.
Dữ liệu này dùng vào đâu
Common Crawl là kho dữ liệu được nhiều nhóm dùng cho nghiên cứu ngôn ngữ và huấn luyện mô hình. Bài proxy training AI nói về việc tự thu thập dữ liệu huấn luyện. Khi trang cần đã có trong Common Crawl, đọc từ kho thường rẻ hơn crawl lại, và không gây thêm tải cho website gốc.
Quyền sử dụng nội dung
Common Crawl cung cấp bản lưu, nhưng nội dung trang vẫn thuộc chủ sở hữu. Điều khoản của Common Crawl và luật bản quyền áp dụng cho từng cách dùng. Anh em chỉ nên truy vấn URL mình có cơ sở sử dụng. Lab chọn trang của chính Common Crawl để tránh vấn đề này.
Ai nên đọc
Bài hợp với kỹ sư dữ liệu, nhà nghiên cứu ngôn ngữ, người làm phân tích lịch sử web. Người mới với WARC nên đọc phần thuật ngữ trước. Người chỉ cần một trang cũ để xem có thể dùng Wayback, nhanh và đơn giản hơn nhiều.
Thuật ngữ dùng trong bài
WARC là định dạng lưu request và response web. Mỗi record được nén gzip riêng rồi nối lại, nên có thể đọc một record từ giữa tệp. Offset là vị trí byte bắt đầu của record. Length là số byte nén của record đó. SURT là dạng đảo tên miền, như org,commoncrawl)/faq. CDX là định dạng index theo dòng.
Dùng index Common Crawl tìm WARC segment và tải byte range với Common Crawl index và WARC range
Phần này giải thích luồng tổng thể và nói rõ lỗi lab đã gặp ngay từ bước đầu.
Nguồn tài liệu đã đọc
Lab đọc trang Get Started của Common Crawl. Trang cho biết dữ liệu nằm trên S3 vùng us-east-1 và tải được qua HTTP bằng cách thêm tiền tố https://data.commoncrawl.org/ vào đường dẫn tệp. Điều kiện dùng dữ liệu nằm ở trang FAQ và Terms of Use, anh em đọc trước khi dùng cho sản phẩm.
Luồng ba bước
Bước một tìm URL trong index để lấy filename, offset, length. Bước hai gửi HTTP Range đúng đoạn byte đó. Bước ba giải nén và đọc record bằng thư viện WARC. Cả luồng chỉ cần vài chục kilobyte cho một trang. Nhờ mỗi record nén độc lập nên cách này mới làm được.
Danh sách crawl
Lab gọi index.commoncrawl.org/collinfo.json và nhận 129 collection. Mới nhất là CC-MAIN-2026-43, tên October 2026 Index, cũ nhất là CC-MAIN-2008-2009. Mỗi mục có id, name, timegate, cdx-api. Lab chọn CC-MAIN-2026-39 để tránh crawl vừa mới phát hành.
import requests, time

s = requests.Session()
s.headers["User-Agent"] = "ProxyVN-docs-lab/1.0 (+https://proxy.vn/)"
c = s.get("https://index.commoncrawl.org/collinfo.json", timeout=60).json()
print(len(c), c[0]["id"], c[0]["cdx-api"], c[-1]["id"])
Output thật là 129, CC-MAIN-2026-43, đường dẫn CDX API của crawl đó và CC-MAIN-2008-2009. Tệp collinfo là tĩnh nên chạy ổn ngay cả lúc endpoint truy vấn lỗi.
Gọi CDX API
Cách thông thường là gọi cdx-api với url, output=json. Lab gọi cho commoncrawl.org/faq/ trong crawl 2026-39 và 2026-30, mỗi nơi vài lần giãn cách 20 giây, đều nhận 504 Gateway Time-out từ nginx. Tới cuối ngày lab thử lại vẫn 504. Không phải lúc nào cũng vậy, và lab không biết nguyên nhân. Dịch vụ này được nhiều người dùng chung nên có thể quá tải.
I = "https://index.commoncrawl.org/CC-MAIN-2026-39-index"
r = s.get(I, params={"url": "commoncrawl.org/faq/", "output": "json", "limit": 3}, timeout=120)
print(r.status_code, r.text[:120])
Trong lab đoạn này in 504 và trang lỗi HTML. Khi dịch vụ chạy bình thường, response là các dòng JSON, mỗi dòng có các trường lab sẽ đọc được từ tệp index ở phần sau. Anh em nên thử cách này trước, vì đơn giản hơn.
Đừng lặp nhanh khi gặp 504
Gọi dồn dập vào một dịch vụ đang quá tải chỉ làm tình hình tệ hơn, và IP có thể bị chặn. Lab giãn 20 giây, thử ba lần rồi dừng. Thay vì cố gọi tiếp, lab chuyển sang đường khác: đọc trực tiếp các tệp index tĩnh mà cùng dữ liệu đó đã được xuất bản.
Các tệp index tĩnh
Mỗi crawl có tệp cc-index.paths.gz liệt kê đường dẫn. Lab đọc của 2026-39 và thấy 302 mục: 300 shard từ cdx-00000.gz tới cdx-00299.gz, cùng cluster.idx và metadata.yaml. Các shard này chứa toàn bộ dòng CDX sắp theo SURT. Tệp cluster.idx là chỉ mục của chỉ mục.
import gzip

CID = "CC-MAIN-2026-39"
D = "https://data.commoncrawl.org/"
r = s.get(D + f"crawl-data/{CID}/cc-index.paths.gz", timeout=120)
P = gzip.decompress(r.content).decode().split()
print(len(P), P[:2], P[-3:])
Output là 302 và các đường dẫn nêu trên. Tệp paths rất nhỏ nên tải một lần cho mỗi crawl là đủ.
Vì sao không tải cả cluster.idx
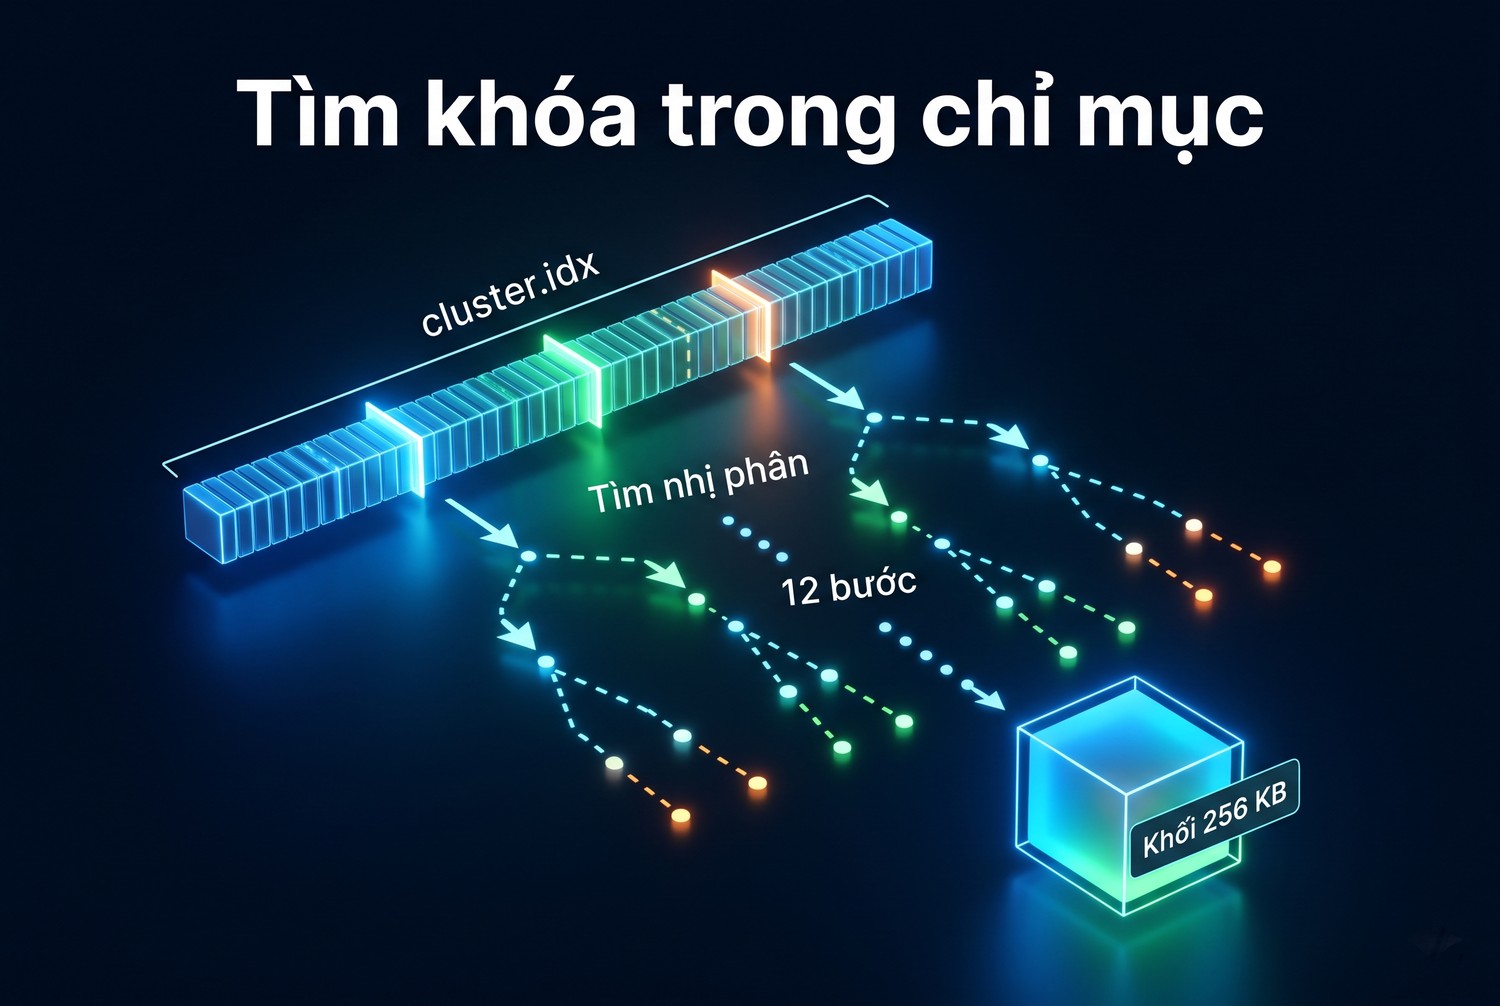
HEAD cho biết cluster.idx nặng 104741069 byte và có Accept-Ranges bytes. Lần đầu lab tải trọn, kết nối hết thời gian đọc sau hơn năm phút. Vì tệp được sắp theo khóa, lab có thể tìm nhị phân ngay trên HTTP, mỗi bước chỉ đọc 4 KB. Cách này là cách lab tự xử lý khi dịch vụ lỗi, tài liệu không mô tả nó như quy trình chuẩn.
Chọn collection index và query URL được phép trong Common Crawl index và WARC range
Trước khi tìm, phải đổi URL về đúng khóa, và hiểu vì sao một URL có nhiều dòng.
Đổi URL thành SURT
Tìm khóa trong chỉ mục
Khóa trong index dạng SURT đảo tên miền, dùng dấu phẩy và ngoặc: https://commoncrawl.org/faq thành org,commoncrawl)/faq. Tìm kiếm cần so theo chuỗi này. Thư viện như surt của Internet Archive làm việc đó, với URL đơn giản anh em có thể tự viết hàm.
Tìm nhị phân qua Range
Đoạn dưới là bản lab chạy thật. Mỗi vòng đọc 4 KB ở giữa khoảng, bỏ dòng dở đầu, so khóa dòng trọn đầu tiên với khóa cần tìm. Khoảng còn dưới 60 KB thì đọc hết và chọn dòng cuối có khóa nhỏ hơn hoặc bằng.
import time

IDX = f"cc-index/collections/{CID}/indexes/"
def rng(path, a, b):
    r = s.get(D + path, headers={"Range": f"bytes={a}-{b}"}, timeout=45)
    assert r.status_code in (200, 206), r.status_code
    return r

size = int(s.head(D + IDX + "cluster.idx", timeout=45).headers["content-length"])
key = "org,commoncrawl)/faq"
lo, hi = 0, size
while hi - lo > 60000:
    mid = (lo + hi) // 2
    t = rng(IDX + "cluster.idx", mid, mid + 4000).content.decode("utf-8", "replace")
    k = t.split("\n")[1].split("\t")[0]
    lo, hi = (mid, hi) if k <= key else (lo, mid)
    time.sleep(1)
rows = rng(IDX + "cluster.idx", lo, hi + 2000).content.decode("utf-8", "replace").split("\n")[1:-1]
line = [x for x in rows if x.split("\t")[0] <= key][-1]
print(line)
Lab mất 12 request Range, đọc tổng cộng dưới 100 KB thay vì 104 MB. Dòng tìm được có khóa org,commonchordqc)/events/list, tệp cdx-00239.gz, offset 477157169, độ dài 256439, số 718705 cuối dòng là số nội bộ của khối. Khóa đó đứng ngay trước khối chứa commoncrawl.
Cột của cluster.idx
Dòng gồm khóa đầu khối kèm timestamp, tên shard, offset, length và một số thứ tự. Mỗi khối trong shard là một đoạn gzip độc lập chứa khoảng 3000 dòng CDX. Đây là cùng ý tưởng với WARC: nén từng đoạn để có thể đọc từ giữa. Chỉ mục hai tầng giúp từ một tệp 100 MB nhảy thẳng tới 256 KB cần thiết.
Đọc đúng một khối của shard
Lab gửi Range 477157169 tới 477413607 vào cdx-00239.gz. Máy chủ trả 206, content-range cho biết tổng tệp là 819210959 byte. Khối nén 256439 byte giải ra 3000 dòng, trong đó 261 dòng thuộc commoncrawl.org. Không phải tải shard 819 MB.
import zlib

f = line.split("\t")
shard, off, ln = f[1], int(f[2]), int(f[3])
r = rng(IDX + shard, off, off + ln - 1)
tx = zlib.decompressobj(31).decompress(r.content).decode()
L = tx.splitlines()
hit = [x for x in L if x.startswith("org,commoncrawl)/faq")]
print(r.status_code, r.headers.get("content-range"), len(L), len(hit))
Output là 206, content-range, 3000 và 8. Tám dòng này là mọi lần URL FAQ được ghi trong crawl đó.
Tám dòng của một URL
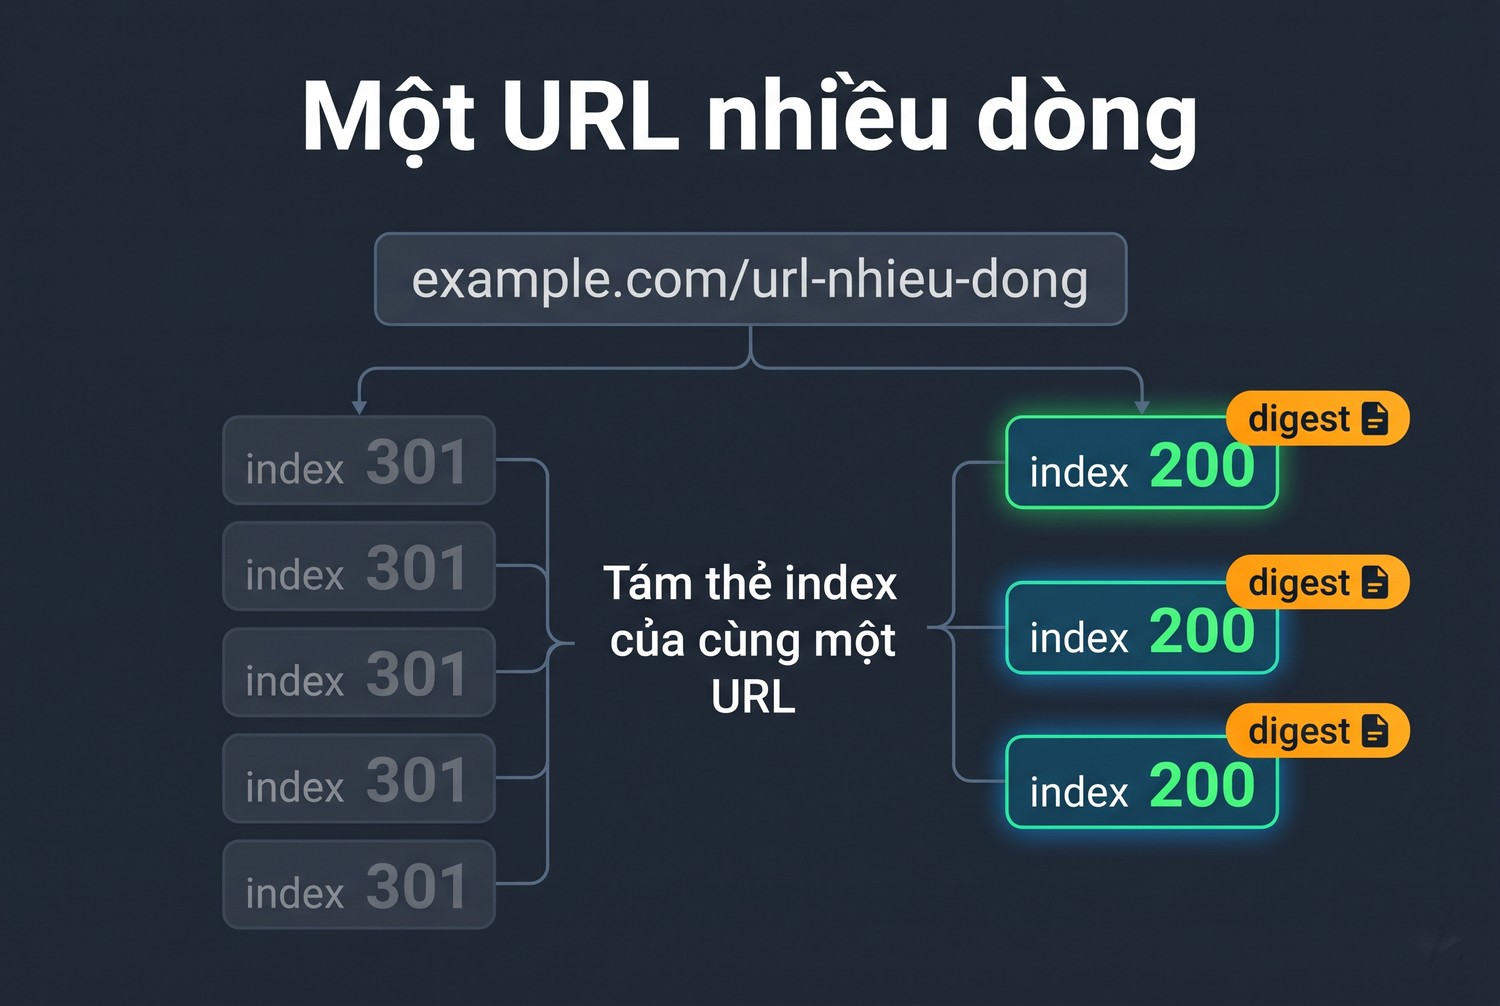
Mỗi dòng có SURT, timestamp và JSON với url, mime, status, digest, length, offset, filename, languages, charset. Một URL xuất hiện nhiều lần vì crawl chạy nhiều ngày và cả dạng có hoặc không dấu gạch chéo. Bảng dưới rút gọn tám dòng thật.
Timestamp |
URL |
Status |
Length |
Digest đầu |
|---|---|---|---|---|
20260905230741 |
/faq/ |
301 |
816 |
LGGT76I5 |
20260906145841 |
/faq/ |
301 |
816 |
LGGT76I5 |
20260908002638 |
/faq/ |
301 |
819 |
LGGT76I5 |
20260909151344 |
/faq |
200 |
10184 |
U4QZUNOV |
20260910002155 |
/faq/ |
301 |
814 |
LGGT76I5 |
20260912082529 |
/faq |
200 |
10180 |
U4QZUNOV |
20260916210133 |
/faq/ |
301 |
821 |
LGGT76I5 |
20260916210133 |
/faq |
200 |
10174 |
COHLRDCZ |
Đọc bảng này
Năm dòng là redirect 301, chỉ ba dòng là trang thật. Lọc status 200 là bước bắt buộc, nếu không anh em sẽ tải về trang chuyển hướng rỗng ruột. Hai dòng 200 đầu có cùng digest U4QZUNOV, nghĩa là nội dung giống hệt dù crawl khác ngày và length khác nhau đôi chút. Dòng cuối có digest khác, nội dung đã đổi.
Dùng digest để bỏ trùng
Length nén khác nhau vì header HTTP và WARC thay đổi, nhưng digest tính trên payload. Vì vậy khử trùng theo digest là chính xác hơn theo URL hay length. Với dự án lấy nhiều URL, chỉ cần một bản cho mỗi digest. Trong ví dụ này, hai trên ba dòng 200 có thể bỏ một.
Crawl nào nên chọn
Nếu cần trạng thái gần đây, chọn crawl mới. Nếu cần lịch sử, truy vấn nhiều collection theo danh sách. Common Crawl không lưu mọi URL ở mọi crawl, nên có URL chỉ xuất hiện ở vài crawl. Bảng kết quả nên có cột collection để biết nguồn.
URL không có trong crawl
Khi URL không tồn tại, CDX API trả lỗi không có kết quả theo tài liệu. Lab không kiểm được nhánh này vì 504. Với cách dò tệp, kết quả rỗng nghĩa là không có dòng khớp trong khối. Lưu ý khóa có thể nằm ngay ranh giới hai khối, nên kiểm thêm khối kế tiếp khi cần chính xác.
Đọc filename, offset và length từ index record của Common Crawl index và WARC range
Phần này nói kỹ về ba trường quan trọng, vì sai một byte là record hỏng.
Bản ghi được chọn
Một URL nhiều dòng
Lab chọn dòng 200 đầu tiên: url https://commoncrawl.org/faq, mime text/html, length 10184, offset 136857083, digest U4QZUNOV4KNNKU263KLCXXFW7WT2E5TW, languages eng, charset UTF-8. Filename là crawl-data/CC-MAIN-2026-39/segments/1788492699863.47/warc/CC-MAIN-20260909150811-20260909180811-00793.warc.gz.
Ý nghĩa filename
Đường dẫn cho biết crawl, segment và tệp WARC. Tên tệp chứa khoảng thời gian ghi và số thứ tự. Filename là đường dẫn tương đối, nên phải ghép đúng tiền tố data.commoncrawl.org. Lưu nguyên chuỗi này vào bảng, không rút gọn, vì đây là thứ giúp tái lập.
Offset và length là kiểu chuỗi
Trong JSON của CDX, offset và length là chuỗi. So sánh chuỗi hay cộng chuỗi sẽ cho lỗi kỳ lạ. Đổi sang int ngay khi đọc. Với tệp gần 1 GB, offset có chín chữ số, nên kiểu số nguyên của Python là phù hợp.
Công thức Range
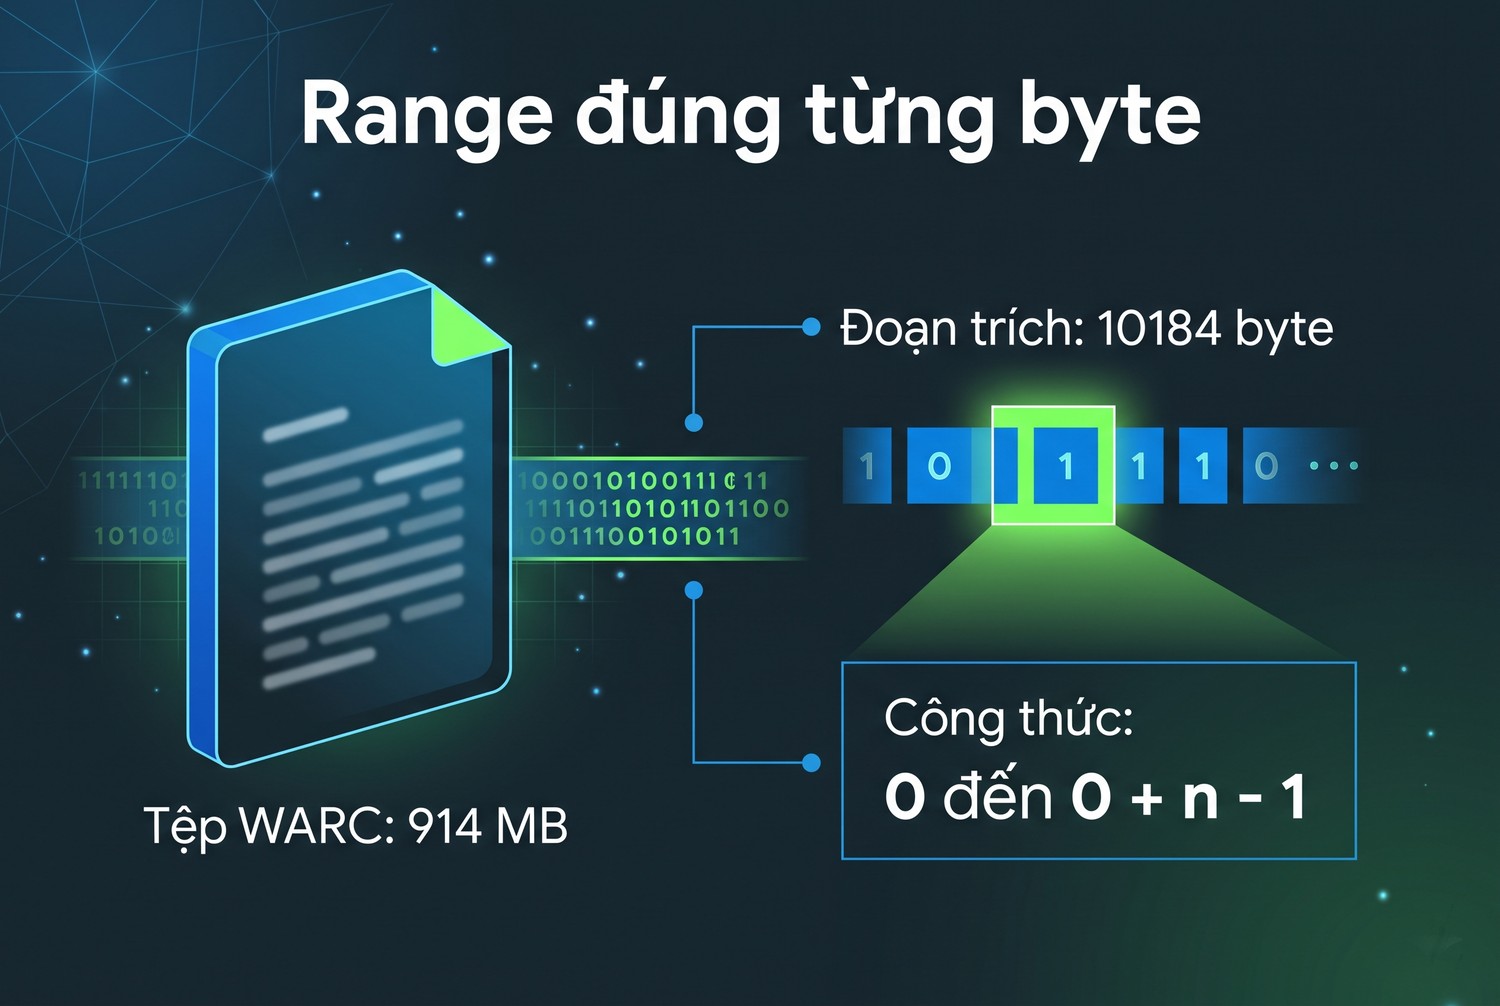
HTTP Range tính cả hai đầu. Muốn đọc n byte từ o thì Range là bytes=o tới o+n-1. Viết o+n là thừa một byte, lúc đó đuôi record dính byte đầu của record kế tiếp. Lỗi này ngắn nhưng làm nhiều người mất cả buổi chiều.
Không có trường nào thay thế được
Thiếu một trong ba trường thì không thể lấy record. Tải theo URL không được, vì tệp WARC không có chỉ mục bên trong. Bảng nên có kiểm tra không rỗng ba cột này trước khi đưa vào hàng tải.
Các trường hỗ trợ
Trường languages và charset do Common Crawl phát hiện, có thể rỗng như các dòng 301. Với lọc theo ngôn ngữ, đây là trường rất tiện, nhưng là kết quả ước đoán tự động. Trường mime lấy từ header, còn mime-detected là do phát hiện. Hai trường có thể khác nhau.
Gom theo tệp để tải
Khi có nhiều record, sắp theo filename rồi offset. Gửi tuần tự theo tệp cho kết nối được dùng lại. Cũng có thể gộp các record liền kề thành một Range lớn. Với vài nghìn record, phần này ảnh hưởng thời gian chạy rõ rệt.
from collections import defaultdict

def group(recs):
    g = defaultdict(list)
    for r in recs:
        g[r["filename"]].append((int(r["offset"]), int(r["length"]), r))
    for f in g:
        g[f].sort(key=lambda x: x[0])
    return g
Hàm nhỏ này là ví dụ của lab, chưa chạy trên nhiều tệp vì lab chỉ có một record.
Tải đúng byte range WARC segment rồi giải nén record với Common Crawl index và WARC range
Đây là bước tạo ra kết quả, và là chỗ anh em thấy tiết kiệm lớn tới đâu.
Gửi Range
Lab gửi Range tới tệp WARC. Máy chủ trả 206 với content-range bytes 136857083-136867266/914479671, thân 10184 byte, ba byte đầu là 1f 8b 08 tức đầu gzip. HEAD xác nhận tệp nặng 914479671 byte. Anh em chỉ tải khoảng 0.001 phần trăm của tệp.
import io, hashlib, base64
from warcio.archiveiterator import ArchiveIterator

x = {"filename": "crawl-data/CC-MAIN-2026-39/segments/1788492699863.47/warc/"
                 "CC-MAIN-20260909150811-20260909180811-00793.warc.gz",
     "offset": "136857083", "length": "10184",
     "digest": "U4QZUNOV4KNNKU263KLCXXFW7WT2E5TW"}
o, n = int(x["offset"]), int(x["length"])
b = rng(x["filename"], o, o + n - 1)
for rec in ArchiveIterator(io.BytesIO(b.content)):
    h = rec.rec_headers
    body = rec.content_stream().read()
    sha = base64.b32encode(hashlib.sha1(body).digest()).decode()
    print(rec.rec_type, h.get_header("WARC-Target-URI"), h.get_header("WARC-Date"),
          rec.http_headers.get_statuscode(), len(body), sha == x["digest"])
Lab dùng warcio 1.8.2. Output thật là response, https://commoncrawl.org/faq, 2026-09-09T15:13:44Z, 200, 43144 và True. Trang có title Common Crawl - FAQ. Record nén 10 KB chứa 43 KB nội dung.
Một record trong một Range
Đoạn tải chứa đúng một record loại response. Common Crawl lưu request, response và metadata thành các record riêng, index trỏ thẳng record response. Vòng lặp vẫn nên dùng ArchiveIterator để tận dụng phần đọc header, không tự cắt tay.
Digest tính thế nào
Trường digest trong index và header WARC-Payload-Digest đều là SHA1 mã hóa base32 của payload. Lab tính lại trên thân response sau khi warcio bỏ header HTTP, ra đúng U4QZUNOV4KNNKU263KLCXXFW7WT2E5TW. Khớp ba nơi: index, header WARC, tính lại. Đây là bằng chứng mạnh nhất rằng anh em cầm đúng dữ liệu.
Thử lệch offset
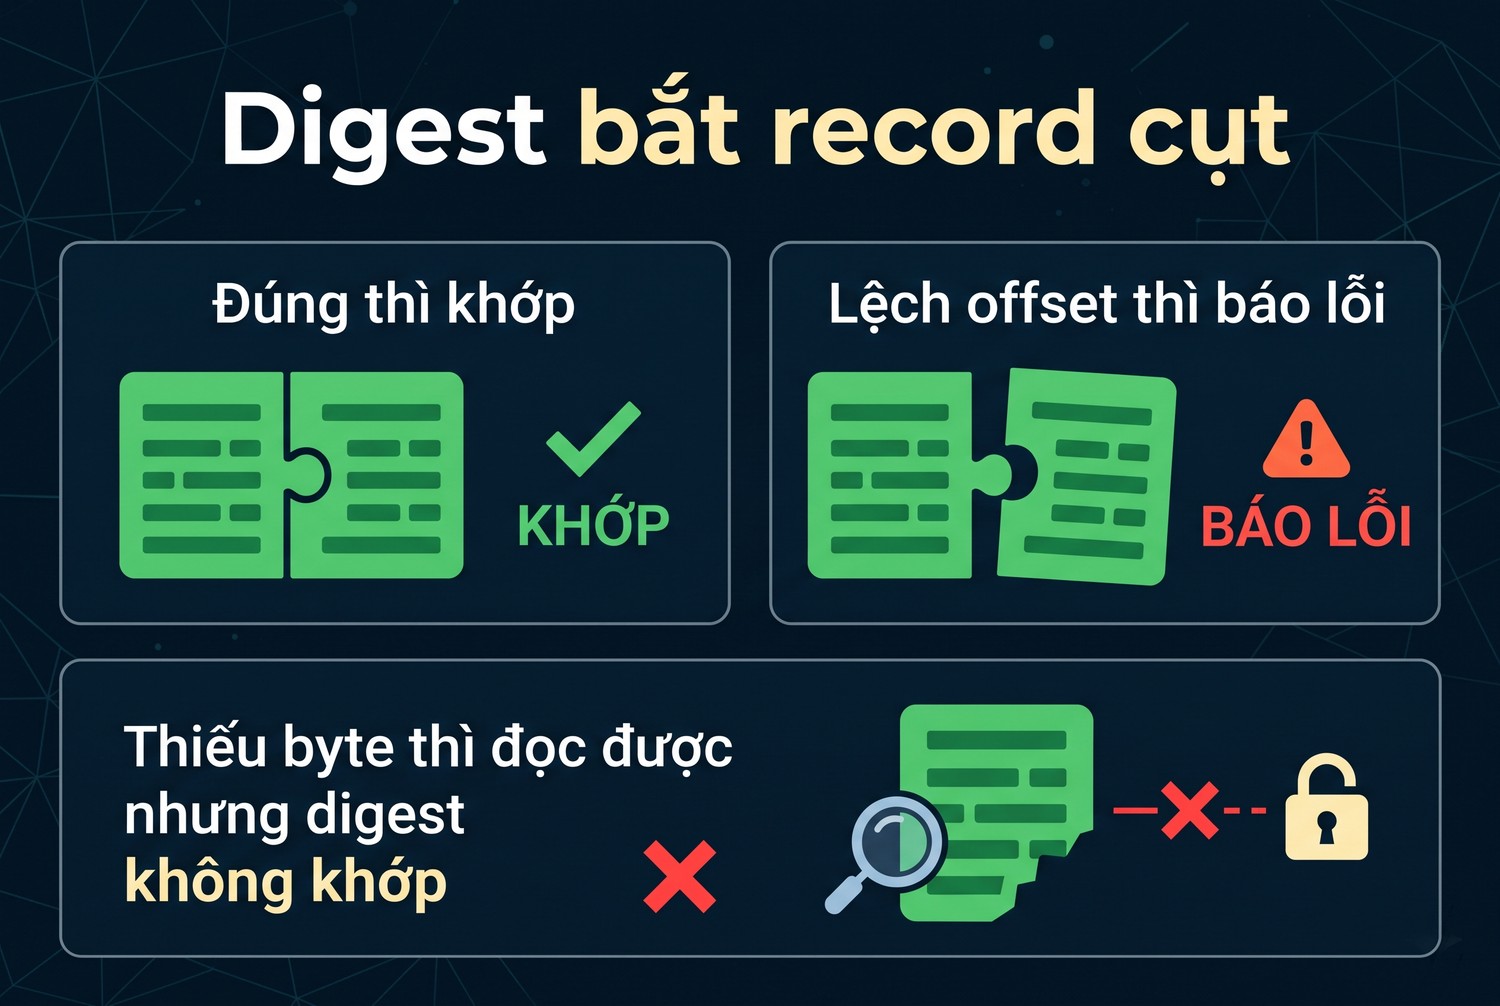
Lab cố tình cộng 7 vào offset. Warcio ném ArchiveLoadFailed với thông báo Invalid ARC record. Lỗi này rõ ràng, nên lệch đầu record dễ bắt. Sai số ở phép ghép offset sẽ hiện ngay ở dòng đầu.
Thử thiếu 100 byte cuối
Lab cắt 100 byte cuối của đoạn tải. Không có lỗi, chỉ có cảnh báo, và warcio trả body 42969 byte thay vì 43144. SHA1 không còn khớp. Record cụt đọc được bình thường, chỉ phép kiểm digest mới phát hiện. Kiểm HTTP 206 và kiểm parse thành công đều không đủ.
Phép thử |
Kết quả warcio |
Body |
Digest |
|---|---|---|---|
Đúng offset, đúng length |
Đọc được |
43144 byte |
Khớp |
Offset cộng 7 |
ArchiveLoadFailed |
không có |
không có |
Thiếu 100 byte cuối |
Đọc được, có cảnh báo |
42969 byte |
Không khớp |
Kiểm độ dài thân response
Với Range, máy chủ có thể trả 200 và cả tệp nếu không hỗ trợ. Script phải kiểm mã 206 và len(content) bằng length, trước khi parse. Nếu nhận 200 từ một proxy trung gian, anh em có thể đang tải gần 1 GB mà không biết. Một assert sẽ chặn điều này.
Content-Encoding
Record của lab có Content-Encoding rỗng, thân response là HTML thường. Với trang có nén, thân có thể đã được giải nén lúc ghi, hoặc còn nén tùy cách lưu của crawler. Khi đọc, anh em kiểm header này trước khi decode. Phần liên quan có ở bài gzip và brotli khi web scraping.
Lưu record thô
Lab lưu đoạn 10184 byte thành tệp rec.warc.gz. Tệp này tự nó là một WARC hợp lệ gồm một record. Lưu dạng này giúp giữ đủ header HTTP gốc và kiểm lại sau. Nhiều record có thể ghép nối bằng cách viết nối tiếp các đoạn gzip vào một tệp.
Đối soát target URI, time, payload với index thay vì tải cả kho trong Common Crawl index và WARC range
Phần này biến các phép thử thành hàm kiểm dùng được cho hàng loạt.
Hàm kiểm một record
Range đúng từng byte
Hàm nhận dòng index và byte đã tải, trả về danh sách lỗi. Rỗng nghĩa là đạt. Ba phép so chính: URI, ngày theo timestamp và digest.
import re

def verify(x, ts, raw):
    err = []
    if len(raw) != int(x["length"]):
        err.append("sai_do_dai")
    try:
        rec = next(iter(ArchiveIterator(io.BytesIO(raw))))
    except Exception as e:
        return err + [type(e).__name__]
    h = rec.rec_headers
    body = rec.content_stream().read()
    if h.get_header("WARC-Target-URI") != x["url"]:
        err.append("sai_uri")
    d = h.get_header("WARC-Date")
    if re.sub(r"\D", "", d)[:14] != ts:
        err.append("sai_thoi_diem")
    if base64.b32encode(hashlib.sha1(body).digest()).decode() != x["digest"]:
        err.append("sai_digest")
    return err
Timestamp 20260909151344 trong index tương ứng WARC-Date 2026-09-09T15:13:44Z. Phép re.sub bỏ mọi ký tự không phải số rồi lấy 14 chữ số đầu để so với timestamp. Lab chạy hàm trên tệp rec.warc.gz và nhận danh sách lỗi rỗng.
Kết quả hàm kiểm
Lab chạy verify trên tệp rec.warc.gz đầy đủ và nhận danh sách rỗng. Chạy trên bản cắt 100 byte cuối thì nhận sai_do_dai và sai_digest. Hai dòng output đó là phép thử rẻ nhất để biết hàm kiểm hoạt động đúng. Mỗi lần sửa code, anh em nên chạy lại cả ca đúng lẫn ca hỏng.
Thiết kế hàng đợi tải
Với danh sách lớn, anh em chia thành bảng trạng thái có các cột key, filename, offset, length, state. Trạng thái đi từ cho_tai sang da_tai, da_kiem hoặc loi. Job có thể dừng và chạy lại mà không tải lại record đã đạt. Thiết kế đơn giản này quan trọng hơn tốc độ tải trong các dự án chạy nhiều ngày.
Xử lý lỗi tạm thời
Tải từ data.commoncrawl.org có thể gặp timeout hay 503 khi tải nặng. Lần tải cluster.idx trọn của lab đã timeout, trong khi các Range nhỏ thì chạy tốt. Hàm tải nên thử lại với thời gian chờ tăng dần, tối đa vài lần, rồi chuyển record sang trạng thái loi để xem sau. Không nên để một record chặn cả hàng đợi.
Trích văn bản sau khi kiểm
Chỉ sau khi record đạt mới trích nội dung. Thân response là HTML, và cần parser riêng để lấy văn bản. Lưu bản thô tách khỏi bản trích, vì cách trích thay đổi theo thời gian còn bản thô thì không. Khi muốn thay thuật toán, anh em chỉ chạy lại bước trích, không tải lại kho.
Bản WET và WAT
Mỗi crawl còn có tệp WET chứa văn bản đã trích và WAT chứa metadata. Index CDX trỏ vào tệp WARC, nên cách của bài áp cho WARC. Nếu chỉ cần văn bản của rất nhiều trang và không cần chọn URL cụ thể, tải WET có thể đơn giản hơn. Lab không dùng hai loại này.
Ghi lại đường đi tìm
Trong manifest, anh em ghi rõ dòng đến từ CDX API hay từ tệp shard. Với lab là shard cdx-00239.gz, offset 477157169. Thông tin này giúp người khác lặp lại đúng đường đi khi dịch vụ đang lỗi. Hai đường cho cùng dòng index, nên kết quả không đổi. Ghi rõ đường đi cũng giúp lần chạy sau biết nên thử cách nào trước, nhất là khi máy chủ index đang chậm. Một dòng ghi chú ngắn như vậy tiết kiệm được nhiều giờ dò lại về sau.
Tỷ lệ tải thực tế
Với một record, lab đọc dưới 100 KB của cluster.idx, 256 KB của shard và 10 KB của WARC. Tổng khoảng 366 KB để lấy một trang trong một kho hàng trăm terabyte. Khi có nhiều URL cùng tên miền, khối CDX được dùng lại, chi phí trung bình còn giảm. Dùng CDX API lúc nó hoạt động thì còn gọn hơn.
Tải nhiều record có trách nhiệm
Common Crawl chạy trên hạ tầng công cộng. Khi lấy hàng trăm nghìn record, tài liệu gợi ý truy cập từ cùng vùng AWS để nhanh và tránh phí truyền. Từ ngoài AWS, script chỉ nên chạy vài kết nối và có giãn cách, xử lý 503 bằng lùi thời gian. Lab chỉ đọc một record.
Chỉ mục cột cho truy vấn lớn
Common Crawl còn có chỉ mục dạng cột trên S3, trang web có mục URL Index và CDXJ Index. Với truy vấn kiểu "mọi URL của tên miền .vn", chỉ mục cột qua công cụ phân tích hợp hơn việc gọi từng URL. Lab không chạy cách này, nên bài không có số đo.
Không suy ra độ phủ
Trang không có trong index không có nghĩa là không tồn tại. Common Crawl là mẫu của web, không phải toàn bộ, và tôn trọng robots.txt theo trang CCBot của họ. Báo cáo cần nói "có trong crawl X", không nói "website này có bao nhiêu trang".
Proxy có cần không
Dữ liệu công khai, không khóa, không cần proxy. Lỗi 504 của lab là do dịch vụ, không phải do IP, nên đổi IP không phải cách giải quyết. Khi mạng công ty bắt buộc qua cổng ra, phải chắc proxy đó giữ nguyên header Range, xem thêm bài HTTP Range tải tiếp qua proxy. Chuỗi cấu hình theo định dạng proxy.
Khi cần crawl lại
Nếu trang cần không có trong kho, anh em phải tự thu thập, đúng robots và điều khoản của trang đó. Bài Web Scraping proxy là gì đề cập vai trò proxy trong việc đó.
Khi đó nếu cần IP ổn định, anh em có thể mua proxy Việt Nam tại trang chủ ProxyVN.
Khóa phiên bản
Lab chạy Python 3.12.10, requests 2.34.2, warcio 1.8.2. Crawl id ghi cố định trong cấu hình. Dữ liệu một crawl không đổi sau khi phát hành theo cách lưu của kho, nên kết quả tái lập được bằng cùng filename và offset.
Đầu ra nghiệm thu bản ghi index filename, offset, length và kiểm trích đúng WARC record của Common Crawl index và WARC range
Mục này chốt bảng và danh sách kiểm.
Bản ghi nghiệm thu thật
Digest bắt record cụt
Cột |
Giá trị thật |
|---|---|
collection |
CC-MAIN-2026-39 |
surt |
org,commoncrawl)/faq |
timestamp |
20260909151344 |
url |
https://commoncrawl.org/faq |
status |
200 |
offset |
136857083 |
length |
10184 |
digest |
U4QZUNOV4KNNKU263KLCXXFW7WT2E5TW |
body_bytes |
43144 |
verified |
true |
Danh sách kiểm
- Collection: ghi id crawl cố định.
- Lọc status: bỏ redirect trước khi tải.
- Range: đúng công thức, nhận 206, đúng độ dài.
- URI và ngày: khớp index.
- Digest: SHA1 base32 của payload khớp index.
- Trùng: khử theo digest khi lấy nhiều lần.
Câu kết luận được phép viết
Từ lab có thể viết rằng lấy một trang chỉ cần vài trăm KB, rằng record cụt vẫn parse được và chỉ digest bắt được, rằng tệp index tĩnh dùng được khi máy chủ index lỗi. Không nên viết về thời gian chạy khi quy mô lớn, vì lab chỉ thử một record.
Những gì lab chưa chạy
Lab chưa nhận được response thành công từ CDX API, chưa dùng chỉ mục cột, chưa lấy nhiều URL, chưa đo thời gian từ AWS. Hàm verify chưa chạy qua lượng lớn record. Hàm group mới là ví dụ.
HTTP 206 chỉ cho biết máy chủ đã trả đoạn byte. Chỉ digest mới cho biết đoạn đó đúng là record cần tìm.
Common Crawl index và WARC range: câu hỏi thường gặp
Các câu dưới đây gom những điểm hay bị hỏi.
Có cần tài khoản AWS không?
Không. HTTP qua data.commoncrawl.org dùng được không cần tài khoản.
Gặp 504 ở index.commoncrawl.org thì sao?
Giãn cách, thử lại ít lần. Có thể đọc tệp cluster.idx và shard tĩnh như lab đã làm.
Vì sao một URL có nhiều dòng?
Trang được ghi nhiều lần trong kỳ crawl, và có cả bản redirect. Lọc theo status và digest.
Range trả 200 thì sao?
Dừng lại. Có thể đang nhận cả tệp. Kiểm mã 206 và độ dài.
Warcio không báo lỗi thì record có đúng không?
Chưa chắc. Lab thấy record thiếu 100 byte vẫn đọc được. Phải kiểm digest.
Có nên tải cả tệp WARC?
Chỉ khi cần phân tích toàn bộ tệp. Lấy URL cụ thể thì dùng Range.
Nội dung tải về có được dùng tự do không?
Không tự động. Bản quyền thuộc chủ nội dung. Kiểm điều khoản theo mục đích dùng.
Có cần proxy không?
Không, trừ khi mạng công ty bắt buộc. Proxy phải giữ nguyên Range.
Common Crawl index và WARC range và những điều cần nhớ
Common Crawl index và WARC range giúp lấy đúng một record từ kho khổng lồ khi anh em lọc status, tính Range chuẩn và kiểm digest mỗi record, thay vì tin vào mã 206. Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam khuyên anh em giữ bản ghi index khi dùng Common Crawl index và WARC range.


