
Colly collector và hàng đợi crawl: chặn vòng lặp URL
Colly collector và hàng đợi crawl là cách ghép Collector của thư viện Colly (Go) với gói queue để duyệt một website theo kiểu đẩy URL vào hàng rồi để vài worker lấy ra tải dần. Nghe đơn giản, nhưng trên một website thật, các trang trỏ qua lại với nhau thành vòng, và một queue viết vội sẽ phình to, tải lặp hoặc không bao giờ dừng. ProxyVN dựng một đồ thị 40 trang có vòng ngày 03/11/2026, chạy Colly v2.3.0 trên Go 1.27.3 và ghi lại từng con số: bao nhiêu URL được đẩy vào, bao nhiêu lượt tải, khi nào queue thật sự kết thúc.
Colly collector và hàng đợi crawl: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra cần nghiệm thu và những gì bài cố ý không nhắc lại.
Bài toán cụ thể
Anh em viết crawler bằng Go thường bắt đầu bằng ví dụ có sẵn: tạo Collector, gắn hàm OnHTML cho thẻ a, rồi gọi Visit cho mỗi link. Cách đó chạy được với vài chục trang. Khi chuyển sang queue để giới hạn số luồng và tách việc tìm link khỏi việc tải, ba câu hỏi xuất hiện.
Câu thứ nhất: queue có tự bỏ URL trùng không. Câu thứ hai: URL nào được coi là trùng, ví dụ có dấu gạch chéo cuối, có fragment, có tham số đảo thứ tự. Câu thứ ba: trên một đồ thị có vòng hoặc có trang sinh link vô hạn, điều gì làm queue dừng.
Bài trả lời cả ba bằng lab chạy thật, không suy từ tài liệu.
Đầu ra cần nghiệm thu
Đầu ra là một bộ ba gồm fixture đồ thị URL, số URL duy nhất thật sự đã tải và nhật ký cho thấy queue kết thúc trong thời gian hữu hạn. Nếu một cấu hình chạy hết thời gian chờ mà queue vẫn còn việc, đó là kết quả trượt, dù số trang tải được nhìn có vẻ đẹp.
Mỗi lần chạy in ra cùng một dòng: số lần gọi AddURL, số lần queue báo đầy, số lượt tải, số URL khác nhau, kích thước queue lớn nhất và trạng thái đã kết thúc hay bị cắt.
Phạm vi không lặp với bài Go có sẵn
Bài Golang proxy đã hướng dẫn đặt proxy trong net/http và trong Colly bằng SetProxyFunc hay RoundRobinProxySwitcher. Bài này không nhắc lại phần cấu hình proxy đó. Trọng tâm ở đây là cách duyệt: queue, khóa URL và điều kiện dừng.
Bài cũng không phải hướng dẫn crawler tổng quát bằng Python. Ai cần nền tảng chung có thể đọc bài xây dựng web crawler Python. Ở đây mọi thứ gắn với hành vi của chính mã nguồn Colly.
Vì sao phải đo thay vì đọc tài liệu
Trang ví dụ queue của Colly chỉ cho thấy cách tạo queue, thêm URL và gọi Run. Nó không nói queue không khử trùng, không nói request thêm bằng AddURL mang độ sâu bằng 0. Những điều đó chỉ lộ ra khi đọc mã nguồn và chạy trên đồ thị có bẫy.
Mình đã đọc tệp queue.go và colly.go của phiên bản v2.3.0 trong module cache, đối chiếu với tài liệu gói queue trên pkg.go.dev, rồi viết lab để xác nhận từng hành vi. Mã nguồn đầy đủ nằm ở kho gocolly/colly trên GitHub. Chỗ nào chỉ là suy luận sẽ được ghi rõ.
Ai nên đọc
Người đang chạy crawler Go nhiều luồng và thấy số request lớn hơn số trang. Người từng để job chạy qua đêm rồi sáng ra thấy nó vẫn chạy trên một trang lịch hay trang lọc vô tận. Người cần báo cáo chính xác số URL đã thu cho khách hàng hay cho đội dữ liệu.
Thiết kế queue Colly cho đồ thị URL có vòng lặp: Colly collector và hàng đợi crawl
Trước khi viết mã, cần hiểu queue của Colly làm gì và không làm gì.
Queue là danh sách request, không phải tập URL
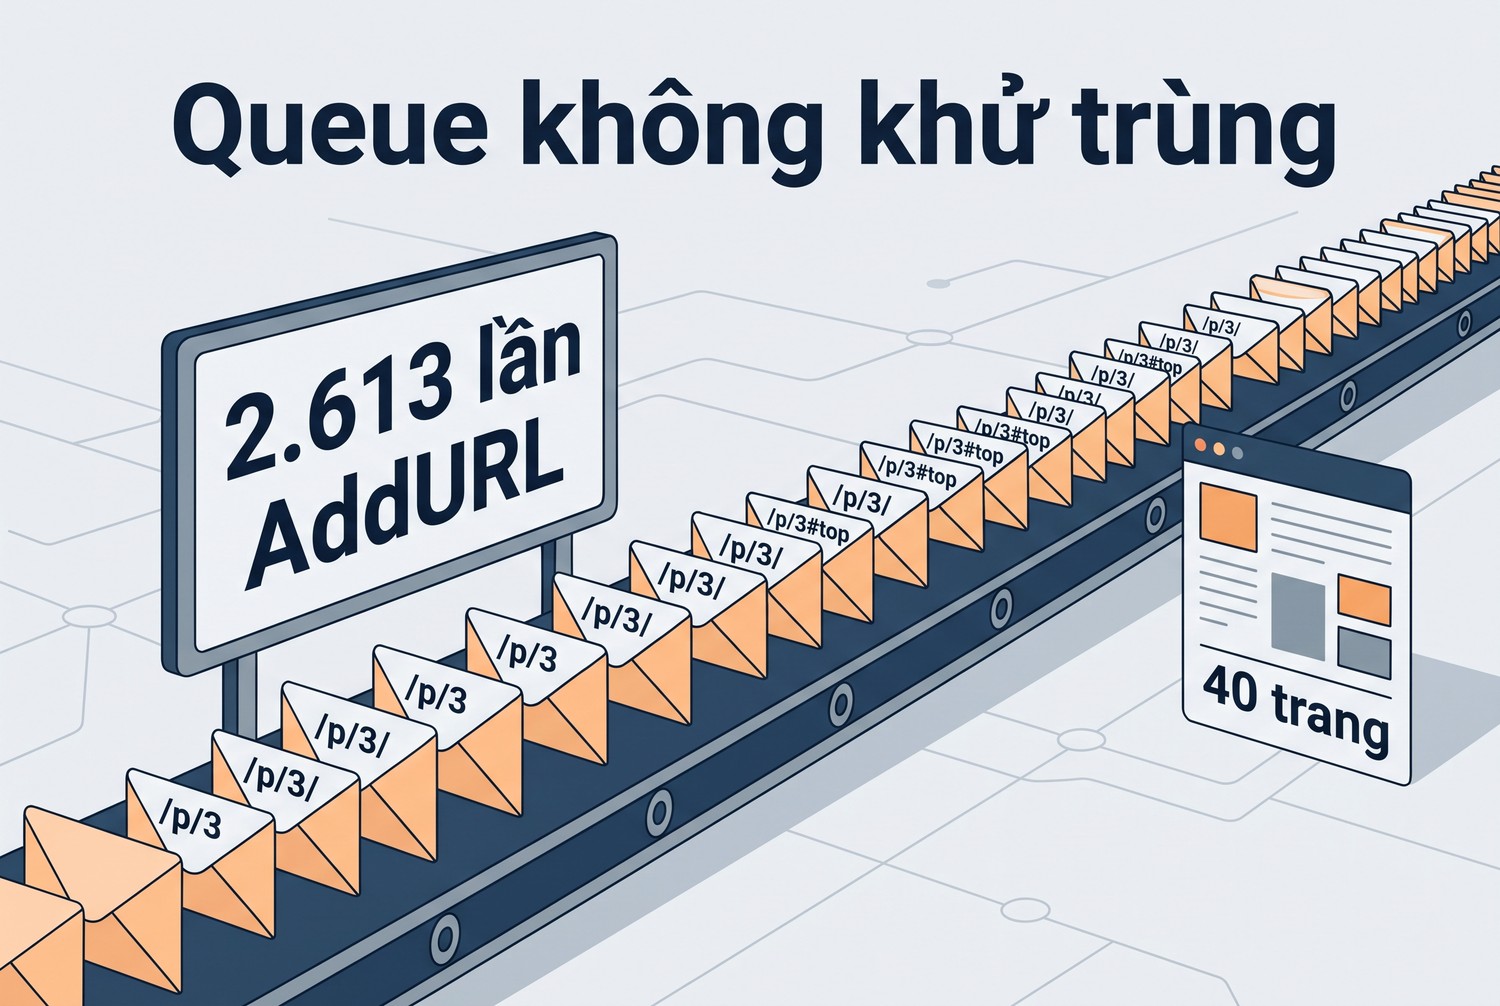
Queue không khử trùng
Gói queue có một kiểu Queue với số luồng Threads và một Storage. Storage mặc định là InMemoryQueueStorage, một danh sách liên kết đơn giản. Mỗi lần AddURL, queue tạo một Request, tuần tự hóa thành byte rồi nối vào cuối danh sách.
Không có bước nào kiểm tra URL đã có trong danh sách hay chưa. Nếu một trang được mười trang khác trỏ tới, nó có thể nằm trong queue mười lần. Việc chặn tải lặp chỉ diễn ra muộn hơn, khi request được lấy ra và Collector kiểm tra kho đã thăm.
Kho đã thăm nằm ở Collector
Collector giữ một store, mặc định trong bộ nhớ, lưu mã băm của URL đã tải. Hàm requestCheck tính mã băm FNV-64a từ URL đã chuẩn hóa cộng thân request nếu có. Nếu mã băm đã có, Collector trả lỗi AlreadyVisitedError và không tải.
Vậy request trùng vẫn chiếm chỗ trong queue, vẫn được lấy ra, vẫn tốn một lượt kiểm tra. Nó chỉ không tốn băng thông. Với đồ thị nhỏ, chi phí này không đáng kể. Với website hàng trăm nghìn trang, queue có thể phình lên nhiều lần số trang thật.
Chuẩn hóa URL của Colly không gộp mọi biến thể
Colly dùng thư viện whatwg-url để chuẩn hóa. Nó gộp được vài khác biệt nhỏ như thiếu dấu gạch chéo sau tên miền. Nó không gộp đường dẫn có và không có gạch chéo cuối, không sắp xếp tham số truy vấn.
Phát hiện bất ngờ nhất trong lab là fragment. Hàm AbsoluteURL bỏ qua href chỉ gồm fragment, nhưng giữ fragment khi href có cả đường dẫn. Vì vậy /p/3 và /p/3#top là hai mục khác nhau trong kho đã thăm, dù máy chủ không hề nhận phần sau dấu thăng.
Vòng lặp chỉ là vấn đề khi khóa sai
Đồ thị có vòng tự nó không làm queue chạy mãi. Mỗi URL chỉ tải một lần nhờ kho đã thăm, nên số lượt tải bị chặn bởi số URL khác nhau. Vấn đề nằm ở chỗ số URL khác nhau theo cách nhìn của Colly có thể lớn hơn nhiều so với số trang thật.
Trường hợp tệ nhất là trang tự sinh link mới mỗi lần tải, như lịch có nút tháng sau. Khi đó số URL khác nhau là vô hạn và kho đã thăm không cứu được.
Ba hàng rào cần có
Một thiết kế queue an toàn cần ba lớp. Lớp một là bộ lọc phạm vi: tên miền, tiền tố đường dẫn, kiểu tệp. Lớp hai là khóa URL do mình kiểm soát, áp dụng trước khi đẩy vào queue. Lớp ba là giới hạn cứng như độ sâu hay tổng số trang, đặt sao cho nó thật sự có hiệu lực với queue.
Phần lab cho thấy lớp ba có cái bẫy riêng mà nhiều người không để ý.
Tạo collector và queue backend, giới hạn phạm vi URL cho Colly collector và hàng đợi crawl
Phần này mô tả fixture và cách khởi tạo Collector cùng queue trong lab.
Fixture đồ thị 40 trang có vòng
Máy chủ lab là một handler net/http trong chính chương trình, nghe ở 127.0.0.1 cổng 9811. Có 40 trang /p/0 đến /p/39. Trang i trỏ tới ba trang: i cộng 1, 7i cộng 3 và i trừ 1, đều lấy dư theo 40. Đồ thị này đầy vòng.
Mỗi liên kết được viết ba kiểu: /p/j, /p/j#top và /p/j/. Mỗi trang còn có link về trang chủ, hai link tới chính nó với tham số đảo thứ tự ?b=2&a=1 và ?a=1&b=2, cùng một link ra tên miền ngoài example.org. Máy chủ đếm từng request-URI mà nó thật sự nhận.
Bẫy lịch vô hạn
Ở chế độ bẫy, trang /p/5 có thêm link tới /cal?d=1. Trang lịch nào cũng có link sang tháng sau với d tăng thêm 1, và một link về /p/1. Đây là mô hình rút gọn của trang lịch, trang lọc hay trang phân trang không có điểm cuối.
Khởi tạo Collector
c := colly.NewCollector(
    colly.AllowedDomains("127.0.0.1"),
    colly.IgnoreRobotsTxt(), // chỉ vì fixture cục bộ
)
c.MaxDepth = 3
q, _ := queue.New(4, &queue.InMemoryQueueStorage{MaxSize: 100000})
c.OnHTML("a[href]", func(e *colly.HTMLElement) {
    q.AddURL(e.Request.AbsoluteURL(e.Attr("href")))
})
q.AddURL("http://127.0.0.1:9811/")
q.Run(c)
AllowedDomains so tên máy, không có cổng
Lần chạy đầu, mình ghi AllowedDomains là 127.0.0.1:9811 và queue kết thúc ngay với 0 lượt tải, không báo lỗi gì vì hàm OnError để trống. Lý do: Colly so với Hostname của URL, phần này không chứa cổng. Đổi thành 127.0.0.1 thì chạy đúng.
Bài học nhỏ nhưng tốn thời gian: luôn gắn OnError và in lỗi trong lúc thử, ít nhất là đếm số lỗi theo loại. Một crawler kết thúc êm với 0 trang là dấu hiệu cấu hình sai, không phải website trống.
IgnoreRobotsTxt chỉ dành cho fixture
Lab tắt kiểm tra robots.txt vì máy chủ cục bộ không có tệp này. Với website thật, giữ mặc định để Colly đọc robots.txt và tôn trọng nó. Bài robots.txt khi crawl website nói rõ cách đọc các quy tắc.
Số luồng và kích thước queue
Queue tạo bốn goroutine chạy request song song. MaxSize là số request tối đa nằm chờ trong storage. Khi đầy, AddRequest trả về colly.ErrQueueFull và request bị bỏ. Nếu mã gọi AddURL không kiểm tra lỗi, request mất trong im lặng.
Đọc lỗi trả về từ AddURL
if err := q.AddURL(u); errors.Is(err, colly.ErrQueueFull) {
    dropped.Add(1) // ghi lại, đừng nuốt
}
Thêm URL vào queue và quyết định khóa URL đã thăm trong Colly collector và hàng đợi crawl
Đây là phần quyết định số lượt tải và độ phình của queue.
Cách ngây thơ: đẩy mọi link
Cấu hình A đẩy mọi href vào queue qua AddURL, MaxSize 100.000. Cấu hình B giống A nhưng MaxSize chỉ 50. Cấu hình C áp một hàm khóa URL của riêng mình rồi chỉ đẩy URL chưa thấy, MaxSize 50.
Hàm khóa URL trong lab
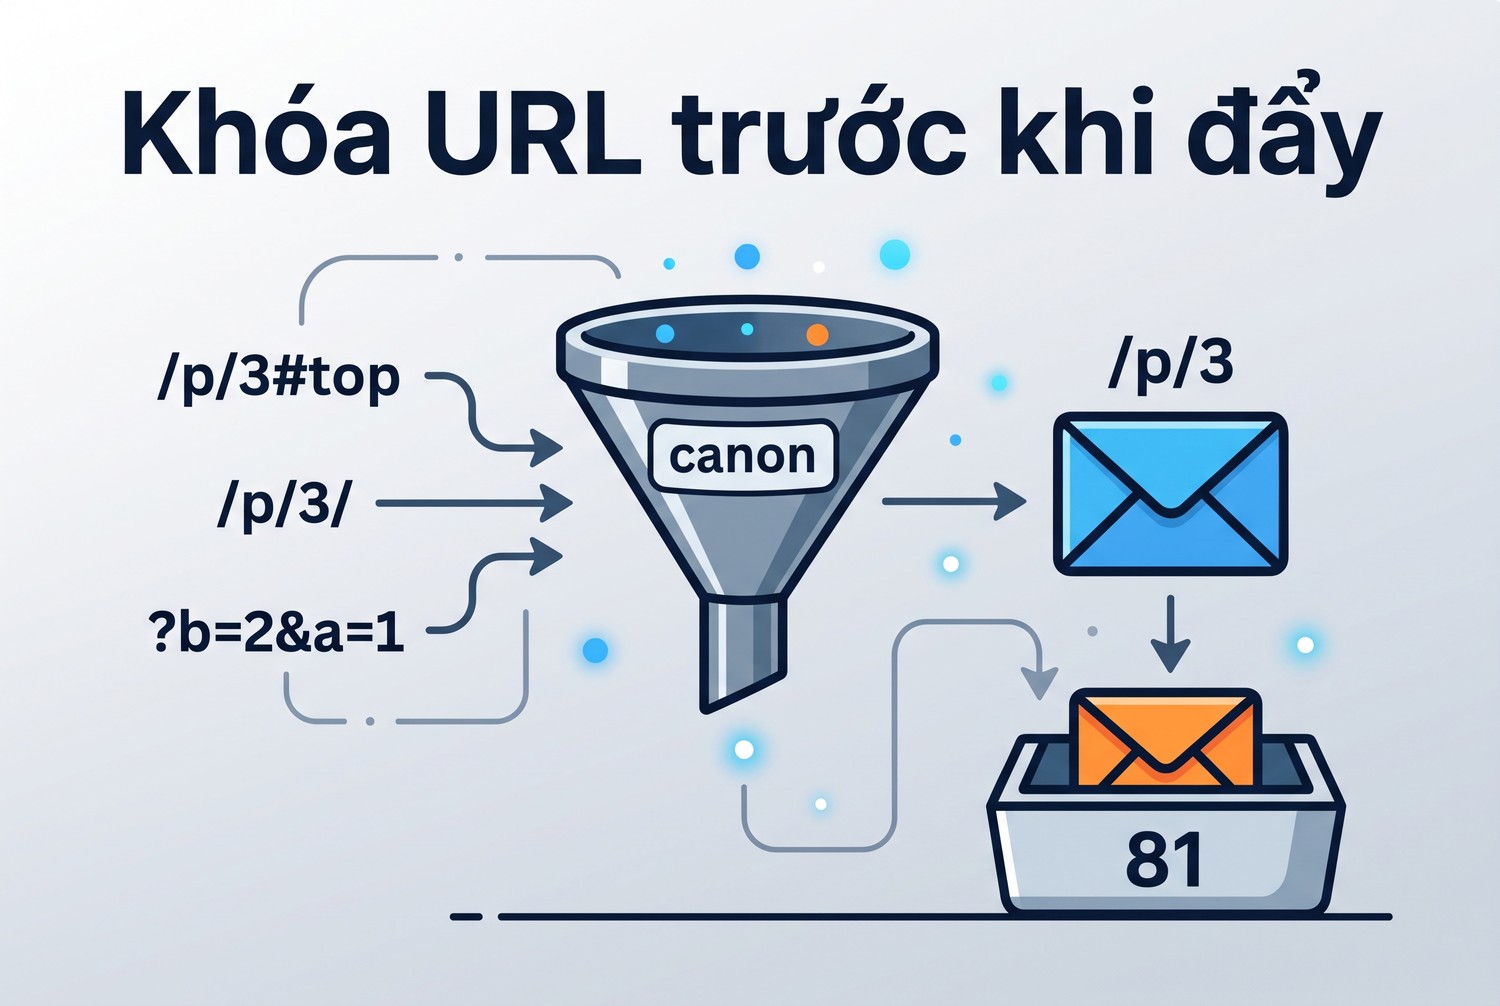
Khóa URL trước khi đẩy
func canon(raw string) string {
    u, err := url.Parse(raw)
    if err != nil { return "" }
    u.Fragment = ""
    u.Host = strings.ToLower(u.Host)
    if len(u.Path) > 1 { u.Path = strings.TrimSuffix(u.Path, "/") }
    u.RawQuery = u.Query().Encode() // Encode sắp xếp theo tên tham số
    return u.String()
}
Hàm này làm bốn việc: bỏ fragment, hạ chữ thường tên máy, bỏ gạch chéo cuối đường dẫn, sắp xếp tham số. Kết quả dùng làm khóa trong một sync.Map. URL đã có khóa thì không đẩy nữa.
Khóa là quyết định nghiệp vụ
Bỏ gạch chéo cuối là an toàn với fixture vì máy chủ trả cùng nội dung. Trên website thật, /a và /a/ có thể là hai tài nguyên khác nhau. Sắp xếp tham số cũng chỉ đúng khi máy chủ không quan tâm thứ tự, điều thường đúng nhưng không phải luôn đúng.
Vì vậy hàm khóa nên đi kèm một phép thử nhỏ: tải vài cặp biến thể, so mã băm nội dung. Nếu giống nhau, gộp. Nếu khác, giữ riêng. Bài SimHash chống trùng nội dung crawl có cách so nội dung gần giống khi trang có phần thay đổi nhỏ như thời gian.
Tham số không làm đổi nội dung
Fixture có ?a=1&b=2 trỏ về chính trang. Hàm khóa sắp xếp tham số nên gộp được hai thứ tự, nhưng vẫn coi /p/3?a=1&b=2 khác /p/3. Đó là lý do cấu hình C tải 81 URL chứ không phải 41.
Nếu biết chắc a và b là tham số theo dõi, bỏ hẳn chúng trong hàm khóa. Danh sách tham số cần bỏ nên ghi trong cấu hình, không chôn trong mã, vì nó khác nhau theo từng website.
Gieo hạt từ sitemap
Thay vì chỉ bắt đầu từ trang chủ, có thể đẩy toàn bộ URL trong sitemap vào queue trước. Cách này giúp tới được trang ít link vào, và cho ngay một danh sách kỳ vọng để đối soát cuối job.
Điều cần nhớ là URL trong sitemap cũng phải đi qua cùng hàm khóa. Sitemap thường ghi URL chuẩn có gạch chéo cuối, còn link trong trang thì không. Nếu khóa của hai nguồn khác nhau, mỗi trang sẽ bị đẩy hai lần và đối soát sẽ lệch đúng bằng số trang.
Thứ tự trong queue là FIFO
InMemoryQueueStorage lấy request theo thứ tự vào trước ra trước. Với một luồng, việc duyệt gần giống tìm kiếm theo chiều rộng: trang gần trang chủ được tải trước. Với bốn luồng, thứ tự hoàn thành xáo trộn nhưng thứ tự lấy ra vẫn theo FIFO.
Điều này có lợi khi job bị dừng giữa chừng: phần đã tải nghiêng về các trang gần gốc, thường là trang quan trọng hơn. Nếu cần ưu tiên khác, ví dụ trang sản phẩm trước trang tin, phải viết storage riêng có hàng ưu tiên.
Ai giữ tập khóa
Trong lab, tập khóa nằm trong bộ nhớ tiến trình. Khi crawler chạy lại sau khi dừng, tập khóa mất. Với job dài, cần storage bền như Redis hay SQLite cho cả queue lẫn tập khóa. Colly có các gói storage bên ngoài cho queue, nhưng tập khóa do mình tự thêm thì mình tự lưu.
Chạy queue trên đồ thị có vòng, ghi số lượt fetch với Colly collector và hàng đợi crawl
Kết quả dưới đây lấy từ năm lần chạy liên tiếp ngày 03/11/2026, cùng máy, cùng chương trình.
Bảng đo trên đồ thị 40 trang
Cấu hình |
Gọi AddURL |
Queue đầy |
Lượt tải |
Trang /p/i đạt |
Queue lớn nhất |
Kết thúc |
|---|---|---|---|---|---|---|
A: đẩy mọi link, MaxSize 100.000 |
2.613 đến 2.626 |
0 |
201 đến 203 |
40/40 |
896 đến 931 |
Có, 0,05 đến 0,09 s |
B: đẩy mọi link, MaxSize 50 |
1.989 đến 2.288 |
1.462 đến 1.647 |
153 đến 176 |
40/40 |
50 |
Có |
C: khóa riêng rồi mới đẩy, MaxSize 50 |
81 |
0 |
81 |
40/40 |
24 đến 25 |
Có, 0,01 đến 0,02 s |
Đọc dòng A
Cấu hình A gọi AddURL hơn 2.600 lần cho một website 40 trang. Queue có lúc giữ hơn 900 request chờ. Collector tải 201 URL khác nhau theo cách nhìn của nó, trong khi máy chủ chỉ nhận 161 request-URI khác nhau.
Khoảng chênh 40 chính là các biến thể #top. Colly coi /p/j#top là URL mới, tải lại, nhưng trình duyệt hay máy chủ không gửi fragment đi. Kết quả là 40 lượt tải thừa cho cùng tài nguyên.
Một vài lần tải trùng do chạy song song
Ở hai trong năm lần chạy, cấu hình A tải 202 hoặc 203 lượt cho 201 URL. Tức là có một hai URL bị tải hai lần dù kho đã thăm đang bật. Mình chưa truy tận gốc, nhưng giải thích hợp lý nhất là hai luồng cùng kiểm tra kho trước khi một luồng kịp ghi lại.
Không nên dựa vào kho đã thăm của Collector như một khóa chặt khi chạy nhiều luồng. Hàm khóa trước khi đẩy vào queue đóng vai trò chặn sớm, và cấu hình C không có lần tải trùng nào trong năm lần chạy.
Đọc dòng B
Khi MaxSize còn 50, queue từ chối từ 1.462 đến 1.647 lần thêm. Nếu không đếm lỗi, mình sẽ không biết. Lần này vẫn đạt 40/40 trang vì mỗi trang có tới ba đường vào cùng nhiều biến thể, mất một bản vẫn còn bản khác.
Trên website thưa link, như trang chi tiết chỉ có một đường vào từ trang danh sách, cùng mức rơi request này sẽ làm mất trang thật. Con số dao động giữa các lần chạy cũng cho thấy việc mất trang phụ thuộc thời điểm, rất khó tái hiện khi gỡ lỗi.
Đọc dòng C
Khóa trước khi đẩy làm số lần AddURL bằng đúng số URL cần tải: 81. Queue không bao giờ quá 25 request chờ. Không có lần nào queue đầy dù MaxSize chỉ 50. Máy chủ nhận đúng 81 request cho 81 URL khác nhau.
Thời gian chạy giảm từ khoảng 0,07 giây xuống 0,01 giây trên máy cục bộ. Trên mạng thật, mỗi lượt tải thừa là vài trăm mili giây và một phần quota của website đích, nên mức tiết kiệm lớn hơn nhiều.
Nhật ký mẫu một lần chạy
A naive AddURL, MaxSize 100000  add=2613 full=0 fetched=201 uniq_url=201 maxQ=909 finished=true 0.08s
B naive AddURL, MaxSize 50      add=2093 full=1467 fetched=161 uniq_url=161 maxQ=50 finished=true 0.05s
C canon+dedupe truoc AddURL     add=81 full=0 fetched=81 uniq_url=81 maxQ=24 finished=true 0.01s
Đối soát số URL duy nhất và điều kiện queue kết thúc trong Colly collector và hàng đợi crawl
Đồ thị có vòng mà không có link sinh vô hạn thì queue nào cũng dừng. Phần này thử bẫy lịch để xem giới hạn nào thật sự có tác dụng.
Bảng đo với bẫy lịch
Cấu hình |
Lượt tải |
Kết thúc |
|---|---|---|
D: AddURL, MaxDepth 3 |
24.800 đến 31.035 trong 5 giây |
Không, bị cắt bởi hẹn giờ |
E: AddRequest với Depth cộng 1, MaxDepth 3 |
33 |
Có |
F: AddURL, MaxRequests 200 |
99 |
Có |
MaxDepth không có tác dụng với AddURL
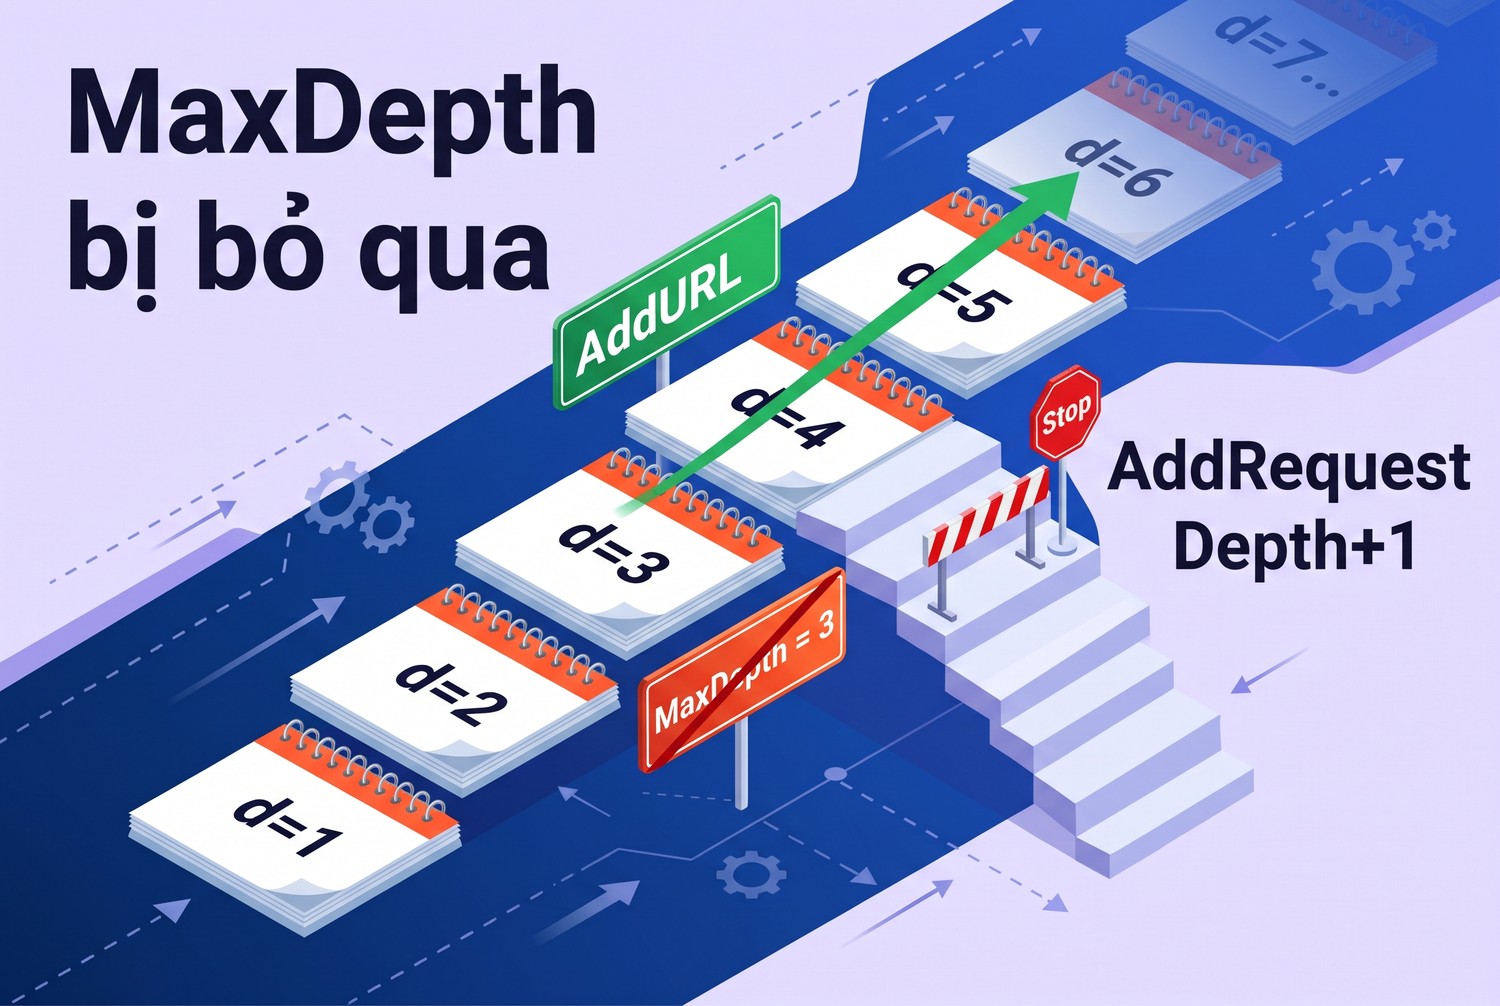
MaxDepth bị bỏ qua
Cấu hình D đặt MaxDepth bằng 3 nhưng vẫn tải hơn 24.000 trang lịch trong 5 giây và còn tải tiếp nếu mình không dừng. Đọc mã queue.go sẽ thấy lý do: AddURL tạo Request mới với Depth bằng 0. Mọi URL thêm theo cách này đều ở độ sâu 0, không bao giờ vượt MaxDepth.
Đây là chỗ khác với Request.Visit, hàm tự cộng 1 vào độ sâu. Ai chuyển từ e.Request.Visit sang q.AddURL để có queue sẽ mất luôn giới hạn độ sâu mà không nhận ra.
Sửa bằng AddRequest mang độ sâu
u, _ := url.Parse(abs)
q.AddRequest(&colly.Request{
    URL: u, Method: "GET",
    Depth: e.Request.Depth + 1,
})
Cấu hình E dùng đúng cách này. Queue tải 33 trang và kết thúc. Bẫy lịch bị cắt ở độ sâu 3, phần đồ thị trong tầm 3 bước từ trang chủ vẫn được tải.
MaxRequests đếm gấp đôi khi dùng queue
Cấu hình F đặt MaxRequests 200 nhưng chỉ tải 99 trang. Mã colly.go cho thấy bộ đếm requestCount tăng một lần khi queue giải tuần tự hóa request, và tăng thêm một lần khi Collector tạo request để tải. Mỗi lượt đi qua queue tiêu hai đơn vị.
Hệ quả: MaxRequests với queue là một trần thô, không phải số trang. Muốn trần chính xác, tự đếm số URL đã đẩy vào queue trong hàm khóa và ngừng đẩy khi đạt ngưỡng.
Điều kiện kết thúc của Run
Hàm loop trong queue.go chỉ trả về khi storage rỗng và không còn request đang chạy, hoặc khi Stop được gọi. Nếu luôn có link mới được đẩy vào, Run không bao giờ trả về. Không có cơ chế hẹn giờ có sẵn.
Lab bọc Run trong một goroutine, chờ tối đa 20 giây với đồ thị và 5 giây với bẫy, quá thời gian thì gọi Stop. Trong job thật, nên có cả hẹn giờ tổng và trần số trang, ghi rõ trong nhật ký lý do dừng.
Đối soát ba con số
Sau mỗi lần chạy, ghi ba con số: số khóa duy nhất đã đẩy, số lượt Collector tải, số request máy chủ nhận nếu đo được. Với cấu hình C cả ba bằng 81. Khi ba số lệch nhau, đó là tín hiệu có khóa sai hoặc có tải trùng.
Với website thật, mình không đếm được phía máy chủ. Thay vào đó, so số khóa duy nhất với số dòng dữ liệu đầu ra và số mã băm nội dung khác nhau. Bài lấy tất cả URL của website có cách lấy danh sách URL kỳ vọng từ sitemap để đối chiếu.
Nhật ký nên ghi gì
Mỗi dòng nhật ký một request nên có: khóa URL, URL gốc trước khi chuẩn hóa, độ sâu, trang cha, mã trạng thái, kích thước, thời gian. Khi có tải trùng hay mất trang, trang cha cho biết link đến từ đâu, độ sâu cho biết giới hạn nào đã cắt nó.
Đầu ra nghiệm thu: Colly collector và hàng đợi crawl với fixture, số URL duy nhất và nhật ký kết thúc
Phần này gom lại những gì cần bàn giao và khi nào cần tới proxy.
Bộ bàn giao tối thiểu
Thứ nhất là fixture đồ thị có vòng, có biến thể URL và có bẫy vô hạn, để chạy lại mỗi lần sửa crawler. Thứ hai là bảng số: số khóa duy nhất, số lượt tải, số lần queue đầy, kích thước queue lớn nhất. Thứ ba là dòng nhật ký cuối ghi queue kết thúc vì rỗng hay vì chạm giới hạn nào.
Ba thứ này giúp người khác kiểm lại kết quả mà không cần tin lời người viết crawler.
Giới hạn của lab
Lab chạy trên máy chủ cục bộ, độ trễ gần bằng 0. Trên mạng thật, thứ tự hoàn thành của bốn luồng sẽ khác, số lần queue đầy cũng khác. Lab chỉ dùng InMemoryQueueStorage, chưa thử storage Redis. Lab không bật robots.txt và không đặt giới hạn tốc độ.
Những con số tải trùng ở cấu hình A chỉ quan sát được hai trong năm lần, nên mình xem đó là hiện tượng có thật nhưng hiếm. Mình chưa đo trên website lớn.
Chạy lại sau khi dừng
Job dài nào cũng có lúc dừng giữa chừng: máy khởi động lại, mạng rớt, người vận hành bấm dừng. Khi chạy lại, cần ba thứ còn nguyên: queue chưa xử lý, tập khóa đã đẩy và tập URL đã tải xong. Mất một trong ba thì hoặc tải lại từ đầu, hoặc bỏ sót phần đang dở.
Cách đơn giản là ghi tập khóa và trạng thái từng khóa vào SQLite, mỗi khóa một dòng với cột trạng thái chờ, đang tải, xong, lỗi. Khi khởi động, nạp các khóa ở trạng thái chờ và đang tải vào queue. Bảng này cũng chính là nhật ký đối soát cuối job.
Giới hạn tốc độ vẫn cần thiết
Queue với bốn luồng có thể bắn bốn request cùng lúc vào một website. Colly có LimitRule với Delay, RandomDelay và Parallelism theo mẫu tên miền. Nên đặt quy tắc này cho mọi website ngoài, không chỉ khi bị chặn. Bài rate limit API khi dùng proxy có cách tính nhịp gọi hợp lý.
Khi nào cần proxy cho Colly collector và hàng đợi crawl
Proxy không giải quyết vấn đề nào trong bài: không khử trùng URL, không làm queue dừng. Proxy chỉ cần khi máy chạy crawler nằm sau mạng công ty bắt buộc đi qua proxy, hoặc khi đội cần một IP thoát cố định để website đối tác đưa vào danh sách cho phép.
Cách khai báo proxy trong Colly và chuỗi proxy có xác thực đã có trong bài Golang proxy và bài định dạng proxy. Với queue chạy lâu, proxy tĩnh dễ đối soát hơn proxy xoay vì nhật ký có một IP thoát duy nhất. Anh em cần IP thoát tại Việt Nam cho job crawl có thể mua proxy tĩnh Việt Nam ở trang chủ ProxyVN, chọn HTTP hoặc SOCKS5 tùy thư viện.
Proxy không thay quyền truy cập
Đổi IP không cho thêm quyền với website. Điều khoản sử dụng, robots.txt và giới hạn tốc độ vẫn giữ nguyên giá trị. Bài Web Scraping proxy là gì phân biệt các vai trò hợp lệ của proxy khi thu dữ liệu.
Checklist Colly collector và hàng đợi crawl
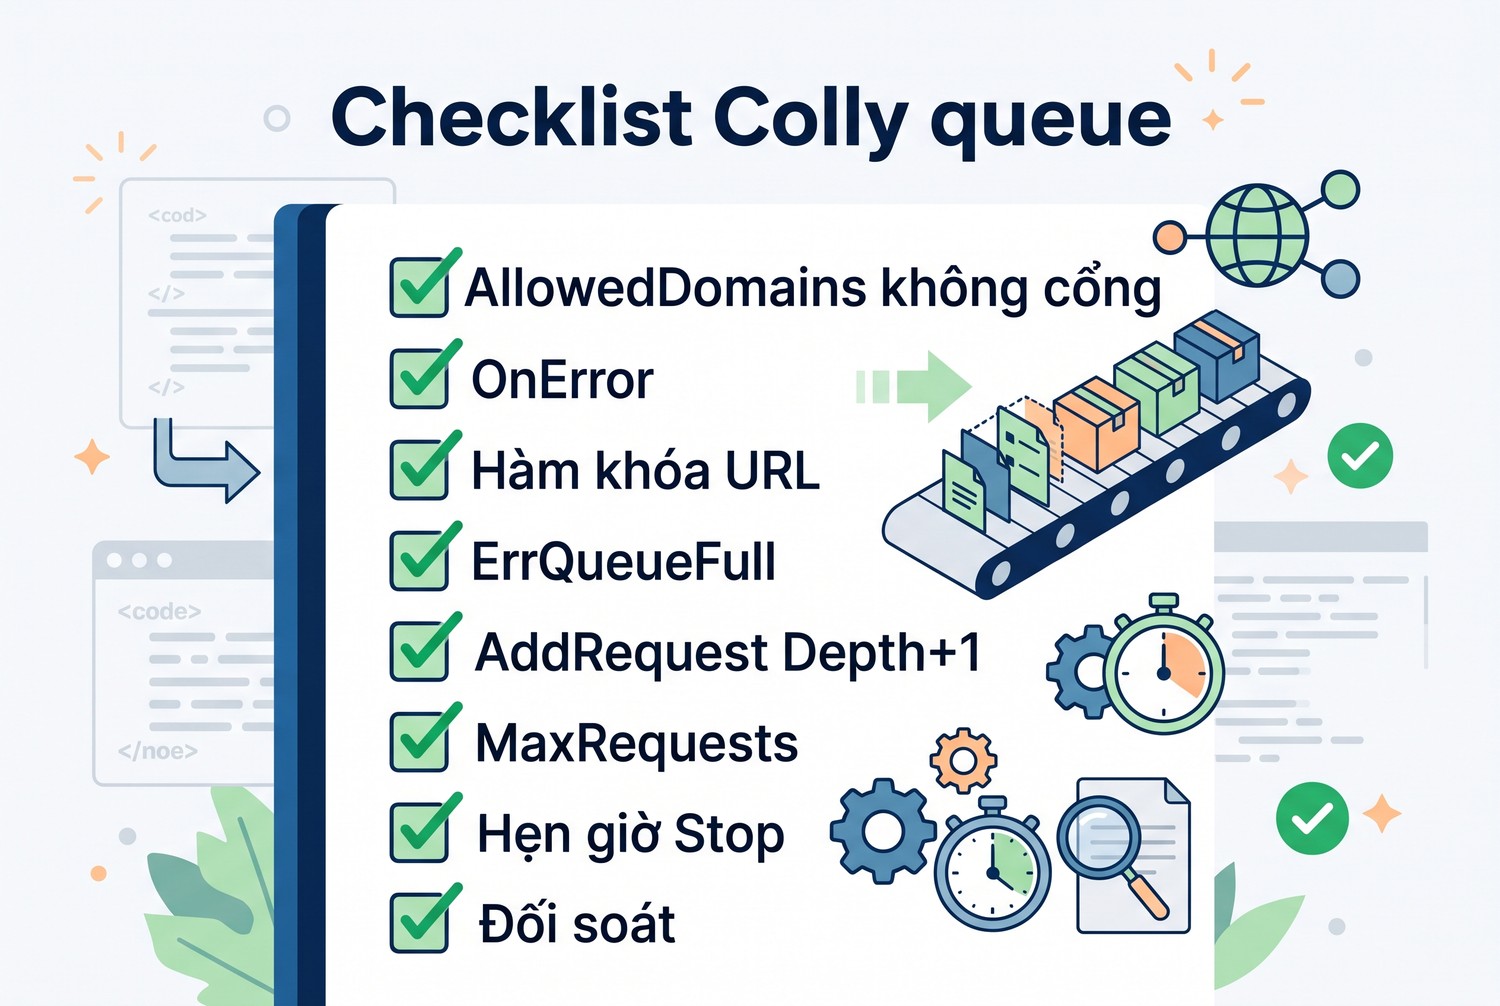
Checklist Colly queue
- AllowedDomains ghi tên máy không kèm cổng, có OnError đếm lỗi.
- Hàm khóa URL bỏ fragment, xử lý gạch chéo cuối và tham số theo đúng website.
- Khóa trước khi gọi AddURL, không trông vào kho đã thăm để chặn phình queue.
- Kiểm lỗi ErrQueueFull, đếm số request bị bỏ.
- Dùng AddRequest với Depth cộng 1 nếu cần MaxDepth.
- Không xem MaxRequests là số trang khi dùng queue.
- Có hẹn giờ tổng và Stop, ghi lý do dừng vào nhật ký.
- Đối soát số khóa, số lượt tải và số dòng đầu ra.
Câu hỏi thường gặp về Colly collector và hàng đợi crawl
Queue của Colly có tự bỏ URL trùng không?
Không. Queue nhận mọi request. Collector chỉ chặn tải lại khi lấy ra, nên queue vẫn phình. Lab đẩy hơn 2.600 lần cho 40 trang.
Vì sao /p/3 và /p/3#top bị tải hai lần?
Hàm AbsoluteURL giữ fragment khi href có đường dẫn, nên mã băm URL khác nhau. Bỏ fragment trong hàm khóa của mình.
Vì sao MaxDepth không chặn được trang lịch?
AddURL tạo request ở độ sâu 0. Dùng AddRequest và đặt Depth bằng độ sâu trang cha cộng 1.
MaxRequests 200 sao chỉ tải 99 trang?
Bộ đếm tăng hai lần cho mỗi request đi qua queue. Tự đếm trong hàm khóa nếu cần trần chính xác.
Queue.Run khi nào trả về?
Khi storage rỗng và không còn request đang chạy, hoặc khi gọi Stop. Không có hẹn giờ sẵn.
Có cần proxy để queue chạy đúng không?
Không. Proxy chỉ là đường đi của request, không ảnh hưởng khóa URL hay điều kiện dừng.
Colly collector và hàng đợi crawl và những điều cần nhớ
Colly collector và hàng đợi crawl chạy ổn trên đồ thị có vòng khi anh em tự khóa URL trước khi đẩy vào queue, kiểm lỗi queue đầy và đặt độ sâu qua AddRequest. Lab ngày 03/11/2026 cho thấy 2.613 lần đẩy giảm còn 81, và bẫy lịch chỉ dừng khi độ sâu được mang theo request. Cần IP thoát ổn định cho job Colly collector và hàng đợi crawl, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


