
CKAN API bằng Python: lấy catalog dataset và resource
CKAN API bằng Python là cách đọc catalog của một cổng dữ liệu mở chạy CKAN, lấy danh sách dataset cùng các resource bên trong, rồi biết tệp nào tải được và còn mới hay không. Bài tập trung dựng bảng kê catalog, còn việc truy vấn từng hàng để dành cho bài khác. ProxyVN chạy thử ngày 29/10/2026 trên cổng Humanitarian Data Exchange và demo.ckan.org: 40 dataset, 122 resource, 12 tệp CSV kiểm bằng HEAD đều trả 200. Bài ghi lại cả những chỗ lab gặp lỗi và những gì chưa thử.
CKAN API bằng Python: mục tiêu dữ liệu, quyền và phạm vi truy cập
Trước khi viết dòng code nào, anh em cần chốt mình lấy gì từ CKAN, ai được đọc, và đầu ra cuối cùng trông ra sao.
CKAN là gì trong bức tranh dữ liệu mở
CKAN là phần mềm mã nguồn mở để dựng cổng dữ liệu. Rất nhiều cổng dữ liệu của chính phủ, tổ chức quốc tế và trường đại học chạy CKAN. Điểm chung là cùng một bộ Action API, nên code viết cho cổng này thường dùng lại được cho cổng khác.
Mỗi cổng có thể bật thêm extension riêng. Hai cổng cùng chạy CKAN vẫn có thể khác nhau ở trường metadata, cách đặt tên giấy phép và cách lưu tệp. Vì vậy bài luôn bắt đầu bằng việc hỏi chính cổng đó đang chạy phiên bản nào và có extension gì.
Đầu ra mà bài này hướng tới
Đầu ra là một bảng CSV, mỗi dòng là một resource. Cột gồm mã dataset, tên dataset, tổ chức sở hữu, giấy phép, thời điểm sửa metadata, mã resource, định dạng, URL tải, thời điểm sửa resource và kết quả kiểm HEAD.
Bảng này trả lời ba câu hỏi rất thực tế. Cổng có những tệp gì về chủ đề mình cần. Tệp nào là CSV đọc được ngay. Tệp nào còn tải được và được cập nhật gần đây.
Dataset và resource là hai tầng khác nhau
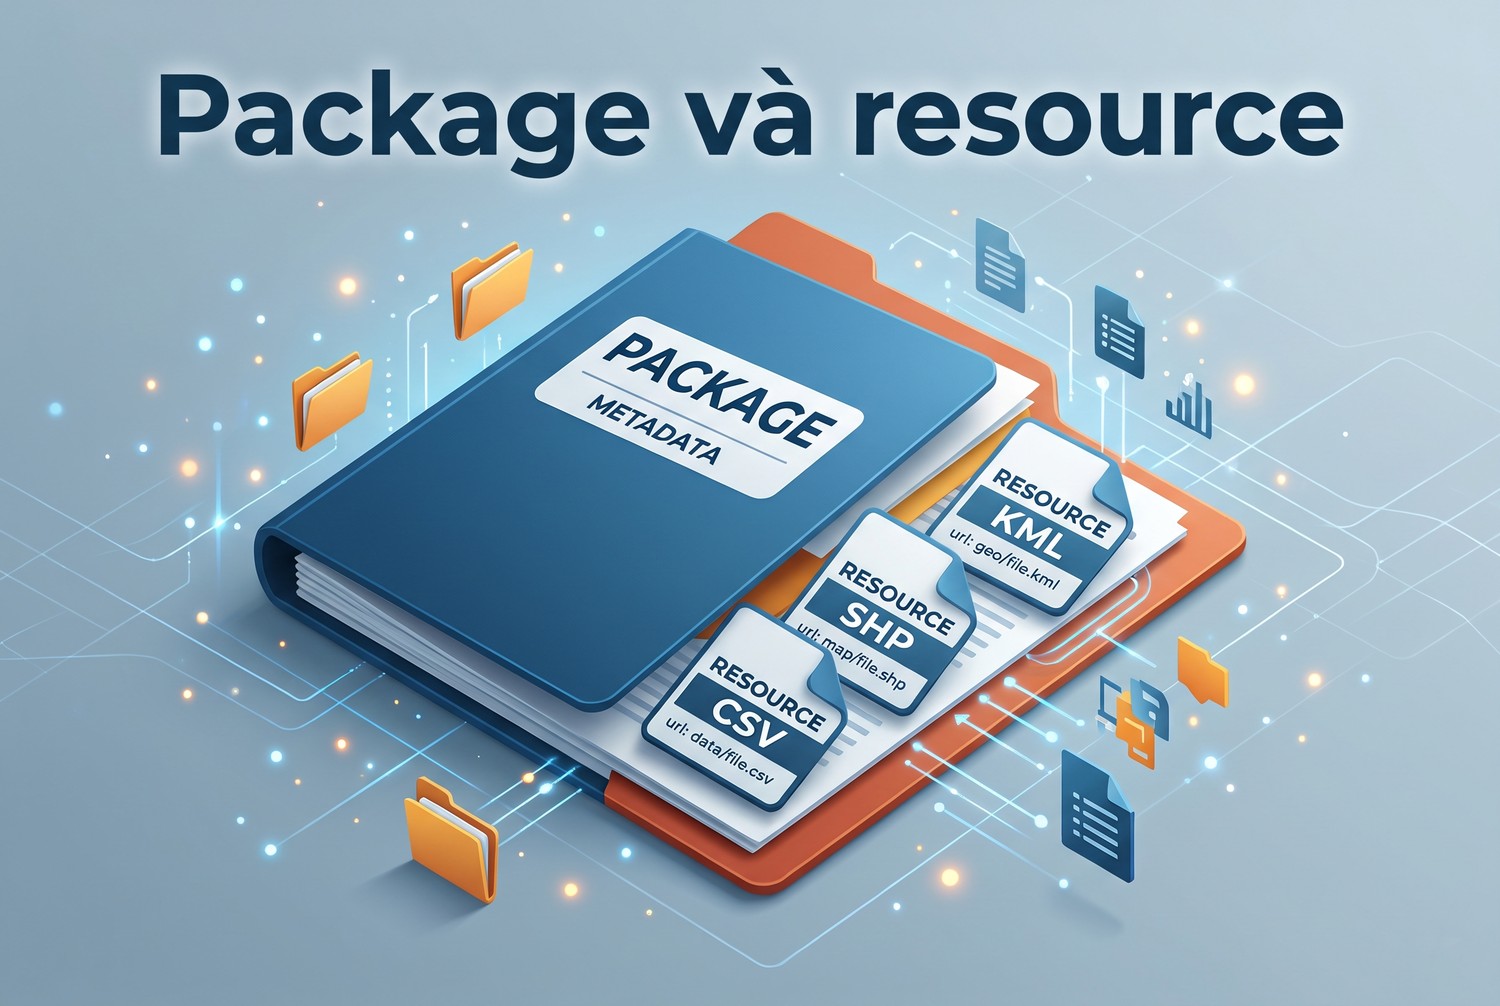
Trong CKAN, dataset được gọi là package. Package là phần metadata: tiêu đề, mô tả, tổ chức, giấy phép, thẻ, ngày cập nhật. Resource là các tệp hoặc đường dẫn nằm trong package, mỗi resource có URL, định dạng và metadata riêng.
Một package có thể không có resource nào, hoặc có hàng chục resource ở nhiều định dạng. Lỗi hay gặp là coi package là tệp dữ liệu. Package chỉ là cái bìa, dữ liệu thật nằm ở URL của từng resource.
Quyền đọc trên cổng công khai
Phần lớn cổng CKAN công khai cho phép đọc catalog mà không cần đăng nhập. Các action như package_search, package_show, resource_show đều gọi được ẩn danh với dataset công khai.
Dataset riêng tư thì khác. Package có cờ private, chỉ thành viên tổ chức có token mới thấy. Gọi ẩn danh sẽ không thấy dataset đó trong kết quả tìm kiếm, và package_show trả lỗi quyền.
Quyền ghi luôn cần token
Lab gửi thử một lệnh package_create không kèm token lên HDX. Máy chủ trả mã 403 với thông báo Authorization Error, người dùng rỗng không được tạo package. Đây là kết quả mong đợi, và là bằng chứng nhỏ rằng cổng tách bạch rõ quyền đọc với quyền ghi.
Bài này chỉ đọc. Không tạo, không sửa, không xóa bất cứ thứ gì trên cổng của người khác. Khi cần ghi lên cổng của chính tổ chức mình, anh em dùng token do quản trị viên cấp.
Giấy phép nằm ở cấp package
Trường license_id và license_title nằm trên package, áp cho mọi resource bên trong. Trong 40 package lab lấy được, có năm loại giấy phép: cc-by, cc-by-igo, hdx-other, other-pd-nr và cc-by-sa.
Bảng kê phải giữ cột giấy phép. Người dùng bảng sau này cần biết tệp nào được dùng lại thương mại, tệp nào phải ghi công, tệp nào có điều khoản riêng. Bài không tư vấn pháp lý, chỉ nhắc rằng giấy phép là dữ liệu phải mang theo.
Ranh giới với Socrata và các API truy vấn hàng
Socrata cho phép truy vấn từng hàng dữ liệu bằng SoQL ngay trên API. CKAN cốt lõi thì quản lý catalog, còn việc truy vấn hàng chỉ có khi resource được nạp vào DataStore. Hai bài cùng cụm giữ hai đầu ra khác nhau: bài này là bảng kê tệp, bài Socrata là bảng hàng dữ liệu đã lọc.
Nếu anh em cần đọc thẳng nội dung một bảng CSV trên CKAN, có hai đường. Tải tệp về rồi đọc bằng pandas, hoặc dùng datastore_search khi resource có datastore_active bằng true. Lab ghi nhận cả hai resource của gói iati-vnm đều có datastore_active bằng false. Cách nạp và truy vấn DataStore được mô tả trong tài liệu DataStore của CKAN.
Ai cần bảng kê catalog này
Nhóm nghiên cứu cần biết cổng có gì trước khi chọn nguồn. Nhóm dữ liệu cần theo dõi tệp nào vừa cập nhật để chạy lại pipeline. Nhóm kiểm định cần biết link nào đã chết để báo cho chủ cổng.
Cả ba nhu cầu đều dùng chung một bảng. Đó là lý do bài tập trung vào bảng kê thay vì tải hết dữ liệu về.
Lấy catalog dataset/resource bằng CKAN API bằng Python, tách metadata package với tệp dữ liệu và quyền resource
Package và resource
Phần này đi vào các action chính, cấu trúc response và cách tách package với resource trong code CKAN API bằng Python.
Action API phiên bản 3
CKAN gom mọi thao tác vào một đường dẫn chung là /api/3/action/ cộng tên action. Đọc thì dùng GET với tham số trên URL, ghi thì dùng POST với thân JSON. Theo tài liệu API của CKAN, mọi response đều có ba trường help, success và result.
Trường success là thứ đầu tiên code phải đọc. Khi success bằng false, result không có, thay vào đó là trường error có __type và message. Đừng chỉ dựa vào mã HTTP.
status_show để biết mình đang nói chuyện với ai
Lab gọi status_show trên ba địa chỉ. demo.ckan.org trả 200, phiên bản CKAN 2.11.5, 11 extension. data.humdata.org trả 200, phiên bản 2.11.4, 34 extension. Địa chỉ catalog.data.gov theo đường cũ trả 404 với thân JSON chỉ có Not Found.
Kết quả cuối là một bài học thực tế. Không phải cổng nào từng chạy CKAN cũng còn giữ đường /api/3/action/. Cổng có thể đổi nền tảng hoặc đặt API ở chỗ khác. Gọi status_show trước khi viết cả pipeline giúp anh em phát hiện sớm.
package_search là cửa vào catalog
package_search nhận q cho tìm kiếm toàn văn, fq cho lọc theo trường, rows cho số kết quả mỗi trang, start cho vị trí bắt đầu và sort cho thứ tự. Response có count là tổng số package khớp, và results là danh sách package kèm toàn bộ resource bên trong.
Lab tìm q bằng vietnam, lọc fq bằng res_format:CSV, sắp theo metadata_modified giảm dần. count trả 120 package, tức là có 120 dataset về Việt Nam có ít nhất một resource CSV trên HDX vào ngày chạy.
Khung code lấy catalog
import requests, time
B = "https://data.humdata.org/api/3/action/"
UA = {"User-Agent": "ProxyVN-lab/1.0 (lab@example.com)"}
def search(start, rows=20):
    r = requests.get(B + "package_search", headers=UA, timeout=60, params={
        "q": "vietnam", "fq": "res_format:CSV", "rows": rows,
        "start": start, "sort": "metadata_modified desc"})
    j = r.json()
    if not j.get("success"):
        raise RuntimeError(j.get("error"))
    return j["result"]
rows = []
for start in (0, 20):
    res = search(start)
    for p in res["results"]:
        for x in p.get("resources", []):
            rows.append({"package_id": p["id"], "package_name": p["name"],
                "license_id": p.get("license_id"), "resource_id": x["id"],
                "format": (x.get("format") or "").upper(), "url": x.get("url")})
    time.sleep(1)
Code đọc success trước, rồi mới đọc result. Mỗi resource thành một dòng, mang theo mã và giấy phép của package cha.
Tách metadata package với metadata resource
Package có metadata_modified, là lúc ai đó sửa phần mô tả. Resource có last_modified, là lúc tệp được tải lên lại, và metadata_modified riêng của resource. Ba mốc thời gian này khác nhau và dễ bị nhầm.
Khi theo dõi dữ liệu mới, mốc đáng tin nhất là last_modified của resource. Sửa một dấu phẩy trong mô tả package cũng làm metadata_modified đổi, dù tệp dữ liệu không đổi gì.
Trường url_type nói tệp nằm ở đâu
url_type bằng upload nghĩa là tệp được tải lên kho của chính cổng. url_type rỗng thường nghĩa là resource chỉ là đường dẫn tới máy chủ khác. Hai resource của gói iati-vnm trong lab đều là upload, có size và hash MD5 đi kèm.
Resource trỏ ra ngoài thì cổng không kiểm soát được. Link có thể chết, có thể chuyển hướng, có thể đổi nội dung mà metadata vẫn giữ nguyên. Đây là lý do bảng kê cần bước kiểm HEAD riêng.
Quyền của từng resource
Resource thừa kế quyền của package. Package công khai thì resource công khai, package riêng tư thì resource riêng tư. CKAN cốt lõi không có quyền riêng cho từng resource.
Nhưng URL tải có thể có lớp kiểm soát khác. Một số cổng dùng kho lưu trữ đám mây với URL ký số có hạn dùng. Một số resource trỏ ra máy chủ đòi đăng nhập. Metadata ghi công khai không có nghĩa tệp tải được không cần quyền.
resource_show cho từng tệp
Khi đã có resource_id, gọi resource_show để lấy metadata đầy đủ của riêng resource đó. Trên HDX, response có 25 trường, trong đó có download_url, size, hash, mimetype, position và các trường riêng của HDX như hdx_rel_url hay microdata.
Các trường riêng của từng cổng là chỗ code dễ gãy khi chuyển sang cổng khác. Bảng kê chỉ nên dựa vào các trường cốt lõi: id, package_id, format, url, last_modified, size, mimetype.
Chuẩn bị truy vấn, ID, token và phiên bản API khi dùng CKAN API bằng Python
Phần này gom các quyết định nhỏ trước khi chạy thật: tên hay mã, cú pháp lọc, token, phiên bản và định danh request.
Dùng id hay name
Mỗi package có id dạng UUID và name dạng chuỗi ngắn như iati-vnm. Cả hai đều gọi được package_show. Name đọc dễ hơn nhưng có thể đổi khi chủ dataset đổi tên. Id không bao giờ đổi.
Bảng kê nên giữ cả hai, nhưng khóa chính là id. Khi so sánh hai lần chạy cách nhau một tháng, dataset đổi name vẫn ghép được theo id.
Cú pháp q và fq
q là tìm kiếm toàn văn trên tiêu đề, mô tả, thẻ. fq là lọc theo trường cụ thể với cú pháp Solr, ví dụ res_format:CSV hay organization:who. Có thể ghép nhiều điều kiện fq bằng AND.
Sai cú pháp fq thường không báo lỗi mà trả count bằng 0. Thử truy vấn nhỏ với rows bằng 0 trước để xem count, rồi mới lấy dữ liệu.
Facet để xem cổng có gì
Gọi package_search với rows bằng 0 và facet.field gồm res_format và license_id. Lab nhận 277 package khớp vietnam. Facet định dạng cho thấy CSV 120, SHP 103, Geodatabase 48, GeoJSON 35, GeoTIFF 35, Geopackage 34, XLSX 27, JSON 26.
Facet là bước rẻ nhất để hiểu catalog. Chỉ một request, không tải metadata nào, mà biết ngay cổng thiên về dữ liệu địa lý hay dữ liệu bảng.
Token chỉ cần khi ghi hoặc đọc dữ liệu riêng tư
CKAN dùng API token, gửi qua header Authorization. Token được tạo trong trang cá nhân của người dùng trên cổng. Với dataset công khai, không cần token.
Không bao giờ ghi token vào code hay vào log. Đọc từ biến môi trường, và khi in cấu hình ra màn hình thì che đi. Bài này không dùng token thật nào.
Phiên bản API và phiên bản CKAN
Đường /api/3/ là phiên bản Action API, không phải phiên bản CKAN. CKAN 2.9, 2.10, 2.11 đều dùng API 3. Khác biệt nằm ở extension và ở một số tham số mới.
Ghi ckan_version từ status_show vào tệp kết quả. Khi một tham số chạy được trên cổng này mà không chạy trên cổng kia, phiên bản thường là lời giải thích đầu tiên.
Định danh bằng User-Agent
Lab đặt User-Agent ProxyVN-lab/1.0 kèm email giả [email protected]. Khi chạy thật, thay bằng tên dự án và email thật. Chủ cổng cần biết ai đang gọi để liên hệ khi có vấn đề.
Đặt User-Agent rõ ràng cũng giúp chính anh em khi đọc log của proxy hay của máy chủ trung gian. Request nào của pipeline nào nhìn là biết.
Kiểm tham số trước khi gửi
Lab gửi thử rows bằng chuỗi abc. Máy chủ trả 409 với Validation Error, rows phải là số nguyên. Đây là mã 409, không phải 400 như nhiều API khác.
Code xử lý lỗi nên đọc __type trong error thay vì chỉ đọc mã HTTP. CKAN dùng 403 cho lỗi quyền, 404 cho không tìm thấy, 409 cho lỗi kiểm dữ liệu. Bài lỗi 409 Conflict khi gọi API giải thích vì sao mã này hay bị hiểu nhầm.
Môi trường lab
Python 3.12.10, requests 2.34.2, csv và json của thư viện chuẩn. Không dùng thư viện bọc riêng như ckanapi, để thấy rõ từng request. Khi dự án lớn, ckanapi giúp code gọn hơn nhưng nên khóa phiên bản trong requirements.txt.
Thu dữ liệu có phân trang với CKAN API bằng Python
CKAN phân trang bằng start và rows. Phần này ghi kết quả chạy thật và các bẫy khi trang thay đổi giữa hai lần gọi.
Kết quả gọi thật ngày 29/10/2026
Request |
Mã |
Giây |
Kết quả |
|---|---|---|---|
status_show demo.ckan.org |
200 |
1,73 |
CKAN 2.11.5 |
status_show data.humdata.org |
200 |
2,04 |
CKAN 2.11.4 |
status_show catalog.data.gov |
404 |
0,83 |
Không có đường cũ |
package_search trang 1 |
200 |
2,09 |
20 package, 1.008.597 byte |
package_search trang 2 |
200 |
4,35 |
20 package, 639.407 byte |
package_show id sai |
404 |
1,04 |
Not Found Error |
package_search rows=1001 |
200 |
3,38 |
10.547.552 byte |
package_search rows=abc |
409 |
không ghi |
Validation Error |
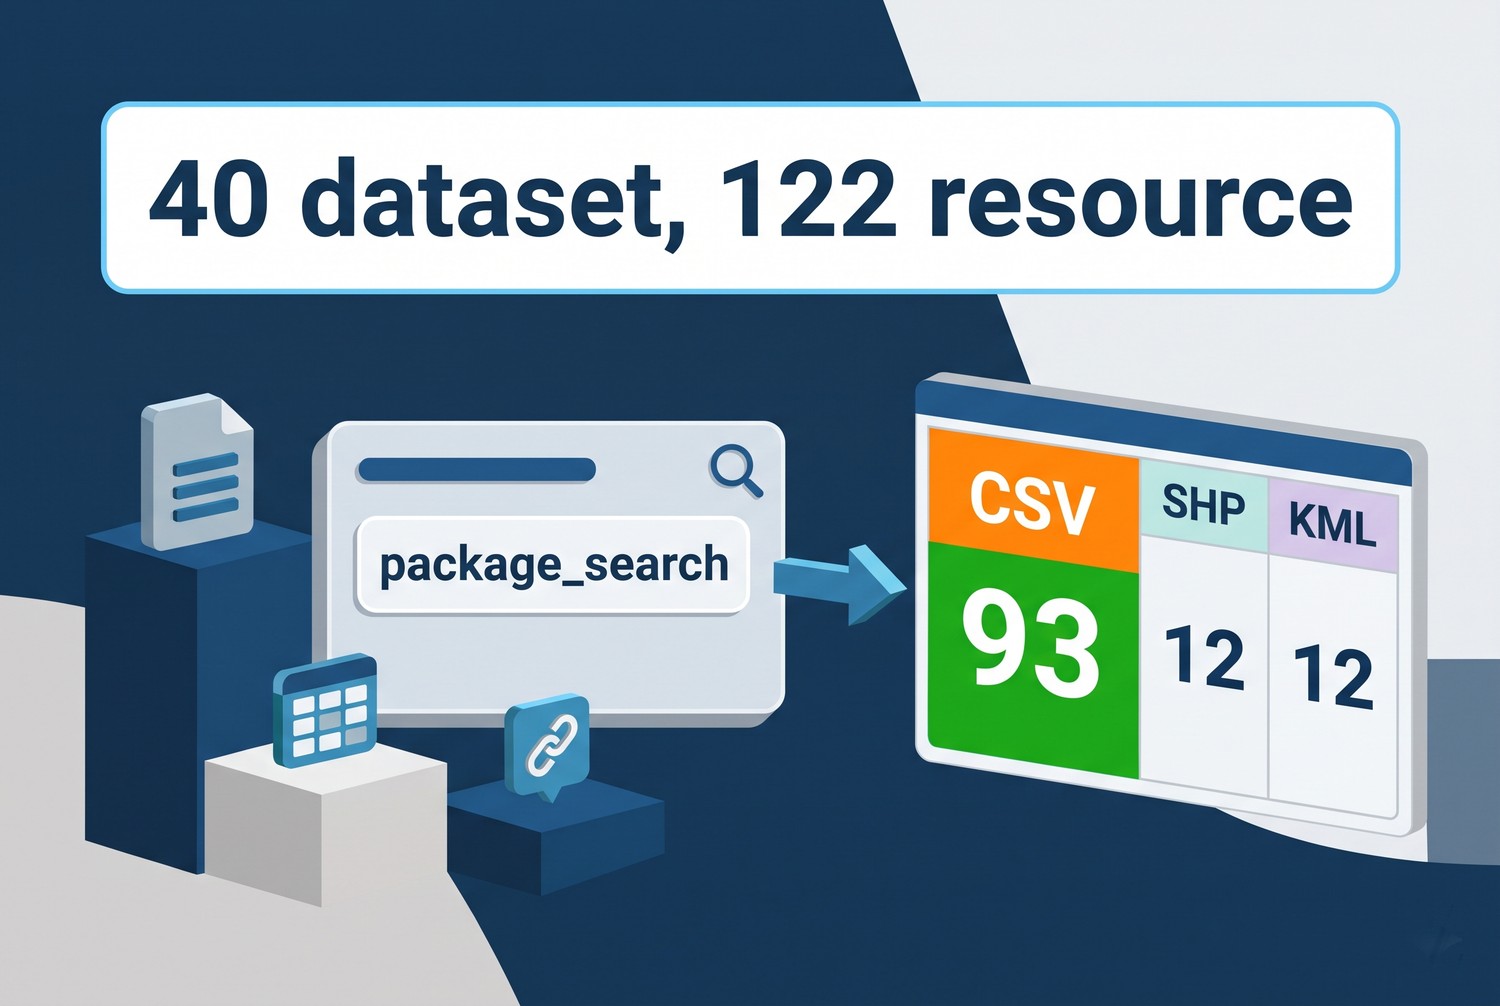
Hai trang đầu cho 40 package với 122 resource. Kích thước mỗi trang lớn vì package_search trả kèm toàn bộ metadata của mọi resource.
Phân bố định dạng trong 122 resource
40 dataset, 122 resource
Định dạng |
Số resource |
|---|---|
CSV |
93 |
SHP |
12 |
KML |
12 |
JSON |
2 |
GEOJSON |
2 |
1 |
Dù lọc fq bằng res_format:CSV, package vẫn mang theo mọi resource khác. Bộ lọc nằm ở cấp package, không ở cấp resource. Muốn chỉ lấy CSV, code phải lọc lại trong Python.
rows lớn không phải lối tắt
Lab gửi rows bằng 1001 cho truy vấn vietnam. Máy chủ trả 200 với hơn 10 MB JSON. Khi chỉ lấy hai trường id và name bằng tham số fl, cùng truy vấn trả 277 package trong khoảng 28 KB.
Tài liệu CKAN ghi giới hạn rows mặc định là 1000, cổng có thể đặt khác. Lab không xác nhận được HDX cắt ở đâu vì tổng chỉ có 277. Bài học thực tế là trang nhỏ, tuần tự và chỉ lấy trường cần.
Trang thay đổi giữa hai lần gọi
Sắp theo metadata_modified giảm dần nghĩa là package vừa sửa sẽ nhảy lên đầu. Nếu một package được sửa giữa lúc gọi trang 1 và trang 2, nó có thể xuất hiện hai lần hoặc đẩy một package khác ra khỏi tầm nhìn.
Lab gặp đúng điều này ở mức nhẹ: các gói iati được cập nhật ngay trong ngày chạy. Cách xử lý là khử trùng theo package id sau khi gom, và chạy lại trang đầu ở cuối để so count.
Sắp theo trường ổn định khi cần đầy đủ
Khi mục tiêu là kê đủ catalog chứ không phải xem cái mới nhất, sắp theo name tăng dần ổn định hơn. Name hiếm khi đổi, nên thứ tự giữa các trang ít bị xáo trộn.
Với catalog lớn, có thể chia theo tổ chức bằng fq organization rồi chạy từng tổ chức. Mỗi phần nhỏ, lỗi ở phần nào chạy lại phần đó.
Kiểm HEAD cho từng URL tải
HEAD kiểm URL
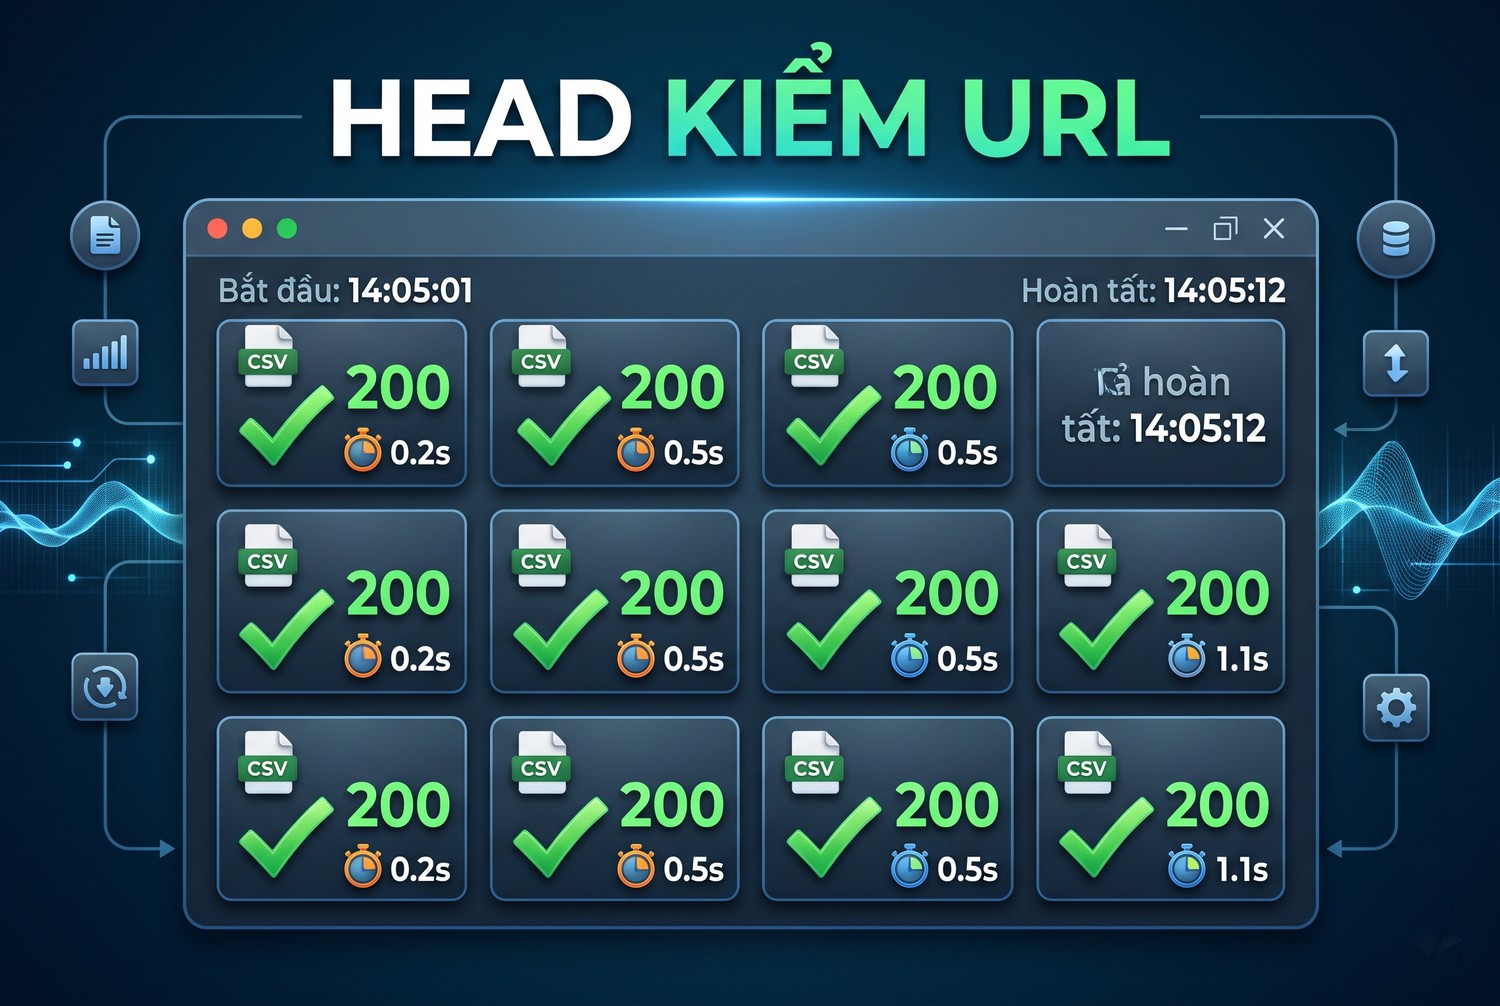
Sau khi có bảng resource, lab lấy 12 resource CSV đầu tiên và gửi HEAD tới từng URL, cho phép theo chuyển hướng, nghỉ một giây giữa hai lần. Cả 12 trả 200, Content-Type text/csv, kèm Last-Modified.
HEAD mất từ 2,62 tới 4,15 giây mỗi tệp, chậm hơn gọi API. Lý do là URL tải đi qua kho lưu trữ của cổng, có chuyển hướng trước khi tới tệp thật.
Mốc thời gian từ HEAD so với metadata
Tệp iati-activities-in-viet-nam có last_modified trong metadata là 12:34:21 ngày 29/10. Header Last-Modified từ HEAD là 12:34:22 cùng ngày. Hai mốc gần khớp, chênh một giây do thời điểm ghi tệp lên kho.
Khi hai mốc lệch xa, ví dụ metadata ghi tháng trước còn HEAD ghi hôm nay, đó là dấu hiệu tệp bị thay mà metadata không cập nhật. Bảng kê giữ cả hai cột để phát hiện chuyện này.
Không tải trọn tệp chỉ để kiểm
Hai tệp của gói iati-vnm nặng 13,9 MB và 7,7 MB theo trường size. Tải trọn chỉ để biết link còn sống là lãng phí băng thông của cả hai bên. HEAD trả đủ thông tin cần mà không tải nội dung.
Một số máy chủ không hỗ trợ HEAD và trả 405. Khi gặp, dùng GET với stream bằng true, đọc header rồi đóng kết nối ngay. Bài lỗi 405 Method Not Allowed khi crawl có mẫu xử lý.
Đối soát ID, kiểu dữ liệu, giá trị thiếu và xuất xứ trong CKAN API bằng Python
Có bảng rồi, việc tiếp theo là kiểm xem bảng có đúng và đủ không.
Khóa chính là resource id
Mỗi dòng trong bảng là một resource, nên khóa chính là resource_id. Package_id là khóa ngoại. Một package có nhiều resource thì xuất hiện nhiều dòng với cùng package_id.
Khi đếm dataset, đếm package_id khác nhau. Lab có 122 dòng nhưng chỉ 40 package_id khác nhau. Đếm nhầm số dòng thành số dataset là lỗi báo cáo rất hay gặp.
Định dạng là chuỗi tự do
Trường format do người tải lên tự nhập. Cùng là CSV có thể ghi CSV, csv, text/csv hay .csv. Lab chuẩn hóa bằng cách viết hoa toàn bộ. Với cổng khác, có thể cần thêm bảng ánh xạ.
GeoJSON trong facet ghi GeoJSON, còn trong resource sau khi viết hoa là GEOJSON. Đây là ví dụ nhỏ cho thấy cùng một khái niệm có hai cách ghi trong cùng một cổng.
Giá trị thiếu
last_modified có thể rỗng nếu resource chỉ là đường dẫn ngoài. size và hash chỉ có với tệp upload. Code lab dùng last_modified, nếu rỗng thì lấy metadata_modified của resource, và ghi rõ nguồn của mốc thời gian.
Đừng điền giá trị giả vào ô trống. Ô trống là thông tin, nó nói rằng cổng không biết hoặc không lưu trường đó.
Kiểu dữ liệu của trường ngày
Trường ngày trong metadata là chuỗi ISO không có múi giờ, ví dụ 2026-10-29T12:34:25.188851. Header Last-Modified là chuỗi theo định dạng HTTP có GMT. Hai kiểu này cần chuyển về cùng một kiểu datetime có múi giờ trước khi so sánh.
Theo hành vi phổ biến của CKAN, mốc trong metadata là giờ UTC. Lab đối chiếu với HEAD và thấy khớp với giờ GMT, củng cố giả định này cho HDX. Với cổng khác, nên kiểm lại.
Trường dataset_date của HDX
HDX có trường riêng dataset_date dạng khoảng thời gian, ví dụ từ 1998-05-01 tới 2032-01-01 cho gói iati-vnm. Đây là phạm vi thời gian dữ liệu bao phủ, không phải ngày cập nhật.
Trường riêng của cổng nên lưu ở cột phụ có tiền tố tên cổng. Khi gộp bảng từ nhiều cổng, cột phụ không làm rối các cột cốt lõi.
Giữ xuất xứ cho từng dòng
Mỗi dòng nên có URL trang dataset để người đọc mở ra kiểm. Trên CKAN, URL trang dataset có dạng địa chỉ cổng cộng /dataset/ cộng name. Bảng kê lab giữ url tải và package_name, đủ để dựng lại URL trang.
Ghi thêm thời điểm chạy, địa chỉ cổng và ckan_version vào phần đầu tệp hoặc tệp nhật ký đi kèm. Bài JSON và CSV khi crawl dữ liệu bàn khi nào nên giữ thêm JSON thô.
Hash để biết tệp có đổi không
Trường hash trên HDX là chuỗi MD5 của tệp. Khi chạy lại sau một tuần, so hash với lần trước. Hash khác nghĩa là tệp đổi, dù last_modified có thể bị ghi đè bởi lý do khác.
Không phải cổng nào cũng điền hash. Khi thiếu, có thể dùng ETag từ HEAD nếu máy chủ trả, nhưng ETag không bảo đảm là hash nội dung.
Lưu kết quả, giới hạn request và khi nào CKAN API bằng Python cần proxy
Phần cuối bàn chuyện lưu trữ, nhịp gọi và vị trí đúng của proxy với cổng dữ liệu mở.
Lưu bảng kê thành CSV
Tệp 287_resources.csv của lab có 122 dòng và 17 cột. Mỗi lần chạy nên ghi tệp mới có ngày trong tên, không ghi đè tệp cũ. So sánh hai tệp liền nhau là cách đơn giản nhất để thấy resource mới, resource bị xóa và tệp vừa đổi.
Nhịp gọi tôn trọng cổng
Tài liệu CKAN không đặt một giới hạn request chung, vì mỗi cổng tự cấu hình. Lab nghỉ một giây giữa các request API và giữa các HEAD. Với catalog vài trăm dataset, toàn bộ quá trình chạy vài phút.
Cổng dữ liệu mở thường do tổ chức công hoặc phi lợi nhuận vận hành, tài nguyên có hạn. Chạy tuần tự, cache kết quả, làm mới theo ngày hoặc theo tuần là đủ cho phần lớn nhu cầu. Bài rate limit API khi dùng proxy có mẫu bộ đếm request.
Khi nhận 429 hay 503
Lab không gặp 429 hay 503 trong ngày chạy. Nếu gặp, đọc header Retry-After nếu có, chờ đúng thời gian đó rồi thử lại, và giảm nhịp cho phần còn lại của job.
Không chia request qua nhiều IP để vượt giới hạn của cổng. Giới hạn là quyết định của chủ cổng, lẩn tránh nó là hành vi sai.
Proxy trong lab kiểm ở đâu
Lab chạy proxy HTTP có xác thực và proxy SOCKS5 cục bộ, rồi gọi status_show của HDX qua từng loại. Mục đích là xác định proxy nằm ở tầng tải, không phải tăng hạn mức.
Cách gọi |
Kết quả |
Proxy thấy gì |
|---|---|---|
Proxy HTTP có xác thực |
200 sau 1,47 giây |
CONNECT data.humdata.org:443 |
Proxy SOCKS5h |
200 sau 1,31 giây |
Tên miền data.humdata.org, cổng 443 |
Proxy HTTP sai mật khẩu |
ProxyError |
Request bị từ chối ở proxy |
Với HTTPS, proxy HTTP chỉ thấy tên máy và cổng trong lệnh CONNECT. Đường dẫn action và tham số truy vấn nằm trong kênh mã hóa. Proxy SOCKS5h nhận tên miền thay vì IP, nên phân giải DNS diễn ra ở phía proxy.
Sai mật khẩu proxy khác với lỗi API
Khi mật khẩu proxy sai, requests ném ProxyError trước khi request tới được CKAN. Đây không phải lỗi của cổng. Code nên bắt ProxyError riêng để log rõ lỗi nằm ở tầng mạng, tránh ghi nhầm là cổng chết.
Bài requests.exceptions.ProxyError liệt kê các nguyên nhân thường gặp của lỗi này.
Khi nào cần proxy thật
Proxy cần khi máy chạy pipeline nằm trong mạng nội bộ chỉ được ra Internet qua proxy. Trường hợp thứ hai là tổ chức yêu cầu lưu lượng ra ngoài đi qua một IP cố định để giám sát, và để chủ cổng đưa IP đó vào danh sách cho phép.
Cấu hình proxy và cách mã hóa mật khẩu có ký tự đặc biệt có trong bài định dạng proxy. Bài Web Scraping proxy là gì phân biệt các vai trò của proxy trong thu thập dữ liệu.
Khi máy chủ của nhóm đặt tại Việt Nam và cần một IP thoát ổn định, proxy tĩnh dễ quản lý hơn proxy xoay. ProxyVN có proxy dân cư tĩnh, datacenter, 4G và proxy xoay qua HTTP hoặc SOCKS5. Anh em có thể mua proxy Việt Nam tại trang chủ ProxyVN rồi khai báo vào requests theo tham số proxies.
Giới hạn suy luận của bài
Số liệu đến từ một lần chạy ngày 29/10/2026 trên HDX và demo.ckan.org, không phải mọi cổng CKAN. Lab chỉ kiểm HEAD 12 tệp CSV đầu tiên, không kiểm đủ 93 tệp. Lab không xác định được giới hạn rows thật của HDX vì tổng kết quả nhỏ hơn 1000.
Lab không dùng token, không đọc dataset riêng tư, không thử datastore_search vì hai resource được xem kỹ đều không có DataStore. Lab không thử proxy thương mại, chỉ proxy cục bộ dùng chung IP thoát với máy lab.
Checklist CKAN API bằng Python
Checklist CKAN API
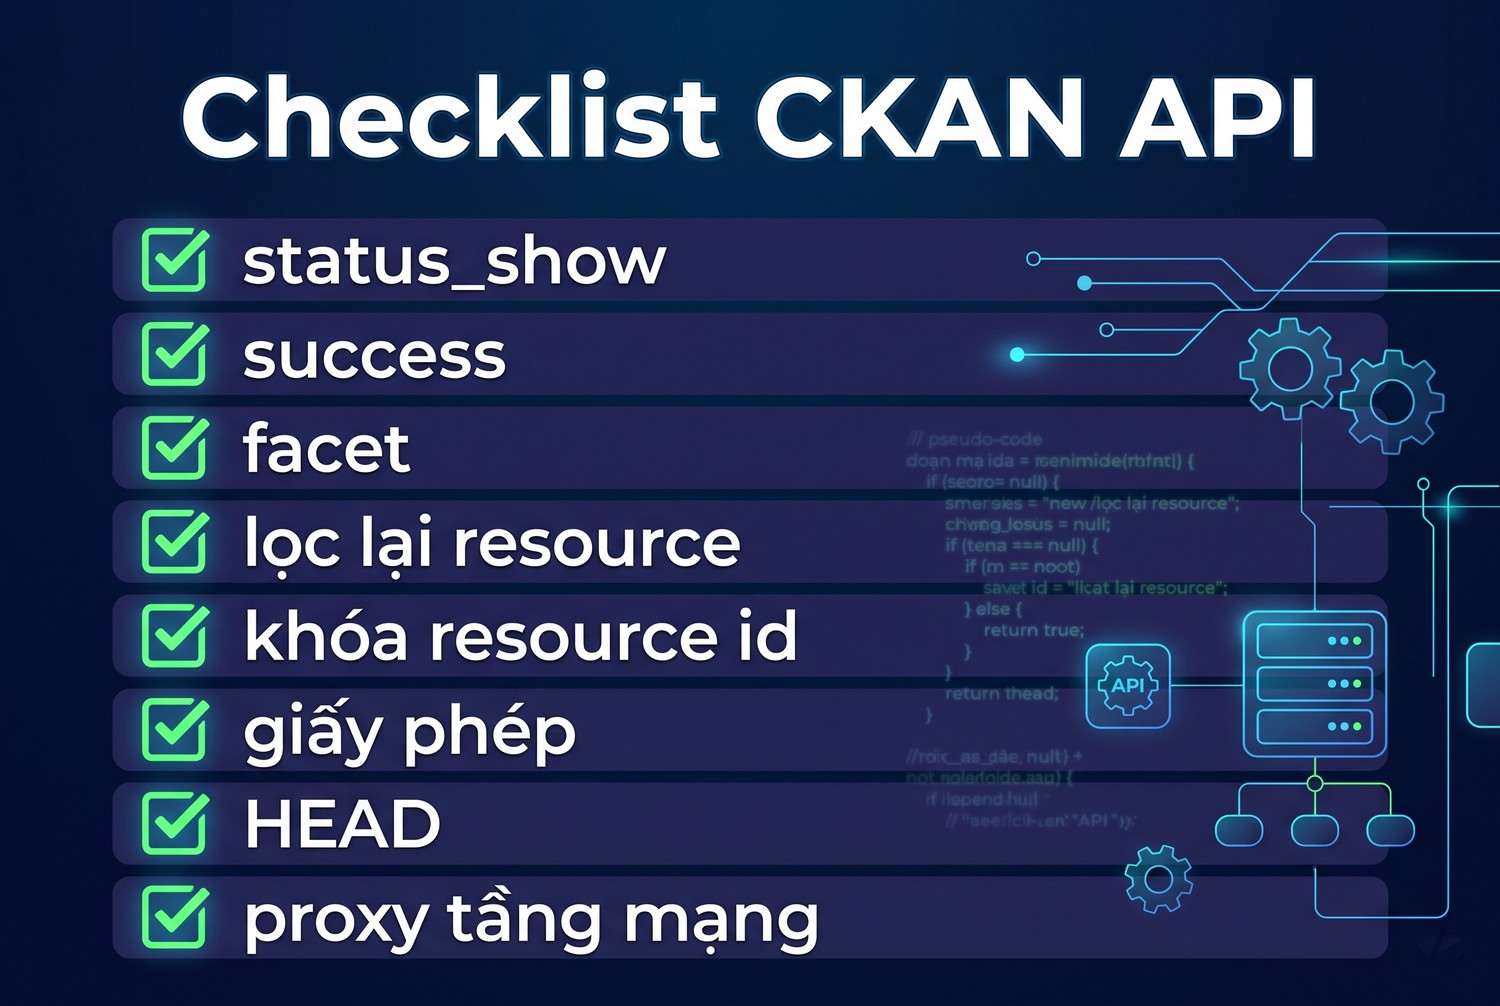
- Gọi status_show trước để biết phiên bản và extension.
- Đọc success trước khi đọc result.
- Dùng facet với rows bằng 0 để xem catalog có gì.
- Nhớ fq lọc ở cấp package, phải lọc lại resource trong Python.
- Khóa chính là resource id, đếm dataset bằng package id.
- Giữ giấy phép, mốc thời gian và URL cho từng dòng.
- Kiểm URL bằng HEAD, nghỉ giữa các lần gọi.
- Proxy chỉ ở tầng mạng, không dùng để vượt giới hạn.
Câu hỏi thường gặp về CKAN API bằng Python
CKAN có cần khóa API để đọc không?
Không, với dataset công khai. Token chỉ cần khi ghi hoặc đọc dataset riêng tư của tổ chức mình.
Vì sao lọc res_format:CSV vẫn ra tệp SHP?
Vì bộ lọc chọn package có ít nhất một resource CSV, rồi trả mọi resource của package đó. Lọc lại theo format trong Python.
Package và resource khác nhau thế nào?
Package là metadata của dataset. Resource là tệp hay đường dẫn bên trong package. Dữ liệu thật nằm ở URL của resource.
Mã 409 từ CKAN nghĩa là gì?
Thường là Validation Error, tham số không hợp lệ. Đọc trường error để biết tham số nào sai.
Có đọc được từng hàng dữ liệu qua CKAN không?
Chỉ khi resource đã được nạp vào DataStore, khi đó dùng datastore_search. Nếu không, tải tệp về và đọc bằng pandas.
Code này dùng cho cổng CKAN khác được không?
Phần lớn được, vì Action API giống nhau. Kiểm status_show trước và chỉ dựa vào các trường cốt lõi.
CKAN API bằng Python và những điều cần nhớ
CKAN API bằng Python cho anh em bảng kê catalog: package nào có resource gì, định dạng gì, giấy phép gì và tệp còn tải được không. Lab ngày 29/10/2026 lấy 40 dataset, 122 resource từ HDX, kiểm HEAD 12 tệp CSV đều trả 200. Nhớ tách package với resource, lọc lại định dạng trong Python và tôn trọng nhịp của cổng. Cần IP thoát cố định cho pipeline chạy CKAN API bằng Python, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


