
Celery quản lý tác vụ crawl: idempotent, retry và deadline
Celery quản lý tác vụ crawl là cách chia danh sách URL thành từng job nhỏ, đẩy vào hàng đợi rồi để nhiều worker cùng lấy ra xử lý, có thử lại khi lỗi. Phần khó không nằm ở chỗ chạy được, mà ở chỗ một job bị gửi hai lần hay bị thử lại năm lần vẫn không ghi dữ liệu hai lần. ProxyVN dựng lab Celery 5.6.3 với hai worker, một proxy HTTP có xác thực và một trang đích cố tình trả 503, gửi 23 job trong đó 7 job trùng chủ đích để kiểm từng thiết lập.
Celery quản lý tác vụ crawl: tác vụ cụ thể và ranh giới với bài đã có
Bài này giải một bài toán: crawler có hàng nghìn URL, chạy trên vài máy, cần thử lại khi trang đích bận mà không tạo bản ghi trùng. Celery là thư viện Python phân phối tác vụ qua một broker, thường là Redis hoặc RabbitMQ. Mỗi URL thành một task, worker lấy task, gọi request qua proxy, ghi kết quả.
Celery giải phần nào của crawler
Celery lo ba việc. Thứ nhất là xếp hàng: URL được đẩy vào broker và nằm đó cho tới khi có worker rảnh. Thứ hai là phân phối: nhiều worker trên nhiều máy cùng lấy từ một hàng, không cần tự viết khóa. Thứ ba là thử lại: task có thể tự đặt lịch chạy lại sau một khoảng chờ.
Celery không lo phần tải trang, phần chọn proxy hay phần chống trùng dữ liệu. Ba việc đó vẫn là mã của anh em bên trong task. Celery chỉ đảm bảo task được giao cho worker, không đảm bảo task chạy đúng một lần.
Hàng đợi job khác bể proxy
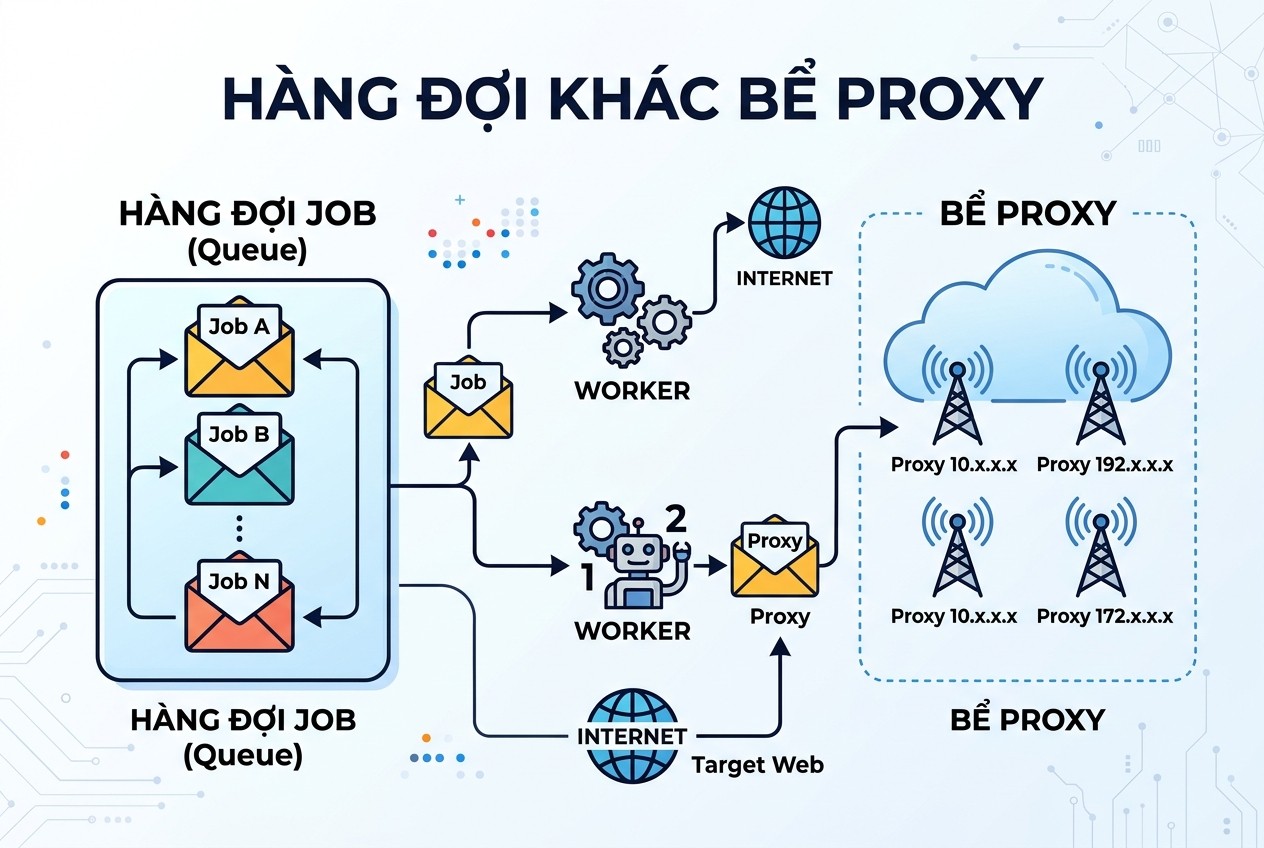
Hàng đợi khác bể proxy
Hai khái niệm này hay bị gộp. Hàng đợi job là danh sách việc cần làm. Bể proxy là danh sách đường đi ra Internet. Một job có thể đi qua bất kỳ proxy nào, một proxy có thể phục vụ nhiều job.
Nếu gắn cứng mỗi worker với một proxy, khi proxy đó chậm thì cả worker chậm theo, và job xếp trong hàng của worker đó cũng chờ. Tách hai thứ ra cho phép đổi proxy mà không đổi hàng đợi, thêm worker mà không cần thêm proxy.
Celery quyết định ai làm job, còn bể proxy quyết định job đi đường nào. Bài Redis quản lý proxy xoay hướng dẫn phần cấp và thu hồi proxy. Bài này chỉ nói phần hàng đợi job.
Số worker nên tính theo proxy hay theo CPU
Task crawl chủ yếu chờ mạng, nên CPU ít khi là giới hạn. Giới hạn thật thường là số kết nối đồng thời mà proxy và trang đích chịu được. Một proxy cho phép 50 kết nối đồng thời thì 200 worker cùng dùng proxy đó chỉ làm tăng lỗi kết nối và 429.
Cách tính hợp lý là bắt đầu từ số kết nối cho phép của bể proxy, trừ đi phần dư an toàn, rồi chia cho số máy chạy worker. Bài 1 proxy chạy được bao nhiêu luồng có cách đo con số này cho từng loại proxy.
Với pool prefork trên Linux, mỗi tiến trình con giữ một task một lúc. Muốn nhiều task chờ mạng cùng lúc mà không tốn nhiều bộ nhớ, Celery có pool gevent hoặc eventlet. Hai pool này cần thư viện HTTP tương thích, requests chạy được sau khi vá thư viện chuẩn.
Ranh giới với Airflow
Bài proxy Apache Airflow nói về lập lịch pipeline theo DAG: chạy lúc mấy giờ, bước nào sau bước nào. Airflow phù hợp cho pipeline vài chục bước chạy theo lịch. Celery phù hợp cho hàng nghìn task nhỏ giống nhau chạy song song. Hai công cụ có thể dùng cùng nhau: Airflow gọi một bước đẩy URL vào Celery.
Tách worker và hàng đợi khỏi bể IP, task crawl idempotent và retry có deadline với Celery quản lý tác vụ crawl
Phần này đi qua ba nguyên tắc thiết kế trước khi viết dòng cấu hình nào. Thiếu một trong ba, lab bên dưới sẽ cho ra bản ghi trùng hoặc task thử lại mãi.
Task phải idempotent
Idempotent nghĩa là chạy một lần hay chạy nhiều lần cho cùng kết quả. Với crawler, điều này nghĩa là task tải cùng một URL hai lần chỉ để lại một bản ghi trong cơ sở dữ liệu.
Tài liệu task của Celery nói rõ khi bật acks_late, task có thể được chạy lại nếu worker chết giữa chừng, nên task cần idempotent. Thực tế còn nhiều nguồn trùng khác: hệ thống gửi task bị lỗi mạng rồi gửi lại, người vận hành chạy lại lô, hai lô có URL chồng nhau.
Có hai lớp chống trùng nên dùng cùng lúc. Lớp đầu là kiểm trước khi làm: job đã có kết quả thì bỏ qua, không tốn request qua proxy. Lớp hai là ràng buộc trong cơ sở dữ liệu: khóa chính theo mã job, ghi bằng câu lệnh bỏ qua khi trùng. Lớp đầu tiết kiệm, lớp hai mới thật sự chặn.
Mã job phải ổn định
Mã job nên sinh từ nội dung việc cần làm, ví dụ băm URL đã chuẩn hóa cộng ngày crawl. Nếu mỗi lần gửi tạo mã ngẫu nhiên, hai lần gửi cùng URL sẽ thành hai job khác nhau và lớp chống trùng không nhận ra.
Mã task trong Celery khác mã job. Celery cấp mã task cho mỗi lần gửi, và mã task giữ nguyên qua các lần thử lại. Trong lab, mã job là p1, f1, còn mã task là p1-a, p1-b cho hai lần gửi.
Chuẩn hóa URL trước khi băm
Hai URL trông khác nhau có thể trỏ cùng một trang: chữ hoa và chữ thường trong tên miền, dấu gạch chéo cuối, tham số theo dõi như utm_source, thứ tự tham số khác nhau. Nếu băm thẳng URL gốc, hai biến thể sẽ thành hai job và crawler tải trang hai lần.
Quy tắc chuẩn hóa tối thiểu gồm: hạ chữ thường phần tên miền, bỏ cổng mặc định, bỏ phần sau dấu thăng, bỏ tham số theo dõi, sắp xếp tham số còn lại. Quy tắc này nên nằm ở một hàm duy nhất mà cả bên gửi job và bên kiểm trùng cùng gọi.
Ngày crawl đưa vào mã job khi anh em muốn tải lại cùng trang theo chu kỳ. Lô hôm nay và lô ngày mai cho cùng URL sẽ có mã khác nhau, còn hai lần gửi trong cùng một ngày vẫn trùng mã.
Retry phải có hạn
Celery có hai giới hạn thử lại: max_retries đếm số lần, và deadline do anh em tự kiểm theo thời gian. Chỉ có max_retries thì task với khoảng chờ tăng dần có thể kéo dài rất lâu sau khi lô đã không còn cần kết quả.
Cách làm trong lab là truyền thời điểm hết hạn của cả lô vào task. Trước mỗi lần thử, task so thời gian hiện tại cộng khoảng chờ sắp tới với deadline. Nếu vượt, task dừng và ghi lý do, không đặt lịch thử lại nữa.
Theo hướng dẫn gọi task, Celery có tham số expires khi gửi task, nhưng tham số này chỉ chặn task chưa bắt đầu. Task đang trong chuỗi thử lại vẫn có thể chạy quá hạn. Kiểm deadline trong mã task là cách chắc hơn.
Thử lại mã nào
Không phải mã lỗi nào cũng nên thử lại. 503 và 429 là trang đích bận hoặc giới hạn tốc độ, thử lại sau một lúc có thể thành công. 404 và 410 là trang không có, thử lại chỉ tốn request. 407 là sai thông tin proxy, thử lại không đổi gì cho tới khi sửa cấu hình.
Bài lỗi 429 khi dùng proxy và rate limit API khi dùng proxy có cách đọc header Retry-After. Task Celery nên dùng giá trị này làm khoảng chờ nếu trang đích có gửi.
Chuẩn bị phiên bản, thông tin proxy và môi trường thử cho Celery quản lý tác vụ crawl
Lab chạy ngày 29/10/2026 trên Windows 10, Python 3.12.10, Celery 5.6.3, Kombu 5.6.2, requests 2.34.2 trong một môi trường ảo riêng. Mọi thành phần chạy trên 127.0.0.1.
Broker không cần Redis
Máy lab không có Redis hay RabbitMQ. Kombu, thư viện truyền tin của Celery, có transport filesystem dùng thư mục làm hàng đợi: mỗi message là một tệp JSON, worker khóa tệp khi lấy. Trên Windows, transport này cần gói pywin32 để khóa tệp.
Transport filesystem chỉ phù hợp để thử. Khi chạy thật nhiều máy, dùng Redis hoặc RabbitMQ. Các thiết lập về task, retry và idempotent trong bài giữ nguyên khi đổi broker.
Celery trên Windows
Celery không hỗ trợ chính thức Windows từ phiên bản 4. Lab chạy worker với --pool=solo, tức mỗi worker xử lý một task một lúc trong tiến trình chính. Hai worker solo cho hai task song song. Máy chủ Linux nên dùng pool prefork mặc định.
Ba thành phần phụ
Trang đích lab ở cổng 9471 có ba loại đường dẫn: /p/số trả 200 sau 0,2 giây, /flaky/số trả 503 cho hai lần gọi đầu rồi 200, /down/số luôn trả 503. Proxy HTTP lab ở cổng 9472 yêu cầu Basic auth, ghi log mỗi request đã xác thực.
Cơ sở dữ liệu kết quả là SQLite với hai bảng: pages có khóa chính job_id, attempts ghi mọi lần chạy của task kèm worker, lần thử và kết quả.
Vì sao lab dùng SQLite
SQLite có sẵn trong Python, hỗ trợ khóa chính và câu lệnh ON CONFLICT DO NOTHING, đủ để chứng minh lớp chống trùng. Hai worker trên cùng máy ghi chung một tệp, SQLite tự khóa khi ghi. Với nhiều máy, thay bằng PostgreSQL hoặc MySQL, câu lệnh chống trùng có dạng tương đương.
Bảng attempts không cần cho chạy thật nhưng rất có ích khi thử. Nó cho biết mỗi job được chạy mấy lần, ở worker nào, kết quả từng lần. Khi số bản ghi không khớp số job, bảng này cho câu trả lời nhanh hơn đọc log.
Thông tin proxy không đi qua broker
Thông tin proxy nằm trong cấu hình của worker, không nằm trong tham số task. Lý do sẽ rõ ở phần đọc log: message trong broker lưu nguyên tham số task dưới dạng đọc được.
Cấu hình tối thiểu và phạm vi từng thiết lập khi dùng Celery quản lý tác vụ crawl
Toàn bộ cấu hình nằm trong một tệp tasks.py. Phần dưới rút gọn đường dẫn thư mục và hàm ghi log cho dễ đọc.
Khai báo app
from celery import Celery
app = Celery("crawl", broker="filesystem://")
app.conf.update(
    broker_transport_options={"data_folder_in": "q/in", "data_folder_out": "q/in",
                              "processed_folder": "q/proc", "store_processed": True},
    task_acks_late=True,
    worker_prefetch_multiplier=1,
    task_reject_on_worker_lost=True,
)
PROXY = {"http": "http://user1:MAT_KHAU@127.0.0.1:9472",
         "https": "http://user1:MAT_KHAU@127.0.0.1:9472"}
Ý nghĩa từng thiết lập lấy theo danh mục cấu hình Celery, đọc ngày 29/10/2026.
Thiết lập |
Giá trị lab |
Tác dụng |
|---|---|---|
task_acks_late |
True |
Xác nhận đã xong sau khi task chạy hết, không phải lúc nhận |
worker_prefetch_multiplier |
1 |
Mỗi worker chỉ giữ trước một task |
task_reject_on_worker_lost |
True |
Worker chết thì task quay lại hàng |
max_retries |
4 |
Tối đa bốn lần thử lại |
store_processed |
True |
Giữ bản sao message đã xử lý để soi trong lab |
Ba dòng đầu đi cùng nhau. acks_late cùng reject_on_worker_lost làm task không mất khi worker chết, đổi lại task có thể chạy hai lần. Prefetch bằng 1 tránh chuyện một worker ôm nhiều task trong khi worker khác rảnh, quan trọng với task crawl có thời gian rất khác nhau.
Task crawl
@app.task(bind=True, max_retries=4)
def fetch_page(self, job_id, url, deadline):
    w, n = self.request.hostname, self.request.retries
    with db() as c:
        if c.execute("SELECT 1 FROM pages WHERE job_id=?", (job_id,)).fetchone():
            log_try(job_id, w, n, "skip_da_co"); return "skip"
    if time.time() > deadline:
        log_try(job_id, w, n, "het_deadline"); return "expired"
    try:
        r = requests.get(url, proxies=PROXY, timeout=5)
    except requests.RequestException as e:
        log_try(job_id, w, n, "loi_mang"); raise self.retry(exc=e, countdown=1)
    if r.status_code in (429, 503):
        log_try(job_id, w, n, f"http_{r.status_code}")
        if time.time() + 2 ** n > deadline:
            log_try(job_id, w, n, "bo_vi_deadline"); return "gave_up"
        raise self.retry(countdown=2 ** n)
    sha = hashlib.sha256(r.content).hexdigest()[:12]
    with db() as c:
        cur = c.execute("INSERT INTO pages VALUES(?,?,?,?,?) "
                        "ON CONFLICT(job_id) DO NOTHING", (job_id, url, sha, w, time.time()))
    log_try(job_id, w, n, "ghi" if cur.rowcount == 1 else "trung_bo_qua")
Thứ tự kiểm trong task có chủ ý. Kiểm đã có kết quả trước, để job trùng không tốn request qua proxy. Kiểm deadline sau, để job hết hạn không tốn request. Chỉ khi qua cả hai mới gọi mạng.
Khoảng chờ tăng theo lũy thừa của 2: 1, 2, 4, 8 giây. Celery có sẵn retry_backoff khi dùng autoretry_for, nhưng lab viết tay để chèn bước kiểm deadline trước khi đặt lịch.
Gửi job và job trùng
dl = time.time() + 40
for jid, url in jobs:
    fetch_page.apply_async((jid, url, dl), task_id=f"{jid}-a")
for jid, url in jobs[:5] + jobs[12:14]:
    fetch_page.apply_async((jid, url, dl), task_id=f"{jid}-b")
Lô có 16 job: 12 trang thường, 3 trang chập chờn, 1 trang luôn lỗi. Bảy job được gửi lại lần hai với mã task khác, gồm năm trang thường p1 tới p5 và hai trang chập chờn f1, f2. Tổng cộng 23 task cho 16 job.
Bên gửi job cũng cần chống trùng
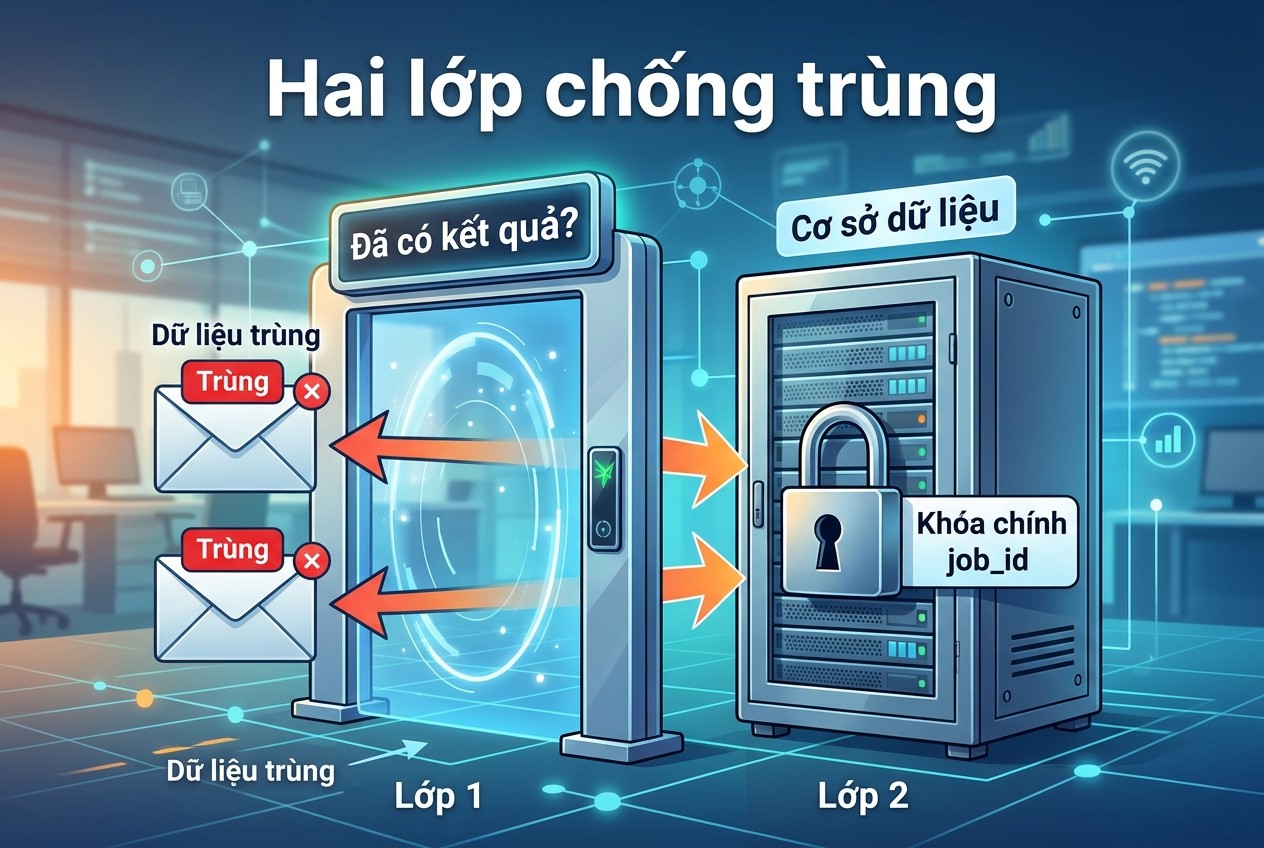
Hai lớp chống trùng
Bên gửi thường là một script đọc danh sách URL từ tệp hoặc cơ sở dữ liệu. Nếu script này chết giữa chừng rồi chạy lại từ đầu, mọi URL đã gửi sẽ được gửi lần nữa. Đây là nguồn job trùng phổ biến nhất trong thực tế, và chính là điều bảy task gửi lại trong lab mô phỏng.
Có thể giảm trùng ngay từ bên gửi bằng cách đánh dấu URL đã gửi trong cơ sở dữ liệu. Nhưng đừng dựa vào đó thay cho chống trùng trong task, vì bên gửi không biết task đã thành công hay chưa. Chống trùng ở bên gửi giảm tải, chống trùng ở task mới bảo đảm đúng.
Với lô rất lớn, gửi theo từng đợt vài nghìn task và chờ hàng đợi vơi bớt trước khi gửi tiếp. Broker giữ hàng triệu message sẽ tốn bộ nhớ và khó soi khi có sự cố.
Khởi động worker
celery -A tasks worker --pool=solo -n w1@lab -l info
celery -A tasks worker --pool=solo -n w2@lab -l info
Tên worker khác nhau để log và bảng attempts ghi được ai làm gì. Trên Linux bỏ --pool=solo và thêm --concurrency theo số tiến trình muốn chạy.
Chạy đối chứng, đọc log và kiểm output khi Celery quản lý tác vụ crawl
Hai worker khởi động, sau 8 giây script gửi 23 task, chờ 50 giây rồi dừng mọi tiến trình. Kết quả đọc từ SQLite, log worker và log proxy.
Kết quả tổng
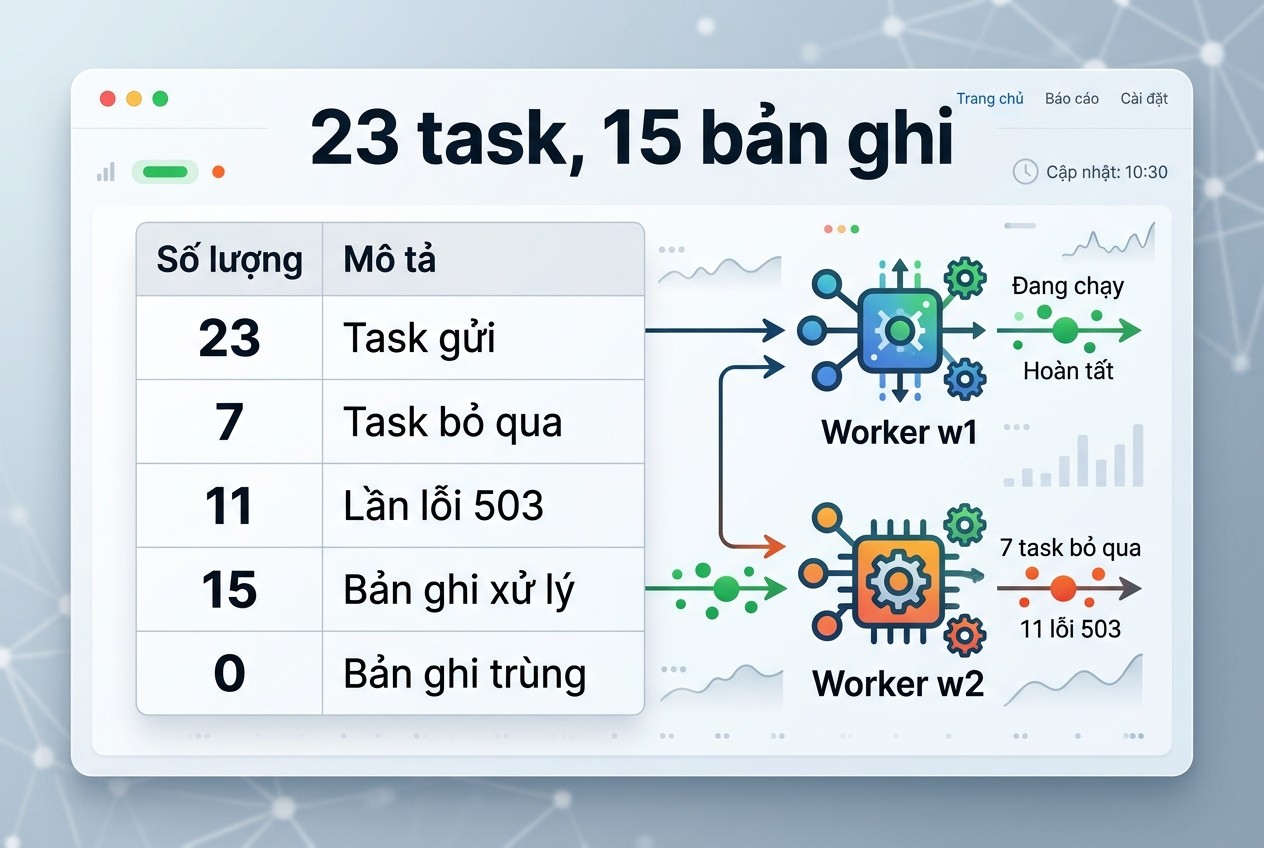
23 task, 15 bản ghi
Chỉ số |
Giá trị |
|---|---|
Task đã gửi |
23 |
Job khác nhau |
16 |
Bản ghi trong bảng pages |
15, đủ 15 job khác nhau |
Lần chạy kết quả ghi |
15 |
Lần chạy bỏ qua vì đã có |
7 |
Lần nhận 503 |
11 |
Ghi trùng bị cơ sở dữ liệu chặn |
0 |
Request đi qua proxy |
26 |
Worker w1 ghi |
6 trang |
Worker w2 ghi |
9 trang |
Mười lăm job thành công, mỗi job đúng một bản ghi. Job thứ mười sáu là down1, trang luôn lỗi, không có bản ghi nào. Bảy lần chạy trùng đều dừng ở bước kiểm đã có, không gọi mạng.
Số request qua proxy là 26, bằng 15 lần ghi cộng 11 lần nhận 503. Con số này khớp từng request với bảng attempts và chứng minh lớp kiểm đầu đã tiết kiệm 7 request.
Đọc lịch sử từng job
Job |
Lịch sử chạy (worker : lần thử : kết quả) |
|---|---|
p1 |
w1 : 0 : ghi, w2 : 0 : bỏ qua vì đã có |
p2 |
w2 : 0 : ghi, w1 : 0 : bỏ qua vì đã có |
f1 |
w1 : 0 : 503, w2 : 0 : 503, w2 : 1 : ghi, w2 : 1 : bỏ qua vì đã có |
f2 |
w1 : 0 : 503, w2 : 0 : 503, w2 : 1 : ghi, w2 : 1 : bỏ qua vì đã có |
down1 |
w1 : 0 : 503, w2 : 1 : 503, w2 : 2 : 503, w2 : 3 : 503, w2 : 4 : 503 |
Job p1 và p2 cho thấy bản trùng có thể rơi vào worker nào cũng được, kết quả vẫn một bản ghi. Job f1 và f2 là ca khó nhất: cả hai bản cùng nhận 503, cùng vào chuỗi thử lại, và ở lần thử thứ hai một bản ghi được, bản còn lại thấy đã có nên dừng.
Job down1 thử đủ năm lần với khoảng chờ 1, 2, 4, 8 giây, tổng 15 giây, chưa chạm deadline 40 giây. Lần thứ năm nhận 503, task gọi retry lần nữa và Celery ném MaxRetriesExceededError. Log worker ghi lỗi này ở mức ERROR, đúng hành vi mong muốn: job bị đánh dấu thất bại, không chạy lại mãi.
Khi nào lớp cơ sở dữ liệu ra tay
Trong lần chạy này, ghi trùng bị chặn bằng 0 vì lớp kiểm đầu đã bắt hết. Lớp cơ sở dữ liệu chỉ ra tay khi hai bản cùng qua bước kiểm trước khi bản nào kịp ghi, tức hai worker chạy cùng job gần như cùng lúc.
Với hai worker và task 0,2 giây, khoảng thời gian đó hẹp. Với hàng chục worker và trang tải chậm vài giây, nó rộng hơn nhiều. Lệnh INSERT kèm ON CONFLICT DO NOTHING là lưới an toàn cho đúng ca này, và bảng attempts sẽ ghi trung_bo_qua khi nó xảy ra.
Ca worker chết chưa được thử
Lab không giết worker giữa chừng. Theo tài liệu, khi worker chết lúc đang chạy task với acks_late, message chưa được xác nhận sẽ quay lại hàng đợi và worker khác nhận. Task sẽ chạy lại từ đầu, kể cả phần đã gọi request qua proxy.
Nếu lần chạy đầu đã ghi kết quả trước khi chết, lần chạy lại dừng ở bước kiểm đã có. Nếu chết trước khi ghi, lần chạy lại tải trang lần nữa. Cả hai trường hợp đều chỉ để lại một bản ghi nhờ hai lớp chống trùng, chỉ khác số request tiêu tốn.
Message trong broker lộ gì
Mở một tệp trong thư mục processed, phần headers có trường argsrepr chứa nguyên tham số task ở dạng chữ, ví dụ mã job, URL và deadline. Phần body là base64 của cùng tham số. Ai đọc được broker là đọc được tham số.
Đừng truyền URL proxy kèm mật khẩu làm tham số task. Trong lab, thông tin proxy nằm trong cấu hình worker nên không xuất hiện trong message. Nếu cần chọn proxy theo job, truyền mã proxy rồi để worker tra mật khẩu từ kho bí mật.
Log worker ở mức INFO cũng in argsrepr khi task lỗi, như dòng MaxRetriesExceededError của down1. Đây là lý do thứ hai để tham số task không chứa bí mật.
Ghi chú về log khởi động
Mỗi worker in cảnh báo "No hostname was supplied" khi dùng transport filesystem. Cảnh báo này đến từ URL broker không có tên máy, không ảnh hưởng chạy. Worker w1 còn in chữ recovery ở dòng khởi động vì lab chạy với acks_late, Celery báo chế độ này để người vận hành biết task có thể chạy lại.
Gỡ cấu hình thử, quản lý bí mật và checklist khi dùng Celery quản lý tác vụ crawl
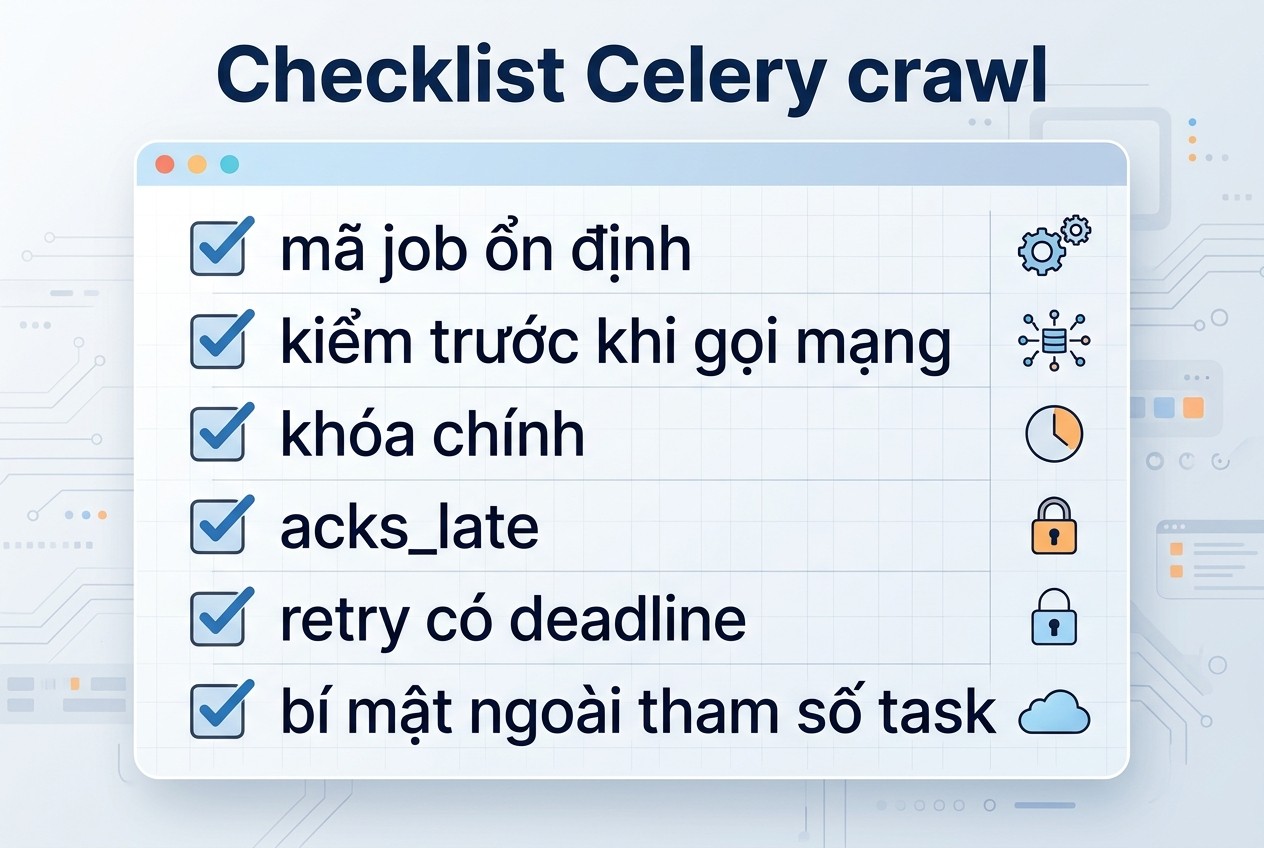
Checklist Celery crawl
Sau khi lab đạt, phần còn lại là đưa thiết kế lên môi trường thật mà không mang theo những thứ chỉ hợp cho thử nghiệm.
Thay broker và bỏ lưu message
Đổi broker sang Redis hoặc RabbitMQ, bỏ store_processed. Thư mục processed trong lab giữ mọi message đã xử lý, có ích để soi nhưng sẽ phình rất nhanh và giữ tham số task lâu hơn cần thiết.
Với Redis, chú ý visibility_timeout: task chưa được xác nhận sau khoảng này sẽ được giao lại cho worker khác. Nếu task crawl có thể chạy lâu hơn mặc định, tăng visibility_timeout cho phù hợp, nếu không sẽ có thêm bản chạy trùng ngoài ý muốn.
Quản lý thông tin proxy
Đặt thông tin proxy trong biến môi trường hoặc kho bí mật mà worker đọc khi khởi động. Không ghi vào tệp cấu hình nằm trong kho mã. Khi in log lỗi kết nối, che phần mật khẩu trong URL proxy.
Nếu có nhiều proxy, worker có thể xin một proxy cho mỗi task từ dịch vụ cấp phát riêng. Task chỉ biết mã proxy, không biết mật khẩu. Bài proxy pool là gì có cách chia proxy theo nhóm việc.
Giới hạn tốc độ theo trang đích
Celery có rate_limit theo task, nhưng giới hạn này tính trên từng worker, không phải toàn cụm. Mười worker với rate_limit 10/m cho 100 request mỗi phút. Muốn giới hạn chung cho một trang đích, cần bộ đếm dùng chung, thường là Redis.
Cách đơn giản hơn là tách hàng đợi theo trang đích và gán số worker cố định cho mỗi hàng. Trang khó tính có ít worker, trang dễ có nhiều. Celery hỗ trợ định tuyến task vào hàng khác nhau qua tham số queue khi gửi.
Theo dõi lô bằng số liệu
Mỗi lô nên có báo cáo cuối gồm: số job gửi, số job có kết quả, số job thất bại vì hết lần thử, số job bỏ vì deadline, số lần chạy trùng bị bỏ qua. Năm con số này lấy được từ bảng kết quả và bảng attempts như trong lab.
Tỷ lệ chạy trùng cao bất thường là dấu hiệu có vấn đề ở phía gửi job hoặc ở visibility_timeout. Tỷ lệ 503 cao là trang đích đang chặn hoặc quá tải, nên giảm số worker cho trang đó thay vì tăng số lần thử.
Flower là công cụ giao diện web phổ biến để xem task Celery theo thời gian thực. Nó cho thấy task đang chạy, task lỗi và tham số task. Vì Flower hiện tham số, cần đặt mật khẩu và không mở ra Internet.
Giới hạn suy luận của bài
Lab chạy trên Windows với broker filesystem và pool solo, không phải cấu hình khuyến nghị cho chạy thật. Hành vi giao lại task khi worker chết chưa được thử bằng cách giết worker giữa chừng. Thời gian và số liệu chỉ đúng cho lab này.
Proxy trong lab là proxy cục bộ, không có độ trễ mạng thật. Với proxy thật, task chạy lâu hơn và khoảng thời gian hai bản trùng cùng qua bước kiểm cũng dài hơn, làm lớp cơ sở dữ liệu quan trọng hơn.
Checklist Celery quản lý tác vụ crawl
- Mã job sinh từ URL đã chuẩn hóa, không ngẫu nhiên.
- Task kiểm đã có kết quả trước khi gọi mạng.
- Bảng kết quả có khóa chính theo mã job, ghi bằng lệnh bỏ qua khi trùng.
- Bật acks_late, reject_on_worker_lost, prefetch bằng 1.
- Thử lại chỉ với 429, 503 và lỗi mạng, có max_retries và deadline.
- Thông tin proxy nằm trong cấu hình worker, không nằm trong tham số task.
- Theo dõi số lần ghi, bỏ qua và lỗi theo từng lô.
- Đổi broker sang Redis hoặc RabbitMQ, chỉnh visibility_timeout khi lên thật.
Khi bể proxy cần IP Việt Nam ổn định cho hàng nghìn task chạy song song, ProxyVN có proxy dân cư tĩnh, datacenter, 4G và proxy xoay qua HTTP hoặc SOCKS5. Anh em có thể mua proxy tốc độ cao tại trang chủ ProxyVN rồi nạp vào cấu hình worker thay cho proxy lab.
Câu hỏi thường gặp về Celery quản lý tác vụ crawl
Có cần Celery nếu crawler chỉ chạy trên một máy?
Không bắt buộc. Một máy có thể dùng asyncio hoặc ThreadPoolExecutor kèm bảng kết quả có khóa chính. Celery có ích khi cần nhiều máy, cần hàng đợi bền khi máy khởi động lại, hoặc cần thử lại có lịch.
Scrapy có thay được Celery không?
Scrapy tự quản hàng đợi URL và thử lại trong một tiến trình. Khi cần phân tán Scrapy qua nhiều máy, người ta thường dùng scrapy-redis. Celery hợp với crawler tự viết bằng requests hoặc httpx.
Vì sao không dùng autoretry_for cho gọn?
Dùng được, kèm retry_backoff và retry_jitter. Lab viết tay để kiểm deadline trước khi đặt lịch thử lại, điều autoretry_for không làm sẵn.
Worker chết giữa chừng thì sao?
Với acks_late và reject_on_worker_lost, task quay lại hàng và worker khác chạy lại. Đây chính là lý do task phải idempotent.
Celery có tự đổi proxy khi thử lại không?
Không. Celery chỉ chạy lại task với cùng tham số. Muốn lần thử sau đi proxy khác, task phải tự xin proxy mới từ bể ở mỗi lần chạy, hoặc nhận số lần thử từ self.request.retries để chọn proxy theo thứ tự.
Có nên lưu HTML vào kết quả của Celery?
Không nên. Result backend dành cho trạng thái task, không dành cho dữ liệu lớn. Ghi HTML vào kho lưu trữ hoặc cơ sở dữ liệu riêng, task chỉ trả mã hoặc trạng thái ngắn.
Celery quản lý tác vụ crawl và những điều cần nhớ
Celery quản lý tác vụ crawl lo việc xếp hàng và chia việc, còn chống trùng và thử lại có hạn là trách nhiệm của task. Lab gửi 23 task cho 16 job, hai worker, 7 bản trùng đều dừng trước khi gọi mạng, 15 trang mỗi trang đúng một bản ghi. Cần proxy ổn định cho các worker khi triển khai Celery quản lý tác vụ crawl, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


