
arXiv API bằng Python: tìm preprint, tách ID và version
arXiv API bằng Python là cách tìm preprint khoa học qua endpoint Atom chính thức của arXiv, rồi chuẩn hóa mã bài, số phiên bản và ngày cập nhật thành bảng dữ liệu. Khác với Crossref hay OpenAlex quản lý metadata theo DOI, arXiv quản lý theo mã riêng kèm hậu tố v1, v2. ProxyVN chạy thật ngày 29/10/2026: hai trang chủ đề cs.NI có chữ proxy trả 50 preprint, 14 bài đã có bản sửa, chỉ 1 bài có DOI, và mã không version luôn trỏ về bản mới nhất.
arXiv API bằng Python: mục tiêu dữ liệu, quyền và phạm vi truy cập
Phần đầu chốt dữ liệu cần lấy, điều khoản của arXiv và ranh giới giữa bài này với các bài về metadata DOI.
Dữ liệu cần lấy
Mỗi bản ghi cần mã arXiv, số phiên bản, tiêu đề, ngày đăng bản đầu, ngày cập nhật bản hiện tại, danh mục chính, DOI nếu có và link PDF. Tám trường này đủ để làm danh sách đọc theo chủ đề hoặc theo dõi bài nào vừa có bản sửa.
Tóm tắt và danh sách tác giả cũng có trong response. Bài này không ghi chúng vào CSV mẫu để file gọn. Khi cần, anh em thêm hai trường đó vào hàm parse, cấu trúc không đổi.
Điều khoản sử dụng API
Điều khoản API của arXiv yêu cầu với các API cũ, trong đó có arXiv API, không gửi quá một request mỗi ba giây và chỉ dùng một kết nối tại một thời điểm. Đây là điều kiện để dùng dịch vụ miễn phí, không phải mẹo tối ưu.
Script lab nghỉ 3,1 giây giữa mọi request, kể cả các request thử lỗi. Chạy chậm như vậy làm hai trang mất khoảng bảy giây. Với nhu cầu theo dõi chủ đề hàng ngày, thời gian này không đáng kể.
Metadata và toàn văn là hai chuyện khác nhau
API trả metadata. PDF là toàn văn do tác giả nộp, mỗi bài có giấy phép riêng do tác giả chọn. Khi tải PDF hàng loạt, anh em cần đọc hướng dẫn dữ liệu số lượng lớn của arXiv thay vì gọi lặp link PDF.
Bài này chỉ lấy metadata qua API và lưu link PDF làm tham chiếu. Không có bước tải PDF nào trong lab.
Ranh giới với Crossref và OpenAlex
Crossref quản lý metadata theo DOI do nhà xuất bản đăng ký. OpenAlex gom nhiều nguồn và gán mã công trình riêng. Hai bài Crossref API bằng Python và OpenAlex API bằng Python đã xử lý hai nguồn đó.
arXiv khác ở chỗ một công trình có nhiều phiên bản cùng mã, và nhiều preprint chưa bao giờ có DOI. Lab cho thấy trong 50 bài mới nhất của chủ đề cs.NI có chữ proxy, chỉ 1 bài có trường DOI. Nếu chỉ khớp theo DOI, anh em sẽ bỏ sót gần hết dữ liệu arXiv.
Ranh giới với RSS
arXiv có cả RSS theo danh mục. RSS chỉ cho bài mới trong ngày, không tìm kiếm được theo từ khóa và không phân trang ngược về quá khứ. Bài thu thập RSS và Atom bằng Python bàn cách đọc feed nói chung. Bài này dùng API tìm kiếm, cũng trả về Atom nhưng có truy vấn và phân trang.
Ai cần bảng preprint
Nhóm nghiên cứu dùng bảng preprint để theo dõi công trình mới trong lĩnh vực hẹp, trước khi bài được xuất bản ở tạp chí. Nhóm kỹ thuật dùng nó để biết có thuật toán hay giao thức mới đáng thử. Nhóm nội dung dùng nó để tìm nguồn trích dẫn có ngày tháng rõ ràng.
Cả ba nhóm cần biết bài nào mới và bài nào vừa sửa. Đó là lý do bài này tập trung vào version và hai trường ngày. Một danh sách tiêu đề không có version sẽ không cho biết bài anh em đọc tuần trước đã thay đổi hay chưa.
Nhịp cập nhật của arXiv cũng phù hợp với việc chạy một lần mỗi ngày. Bài mới được công bố theo đợt trong ngày làm việc, nên chạy liên tục từng phút không mang lại thêm dữ liệu nào.
Những gì bài không làm
Bài không hướng dẫn nộp bài lên arXiv, không dùng OAI-PMH và không tải PDF. Bài cũng không hướng dẫn chia request ra nhiều IP để chạy nhanh hơn ba giây, vì điều đó vi phạm điều kiện một kết nối của arXiv.
arXiv API bằng Python: tìm preprint qua Atom, chuẩn hóa ID, version và ngày cập nhật
Phần này đi vào định dạng mã arXiv, cách version gắn vào mã, và hai trường ngày dễ nhầm.
Hai định dạng mã arXiv
Theo tài liệu định danh, mã mới có dạng YYMM.NNNNN, ví dụ 1706.03762. Mã cũ trước năm 2007 có dạng danh-mục/YYMMNNN, ví dụ hep-th/9901001. Script cần xử lý được cả hai.
Hàm parse trong lab dùng biểu thức chính quy lấy phần sau abs/ rồi tách hậu tố v kèm số ở cuối. Cách này không phụ thuộc định dạng mới hay cũ, vì version luôn nằm ở cuối mã.
Version là hậu tố, không phải trường riêng
Thẻ id trong mỗi entry có dạng http://arxiv.org/abs/2610.32254v1. Không có trường version riêng. Script phải tách 2610.32254 làm mã gốc và 1 làm số phiên bản.
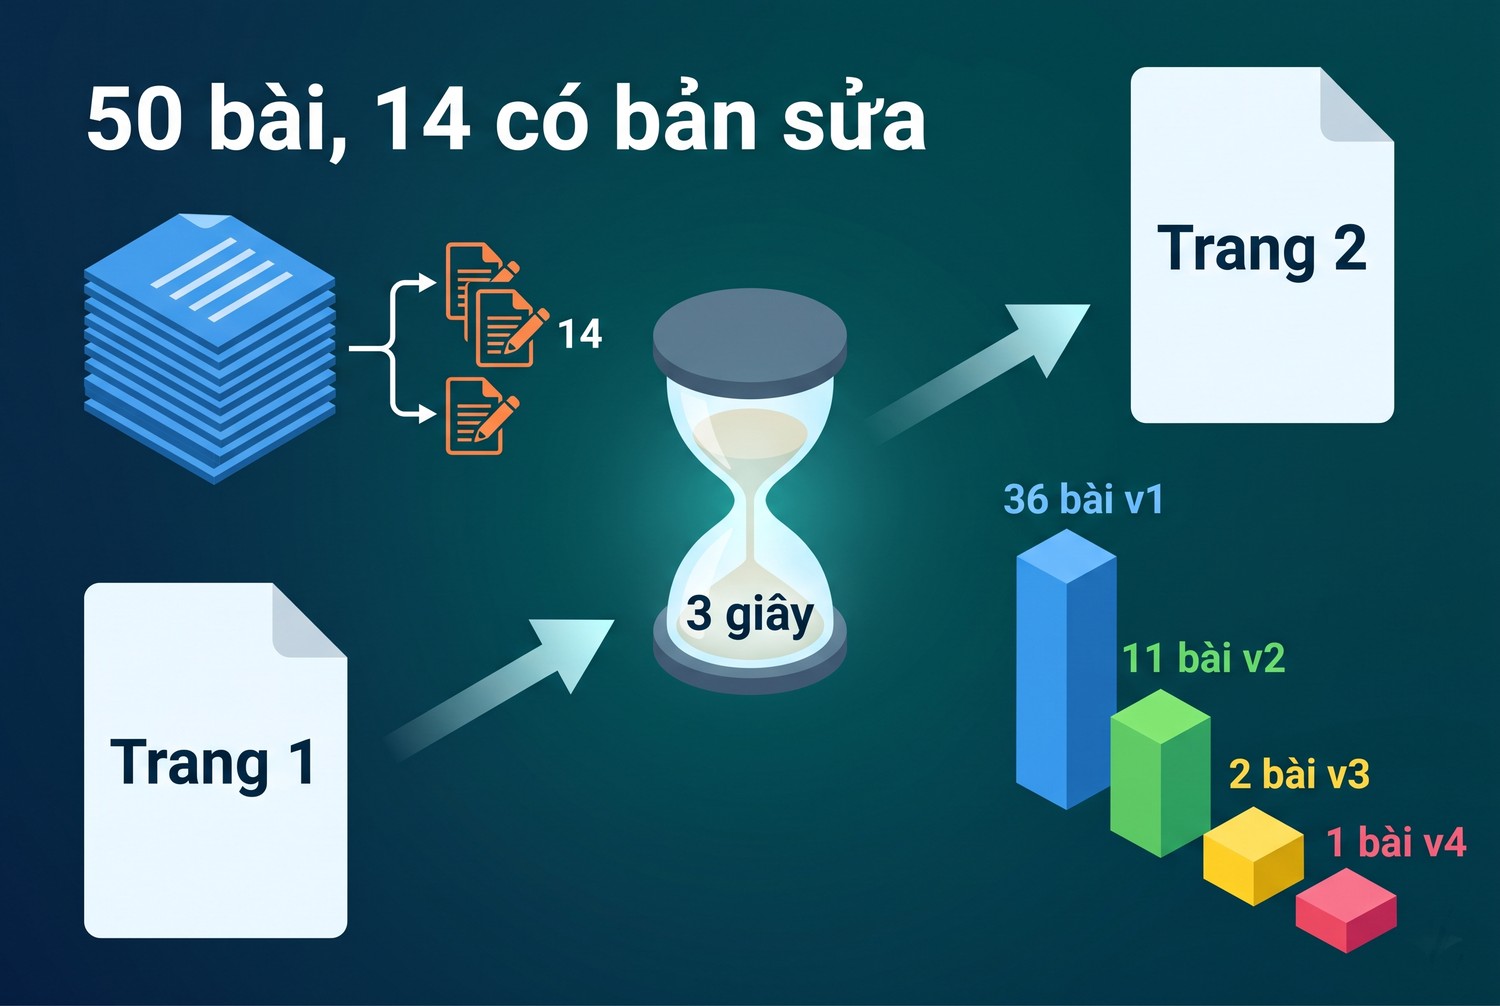
Lab đếm version của 50 bài: 36 bài v1, 11 bài v2, 2 bài v3, 1 bài v4. Như vậy gần một phần tư số bài trong mẫu đã có ít nhất một bản sửa. Nếu khóa chính là mã có version, mỗi lần tác giả sửa bài, bảng của anh em sẽ có thêm một dòng mới thay vì cập nhật dòng cũ.
published và updated
published khác updated
Trường published là thời điểm nộp bản v1. Trường updated là thời điểm của phiên bản đang trả về. Với bài chỉ có v1, hai trường bằng nhau.
Lab thấy 14 trên 50 bài có published khác updated. Trùng khớp với số bài có version từ 2 trở lên. Đây là cách kiểm nhanh để biết bài có bản sửa mà không cần gọi thêm request.
Lọc bài mới theo published, theo dõi bài vừa sửa theo updated. Đừng dùng một trường cho cả hai việc.
Mã không version trả bản nào
Mã gốc + version
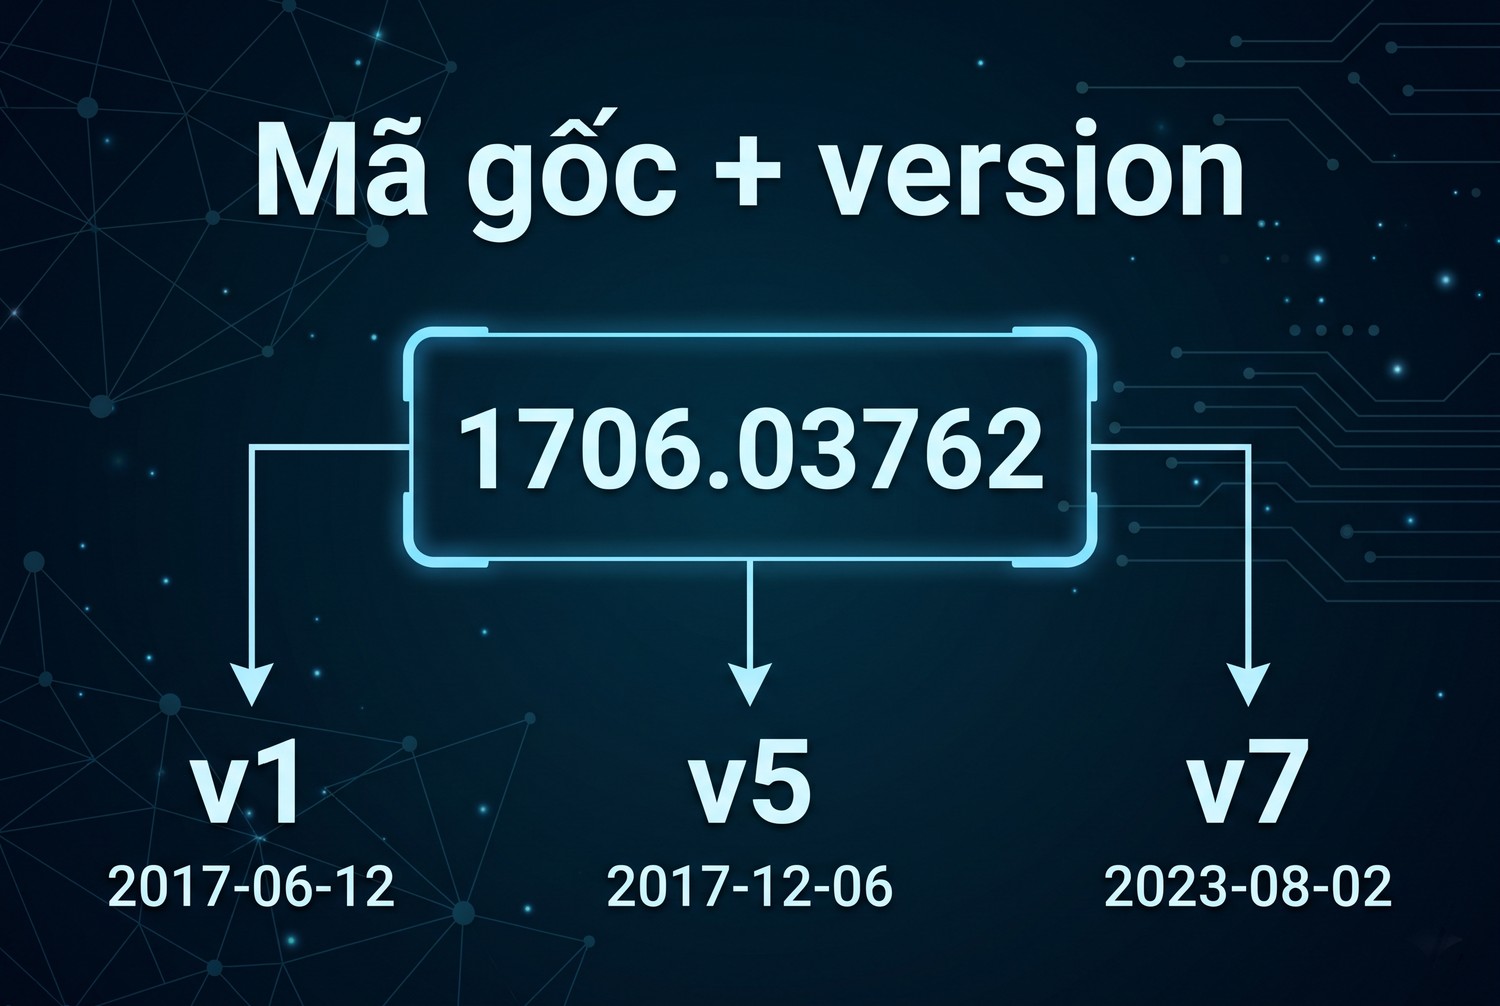
Lab gọi id_list=1706.03762, không ghi version. API trả bản v7, updated ngày 02/08/2023. Gọi id_list=1706.03762v1 trả bản v1 với updated bằng published, ngày 12/06/2017. Gọi v5 trả bản cập nhật ngày 06/12/2017.
Cả ba bản đều có cùng published. Kết luận: mã không version là con trỏ động tới bản mới nhất. Khi trích dẫn hoặc tái lập kết quả, hãy lưu mã có version.
Bảng so sánh ba lần gọi cùng một công trình
Truy vấn id_list |
Version trả về |
published |
updated |
|---|---|---|---|
1706.03762 |
7 |
2017-06-12 |
2023-08-02 |
1706.03762v1 |
1 |
2017-06-12 |
2017-06-12 |
1706.03762v5 |
5 |
2017-06-12 |
2017-12-06 |
Mã kiểu cũ và ký tự gạch chéo
Mã kiểu cũ chứa dấu gạch chéo, ví dụ hep-th/9901001v2. Khi ghi vào tên file hoặc dùng làm khóa trong hệ thống tệp, dấu gạch chéo sẽ tạo thư mục con ngoài ý muốn. Nên thay bằng dấu gạch dưới khi đặt tên file, nhưng giữ nguyên mã gốc trong dữ liệu.
Biểu thức chính quy trong lab dùng (.+?) để lấy mã, nên chấp nhận cả dấu gạch chéo. Anh em nên thử hàm parse với một mã cũ trước khi chạy truy vấn lớn, vì mẫu cs.NI mới không có mã kiểu cũ nào.
Bài bị rút và bản thay thế
Tác giả có thể rút bài bằng cách nộp một phiên bản mới ghi chú rút. Phiên bản đó vẫn có version cao hơn và vẫn xuất hiện trong API. Comment của entry thường ghi lý do rút.
Nếu dùng dữ liệu để trích dẫn, nên kiểm trường arxiv:comment có chữ withdrawn. Bài này không gặp trường hợp rút trong mẫu 50 bài, nên chỉ ghi nhận như một điểm cần kiểm khi chạy với dữ liệu lớn hơn.
Danh mục chính và danh mục phụ
Mỗi entry có arxiv:primary_category và nhiều thẻ category. Một bài chính ở cs.NI có thể gắn thêm cs.CR. Khi truy vấn cat:cs.NI, API trả cả bài có cs.NI là danh mục phụ.
Nếu báo cáo cần đếm theo danh mục chính, hãy lọc lại theo primary_category sau khi lấy dữ liệu. Lab ghi primary_category vào CSV cho mục đích đó.
Chuẩn bị truy vấn, ID và phiên bản khi dùng arXiv API bằng Python
Phần này gom cú pháp truy vấn, tham số sắp xếp, cách viết URL và những thứ không cần chuẩn bị.
Cú pháp search_query
search_query nhận tiền tố trường: ti cho tiêu đề, au cho tác giả, abs cho tóm tắt, cat cho danh mục, all cho mọi trường. Các điều kiện nối bằng AND, OR, ANDNOT. Cụm từ đặt trong dấu nháy kép.
Lab dùng cat:cs.NI AND abs:"proxy". Kết quả có totalResults là 222. So với all:proxy cho 12.748 kết quả, truy vấn có danh mục hẹp hơn gần sáu mươi lần. Thu hẹp truy vấn trước giúp anh em tốn ít request hơn nhiều.
id_list cho danh sách mã đã biết
Khi đã có danh sách mã, dùng id_list với các mã ngăn bằng dấu phẩy thay vì search_query. Có thể kết hợp cả hai, khi đó API lọc danh sách id_list theo điều kiện search_query.
Lab thử id_list=9999.99999, một mã không tồn tại. API không trả lỗi HTTP mà trả mã 200 với totalResults 0 và không có entry. Script phải kiểm số entry, không thể dựa vào mã trạng thái để biết mã có tồn tại hay không.
sortBy và sortOrder
sortBy nhận relevance, lastUpdatedDate hoặc submittedDate. sortOrder nhận ascending hoặc descending. Lab dùng submittedDate giảm dần để lấy bài mới nộp trước.
Khi phân trang qua nhiều trang, nên sắp xếp theo ngày thay vì relevance. Thứ tự theo relevance có thể đổi khi chỉ mục được cập nhật, dễ gây trùng hoặc sót ở ranh giới trang.
Lọc theo khoảng ngày nộp
search_query hỗ trợ điều kiện submittedDate theo dạng khoảng, ví dụ submittedDate:[202610010000 TO 202610292359]. Định dạng là năm, tháng, ngày, giờ, phút liền nhau, theo giờ GMT.
Điều kiện ngày giúp chạy theo lô: mỗi lần chỉ lấy bài nộp trong một ngày hoặc một tuần. Lô nhỏ ít trang hơn, ít rủi ro lỗi giữa chừng hơn và dễ chạy lại khi có sự cố. Lab chưa chạy điều kiện ngày, nên anh em cần thử cú pháp trên một khoảng nhỏ trước.
Dùng HTTPS ngay từ đầu
Tài liệu cũ ghi URL dạng http://export.arxiv.org/api/query. Lab gọi bằng http và thấy URL cuối cùng là https, nghĩa là server chuyển hướng. Mỗi request vì vậy tốn thêm một vòng kết nối.
Lab qua proxy HTTP còn cho thấy một hệ quả khác. Với URL http, proxy nhận nguyên dòng GET kèm toàn bộ tham số truy vấn trước khi bị chuyển hướng. Viết thẳng https thì proxy chỉ thấy CONNECT export.arxiv.org:443.
Không cần khóa API
arXiv API không cần đăng ký hay khóa. Điều kiện duy nhất là tôn trọng nhịp ba giây và một kết nối. Lab vẫn đặt User-Agent ProxyVN-lab/1.0 kèm email giả [email protected] để nhà vận hành biết nguồn request.
Ghi truy vấn vào cấu hình
Gom search_query, sortBy, sortOrder và max_results vào một dict. Khi đổi chủ đề, chỉ sửa dict. Ghi dict đó vào đầu file kết quả để sau này biết dữ liệu sinh ra từ truy vấn nào.
Requests tự mã hóa dấu nháy kép, dấu hai chấm và khoảng trắng trong search_query. Đừng tự ghép chuỗi URL bằng tay, vì rất dễ quên mã hóa dấu nháy và nhận về kết quả khác với dự định.
Môi trường lab
Python 3.12.10, requests 2.34.2 và xml.etree.ElementTree của thư viện chuẩn. Không cần feedparser. ElementTree đủ để đọc Atom nếu khai báo đúng ba namespace: Atom, OpenSearch và arxiv.
Thu dữ liệu có phân trang bằng arXiv API bằng Python
Phần này chạy truy vấn thật hai trang, đo thời gian, đọc ba trường OpenSearch và xuất CSV.
Script đọc Atom và tách version
50 bài, 14 có bản sửa
import re, time, requests
import xml.etree.ElementTree as ET
B = "https://export.arxiv.org/api/query"
NS = {"a": "http://www.w3.org/2005/Atom",
      "os": "http://a9.com/-/spec/opensearch/1.1/",
      "arxiv": "http://arxiv.org/schemas/atom"}
UA = {"User-Agent": "ProxyVN-lab/1.0 (lab@example.com)"}

def parse(xml):
    root = ET.fromstring(xml)
    total = int(root.findtext("os:totalResults", namespaces=NS))
    rows = []
    for e in root.findall("a:entry", NS):
        full = e.findtext("a:id", namespaces=NS)
        m = re.search(r"abs/(.+?)(v(\d+))?$", full)
        rows.append({"arxiv_id": m.group(1), "version": int(m.group(3)),
                     "published": e.findtext("a:published", namespaces=NS),
                     "updated": e.findtext("a:updated", namespaces=NS),
                     "primary": e.find("arxiv:primary_category", NS).get("term"),
                     "doi": e.findtext("arxiv:doi", namespaces=NS) or ""})
    return total, rows

q = {"search_query": 'cat:cs.NI AND abs:"proxy"', "sortBy": "submittedDate",
     "sortOrder": "descending", "max_results": 25}
out = []
for start in (0, 25):
    r = requests.get(B, params=dict(q, start=start), headers=UA, timeout=40)
    total, rows = parse(r.content)
    out += rows
    time.sleep(3.1)
Kết quả hai trang
Trang |
start |
Mã |
Giây |
Byte |
totalResults |
Số entry |
|---|---|---|---|---|---|---|
1 |
0 |
200 |
1,240 |
65.119 |
222 |
25 |
2 |
25 |
200 |
1,114 |
60.128 |
222 |
25 |
Hai trang cho 50 entry, 50 mã gốc khác nhau. Content-Type trả về là application/atom+xml. Mỗi trang nặng khoảng 60 KB vì có cả tóm tắt và tác giả, dù CSV chỉ giữ tám trường.
Đọc ba trường OpenSearch
totalResults, startIndex và itemsPerPage nằm ở cấp feed. Lab đọc được 222, 0 và 25 ở trang đầu, 222, 25 và 25 ở trang hai. Ba trường này đủ để biết còn bao nhiêu kết quả và trang hiện tại nằm ở đâu.
Với 222 kết quả và 25 bài mỗi trang, cần 9 trang để lấy hết. Ở nhịp ba giây, chín trang mất khoảng 30 giây. Có thể tăng max_results để giảm số request, nhưng response lớn hơn và mỗi request chậm hơn.
Đặt max_results hợp lý
Tài liệu cho phép max_results lớn, nhưng response với hàng trăm entry dễ chạm timeout và nặng khi parse. Lab chọn 25 cho dễ đo. Khi chạy thật, 100 tới 200 entry mỗi trang là mức cân bằng giữa số request và kích thước response.
Nếu một trang trả ít entry hơn max_results trong khi startIndex chưa tới totalResults, đó có thể là lỗi tạm thời phía server. Chờ rồi gọi lại đúng trang đó thay vì nhảy sang trang sau.
Nhịp ba giây và một kết nối
Không dùng đa luồng, không dùng asyncio để gọi song song. Một vòng for với time.sleep(3.1) đáp ứng đúng điều kiện. Thêm 0,1 giây so với ba giây để bù sai số đồng hồ.
Nếu anh em có nhiều truy vấn, hãy xếp chúng vào một hàng đợi và cho một tiến trình duy nhất xử lý tuần tự. Cách này dễ kiểm soát hơn nhiều tiến trình tự chờ riêng.
Theo dõi hàng ngày
Với lịch chạy hàng ngày, sắp xếp theo lastUpdatedDate giảm dần và dừng khi gặp bài có updated cũ hơn lần chạy trước. Cách này bắt được cả bài mới lẫn bài vừa sửa trong một vòng lặp.
Lưu mốc updated lớn nhất của lần chạy thành công vào file. Lần sau đọc mốc đó làm điểm dừng. Nếu lần chạy lỗi giữa chừng, mốc không đổi và lần sau sẽ lấy lại phần bị lỡ.
Lỗi và mã không tồn tại
Mã không tồn tại cho 200 kèm totalResults 0. Truy vấn sai cú pháp thường trả feed có một entry báo lỗi thay vì mã HTTP lỗi. Script nên kiểm entry có tiêu đề Error trước khi coi đó là dữ liệu.
Bài rate limit API khi dùng proxy có mẫu thử lại theo cấp số nhân. Với arXiv, khoảng chờ tối thiểu luôn là ba giây, kể cả khi thử lại.
Đối soát ID, kiểu dữ liệu và giá trị thiếu trong arXiv API bằng Python
Phần này kiểm dữ liệu sau khi lấy: khóa chính, ngày giờ, DOI thiếu và bài trùng giữa các lần chạy.
Chọn khóa chính
Khóa chính nên là mã gốc không version. Version là thuộc tính, không phải một phần của khóa. Khi lần chạy sau thấy cùng mã với version cao hơn, cập nhật dòng cũ và ghi lại version trước đó vào bảng lịch sử.
Nếu dự án cần lưu mọi phiên bản, dùng cặp mã gốc và version làm khóa của bảng lịch sử. Hai bảng tách biệt giúp truy vấn bản mới nhất không phải lọc.
Ngày giờ UTC
published và updated dùng định dạng ISO với hậu tố Z, tức UTC. Ví dụ bài 2610.32254 có published 2026-10-23T07:08:39Z. Python 3.11 trở lên đọc được trực tiếp bằng datetime.fromisoformat.
Khi lọc bài mới theo ngày Việt Nam, đổi múi giờ ở bước hiển thị, giữ dữ liệu gốc ở UTC. Một bài nộp lúc 23 giờ UTC đã là sáng hôm sau ở Việt Nam.
DOI thường trống
Chỉ 1 trên 50 bài trong mẫu có arxiv:doi. Trường này do tác giả bổ sung sau khi bài được xuất bản chính thức, nên preprint mới gần như luôn trống. Ghi chuỗi rỗng thay vì bỏ cột.
Khi cần nối với Crossref hay OpenAlex, đừng chỉ dựa vào DOI. OpenAlex có thể chứa bản ghi arXiv theo mã arXiv. Cách nối an toàn là thử DOI trước, sau đó thử mã arXiv.
Tiêu đề có xuống dòng
Tiêu đề trong Atom có thể chứa xuống dòng và nhiều khoảng trắng do định dạng XML. Lab dùng " ".join(title.split()) để gom về một dòng trước khi ghi CSV.
Bước này nên áp dụng cho cả tóm tắt nếu lấy. Không làm thì CSV mở trong bảng tính sẽ vỡ dòng ở giữa ô.
Bài trùng giữa các lần chạy
Chạy hàng ngày với cùng truy vấn, trang đầu hôm nay sẽ chứa nhiều bài đã có hôm qua. Dùng mã gốc để khử trùng. Nếu version tăng, cập nhật. Nếu không, bỏ qua.
Lab đếm 50 dòng và 50 mã khác nhau trong một lần chạy. Phép kiểm này nên chạy sau mỗi lần lấy, cùng với số entry so với itemsPerPage.
Tác giả và tóm tắt
Mỗi entry có nhiều thẻ author, mỗi thẻ có name và có thể có arxiv:affiliation. Thứ tự tác giả trong XML là thứ tự trên bài. Nếu cần lưu, ghi danh sách tác giả dạng mảng trong JSON hoặc bảng riêng, không nối thành chuỗi khó tách.
Tóm tắt nằm trong thẻ summary và có thể chứa công thức LaTeX. Đừng cố render LaTeX trong CSV. Giữ nguyên chuỗi gốc, phần hiển thị để ứng dụng đọc dữ liệu tự xử lý.
Xuất CSV có xuất xứ
File 283_preprints.csv gồm arxiv_id, version, id_url, title, published, updated, primary_category, doi và pdf. Cột id_url giữ nguyên URL có version để truy về đúng bản. Nên thêm cột thời điểm lấy và truy vấn đã dùng khi đưa vào hệ thống thật.
Lưu kết quả, giới hạn request và khi nào arXiv API bằng Python cần proxy
Phần cuối bàn chuyện lưu trữ, nhịp request và vị trí của proxy trong luồng tải.
Lưu Atom thô bên cạnh CSV
Atom thô giữ tóm tắt, tác giả, comment và journal_ref. Lưu file XML của từng trang theo ngày giúp anh em parse lại khi cần thêm trường mà không phải gọi API lần nữa. Mỗi trang khoảng 60 KB, chín trang chưa tới 1 MB.
Lịch chạy và nhật ký
Đặt job chạy một lần mỗi ngày sau giờ arXiv công bố đợt bài mới. Ghi nhật ký gồm truy vấn, totalResults, số entry nhận, số mã mới, số mã đổi version và thời gian chạy. Năm con số này đủ để phát hiện lần chạy bất thường.
Khi totalResults giảm đột ngột so với hôm trước, đó thường là dấu hiệu truy vấn sai hoặc dịch vụ trả lỗi trong feed. Kiểm entry Error trước khi ghi đè dữ liệu cũ.
Proxy không làm nhanh hơn nhịp ba giây
Điều khoản arXiv giới hạn theo hành vi của ứng dụng, không chỉ theo IP. Chia request qua nhiều IP để chạy song song là vi phạm điều kiện một kết nối. Proxy vì vậy không phải công cụ tăng tốc ở đây.
Lab đặt proxy ở tầng tải
Lab gọi id_list=1706.03762 qua proxy HTTP có xác thực và proxy SOCKS5 cục bộ. Kết quả giống gọi trực tiếp: 200 và 2.965 byte.
Cách gọi |
Kết quả |
Giây |
Proxy thấy gì |
|---|---|---|---|
Proxy HTTP, URL http |
200 |
0,775 |
GET đầy đủ URL có id_list, rồi CONNECT cổng 443 |
SOCKS5h |
200 |
0,584 |
Tên miền cổng 80, rồi cổng 443 |
Proxy HTTP, sai mật khẩu |
ProxyError |
0,151 |
auth_ok false, arXiv không nhận request |
Dòng đầu là bằng chứng nên viết https ngay từ đầu. Với URL http, proxy HTTP đọc được toàn bộ truy vấn. Với SOCKS5h, proxy chỉ thấy tên miền và cổng, nhưng vẫn phải mở hai kết nối vì chuyển hướng.
Khi nào cần proxy thật
Proxy cần khi mạng nơi chạy script bắt buộc đi qua proxy, ví dụ mạng trường đại học hoặc máy chủ trong vùng mạng kín. Proxy cũng hữu ích khi cần một IP thoát cố định để quản trị mạng cho phép đi ra ngoài. Cách khai báo proxy và mã hóa mật khẩu có ký tự đặc biệt nằm trong bài định dạng proxy.
Bài proxy share có an toàn không có nhắc nghiên cứu về proxy miễn phí. Với request học thuật, đừng dùng proxy miễn phí không rõ nguồn, vì proxy đó đọc được URL http và có thể sửa response.
Nếu nhóm nghiên cứu cần một IP thoát ổn định cho máy chủ chạy job định kỳ, proxy tĩnh dễ đưa vào danh sách cho phép hơn proxy xoay. ProxyVN có proxy dân cư tĩnh, datacenter, 4G và proxy xoay qua HTTP hoặc SOCKS5. Anh em có thể mua proxy giá rẻ tại trang chủ ProxyVN rồi khai báo vào requests như lab.
Giới hạn suy luận của bài
Số đo đến từ một máy ở Việt Nam ngày 29/10/2026. totalResults thay đổi theo ngày khi có bài mới. Tỷ lệ 14 trên 50 bài có bản sửa là của một mẫu nhỏ thuộc cs.NI, không đại diện cho toàn arXiv.
Lab chưa gặp lỗi 503 hay bị chặn vì nhịp request, vì luôn nghỉ đủ ba giây. Chưa thử truy vấn trả hàng nghìn entry trong một trang. Proxy trong lab là proxy cục bộ, chưa thử proxy thương mại.
Checklist arXiv API bằng Python
Checklist arXiv API
- Viết URL https, không dùng http.
- Thu hẹp truy vấn bằng cat và trường cụ thể.
- Sắp xếp theo submittedDate hoặc lastUpdatedDate khi phân trang.
- Nghỉ ít nhất ba giây giữa hai request, một kết nối.
- Tách version khỏi mã, khóa chính là mã gốc.
- Dùng published cho bài mới, updated cho bài sửa.
- Kiểm số entry, không tin mã 200.
- Lưu Atom thô cùng CSV.
Câu hỏi thường gặp về arXiv API bằng Python
Có cần đăng ký khóa không?
Không. arXiv API không cần khóa. Điều kiện là một request mỗi ba giây và một kết nối tại một thời điểm.
Làm sao biết bài có bản mới?
So sánh version của lần chạy này với lần trước theo mã gốc. Cách nhanh hơn là xem published khác updated, nghĩa là bài đã có ít nhất v2.
Vì sao mã không tồn tại vẫn trả 200?
API trả feed rỗng với totalResults 0 thay vì lỗi HTTP. Script phải đếm entry để biết.
arXiv khác OpenAlex ở điểm nào?
arXiv quản lý preprint theo mã có version. OpenAlex gom nhiều nguồn và gán mã công trình riêng. Nhiều preprint arXiv không có DOI nên không khớp được với Crossref.
Có nên dùng thư viện arxiv trên PyPI?
Có thể, nếu thư viện tôn trọng nhịp ba giây. Viết bằng requests và ElementTree giúp anh em thấy rõ namespace, version và OpenSearch.
Proxy có giúp tải PDF nhanh hơn không?
Không nên dùng proxy cho mục đích đó. Tải PDF số lượng lớn nên theo hướng dẫn dữ liệu số lượng lớn của arXiv.
arXiv API bằng Python và những điều cần nhớ
arXiv API bằng Python trả preprint dạng Atom với mã có version, và việc của anh em là tách version, chọn đúng trường ngày và giữ nhịp ba giây. Lab ngày 29/10/2026 lấy 50 bài cs.NI, 14 bài có bản sửa, chỉ 1 bài có DOI, mã không version trỏ về v7. Viết https, khóa chính là mã gốc, lưu Atom thô. Cần IP thoát ổn định cho máy chủ chạy arXiv API bằng Python, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


