
Apache StormCrawler topology: URL status và metadata
Apache StormCrawler topology là cách StormCrawler tổ chức một crawler thành đồ thị Apache Storm. Spout phát URL đến hạn, các bolt tải, phân tích, đánh chỉ mục, và một bolt cập nhật trạng thái ghi lại URL đã đi tới đâu. Hiểu topology nghĩa là hiểu hai thứ chạy xuyên suốt đồ thị: trạng thái của URL và metadata đi theo nó. ProxyVN đọc mã nguồn StormCrawler 3.7.0 ngày 03/11/2026, chép đúng các quy tắc chuyển trạng thái và lọc metadata sang một mô phỏng Python, rồi chạy trên một website mẫu để xem từng URL đổi trạng thái thế nào.
Apache StormCrawler topology: mục tiêu và phạm vi không lặp
Phần đầu chốt bài toán, đầu ra và giới hạn quan trọng của bài.
Bài toán
StormCrawler không phải chương trình chạy một lần rồi xong. Nó là crawler chạy liên tục, mỗi URL có lịch tải lại riêng. Người vận hành cần trả lời được: URL này đang ở trạng thái nào, vì sao, khi nào được tải lại, và metadata nào đã được lưu cùng nó.
Nếu không hiểu luồng status và metadata, rất dễ gặp những chuyện khó hiểu: trang 404 vẫn được thử lại nhiều lần, URL lỗi không bao giờ quay lại, metadata gắn vào seed biến mất ở trang con.
Đầu ra nghiệm thu
Đầu ra là sơ đồ spout và bolt của topology mẫu, cùng nhật ký chuyển trạng thái của từng URL trên một website nhỏ. Website có đủ tình huống: trang tốt, 404, 503 tạm thời, chuyển hướng, robots.txt chặn, trang chậm quá timeout. Mỗi dòng nhật ký ghi trạng thái cũ, trạng thái mới, thời điểm tải lại, metadata được lưu và metadata bị bỏ.
Giới hạn quan trọng của bài
StormCrawler chạy trên JVM, cần JDK 17, Maven và Apache Storm. Môi trường lab chặn tải và chạy JDK từ bên ngoài, nên bài không chạy được StormCrawler thật. Mình chọn cách đọc mã nguồn của bản 3.7.0 và chép các quy tắc vào một mô phỏng Python.
Mô phỏng tải trang thật qua HTTP từ máy chủ cục bộ, nhưng spout và bolt chỉ là hàm Python, thời gian là phút giả lập. Mọi kết luận về StormCrawler trong bài dẫn từ dòng mã cụ thể, không từ kết quả chạy StormCrawler.
Phạm vi không lặp
Website đã có bài Apache Nutch proxy và bài Heritrix crawler. Ba công cụ cùng là crawler quy mô lớn, nhưng khác nhau ở kiến trúc. Bài này chỉ nói phần riêng của StormCrawler: topology Storm, luồng status và cách metadata được chuyển, không đổi tên công cụ trên cùng một hướng dẫn.
Nguồn kiểm chứng
Mã nguồn lấy từ kho apache/stormcrawler trên GitHub tại thẻ stormcrawler-3.7.0, phát hành ngày 29/07/2026. Các tệp đã đọc gồm Status.java, AbstractStatusUpdaterBolt.java, DefaultScheduler.java, MetadataTransfer.java, FetcherBolt.java, Constants.java, crawler-default.yaml, cùng crawler.flux và crawler-conf.yaml của archetype. Tài liệu tổng quan ở trang chủ StormCrawler.
Thiết kế topology StormCrawler với URL status và metadata trong Apache StormCrawler topology
Phần này giải thích năm trạng thái và vai trò của metadata.
Năm trạng thái
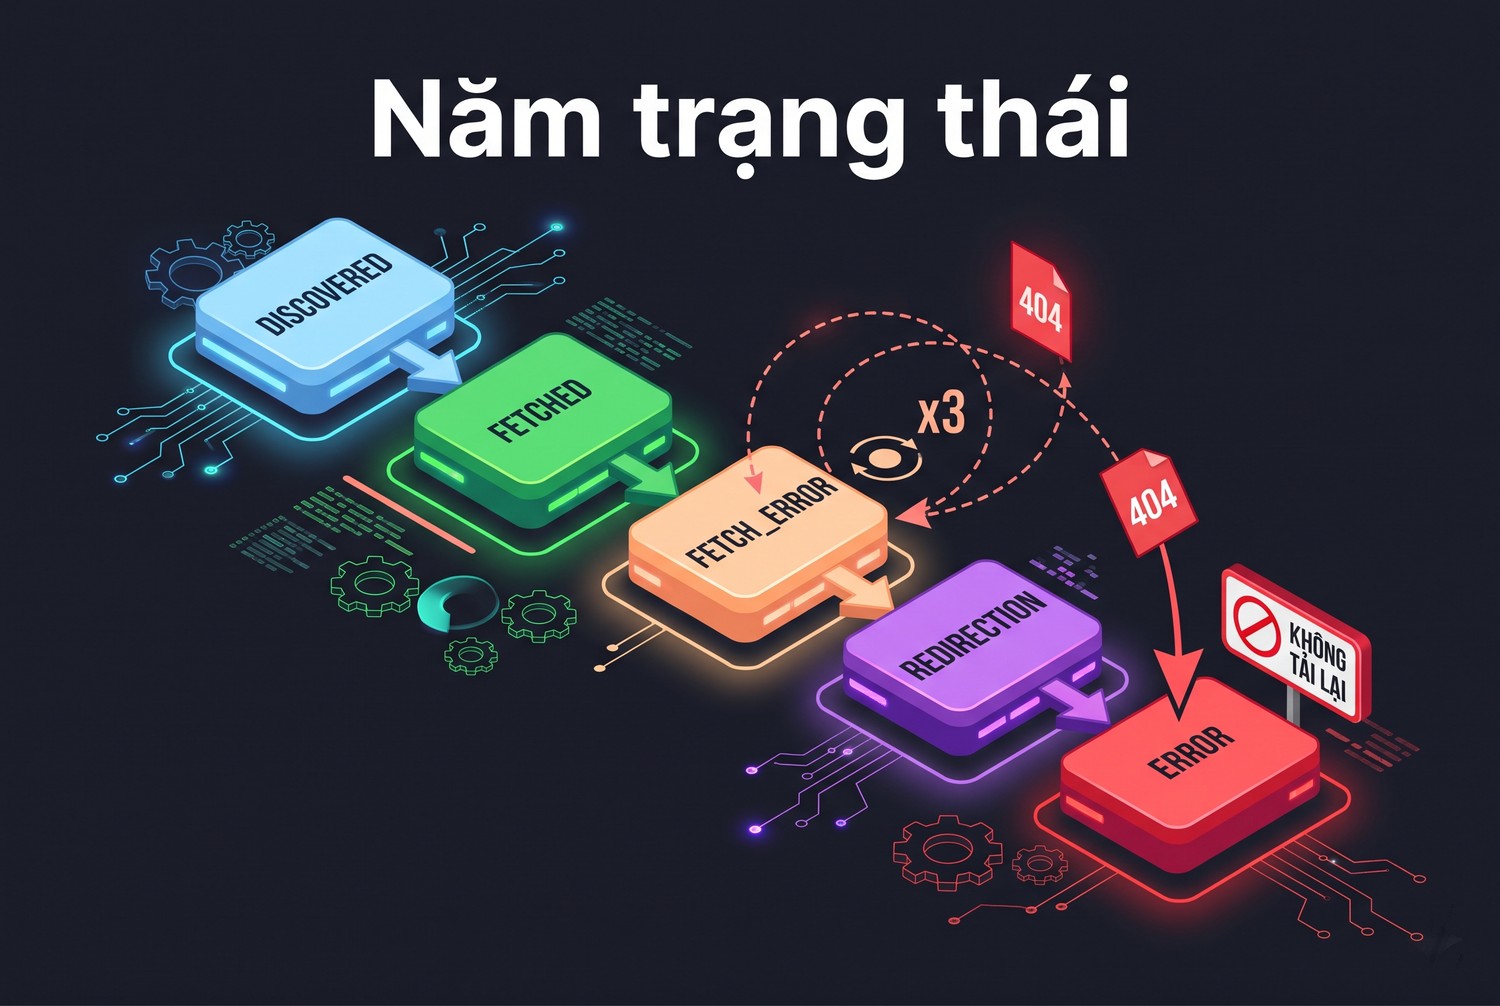
Năm trạng thái
Enum Status trong mã nguồn có năm giá trị: DISCOVERED, FETCHED, FETCH_ERROR, REDIRECTION, ERROR. DISCOVERED là URL mới tìm thấy, chưa tải. FETCHED là đã tải thành công. FETCH_ERROR là lỗi tải có thể thử lại. REDIRECTION là chuyển hướng. ERROR là lỗi cuối, thường không tải lại nữa.
Mã HTTP sang trạng thái
Hàm fromHTTPCode ánh xạ rất gọn: 200 và 304 thành FETCHED, mọi mã từ 300 tới 399 thành REDIRECTION, còn lại thành FETCH_ERROR. Không có ngoại lệ nào cho 404 hay 410. Một trang 404 được coi là lỗi tải tạm thời giống hệt một trang 503.
Đây là điểm đầu tiên người mới hay hiểu sai. StormCrawler mặc định không kết luận trang chết ngay khi gặp 404. Nó thử lại theo lịch lỗi, đủ số lần mới chuyển sang ERROR.
Metadata là túi khóa và giá trị
Mỗi URL đi kèm một Metadata, là bảng khóa ánh xạ tới danh sách chuỗi. Metadata đi cùng tuple qua mọi bolt và được lưu cùng URL ở kho trạng thái. Các bolt đọc và ghi metadata để truyền thông tin: độ sâu, trang cha, số lần lỗi, URL chuyển hướng tới, nguyên nhân lỗi.
Hai danh sách quyết định số phận metadata
MetadataTransfer có hai danh sách. metadata.transfer là các khóa được chuyển từ trang cha sang trang con, và cũng được lưu cho chính trang cha. metadata.persist là các khóa chỉ được lưu cho trang hiện tại, không chuyển sang trang con. Khóa nằm ngoài cả hai danh sách sẽ bị bỏ khi lưu.
Hàm filter trong mã nguồn dựng một Metadata mới chỉ gồm khóa thuộc hai danh sách, rồi bolt cập nhật trạng thái lưu Metadata mới đó. Mọi khóa khác biến mất ở bước này, không có cảnh báo.
Mặc định của hai danh sách
Trong crawler-default.yaml, metadata.transfer để trống. metadata.persist gồm _redirTo, error.cause, error.source, isSitemap, isFeed. Mã MetadataTransfer luôn thêm fetch.error.count vào danh sách persist, và thêm url.path, depth, max.depth vào danh sách transfer khi metadata.track.path và metadata.track.depth bật, mặc định là bật.
Tức là ngoài những khóa này, mọi metadata khác đều không được lưu nếu không khai báo.
Vẽ topology với spout, fetcher, parser và status updater cho Apache StormCrawler topology
Phần này đọc tệp crawler.flux của archetype.
Các thành phần trong crawler.flux
Topology mẫu của archetype khai báo một spout và chín bolt. Spout là urlfrontier.Spout, lấy URL đến hạn từ URLFrontier. Các bolt theo thứ tự xử lý gồm partitioner là URLPartitionerBolt, fetcher là FetcherBolt, sitemap là SiteMapParserBolt, feed là FeedParserBolt, parse là JSoupParserBolt. Tiếp theo là shunt là RedirectionBolt của mô đun Tika, tika là ParserBolt của Tika, index là StdOutIndexer, và status là StatusUpdaterBolt của urlfrontier.
Luồng chính
Spout đi tới partitioner bằng SHUFFLE. Partitioner đi tới fetcher bằng FIELDS theo trường key. Từ fetcher trở đi, sitemap, feed, parse, shunt, tika, index nối nhau bằng LOCAL_OR_SHUFFLE. Đây là đường đi của nội dung trang.
Luồng status
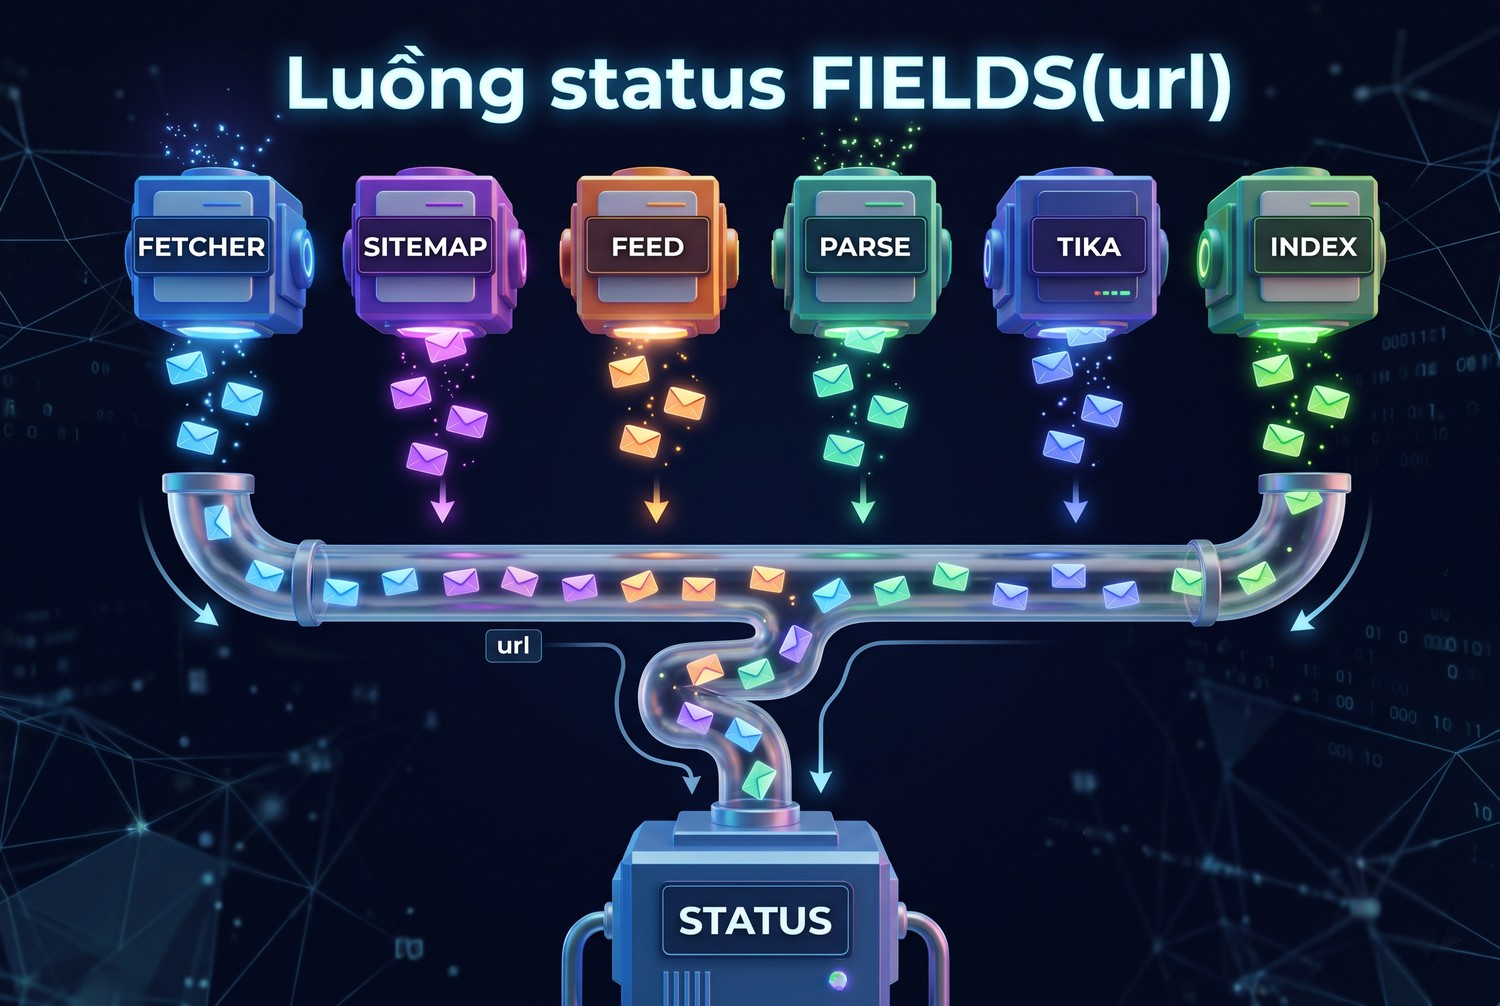
Luồng status FIELDS(url)
Song song với luồng chính là luồng có streamId status. fetcher, sitemap, feed, parse, tika và index đều có một nhánh status đi tới bolt status, nhóm theo FIELDS trên trường url. Bất cứ bolt nào cũng có thể báo trạng thái của URL, và mọi báo cáo về cùng một URL luôn tới cùng một thực thể của bolt status.
Nhóm theo url là chi tiết quan trọng. Nó giúp bộ nhớ tạm của bolt status trên một thực thể thấy được mọi báo cáo về một URL, tránh hai thực thể cùng ghi một URL.
Luồng xóa khi URL thành ERROR
Trong AbstractStatusUpdaterBolt, khi trạng thái là ERROR, bolt phát thêm một tuple trên luồng deletion gồm url và metadata. Luồng này dành cho các bolt xóa tài liệu khỏi chỉ mục tìm kiếm. Nhờ vậy trang chết lâu ngày không còn nằm trong kết quả tìm kiếm nội bộ.
Nếu topology không nối luồng deletion tới bolt nào, tuple đó không đi đâu. Với hệ thống có chỉ mục, đây là chỗ hay bị bỏ quên khi tự dựng topology.
Ack, fail và thử lại ở tầng Storm
Khi lưu thành công, bolt status gọi ack cho tuple và đưa URL vào bộ nhớ tạm. Khi hàm store ném lỗi, ví dụ kho trạng thái không truy cập được, bolt gọi fail. Storm sẽ phát lại tuple từ spout theo cơ chế của nó. Đây là lớp thử lại khác hẳn bộ đếm fetch.error.count: một bên là lỗi ghi kho, một bên là lỗi tải trang.
Partitioner nhóm theo host
partition.url.mode mặc định là byHost. Partitioner gắn khóa theo tên máy, fetcher nhận URL theo khóa đó. Mọi URL của cùng một host đi về cùng một fetcher, nhờ vậy fetcher giữ được hàng đợi và độ trễ lịch sự cho từng host. Có thể đổi sang byDomain hay byIP.
Sơ đồ rút gọn
spout --SHUFFLE--> partitioner --FIELDS(key)--> fetcher --> sitemap --> feed --> parse --> shunt --> tika --> index
   ^                                              |          |          |         |                   |         |
   |                                              +-----status stream, FIELDS(url)-----------------------------+
   |                                                                       v
   +------------------------------ kho trạng thái <---------------- status (StatusUpdaterBolt)
Sơ đồ đóng vòng qua kho trạng thái: bolt status ghi trạng thái và ngày tải lại, spout đọc những URL đến hạn từ kho để phát lại. Đây là điều làm StormCrawler thành crawler liên tục.
Giữ URL metadata xuyên qua các bolt trong Apache StormCrawler topology
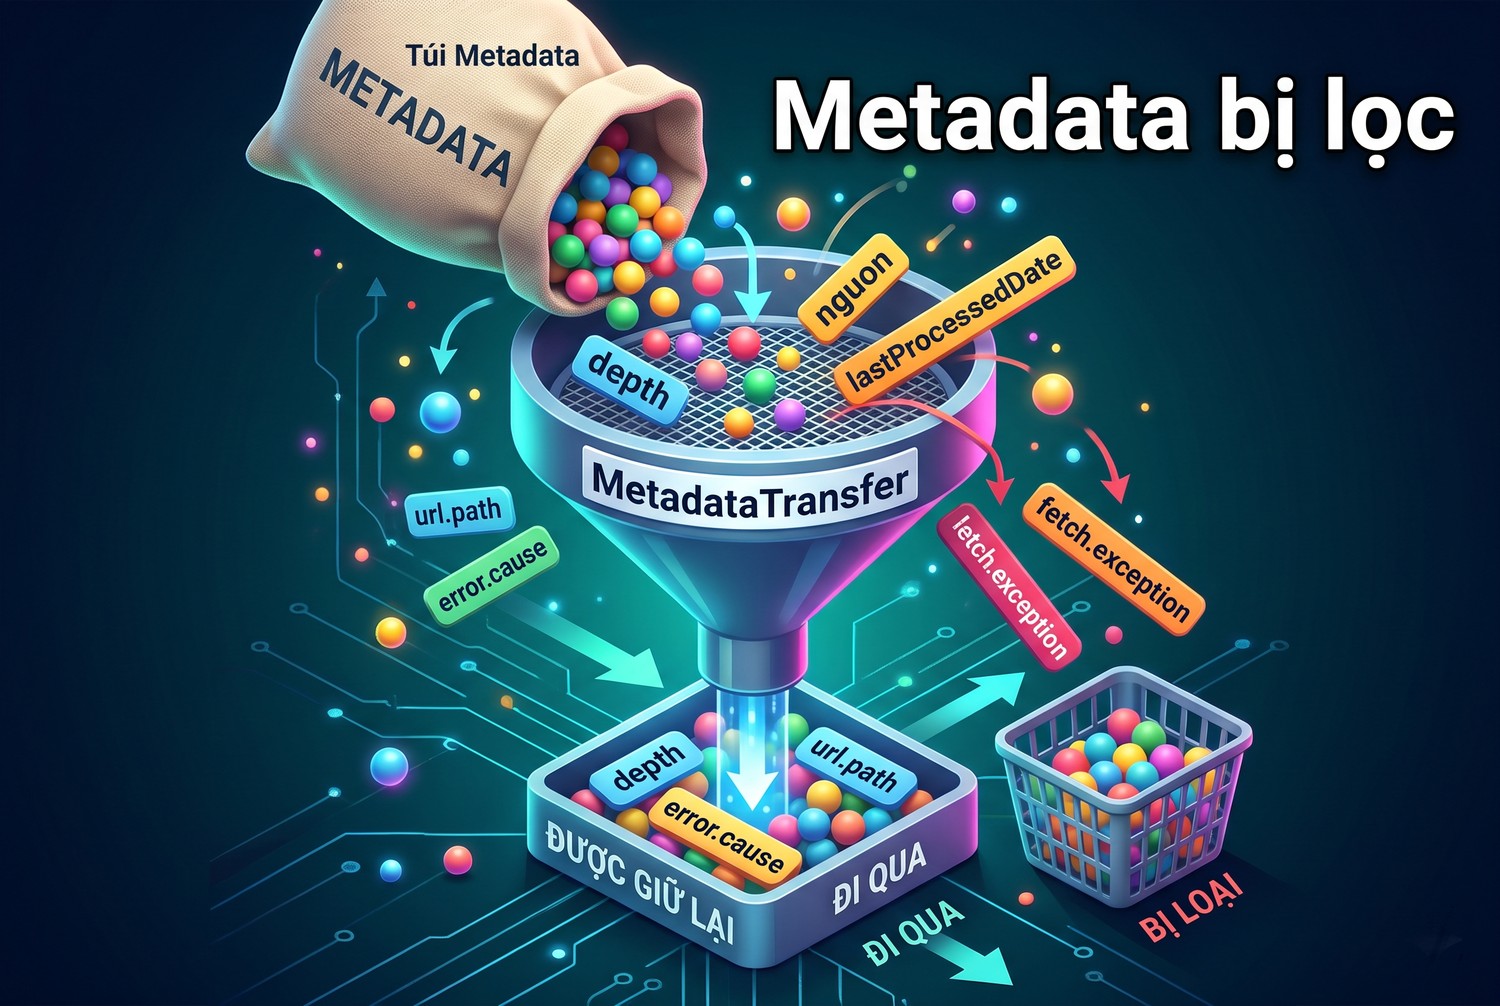
Metadata bị lọc
Phần này nói về đường đi của metadata.
Metadata sang trang con
Khi một trang có link mới, hàm getMetaForOutlink tạo metadata cho trang con. Nó lọc metadata trang cha theo danh sách transfer, thêm URL trang cha vào url.path, và tăng depth thêm 1. Khóa của trang cha không thuộc danh sách transfer không sang trang con.
Trong mô phỏng, seed được gắn khóa tự đặt nguon bằng catalog. Với cấu hình mặc định, trang con /a và /mat nhận url.path và depth bằng 1, không có nguon. Khi lưu chính seed, nguon cũng bị bỏ vì không thuộc danh sách nào.
Khi cần giữ khóa tự đặt
Cấu hình B của mô phỏng thêm nguon vào metadata.transfer. Lúc đó seed giữ nguon khi lưu, trang con /a và /mat cũng nhận nguon bằng catalog. Đây là cách StormCrawler truyền thông tin như danh mục nguồn, cookie hay cờ follow từ trang cha xuống trang con. Tài liệu trong tệp yaml gợi ý dùng ký tự sao, như follow.*, để chuyển cả nhóm khóa.
url.path dài dần theo độ sâu
url.path là danh sách. Mỗi bước thêm một phần tử. Trang /b được tìm thấy từ /a nên url.path có hai phần tử là trang chủ và /a, depth bằng 2. Với website sâu, url.path có thể rất dài. Nếu không cần, tắt metadata.track.path để giảm kích thước lưu.
Ngày phát hiện và ngày xử lý
AbstractStatusUpdaterBolt gán discoveryDate cho URL DISCOVERED và lastProcessedDate cho mọi trạng thái khác, ngay trước khi lưu. Nhưng hai khóa này không nằm trong danh sách mặc định. Ngay sau đó, metadata được lọc và hai khóa bị bỏ.
Mô phỏng với cấu hình mặc định cho thấy cột bị bỏ của mọi dòng đều có discoveryDate hoặc lastProcessedDate. Muốn giữ hai ngày này trong kho, phải thêm chúng vào metadata.persist. Cấu hình B làm vậy, và cả hai khóa xuất hiện trong phần được lưu.
Thông tin lỗi mạng cũng bị bỏ
Khi tải gặp ngoại lệ, FetcherBolt ghi lý do vào khóa fetch.exception, ví dụ Socket timeout fetching hay Unknown host, rồi báo FETCH_ERROR. fetch.exception không nằm trong metadata.persist mặc định. Mô phỏng trang /cham quá timeout cho thấy fetch.exception bị bỏ ở cấu hình mặc định và được giữ ở cấu hình B.
Hệ quả: với cấu hình mặc định, nhìn vào kho trạng thái chỉ thấy URL đang FETCH_ERROR, không biết vì timeout hay vì tên miền không tồn tại. Khi gỡ lỗi một đợt URL lỗi hàng loạt, thiếu thông tin này buộc phải đi tìm trong log của từng worker Storm, chậm hơn nhiều so với một truy vấn trên kho.
Dựng fixture thành công và URL fetch lỗi cho Apache StormCrawler topology
Phần này mô tả website mẫu và mô phỏng.
Website mẫu
Máy chủ http.server ở 127.0.0.1 cổng 9811 có robots.txt chặn thư mục /admin/. Trang chủ trỏ tới /a, /mat, /chap, /cu, /admin/x và /cham. /a trỏ về trang chủ và /b. /mat trả 404. /chap trả 503 hai lần đầu rồi 200. /cu chuyển hướng 301 sang /b. /cham trả sau 3 giây, quá timeout 2 giây của mô phỏng.
Những quy tắc được chép từ mã nguồn
Mô phỏng chép năm nhóm quy tắc. Ánh xạ mã HTTP theo fromHTTPCode. Bộ đếm fetch.error.count tăng mỗi lần FETCH_ERROR, đạt max.fetch.errors bằng 3 thì chuyển ERROR với error.cause là maxFetchErrors. Khóa fetch.error.count bị xóa khi trạng thái khác FETCH_ERROR. Lịch tải lại theo DefaultScheduler với giá trị trong crawler-default.yaml. Lọc metadata theo MetadataTransfer.
Thêm hai quy tắc từ FetcherBolt: URL bị robots.txt chặn báo ERROR với error.cause là robots.txt, và ngoại lệ khi tải báo FETCH_ERROR với fetch.exception.
Vì sao chọn mô phỏng thay vì bỏ bài
Có thể đọc mã nguồn rồi viết lại bằng lời, nhưng những quy tắc nhỏ như thứ tự gán ngày rồi mới lọc metadata rất dễ bị bỏ qua khi chỉ đọc. Viết lại thành mã chạy được buộc phải đi đúng từng nhánh if. Kết quả mô phỏng là một dự đoán có thể kiểm: khi chạy StormCrawler thật trên cùng website mẫu, nhật ký phải giống.
Những gì mô phỏng không làm
Mô phỏng không có Storm, không có ack và fail của tuple, không chạy song song, không có URLFrontier hay kho thật. Nó không có JSoupParserBolt mà dùng biểu thức chính quy lấy href. Nó cũng không mô phỏng bộ nhớ tạm của bolt status với thời hạn một giờ, chỉ dùng một tập URL đã thấy. Thời gian là các mốc phút cố định: 0, 1, 2, 121, 122, 242, 243, 1441, 1442, 2882.
Các nguyên nhân ERROR khác trong FetcherBolt
Ngoài robots.txt và maxFetchErrors, mã FetcherBolt còn hai nguyên nhân ERROR. Một là crawl_delay: khi robots.txt yêu cầu độ trễ lớn hơn fetcher.max.crawl.delay, mặc định 30 giây, và fetcher.max.crawl.delay.force là false, URL bị báo ERROR với error.cause là crawl_delay. Hai là malformed URL, khi URL không phân tích được.
Nguyên nhân crawl_delay đáng chú ý. Website đặt Crawl-delay 60 giây trong robots.txt sẽ có mọi URL thành ERROR, và với fetchInterval.error bằng -1 thì không bao giờ quay lại. Mô phỏng không thử trường hợp này.
Lịch tải lại mặc định
crawler-default.yaml đặt fetchInterval.default bằng 1440 phút, tức một ngày. fetchInterval.fetch.error bằng 120 phút. fetchInterval.error bằng -1, nghĩa là không bao giờ tải lại. Mã DefaultScheduler có giá trị dự phòng 44640 phút cho ERROR khi không có cấu hình, nhưng tệp mặc định ghi đè thành -1.
Chi tiết này đáng chú ý: ai tự dựng cấu hình mà bỏ sót tệp mặc định sẽ có URL ERROR được thử lại sau 31 ngày, còn ai dùng tệp mặc định thì URL ERROR nằm im mãi.
Chuyển hướng không được theo mặc định
http.allow.redirects mặc định là false. Phần xử lý REDIRECTION trong FetcherBolt ghi URL đích vào _redirTo, và chỉ phát URL đích như một outlink mới nếu cho phép chuyển hướng. Mô phỏng ghi _redirTo bằng /b cho /cu và không tự tải /b từ /cu. /b vẫn được tìm thấy vì /a có link tới nó.
Theo dõi status transition và điều kiện URL được thử lại trong Apache StormCrawler topology
Đây là nhật ký chính của mô phỏng với cấu hình mặc định.
Bảng chuyển trạng thái
URL |
T+0 phút |
T+121 |
T+242 |
Trạng thái cuối |
Tải lại |
|---|---|---|---|---|---|
/ |
FETCHED |
FETCHED |
Sau 1440 phút |
||
/a |
FETCHED |
FETCHED |
Sau 1440 phút |
||
/b |
FETCHED |
FETCHED |
Sau 1440 phút |
||
/mat (404) |
FETCH_ERROR, lỗi 1 |
FETCH_ERROR, lỗi 2 |
ERROR, maxFetchErrors |
ERROR |
Không bao giờ |
/chap (503, 503, 200) |
FETCH_ERROR, lỗi 1 |
FETCH_ERROR, lỗi 2 |
FETCHED, xóa bộ đếm |
FETCHED |
Sau 1440 phút |
/cham (timeout) |
FETCH_ERROR, lỗi 1 |
FETCH_ERROR, lỗi 2 |
ERROR, maxFetchErrors |
ERROR |
Không bao giờ |
/cu (301) |
REDIRECTION, _redirTo /b |
REDIRECTION |
Sau 1440 phút |
||
/admin/x |
ERROR, robots.txt |
ERROR |
Không bao giờ |
Đọc dòng /mat
Trang 404 được thử ba lần qua khoảng bốn giờ: phút 0, phút 121, phút 242. Lần thứ ba, bộ đếm đạt 3, trạng thái chuyển ERROR với error.cause là maxFetchErrors, lịch tải lại là không bao giờ. Từ lúc đó /mat nằm im trong kho.
Ba request cho một trang chết là chi phí nhỏ với một website, nhưng nhân lên hàng triệu URL thì đáng kể. Nếu muốn 404 thành ERROR ngay, cần một bước tùy biến, ví dụ một bolt đọc mã trạng thái và đặt lại trạng thái trước khi tới bolt status. Mình chưa kiểm cách làm cụ thể trong mã nguồn.
Đọc dòng /chap
Hai lần 503 đầu tiên làm bộ đếm lên 2. Lần thứ ba trả 200, trạng thái chuyển FETCHED, và theo mã nguồn khóa fetch.error.count bị xóa vì trạng thái không còn là FETCH_ERROR. Nếu /chap lỗi lại vào tuần sau, bộ đếm bắt đầu từ 0. Đây là hành vi đúng: lỗi tạm thời không cộng dồn mãi.
Đọc dòng /cham
Trang trả quá timeout được đối xử giống 404: ba lần FETCH_ERROR rồi ERROR. Khác biệt duy nhất là lý do nằm trong fetch.exception, và lý do đó bị bỏ khi lưu với cấu hình mặc định. Trong kho, /cham và /mat nhìn gần như giống nhau: cùng ERROR, cùng error.cause là maxFetchErrors.
Đọc dòng /admin/x
URL bị robots.txt chặn đi thẳng tới ERROR ở lần đầu, với error.cause là robots.txt, không qua FETCH_ERROR. error.cause nằm trong metadata.persist nên được giữ. Lịch tải lại là không bao giờ. Nếu robots.txt của website sau này bỏ chặn, URL này vẫn không tự quay lại.
Cấu hình B thay đổi gì
Chạy lại mô phỏng với cấu hình B, bảng chuyển trạng thái giống hệt cấu hình mặc định. Chỉ phần metadata được lưu khác: seed và mọi trang con có nguon bằng catalog, mọi dòng có discoveryDate và lastProcessedDate, /cham có fetch.exception bằng Socket timeout fetching. Tức là danh sách metadata không đổi hành vi crawl, chỉ đổi những gì người vận hành nhìn thấy trong kho.
Lịch tải lại sau một ngày
Ở phút 1441, các URL FETCHED và REDIRECTION đến hạn và được tải lại, lịch đẩy tiếp thêm 1440 phút. URL ERROR không bao giờ xuất hiện lại trong các vòng sau. Đó là trạng thái cuối của mô phỏng: 5 URL sống theo chu kỳ một ngày, 3 URL ERROR nằm im.
Ghi lịch tải lại cố định từ metadata
Mã AbstractStatusUpdaterBolt có một đường tắt: nếu metadata có khóa status.store.as.is.with.nextfetchdate chứa một ngày ISO, URL được lưu nguyên trạng thái với đúng ngày đó, bỏ qua mọi tính toán lỗi và lịch. Đây là cách cho một công cụ bên ngoài đặt lịch tải lại chính xác cho một URL, ví dụ khi biết trước trang sẽ cập nhật lúc nào.
Mã định danh tài liệu
Hàm getDocumentID mặc định trả mã băm SHA-256 của URL. Kho trạng thái dùng mã này làm khóa. Hai URL chỉ khác một ký tự là hai tài liệu khác nhau, nên việc chuẩn hóa URL trước khi vào luồng status, như bỏ tham số theo dõi, ảnh hưởng trực tiếp tới số tài liệu trong kho.
Thời gian được làm tròn
Trước khi lưu, ngày tải lại được làm tròn theo status.updater.unit.round.date, mặc định là SECOND. Có thể đổi sang MINUTE hay HOUR để gom nhiều URL vào cùng mốc, giúp kho trạng thái truy vấn hiệu quả hơn. Mô phỏng dùng phút nguyên nên không thấy tác động.
Đầu ra nghiệm thu: sơ đồ spout bolt và log URL chuyển trạng thái trên fixture nhỏ với Apache StormCrawler topology
Phần cuối gom lại cấu hình nên chỉnh, bộ bàn giao và vai trò của proxy.
Cấu hình nên xem lại trước khi chạy
Thêm vào metadata.persist những khóa cần cho vận hành: lastProcessedDate, discoveryDate, fetch.exception. Thêm vào metadata.transfer những khóa cần đi xuống trang con, như danh mục nguồn hay cờ theo dõi. Quyết định fetchInterval.error có nên là -1 hay một số ngày, tùy việc có muốn URL lỗi quay lại không. Quyết định có cho phép chuyển hướng không.
config:
  metadata.transfer:
    - nguon
  metadata.persist:
    - _redirTo
    - error.cause
    - error.source
    - isSitemap
    - isFeed
    - discoveryDate
    - lastProcessedDate
    - fetch.exception
  fetchInterval.error: 10080
Khoảng tải lại theo metadata
DefaultScheduler đọc khóa scheduler.delay.mins trong metadata nếu có, và đọc các quy tắc dạng fetchInterval kèm tên khóa và giá trị, có thể kèm trạng thái. Ví dụ trong tệp yaml là trang có isFeed bằng true được tải lại sau 10 phút. Đây là cách cho trang danh sách hay feed được tải thường xuyên hơn trang chi tiết.
Bộ nhớ tạm của bolt status
status.updater.use.cache mặc định bật, với spec expireAfterAccess=1h,softValues. URL DISCOVERED đã có trong bộ nhớ tạm sẽ không được ghi lại. Nhờ vậy một link xuất hiện trên hàng nghìn trang chỉ tốn một lần ghi trong mỗi giờ. Mô phỏng dùng một tập đơn giản thay bộ nhớ tạm có hạn.
Theo dõi ERROR theo nguyên nhân
Với hàng triệu URL, nhìn từng dòng nhật ký là không thể. Cần một bảng đếm URL ERROR theo error.cause mỗi ngày: maxFetchErrors, robots.txt, crawl_delay, malformed URL. Một ngày maxFetchErrors tăng vọt thường là sự cố mạng hay proxy, không phải hàng loạt trang chết thật. Khi đó cần đưa các URL đó về lại DISCOVERED thay vì để nằm im.
Bộ bàn giao
Bộ bàn giao gồm sơ đồ topology như trên, cấu hình metadata.transfer và metadata.persist kèm lý do từng khóa, bảng lịch tải lại theo trạng thái, và nhật ký chuyển trạng thái trên website mẫu. Khi chạy StormCrawler thật, đối chiếu nhật ký thật với nhật ký mô phỏng. Khác biệt nào cũng là chỗ mình hiểu sai mã nguồn hoặc cấu hình đã đổi.
Giới hạn của bài
Không chạy StormCrawler, Storm hay URLFrontier. Mô phỏng chỉ chép quy tắc từ các tệp đã liệt kê của bản 3.7.0. Kho trạng thái thật, như OpenSearch hay URLFrontier, có thể có hành vi riêng khi lưu URL DISCOVERED đã tồn tại. Mô phỏng giả định URL đã có thì không ghi đè, giống ý đồ của bộ nhớ tạm, nhưng chưa kiểm với từng kho.
Khi nào cần proxy với Apache StormCrawler topology
Proxy là cấu hình của tầng tải trong FetcherBolt, không liên quan tới luồng status hay metadata. Proxy cần khi cụm Storm chạy trong mạng chỉ ra Internet qua proxy, hoặc khi website nguồn chỉ cho phép một dải IP cố định.
Một liên hệ với bài này: lỗi do proxy, như proxy từ chối kết nối, đi vào FETCH_ERROR giống lỗi của website, và lý do nằm trong fetch.exception sẽ mất nếu không thêm vào metadata.persist. Proxy chập chờn có thể đẩy hàng loạt URL tốt sang ERROR sau ba lần lỗi. Cách viết chuỗi proxy có trong bài định dạng proxy. Với cụm crawler cần IP thoát ổn định, anh em có thể mua proxy tĩnh Việt Nam tại trang chủ ProxyVN. Proxy không thay quyền truy cập, như bài Web Scraping proxy là gì đã nói, và robots.txt vẫn được tôn trọng như dòng /admin/x cho thấy.
Checklist Apache StormCrawler topology
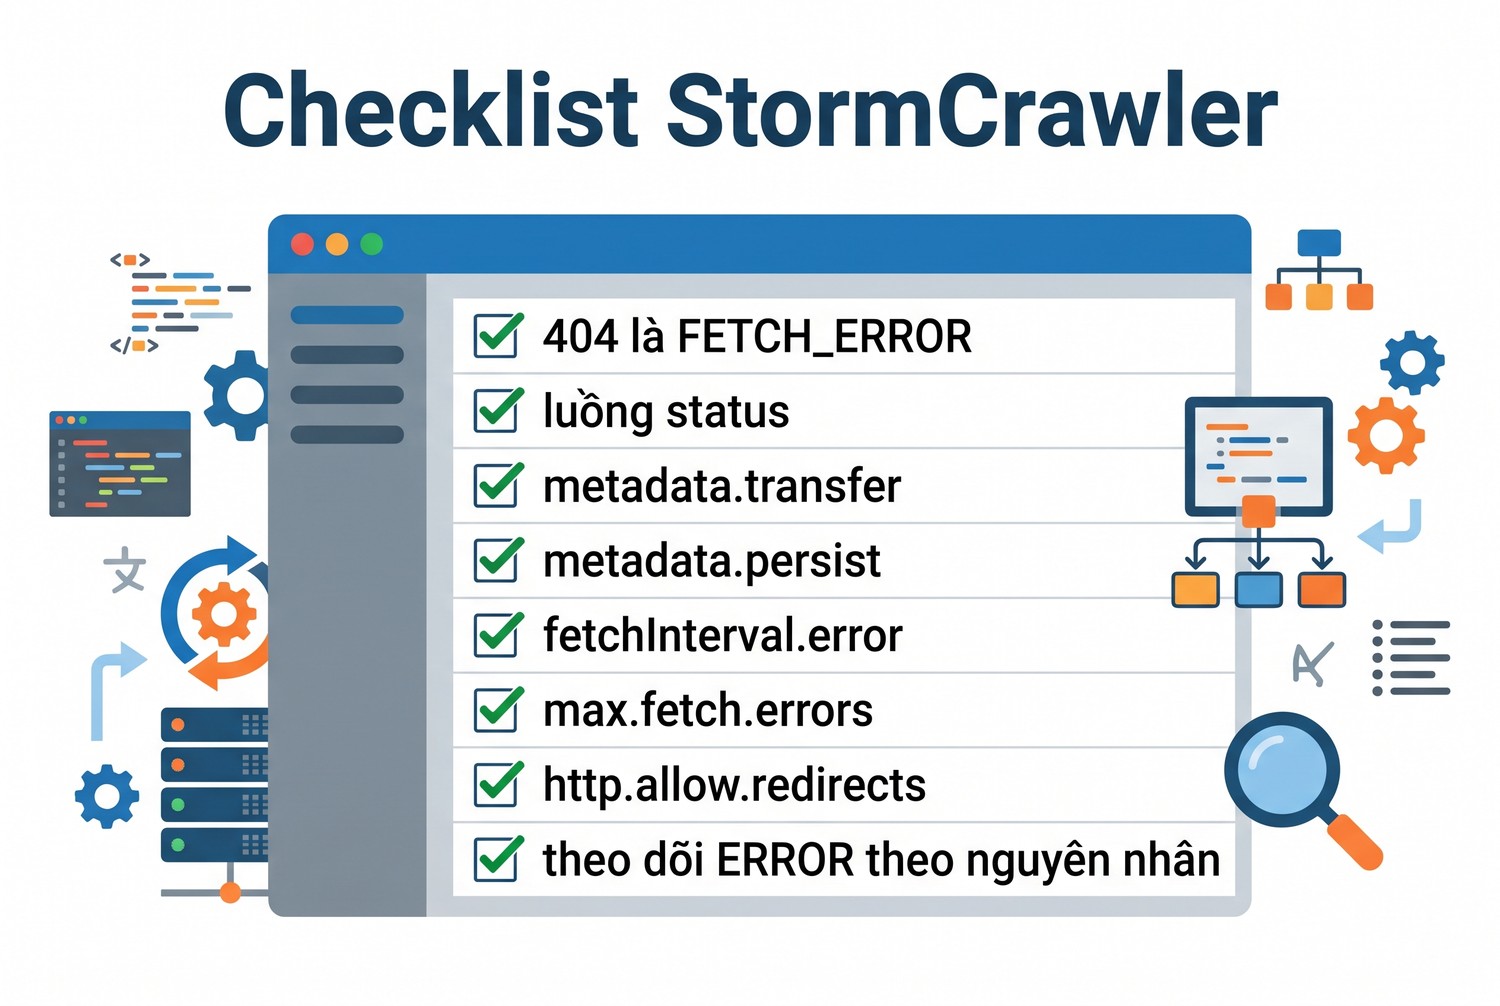
Checklist StormCrawler
- Nắm năm trạng thái và ánh xạ mã HTTP: 404 là FETCH_ERROR.
- Đọc crawler.flux, xác định bolt nào gửi luồng status.
- Liệt kê khóa metadata cần chuyển xuống trang con.
- Liệt kê khóa cần lưu: ngày xử lý, fetch.exception.
- Xem lại fetchInterval.error và max.fetch.errors.
- Quyết định http.allow.redirects.
- Theo dõi tỷ lệ URL chuyển sang ERROR theo nguyên nhân.
- Đối chiếu nhật ký thật với mô phỏng trên website mẫu.
Câu hỏi thường gặp về Apache StormCrawler topology
Vì sao trang 404 không thành ERROR ngay?
fromHTTPCode xếp mọi mã ngoài 200, 304 và 3xx vào FETCH_ERROR. Cần ba lần lỗi theo max.fetch.errors mới chuyển ERROR.
Vì sao metadata gắn vào seed biến mất?
Khóa không thuộc metadata.transfer hay metadata.persist bị bỏ khi lưu. Thêm khóa vào danh sách phù hợp.
URL ERROR có được tải lại không?
Với crawler-default.yaml thì không, vì fetchInterval.error bằng -1.
Làm sao biết URL lỗi vì timeout hay vì 404?
Thêm fetch.exception vào metadata.persist. Mặc định khóa này bị bỏ.
StormCrawler có theo chuyển hướng không?
Mặc định http.allow.redirects là false. URL đích được ghi vào _redirTo nhưng không tự phát thành outlink.
Bài này có chạy StormCrawler thật không?
Không. Quy tắc được chép từ mã nguồn 3.7.0 sang mô phỏng Python vì môi trường lab chặn chạy JDK.
Apache StormCrawler topology và những điều cần nhớ
Apache StormCrawler topology xoay quanh luồng status và metadata. Đọc mã nguồn 3.7.0 và mô phỏng ngày 03/11/2026 cho thấy 404 được thử ba lần trước khi thành ERROR, ERROR không bao giờ quay lại với cấu hình mặc định, và lastProcessedDate cùng fetch.exception bị bỏ khi lưu. Xem lại metadata.persist trước khi chạy. Cần IP ổn định cho Apache StormCrawler topology, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


