
Apache Parquet lưu dữ liệu crawl: schema, row group và nhiều lô
Apache Parquet lưu dữ liệu crawl là cách ghi kết quả cào web thành tệp dạng cột, nén tốt và đọc nhanh theo cột, thay cho tệp JSONL hay CSV dài dằng dặc. Một lô 60.000 dòng có thể từ hơn 10 MB xuống dưới 1 MB. Nhưng Parquet cũng có những chỗ âm thầm: schema giữa các lô lệch nhau thì dữ liệu bị ép kiểu hoặc rơi cột mà không ai báo. ProxyVN chạy pyarrow 26.0.1 ngày 03/11/2026 với ba lô dữ liệu crawl giả lập, so dung lượng, đo số row group phải đọc khi lọc theo thời gian, và cố ý ghi một lô có schema khác. Bài ghi lại con số thật và những chỗ cần khóa lại.
Apache Parquet lưu dữ liệu crawl: mục tiêu và phạm vi không lặp
Phần này chốt bài toán, đầu ra và những gì bài không bàn.
Bài toán
Một crawler giá ghi mỗi ngày khoảng 60.000 dòng: URL, tên miền, mã sản phẩm, giá, đơn vị tiền, mã trạng thái, thời điểm tải. Sau vài tháng, thư mục JSONL nặng vài gigabyte, mỗi lần phân tích phải đọc lại toàn bộ. Nhóm muốn chuyển sang Parquet, nhưng chưa rõ chọn schema thế nào, chia tệp ra sao, và làm gì khi một lô có cột khác các lô trước.
Đầu ra nghiệm thu
Đầu ra gồm schema cố định cho dữ liệu crawl, cấu hình row group và nén đã đo, một thư mục nhiều lô chia theo ngày, và ca lô có schema lệch cùng cách phát hiện. Mỗi khuyến nghị phải có con số đo từ lab.
Ranh giới với JSONL và DuckDB
JSONL là định dạng dòng, dễ ghi từng bản ghi, hợp với bước crawl đang chạy. DuckDB là công cụ truy vấn, đọc được cả JSONL lẫn Parquet. Bài này bàn định dạng lưu trữ dài hạn: Parquet ghi thế nào để đọc về sau nhanh và đúng. Câu lệnh truy vấn bằng DuckDB hay Polars không phải trọng tâm.
Phiên bản đã khóa
Lab dùng pyarrow 26.0.1, Python 3.12 trên Windows. Mọi dung lượng và số row group trong bài lấy từ lần chạy này. Thư viện khác như Spark hay Polars ghi Parquet với mặc định khác, nên con số có thể khác.
Ai nên đọc
Người đang lưu dữ liệu crawl bằng JSONL hay CSV và thấy thư mục phình nhanh. Người đã chuyển sang Parquet nhưng chưa nghĩ tới schema giữa các lô. Người cần đọc nhanh một khoảng thời gian trong dữ liệu nhiều tháng.
Khi nào chưa nên dùng Parquet
Parquet ghi theo khối, không hợp để thêm từng dòng một khi crawler đang chạy. Bước crawl nên ghi JSONL hoặc ghi vào hàng đợi, rồi một bước riêng gom lại thành Parquet theo lô. Nếu dữ liệu chỉ vài trăm dòng mỗi ngày, lợi ích của Parquet nhỏ, CSV hay JSONL vẫn đủ dùng.
Dữ liệu lab là dữ liệu giả
Ba lô được sinh bằng mã, mỗi lô 60.000 dòng, ba tên miền xoay vòng, giá tăng theo công thức, cứ 50 dòng có một dòng mã 404. Dữ liệu giả có tính lặp cao hơn dữ liệu thật, nên tỷ lệ nén trong lab có thể tốt hơn thực tế. Cấu trúc và cách đọc thì giống dữ liệu thật.
Chọn schema và row group Parquet cho dữ liệu crawl nhiều lô với Apache Parquet lưu dữ liệu crawl
Trước khi ghi, cần nắm vài khái niệm của Parquet.
Định dạng cột
Theo trang Overview của dự án Apache Parquet, Parquet là định dạng lưu trữ dạng cột, mã nguồn mở. Nó được thiết kế để lưu và truy xuất dữ liệu hiệu quả, có cơ chế nén và mã hóa cho dữ liệu lớn. Dữ liệu cùng cột nằm cạnh nhau trên đĩa. Đọc ba cột trong mười cột chỉ đọc khoảng ba phần mười dữ liệu.
Row group
Tệp Parquet chia dòng thành các row group. Mỗi row group chứa một đoạn dòng, bên trong chia theo cột. Mỗi cột trong mỗi row group có thống kê như giá trị nhỏ nhất và lớn nhất. Trình đọc dùng thống kê này để bỏ qua row group không thể chứa dữ liệu cần tìm.
Schema đi cùng tệp
Mỗi tệp Parquet lưu schema của nó: tên cột, kiểu dữ liệu, có cho phép rỗng không. Đây là ưu điểm lớn so với CSV, nơi kiểu dữ liệu phải đoán. Nhưng mỗi tệp có schema riêng, và không có gì bắt buộc các tệp trong cùng thư mục có schema giống nhau.
Schema cố định cho dữ liệu crawl
SCHEMA = pa.schema([
    ("url", pa.string()), ("domain", pa.string()),
    ("product_id", pa.int64()), ("price", pa.int64()),
    ("currency", pa.string()), ("status", pa.int16()),
    ("fetched_at", pa.timestamp("us", tz="UTC"))])
Giá là số nguyên tính bằng đồng, không phải chuỗi có dấu chấm. Mã trạng thái là số nguyên 16 bit. Thời điểm tải có múi giờ UTC. Schema này được khai báo một lần và dùng cho mọi lô.
Vì sao giá là số nguyên
Giá dạng chuỗi như 150.000đ không lọc được theo khoảng, không cộng được, và chiếm nhiều chỗ hơn. Chuyển sang số nguyên ở bước parse, trước khi ghi Parquet. Nếu giá có phần lẻ, dùng decimal thay cho số thực để tránh sai số làm tròn.
Cột nào nên có
Ngoài các cột trong lab, dữ liệu crawl thường cần mã lần chạy để truy về nhật ký, vùng tải nếu crawl qua nhiều vùng, và mã băm nội dung trang để phát hiện trang không đổi. Mỗi cột thêm vào nên có lý do sử dụng rõ. Cột không ai đọc chỉ làm tệp lớn hơn.
Rỗng có chủ ý
Schema của lab cho phép mọi cột rỗng, mặc định của pyarrow. Giá rỗng với trang 404 là hợp lý. URL rỗng thì không. Có thể khai báo cột url không được rỗng để pyarrow chặn ngay lúc tạo bảng. Lab chưa đặt ràng buộc này.
Vì sao thời điểm có múi giờ
Cột thời điểm không có múi giờ sẽ được mỗi công cụ hiểu theo cách riêng. Một công cụ coi là giờ địa phương, công cụ khác coi là UTC. Ghi rõ UTC trong schema loại bỏ sự mơ hồ này ngay từ tệp.
Thiết kế schema, nén và row group đã đo cho Apache Parquet lưu dữ liệu crawl
Phần này ghi lô đầu tiên với nhiều cấu hình và so dung lượng.
JSONL làm mốc
Lô 1 ghi ra JSONL nặng 10.290 KB. Mỗi dòng lặp lại tên trường, giá dạng số trong văn bản, thời điểm dạng chuỗi ISO. Đây là mốc để so.
Bốn cấu hình Parquet
Nén |
row_group_size |
Dung lượng |
Số row group |
|---|---|---|---|
snappy |
1.000.000 |
1.549 KB |
1 |
snappy |
10.000 |
1.551 KB |
6 |
zstd |
1.000.000 |
911 KB |
1 |
zstd |
10.000 |
770 KB |
6 |
zstd nhỏ hơn snappy gần một nửa
Với cùng row group, zstd cho tệp khoảng 50 tới 59 phần trăm dung lượng snappy. snappy nhanh hơn khi nén và giải nén, zstd nén chặt hơn. Với dữ liệu lưu dài hạn và đọc không quá thường xuyên, zstd thường là lựa chọn hợp lý. Lab không đo tốc độ, chỉ đo dung lượng.
Đo trên dữ liệu thật
Con số trong bảng đúng với dữ liệu giả của lab. Dữ liệu thật có URL dài ngắn khác nhau, giá phân tán hơn, có cột văn bản như tên sản phẩm. Trước khi chốt cấu hình, lấy một lô thật, ghi với hai ba cấu hình, so dung lượng và thời gian đọc một truy vấn thường dùng. Việc này mất vài phút.
Row group nhỏ không làm tệp lớn hơn đáng kể
Với snappy, sáu row group chỉ lớn hơn một row group 2 KB. Với zstd, sáu row group còn nhỏ hơn, 770 KB so với 911 KB. Kết quả thứ hai bất ngờ, có thể do dữ liệu giả có tính chu kỳ, mỗi đoạn nhỏ nén tốt hơn. Với dữ liệu thật, đừng giả định row group nhỏ luôn nhỏ hơn. Nên đo trên dữ liệu của mình.
Nén không thay được schema tốt
Chọn kiểu đúng tiết kiệm nhiều hơn chọn nén. Giá dạng số nguyên chiếm 8 byte trước nén, dạng chuỗi có thể chiếm gấp đôi. Mã trạng thái dạng int16 chỉ 2 byte. Làm đúng schema trước, rồi mới tinh chỉnh nén.
So với JSONL
Tệp zstd sáu row group bằng khoảng 7,5 phần trăm tệp JSONL. Phần lớn chênh lệch đến từ việc không lặp tên trường, lưu số dạng nhị phân, và mã hóa từ điển cho cột lặp lại.
Mã hóa từ điển
Mã hóa từ điển
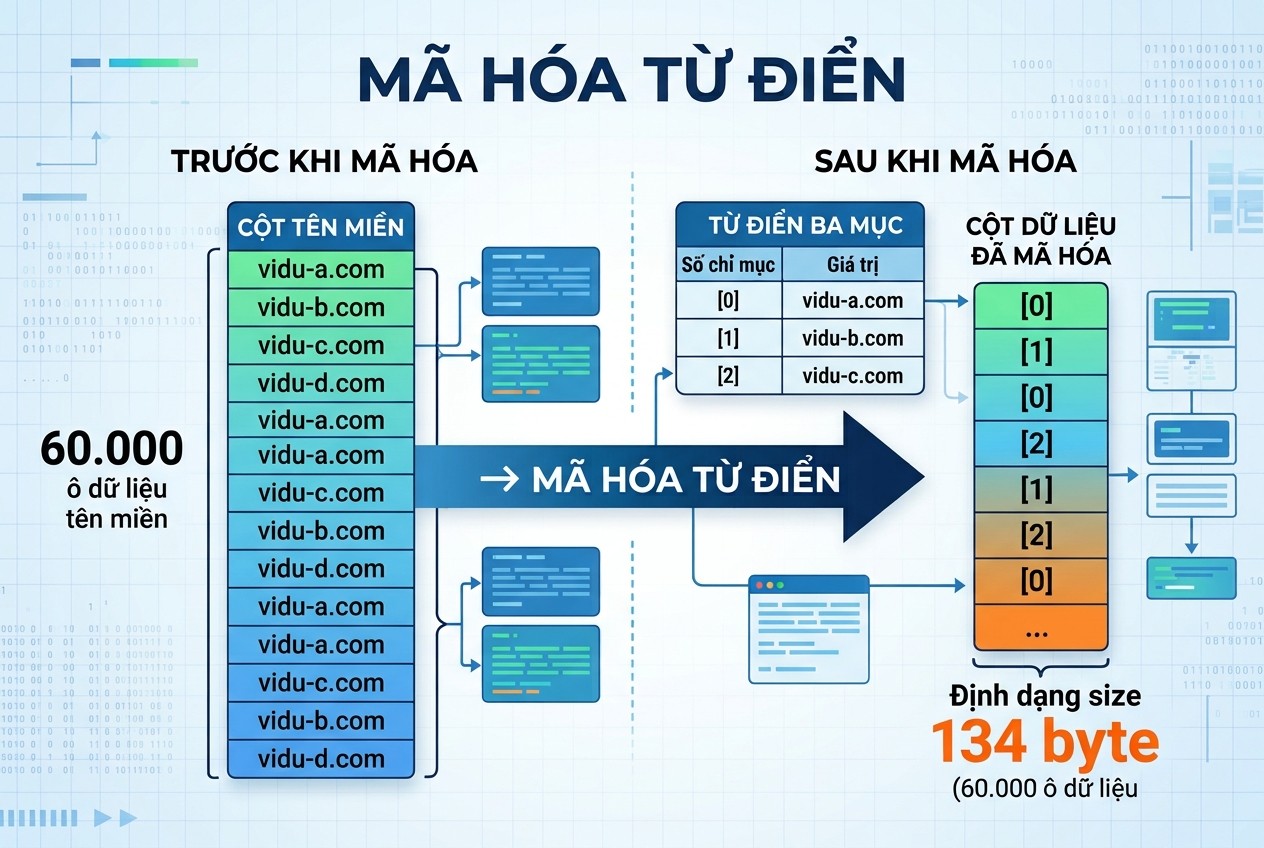
Cột domain chỉ có ba giá trị khác nhau trong 60.000 dòng. Parquet tự dùng mã hóa từ điển: lưu ba chuỗi một lần, rồi lưu chỉ số cho từng dòng. Siêu dữ liệu của row group đầu ghi các mã hóa PLAIN, RLE và RLE_DICTIONARY cho cột này, và kích thước nén chỉ 134 byte cho 10.000 dòng.
Cột currency chỉ có một giá trị, cũng được nén gần như bằng không. Đây là lý do không cần lo việc lặp tên miền hay đơn vị tiền trong từng dòng.
Mức nén của zstd
zstd có nhiều mức nén, mức cao nén chặt hơn nhưng chậm hơn. pyarrow cho đặt mức qua tham số compression_level. Lab dùng mức mặc định. Với lưu trữ dài hạn ghi một lần đọc nhiều lần, có thể tăng mức nén. Nên đo trên dữ liệu thật trước khi đổi.
URL là cột nặng nhất
Cột url mỗi dòng một giá trị khác, không hưởng lợi từ từ điển. Nó chiếm phần lớn dung lượng tệp. Nếu URL có tiền tố chung dài, có thể tách thành cột domain và cột path để mỗi phần nén tốt hơn. Lab giữ nguyên URL đầy đủ.
Thống kê row group và đọc chọn lọc theo thời gian với Apache Parquet lưu dữ liệu crawl
Phần này đo việc bỏ qua row group khi lọc.
Thống kê của từng row group
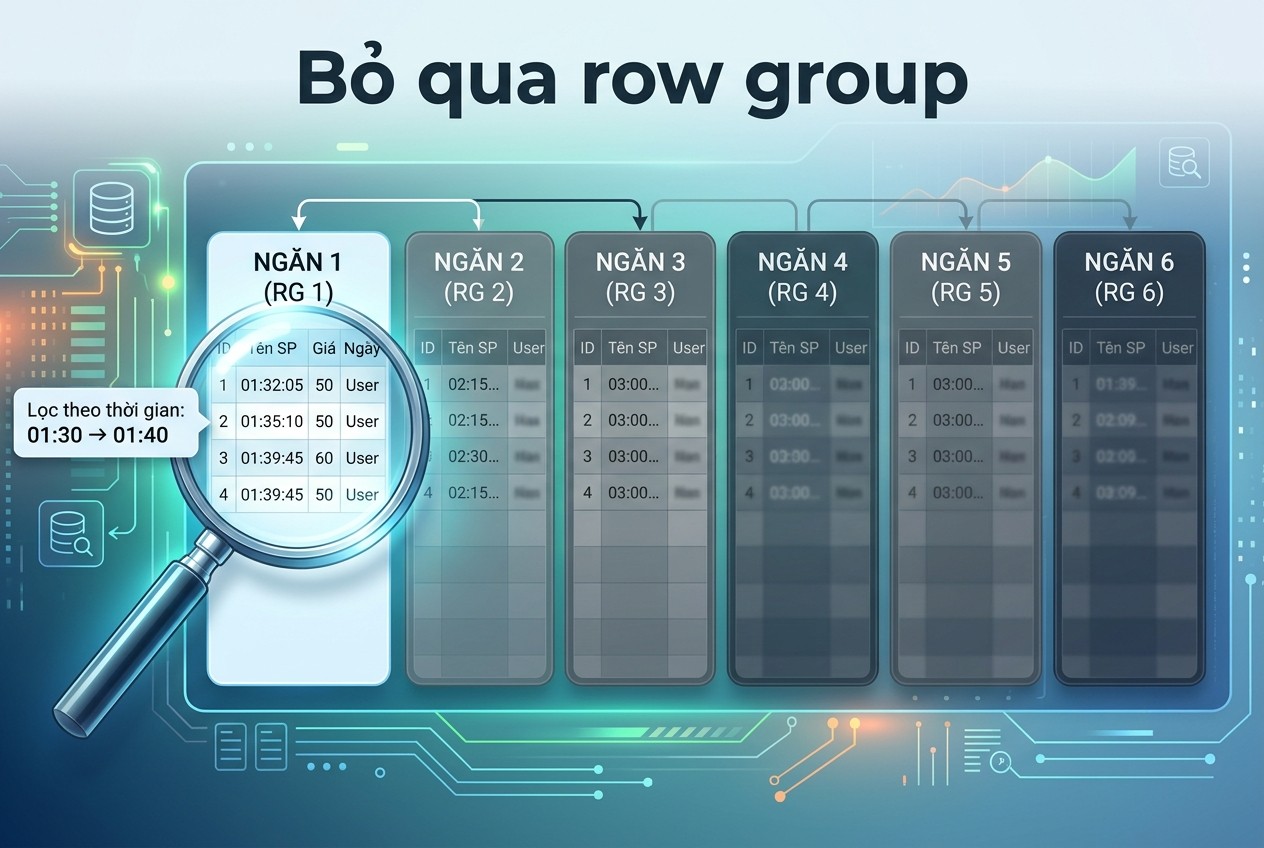
Trong tệp zstd sáu row group, row group 0 có fetched_at từ 01:00:00 tới 03:46:39 ngày 01/11 UTC. Row group 5 có fetched_at từ 14:53:20 tới 17:39:59. Mỗi row group phủ một khoảng thời gian không chồng lấn, vì dữ liệu được ghi theo thứ tự thời gian.
Lọc 10 phút
Bỏ qua row group
Lab lọc khoảng 01:30 tới 01:40. So khoảng này với min và max của từng row group, chỉ row group 0 có thể chứa dữ liệu. Năm row group còn lại bị loại mà không cần đọc. Truy vấn trả 601 dòng.
Một row group thì không bỏ qua được gì
Với tệp một row group, mọi truy vấn đều phải đọc cả tệp, vì thống kê duy nhất phủ cả ngày. Row group nhỏ hơn cho phép trình đọc bỏ qua nhiều hơn. Đổi lại, quá nhiều row group nhỏ làm siêu dữ liệu lớn và mỗi lần đọc nhiều mẩu nhỏ.
Thứ tự ghi quyết định hiệu quả
Thống kê chỉ hữu ích khi dữ liệu trong mỗi row group tập trung trong một khoảng. Lab ghi theo thời gian tải, nên lọc theo thời gian hiệu quả. Nếu ghi theo thứ tự ngẫu nhiên, mỗi row group phủ cả ngày, không bỏ qua được gì. Nếu hay lọc theo tên miền, nên sắp theo tên miền trước khi ghi.
Chọn row_group_size
Không có con số đúng cho mọi trường hợp. Với dữ liệu crawl vài chục nghìn dòng mỗi lô, row group vài nghìn tới vài chục nghìn dòng cho phép lọc theo giờ. Với dữ liệu hàng triệu dòng mỗi lô, row group lớn hơn. Nên chọn sao cho một row group tương ứng với khoảng thời gian mà truy vấn thường lọc.
Kiểm row group bằng siêu dữ liệu
Lab đếm row group cần đọc bằng cách so khoảng lọc với min và max trong siêu dữ liệu, không đọc dữ liệu. Đây cũng là cách trình đọc làm. Muốn biết một truy vấn có tận dụng được thống kê không, chỉ cần đọc siêu dữ liệu của tệp và xem khoảng giá trị của cột lọc trong từng row group.
Đọc chọn cột
Ngoài bỏ qua row group, Parquet còn bỏ qua cột. Truy vấn chỉ cần url của các dòng 404 đọc cột status để lọc và cột url để trả về, không đọc giá, thời điểm hay tên miền. Đây là lợi ích tự nhiên của định dạng cột.
Siêu dữ liệu ở cuối tệp
Parquet lưu siêu dữ liệu, gồm schema và thống kê row group, ở cuối tệp. Trình đọc đọc phần cuối trước, quyết định row group nào cần, rồi mới đọc phần dữ liệu tương ứng. Đây là lý do tệp Parquet ghi dở không đọc được: thiếu phần cuối thì không có siêu dữ liệu. Ghi vào tệp tạm rồi đổi tên giúp tránh tệp dở trong thư mục.
Lọc trên cột không sắp xếp
Lọc theo status bằng 404 không bỏ qua được row group nào, vì mỗi row group đều có dòng 404. Thống kê min bằng 200, max bằng 404 ở mọi row group. Trình đọc vẫn phải đọc cột status của mọi row group. Bỏ qua chỉ hiệu quả với cột có giá trị tập trung theo row group.
Ghi nhiều lô theo thư mục ngày với Apache Parquet lưu dữ liệu crawl
Phần này ghi nhiều lô vào cùng một thư mục chia theo ngày.
Chia thư mục kiểu hive
t = table.append_column("ngay", pa.array(["2026-11-01"] * len(table)))
pq.write_to_dataset(t, "kho", partition_cols=["ngay"],
                    compression="zstd", row_group_size=10000)
write_to_dataset tạo thư mục con dạng ngay bằng 2026-11-01 và ghi tệp vào đó. Cột ngay không được lưu trong tệp, mà nằm trong tên thư mục. Khi đọc với partitioning hive, cột này được dựng lại từ tên thư mục.
Cột phân vùng là chuỗi
Cột ngay trong lab là chuỗi dạng năm tháng ngày. Khi đọc với partitioning hive, pyarrow có thể suy kiểu cho cột phân vùng. So sánh chuỗi ngày theo thứ tự từ điển vẫn đúng vì định dạng năm trước, tháng sau, ngày cuối. Dùng định dạng khác như ngày trước tháng sau sẽ làm lọc theo khoảng sai.
Đọc thư mục
Sau khi ghi lô 1 và lô 2, đọc thư mục bằng pyarrow.dataset thấy hai tệp, schema có tám cột gồm cả ngay. Lọc ngày 02/11 và status 404 trả 1.200 dòng. Thư mục ngày 01/11 không được mở, vì bộ lọc theo ngay loại nó ngay từ tên thư mục.
Bỏ qua cả thư mục
Lọc theo cột phân vùng là cách bỏ qua dữ liệu mạnh nhất: không mở tệp, không đọc siêu dữ liệu. Với dữ liệu crawl nhiều tháng, phân vùng theo ngày cho phép đọc một ngày mà không chạm tới các ngày khác.
Không phân vùng quá nhỏ
Phân vùng theo ngày và tên miền sẽ tạo nhiều thư mục nhỏ. Mỗi thư mục một tệp nhỏ, nhiều tệp nhỏ làm việc liệt kê và mở tệp chậm. Với vài tên miền, phân vùng theo ngày là đủ, tên miền để thống kê row group lo.
Tên tệp do thư viện đặt
write_to_dataset đặt tên tệp ngẫu nhiên trong mỗi thư mục phân vùng. Khó biết tệp nào thuộc lần ghi nào. Nếu cần truy vết, có thể đặt mẫu tên tệp chứa mã lần chạy qua tham số của thư viện, hoặc tự ghi từng tệp bằng write_table với tên do mình đặt. Lab dùng tên mặc định.
Ghi thêm lô mới
Mỗi lần gọi write_to_dataset ghi thêm tệp mới vào thư mục phân vùng tương ứng, không đụng tệp cũ. Ghi lại cùng một ngày hai lần sẽ có hai tệp trong cùng thư mục, và dữ liệu bị nhân đôi khi đọc. Pipeline nên xóa thư mục ngày trước khi ghi lại ngày đó.
Kiểm lô có schema lệch khi đọc nhiều tệp Parquet với Apache Parquet lưu dữ liệu crawl
Phần này cố ý ghi một lô có schema khác.
Lô 3 lệch schema
Lô 3 được tạo không qua SCHEMA cố định: giá là chuỗi như 100000, và có thêm cột in_stock. pyarrow tự suy kiểu: price là string. Lô được ghi vào thư mục ngày 03/11 như hai lô trước.
Schema của thư mục lấy từ tệp đầu
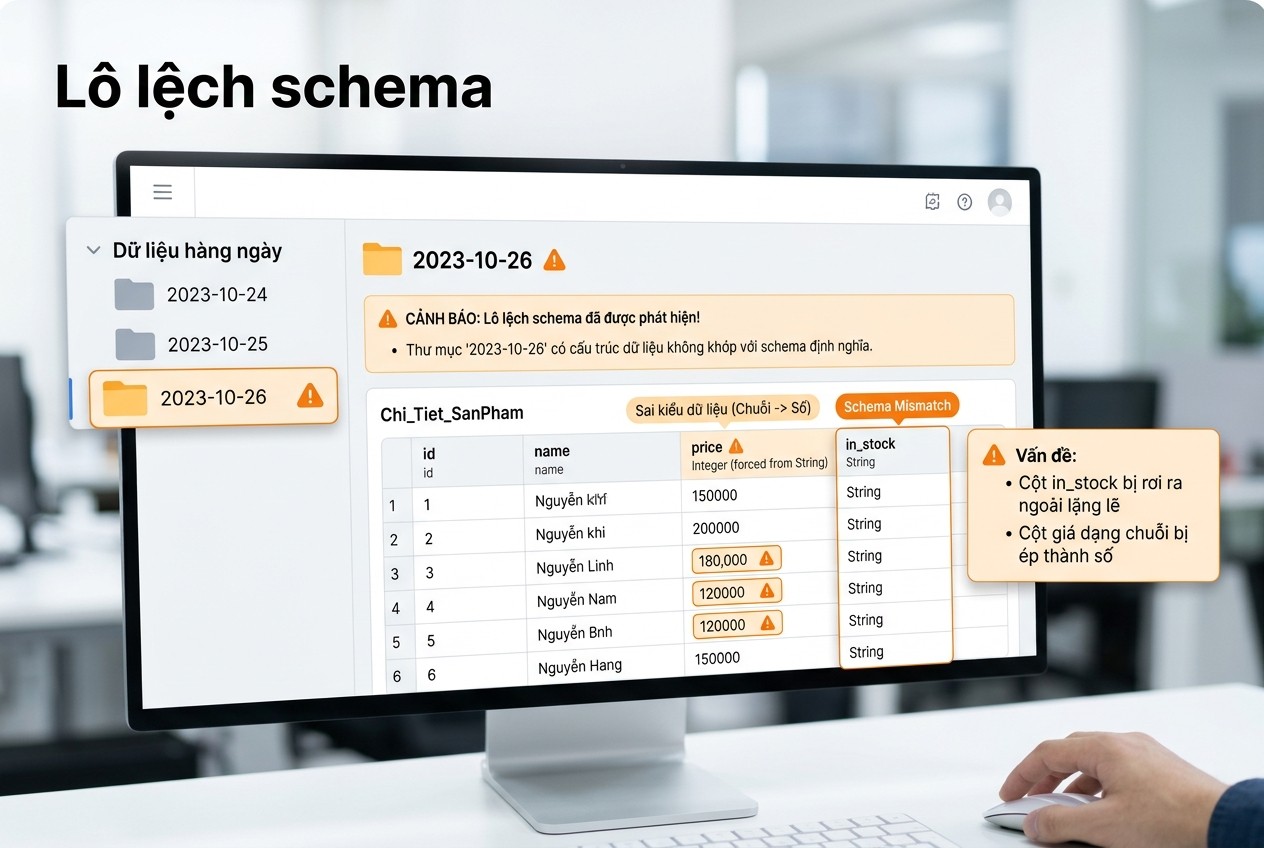
Đọc thư mục, schema của dataset có price kiểu int64 và không có cột in_stock. pyarrow lấy schema từ tệp đầu tiên nó gặp, không gộp schema của mọi tệp. Cột in_stock của lô 3 không xuất hiện.
Đọc toàn thư mục không báo lỗi
Lô lệch schema
Đọc toàn bộ thư mục trả 180.000 dòng. Không có lỗi, không có cảnh báo. Giá của lô 3 được ép từ chuỗi sang int64: ba giá trị đầu là 100000, 100037, 100074, đúng như mong muốn vì chuỗi chỉ chứa chữ số. Cột in_stock bị bỏ qua lặng lẽ.
Đây là hành vi nguy hiểm nhất của lab. Dữ liệu có vẻ đúng, nhưng một cột đã mất, và việc ép kiểu thành công chỉ vì chuỗi tình cờ là số.
Khi chuỗi không phải số
Lab ghi thêm một tệp ngày 04/11 với giá là chuỗi 150.000đ. Đọc toàn thư mục lần này báo ArrowInvalid: không phân tích được chuỗi 150.000đ thành int64. Cả truy vấn thất bại, kể cả phần dữ liệu của các ngày khác.
Một lô hỏng làm hỏng mọi truy vấn trên toàn thư mục. Lỗi xuất hiện lúc đọc, có thể nhiều ngày sau lúc ghi, khi người ghi đã quên lô đó có gì đặc biệt.
Ép schema khi đọc
Lab đọc lại với schema khai báo rõ, gồm cả in_stock. Kết quả 180.000 dòng, cột in_stock có giá trị cho lô 3 và rỗng cho hai lô trước. Khai báo schema khi đọc giúp thấy cột mới, nhưng không chặn được dữ liệu sai kiểu.
Chặn ở lúc ghi
Cách đúng là kiểm schema trước khi ghi. Tạo bảng bằng from_pydict với schema cố định: nếu dữ liệu không khớp, lỗi xảy ra ngay lúc tạo bảng, lô bị chặn, không vào thư mục. Lô 1 và 2 trong lab được tạo theo cách này. Lô 3 bỏ qua bước này nên lọt vào.
Kiểm schema của thư mục định kỳ
Một tập lệnh nhỏ đọc schema của từng tệp trong thư mục và so với schema cố định sẽ phát hiện lô lệch trước khi ai đó truy vấn. pyarrow.parquet.read_schema đọc schema mà không đọc dữ liệu, rất nhanh. Chạy tập lệnh này sau mỗi lần ghi là cách rẻ để bắt lỗi như lô 3.
Thêm cột có chủ ý
Khi thật sự cần thêm cột như in_stock, cập nhật schema cố định, ghi chú phiên bản schema, và khai báo schema mới khi đọc. Lô cũ không có cột đó sẽ đọc ra giá trị rỗng. Đây là tiến hóa schema có kiểm soát, khác với để mỗi lô tự suy schema.
Đầu ra nghiệm thu: schema, row group và ca lô lệch schema của Apache Parquet lưu dữ liệu crawl
Phần cuối gom kết quả thành bộ bàn giao.
Bộ bàn giao
Bộ bàn giao gồm lab.py và lab2.py, thư mục out với tệp JSONL đối chứng, bốn tệp Parquet cấu hình khác nhau, và thư mục kho chia theo ngày. Người nhận chạy lại hai tệp, phải thấy đúng bảng dung lượng, lọc 10 phút chỉ đọc 1 trên 6 row group, lô 3 làm mất cột in_stock khi đọc mặc định, lô 4 làm hỏng truy vấn.
Tiêu chí đạt
Schema khai báo một lần và dùng khi ghi mọi lô. Nén zstd với row group phù hợp khoảng lọc. Thư mục chia theo ngày. Lô không khớp schema bị chặn trước khi ghi. Khi đọc, schema được khai báo rõ.
Quy tắc ghi Parquet cho dữ liệu crawl
Chuẩn hóa kiểu ở bước parse. Tạo bảng với schema cố định. Sắp dữ liệu theo cột hay lọc trước khi ghi. Chọn row group theo khoảng lọc. Phân vùng theo ngày. Xóa thư mục ngày trước khi ghi lại. Ghi phiên bản schema khi thêm cột.
Khi nào cần proxy với Apache Parquet lưu dữ liệu crawl
Parquet là định dạng tệp, ghi và đọc không cần mạng, không cần proxy. Proxy chỉ liên quan tới bước crawl trước đó. Có một liên hệ gián tiếp: nếu crawl qua nhiều vùng IP và giá khác nhau theo vùng, nên có cột vùng tải trong schema để không trộn giá của hai vùng trong cùng phân tích.
Với website được phép thu thập nhưng hiển thị giá theo vùng, có lúc cần IP tại Việt Nam để lấy đúng giá trong nước. Khi đó anh em có thể mua proxy tĩnh Việt Nam tại trang chủ ProxyVN. Proxy không làm tệp Parquet nhỏ hơn và không sửa schema lệch. Vai trò hợp lệ của proxy được phân tích ở bài Web Scraping proxy là gì.
Không lưu cấu hình proxy trong dữ liệu
Nếu muốn ghi lại lô nào crawl qua cấu hình mạng nào, chỉ ghi nhãn như vn-static. Không ghi chuỗi proxy có mật khẩu vào cột hay vào siêu dữ liệu của tệp Parquet, vì tệp dữ liệu thường được chép đi nhiều nơi. Cách viết chuỗi proxy đúng định dạng có trong bài định dạng proxy.
Định dạng bảng giải quyết gì
Iceberg, Delta Lake và Hudi thêm một lớp quản lý trên các tệp Parquet: ghi nhận schema của bảng, kiểm schema khi ghi, cho phép thêm cột có kiểm soát, xóa và cập nhật dòng. Với dữ liệu crawl lớn và nhiều người cùng ghi, lớp này đáng cân nhắc. Với một pipeline nhỏ, schema cố định và kiểm định kỳ như lab là đủ.
Những gì lab chưa thử
Lab chưa đo tốc độ ghi và đọc, chưa thử Parquet với Spark hay Polars, chưa thử định dạng bảng như Iceberg hay Delta vốn quản lý schema giữa các lô. Lab chưa thử cột lồng nhau như danh sách ảnh của sản phẩm. Dữ liệu giả có tính lặp cao, tỷ lệ nén thật có thể thấp hơn.
Checklist Apache Parquet lưu dữ liệu crawl
Checklist
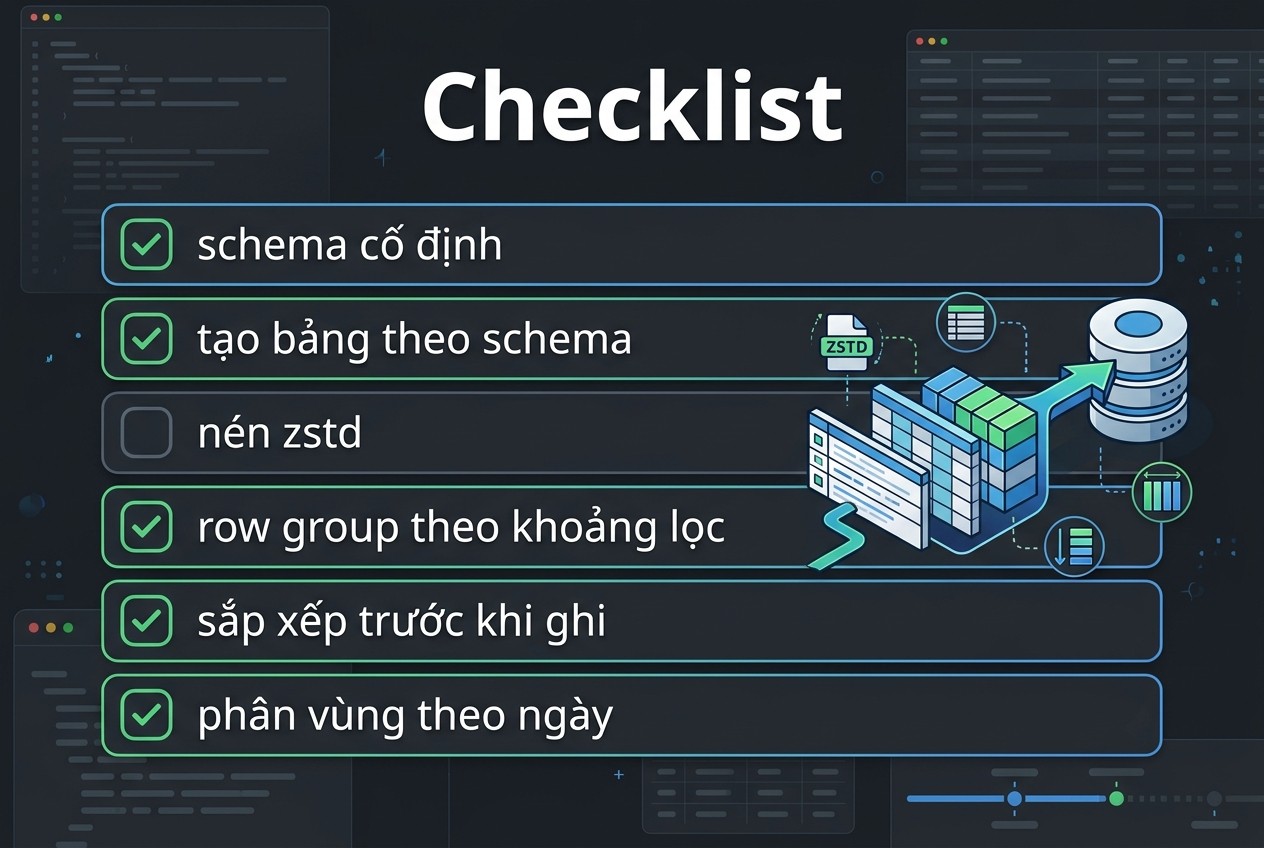
- Schema cố định, giá số nguyên, thời điểm UTC.
- Tạo bảng với schema để chặn lô lệch ngay lúc ghi.
- Nén zstd cho lưu trữ dài hạn.
- row_group_size theo khoảng thời gian hay lọc.
- Sắp dữ liệu theo cột lọc chính trước khi ghi.
- Phân vùng theo ngày, không phân vùng quá nhỏ.
- Xóa thư mục ngày trước khi ghi lại.
- Khai báo schema khi đọc thư mục nhiều lô.
Câu hỏi thường gặp về Apache Parquet lưu dữ liệu crawl
Parquet nhỏ hơn JSONL bao nhiêu?
Trong lab, lô 60.000 dòng từ 10.290 KB JSONL xuống 770 KB Parquet nén zstd, khoảng 7,5 phần trăm.
Nên dùng snappy hay zstd?
Lab đo zstd nhỏ hơn snappy gần một nửa. snappy nhanh hơn, zstd hợp lưu trữ dài hạn.
Row group dùng để làm gì?
Để trình đọc bỏ qua phần dữ liệu không cần. Lab lọc 10 phút chỉ phải đọc 1 trên 6 row group.
Đọc nhiều tệp có schema khác nhau thì sao?
pyarrow lấy schema từ tệp đầu. Lab thấy cột mới bị bỏ qua lặng lẽ, còn chuỗi không phải số làm hỏng cả truy vấn.
Nên phân vùng theo gì?
Theo ngày là đủ cho dữ liệu crawl hằng ngày. Phân vùng quá nhỏ tạo nhiều tệp nhỏ, đọc chậm.
Parquet có cần proxy không?
Không. Chỉ bước crawl trước đó mới có thể cần.
Apache Parquet lưu dữ liệu crawl và những điều cần nhớ
Apache Parquet lưu dữ liệu crawl giảm dung lượng tới hơn mười lần và cho đọc chọn lọc theo cột, theo row group, theo ngày. Lab trên pyarrow 26.0.1 cho thấy zstd nhỏ hơn snappy gần một nửa, lọc theo thời gian bỏ qua năm trên sáu row group, nhưng lô có schema lệch thì mất cột lặng lẽ hoặc làm hỏng mọi truy vấn. Khóa schema ngay lúc ghi là việc quan trọng hơn mọi tinh chỉnh nén. Cần IP tĩnh cho bước crawl trước khi ghi Apache Parquet lưu dữ liệu crawl, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


