
Aider đọc nội dung web: dùng /web, proxy và giới hạn JavaScript
Aider đọc nội dung web bằng lệnh /web: tải một trang, đổi sang markdown rồi gửi vào cuộc trò chuyện để mô hình dùng làm ngữ cảnh khi sửa mã. ProxyVN chạy đúng hàm tải trang của Aider 0.86.2 qua proxy tự dựng, thử 13 ca, ghi lại cái gì thật sự vào ngữ cảnh và chỗ nào JavaScript làm trang trống.
Aider đọc nội dung web là việc của ứng dụng, không phải của mô hình
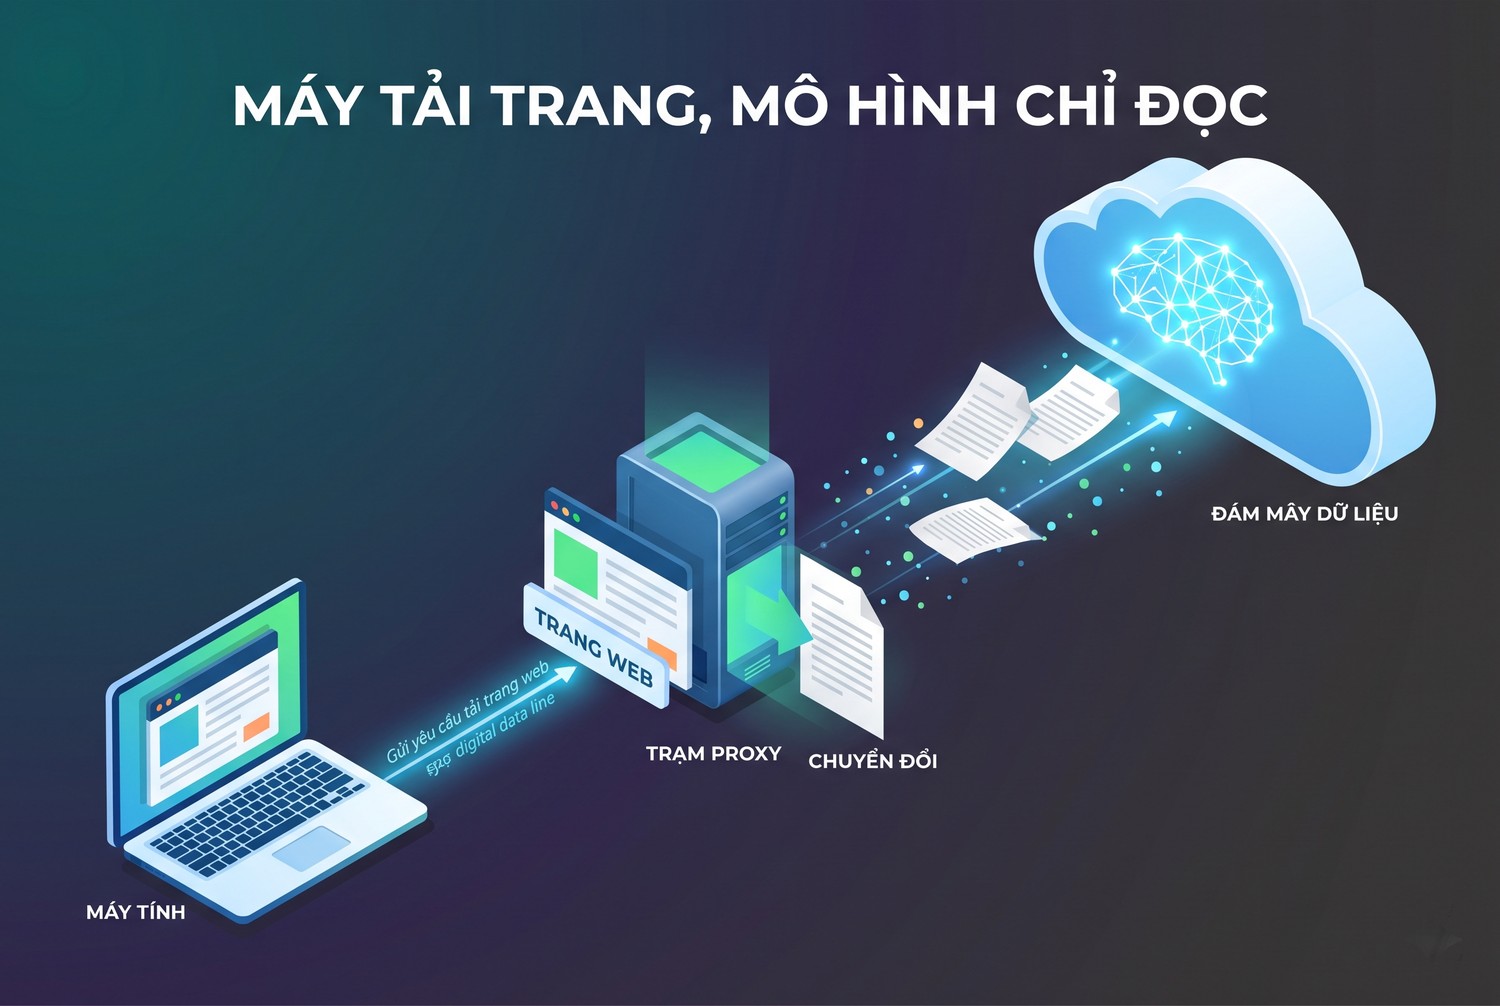
Máy tải trang, mô hình chỉ đọc
Ba thành phần cần tách bạch
Aider là trợ lý lập trình chạy trong terminal, làm việc trực tiếp với kho Git của anh em. Khi nói Aider đọc nội dung web, có ba thành phần khác nhau dễ bị gộp làm một. Thứ nhất là ứng dụng Aider chạy trên máy, thứ hai là mô hình ngôn ngữ ở xa nhận ngữ cảnh, thứ ba là công cụ tải trang mà Aider gọi.
Mô hình không tự lên mạng đọc trang. Chính tiến trình Aider trên máy anh em tải trang về, đổi thành văn bản, rồi gửi văn bản đó kèm câu hỏi tới mô hình. Mọi chuyện về mạng, proxy, chặn truy cập hay trang trống đều xảy ra ở máy của anh em, không xảy ra ở phía nhà cung cấp mô hình.
Hiểu đúng điểm này giúp gỡ lỗi đúng chỗ. Trang không vào được là chuyện của tiến trình Aider và proxy của máy, không phải chuyện của khóa API hay của mô hình.
/web khác tìm kiếm web và khác RAG
Lệnh /web nhận một URL cụ thể. Nó không tìm kiếm, không chọn nguồn, không duyệt nhiều trang. Anh em phải biết trước trang nào cần đưa vào. Đây là khác biệt lớn với các công cụ tìm kiếm web cho agent, nơi agent tự gửi truy vấn tới một API tìm kiếm rồi chọn kết quả.
/web cũng khác RAG. RAG lưu nhiều tài liệu vào kho vector, rồi truy xuất đoạn liên quan theo câu hỏi. /web chỉ dán nguyên nội dung một trang vào ngữ cảnh hiện tại. Bài RAG với dữ liệu web và proxy hợp hơn nếu anh em cần làm việc với hàng trăm trang. Bài này chỉ nói về việc đưa một trang tài liệu được phép vào ngữ cảnh Aider.
Theo trang lệnh của Aider
Trang lệnh trong chat của Aider mô tả /web là lệnh tải một trang web, đổi sang markdown và gửi trong một tin nhắn. Lệnh này đứng cạnh các lệnh như /read-only để thêm tệp tham khảo, /drop để bớt tệp khỏi ngữ cảnh và /tokens để xem ngữ cảnh đang tốn bao nhiêu token.
Ba lệnh /drop, /read-only và /tokens liên quan trực tiếp tới /web. Một trang tài liệu dài có thể chiếm rất nhiều token, đẩy các tệp mã quan trọng ra khỏi tầm chú ý của mô hình. Dùng /tokens ngay sau /web để biết trang vừa thêm nặng bao nhiêu.
Aider đọc nội dung web bằng httpx hoặc Playwright
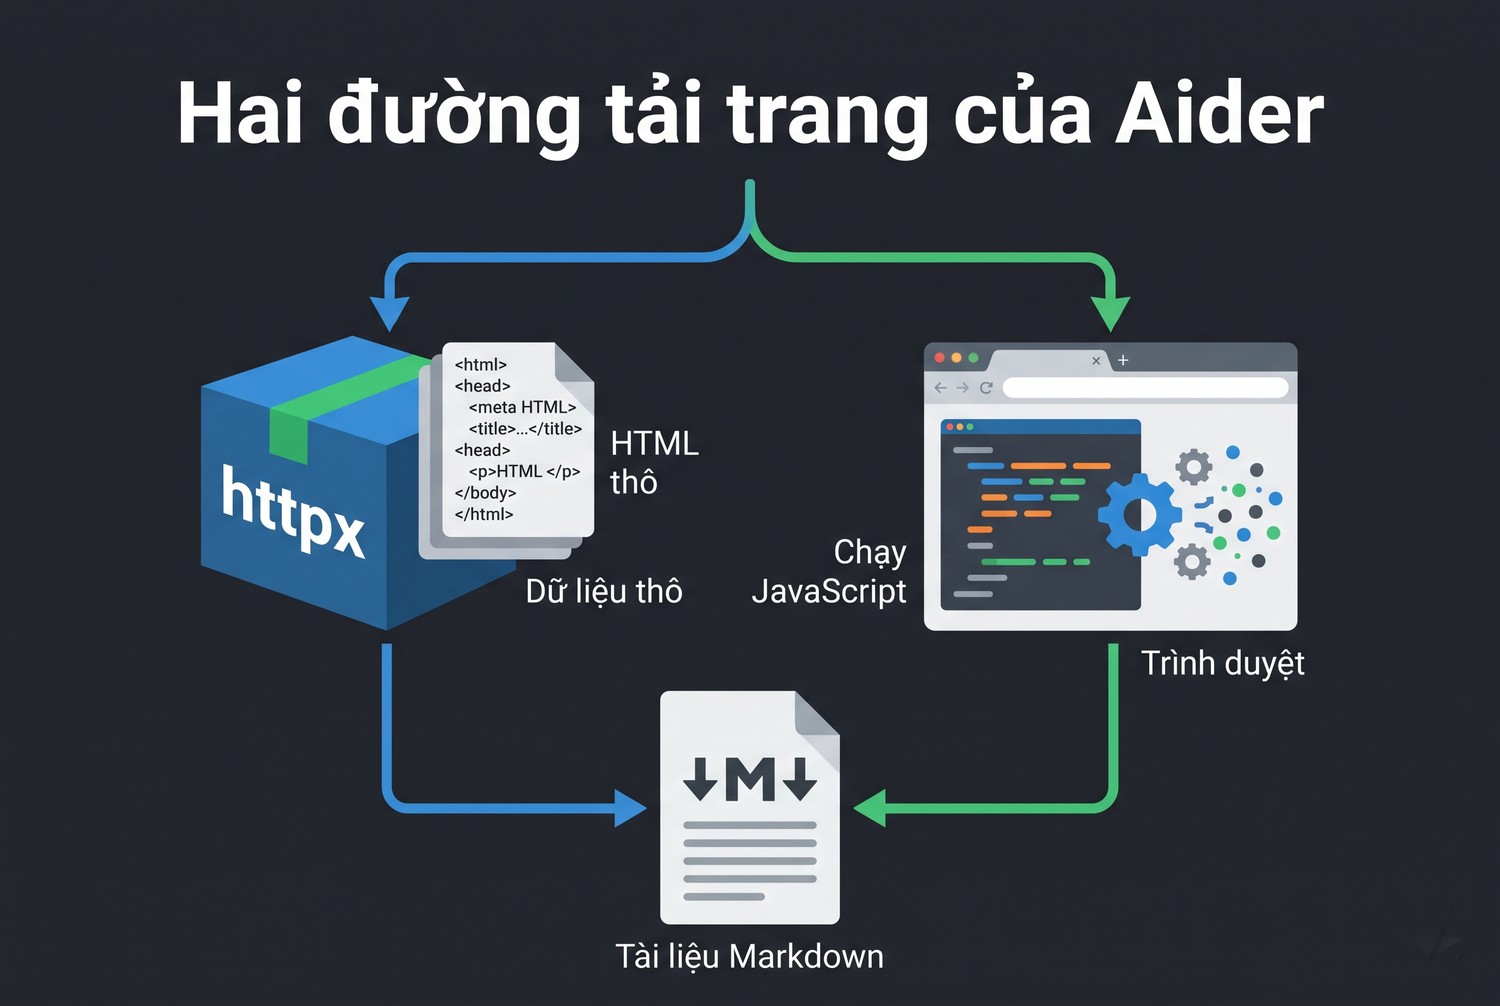
Hai đường tải trang của Aider
Đọc mã nguồn tệp scrape.py
Mình đọc tệp aider/scrape.py ở nhánh main trên GitHub ngày 27/10/2026. Lớp Scraper có hai đường tải trang. Nếu Playwright có sẵn và Chromium khởi chạy được, Aider dùng trình duyệt thật. Nếu không, Aider dùng thư viện httpx để gửi một request GET thường.
Hai đường này khác nhau rất xa. Đường Playwright chạy JavaScript, chờ trang yên mạng tối đa 5 giây rồi lấy nội dung sau khi trang dựng xong. Đường httpx chỉ lấy HTML thô mà máy chủ trả về, không chạy JavaScript nào.
Sau khi có nội dung, nếu kiểu MIME là text/html hoặc nội dung trông giống HTML, Aider làm sạch HTML bằng BeautifulSoup rồi đổi sang markdown bằng pandoc. Nếu không phải HTML, ví dụ JSON hay văn bản thuần, Aider giữ nguyên.
Aider làm sạch HTML ra sao
Hàm slimdown_html trong mã xóa toàn bộ thẻ svg, xóa ảnh đầu tiên, xóa các thẻ có href hoặc src dạng data:, rồi bỏ mọi thuộc tính của mọi thẻ trừ href. Nghĩa là class, id, style, alt đều mất. Liên kết được giữ lại để mô hình biết trang trỏ đi đâu.
Cách làm sạch này giúp giảm token đáng kể, nhưng cũng làm mất thông tin. Bảng dựa vào class để tô màu, mã nguồn được đánh dấu bằng class ngôn ngữ, chú thích ảnh trong alt đều không còn. Khi tài liệu quan trọng nằm ở những chỗ đó, mô hình sẽ không thấy.
User-Agent mà Aider gửi
Đường httpx gửi User-Agent dạng Mozilla./5.0 kèm chuỗi Aider, số phiên bản và địa chỉ website của Aider. Trong lab, trang thử nhận đúng chuỗi này. Đường Playwright lấy User-Agent của Chromium, bỏ chữ Headless, rồi nối thêm chuỗi Aider.
Website có thể dựa vào User-Agent để chặn hoặc trả nội dung khác. Thấy Aider nhận được trang lỗi trong khi trình duyệt xem bình thường, User-Agent là một trong những nguyên nhân cần nghĩ tới, bên cạnh IP và JavaScript.
Chuẩn bị lab để kiểm Aider đọc nội dung web
Bản cài và cách chạy đúng hàm tải trang
Mình tạo một môi trường ảo Python 3.12 trên Windows 10, cài aider-chat 0.86.2 cùng httpx 0.28.1. Để không phải gọi mô hình thật, mình không chạy giao diện chat mà gọi thẳng lớp Scraper trong aider.scrape, đúng hàm mà lệnh /web dùng. Playwright không cài, nên Aider đi đường httpx.
from aider.scrape import Scraper

errors = []
scraper = Scraper(print_error=errors.append, playwright_available=False)
content = scraper.scrape("http://shop.test:8941/doc")
print(content[:200] if content else None, errors)
Trong lab, mình tắt bước pandoc bằng cách thay hàm try_pandoc, vì Aider sẽ tự tải pandoc về nếu máy chưa có. Bước đó không liên quan tới proxy và làm lab chờ lâu. Khi dùng thật, nên cài pandoc sẵn để Aider không phải tải lúc chạy.
Proxy và website thử
Proxy thử là một chương trình Python nghe ba cổng: website thử, proxy HTTP cần tài khoản user1 với mật khẩu p@ss#2026, proxy SOCKS5 cùng tài khoản. Website tên shop.test, chỉ phân giải được bên trong proxy. Request nào đi thẳng sẽ báo lỗi getaddrinfo, request nào qua proxy sẽ có nội dung.
Mình thử thêm https://example.com để xem đường HTTPS qua lệnh CONNECT. Mọi lần kết nối tới proxy đều được ghi vào nhật ký, nên mình đối chiếu được kết quả với đường đi thật.
Repo lab và trang tài liệu được phép
Brief yêu cầu một repo lab và một trang tài liệu. Repo lab là một thư mục Git nhỏ có một tệp Python cần sửa. Trang tài liệu nên là trang anh em có quyền đọc và dùng: tài liệu chính thức của thư viện, trang wiki nội bộ, hoặc một trang tự dựng như shop.test trong lab.
Đừng đưa vào Aider các trang cần đăng nhập, trang chứa dữ liệu khách hàng hay trang mà điều khoản cấm thu thập tự động. Nội dung đưa vào /web sẽ được gửi tới nhà cung cấp mô hình cùng câu hỏi. Đó là một quyết định về dữ liệu, không chỉ là một thao tác kỹ thuật.
Đặt proxy để Aider đọc nội dung web
httpx đọc biến môi trường
Đường httpx của Aider tạo httpx.Client với User-Agent, verify và follow_redirects, không truyền proxy. Khi đó httpx đọc biến môi trường proxy mặc định. Trong lab, đặt HTTP_PROXY rồi gọi Scraper, trang shop.test trả nội dung và nhật ký proxy ghi GET http://shop.test:8941/doc với tài khoản user1.
export HTTP_PROXY="http://user1:p%40ss%232026@127.0.0.1:8942"
export HTTPS_PROXY="http://user1:p%40ss%232026@127.0.0.1:8942"
export NO_PROXY="localhost,127.0.0.1"
aider
Với URL https://example.com và HTTPS_PROXY, nhật ký ghi CONNECT example.com:443 có tài khoản. Không đặt biến nào, cùng URL shop.test báo lỗi getaddrinfo failed, chứng tỏ request đi thẳng.
HTTP_PROXY và HTTPS_PROXY chọn theo URL
httpx chọn biến theo giao thức của URL đích. Trong lab, chỉ đặt HTTPS_PROXY rồi gọi URL http://shop.test, request đi thẳng và lỗi DNS. Muốn mọi trang đi qua proxy, đặt cả hai biến cùng giá trị. Đây là chi tiết dễ quên khi tài liệu nội bộ của công ty vẫn còn trang http.
ALL_PROXY cũng có tác dụng. Chỉ đặt ALL_PROXY, URL http qua proxy bình thường. Với httpx, ALL_PROXY áp cho mọi giao thức khi không có biến riêng.
Mật khẩu có ký tự đặc biệt
Mình thử đặt mật khẩu nguyên văn p@ss#2026 vào URL proxy. Kết quả là lỗi getaddrinfo failed, không có dòng nào trong nhật ký proxy. Chuỗi bị tách sai ở ký tự @ đầu tiên, httpx cố kết nối tới một tên máy không tồn tại.
Cách sửa là mã hóa phần trăm: @ thành %40, # thành %23. Bài định dạng proxy có bảng mã hóa các ký tự hay gặp. Với Aider, chuỗi proxy sai không báo lỗi riêng, nó chỉ hiện thành lỗi tải trang chung.
NO_PROXY
Đặt HTTP_PROXY kèm NO_PROXY=shop.test, request tới shop.test đi thẳng và lỗi DNS, đúng như mong đợi. Với tài liệu nội bộ trên máy chủ trong mạng công ty, thêm tên miền nội bộ vào NO_PROXY để Aider không đẩy chúng ra proxy bên ngoài. Bài no_proxy là gì giải thích cách viết danh sách.
SOCKS5 qua ALL_PROXY
httpx hỗ trợ SOCKS khi có gói socksio. Mình cài socksio rồi đặt ALL_PROXY=socks5h://user1:p%40ss%[email protected]:8943. Trang shop.test tải được, nhật ký SOCKS ghi CONNECT với kiểu địa chỉ domain, nghĩa là tên miền được gửi cho proxy phân giải.
Bản aider-chat 0.86.2 khai socksio trong danh sách phụ thuộc, nên cài đầy đủ thì SOCKS dùng được. Với bản cài thiếu, httpx sẽ báo cần cài gói socks. Bài cách sử dụng SOCKS5 proxy có thêm chi tiết về SOCKS5.
Ghi nhận nội dung khi Aider đọc nội dung web
Bảng 13 ca trong lab
Brief yêu cầu ghi nhận nội dung thật sự được đưa vào. Bảng dưới gom các ca đã chạy, cột cuối là cái Scraper trả về, tức cái sẽ đi vào ngữ cảnh của mô hình.
Ca |
Cấu hình |
Kết quả Scraper trả về |
|---|---|---|
Không proxy |
Không biến nào |
Rỗng, lỗi getaddrinfo failed |
HTTP_PROXY, URL http |
Tài khoản đã mã hóa |
JSON của trang shop.test |
HTTP_PROXY, URL https |
Tài khoản đã mã hóa |
HTML của example.com, qua CONNECT |
Chỉ HTTPS_PROXY, URL http |
Tài khoản đã mã hóa |
Rỗng, đi thẳng |
Chỉ ALL_PROXY, URL http |
Tài khoản đã mã hóa |
JSON của trang |
Sai mật khẩu, URL http |
HTTP_PROXY |
Rỗng, lỗi 407 Proxy Authentication Required |
Sai mật khẩu, URL https |
HTTPS_PROXY |
Rỗng, lỗi 407 Proxy Authentication Required |
Mật khẩu chưa mã hóa |
HTTP_PROXY |
Rỗng, lỗi getaddrinfo failed |
SOCKS5 |
ALL_PROXY socks5h |
JSON của trang |
NO_PROXY chứa host |
HTTP_PROXY và NO_PROXY |
Rỗng, đi thẳng |
Trang trả 404 |
HTTP_PROXY |
Rỗng, lỗi Client error 404 Not Found |
Trang chậm 5 giây |
HTTP_PROXY |
Rỗng, lỗi timed out |
Không proxy, trang không phân giải |
Không biến |
Rỗng |
Điểm chung của mọi ca lỗi: Scraper trả rỗng và in thông báo Failed to retrieve content from cùng URL. Không có nội dung lỗi nào được đưa vào ngữ cảnh. Điều này tốt, vì mô hình không nhận nhầm trang lỗi của proxy làm tài liệu.
Timeout mặc định khoảng 5 giây
Đường httpx của Aider không đặt timeout riêng, nên dùng mặc định của httpx. Theo tài liệu timeout của httpx, mặc định là 5 giây cho các bước. Trong lab, trang chờ 5 giây trước khi trả lời, Aider báo HTTP error occurred: timed out.
Với proxy chậm hoặc trang tài liệu nặng, 5 giây có thể không đủ. Aider không có tùy chọn dòng lệnh để chỉnh timeout của /web, tùy chọn --timeout trong trang cấu hình là timeout cho request tới mô hình. Nếu trang thường quá hạn, cân nhắc tải trang về tệp bằng công cụ khác rồi thêm tệp bằng /read-only.
Mã 4xx và 5xx không vào ngữ cảnh
Aider gọi raise_for_status sau khi nhận response, nên mọi mã 4xx và 5xx thành lỗi. Trang 404 trong lab trả rỗng kèm thông báo Client error 404 Not Found. Với 403 hay 429 từ website, kết quả tương tự: không có nội dung vào ngữ cảnh.
Lỗi 407 cũng đi theo đường này. Với URL http, thông điệp là Client error '407 Proxy Authentication Required'. Với URL https, thông điệp ngắn hơn là 407 Proxy Authentication Required, vì lỗi xảy ra ở bước CONNECT. Bài sửa lỗi 407 Proxy Authentication Required có danh sách nguyên nhân phía nhà cung cấp.
Khi Aider báo Failed to retrieve content, ngữ cảnh không có gì mới. Đọc dòng HTTP error occurred ngay trước đó để biết lỗi nằm ở proxy, ở DNS hay ở website.
Đo lượng token một trang chiếm
Một trang tài liệu thư viện trung bình sau khi làm sạch và đổi sang markdown vẫn có thể dài vài nghìn tới vài chục nghìn token. Bảng tham số, ví dụ mã và mục lục bên cạnh đều nằm trong đó. Với mô hình có cửa sổ ngữ cảnh lớn, con số này không làm lỗi, nhưng làm chi phí mỗi câu hỏi tăng và làm phần mã nguồn quan trọng bị loãng.
Mình khuyên chọn trang con cụ thể thay vì trang mục lục. Ví dụ muốn sửa mã theo một hàm mới, dùng URL trang tham chiếu của đúng hàm đó, không dùng trang chủ tài liệu. Trang càng sát câu hỏi thì mô hình càng ít đoán.
Khi so hai lần /web của cùng một trang, một lần qua proxy và một lần đi thẳng, lượng token nên gần bằng nhau. Nếu lần qua proxy nhỏ hơn hẳn, có thể website trả trang khác cho IP của proxy, ví dụ trang xác minh hay trang thông báo vùng. Mở trang bằng trình duyệt qua cùng proxy để xem website thật sự trả gì.
Phiên bản tài liệu
Tài liệu trên web thường là bản mới nhất, còn dự án có thể đang ghim một bản cũ của thư viện. Đưa trang tài liệu mới vào ngữ cảnh có thể khiến mô hình viết mã dùng API chưa có trong bản đang cài. Khi thư viện có tài liệu theo phiên bản, dùng URL của đúng bản đang ghim trong tệp phụ thuộc.
Giới hạn JavaScript khi Aider đọc nội dung web
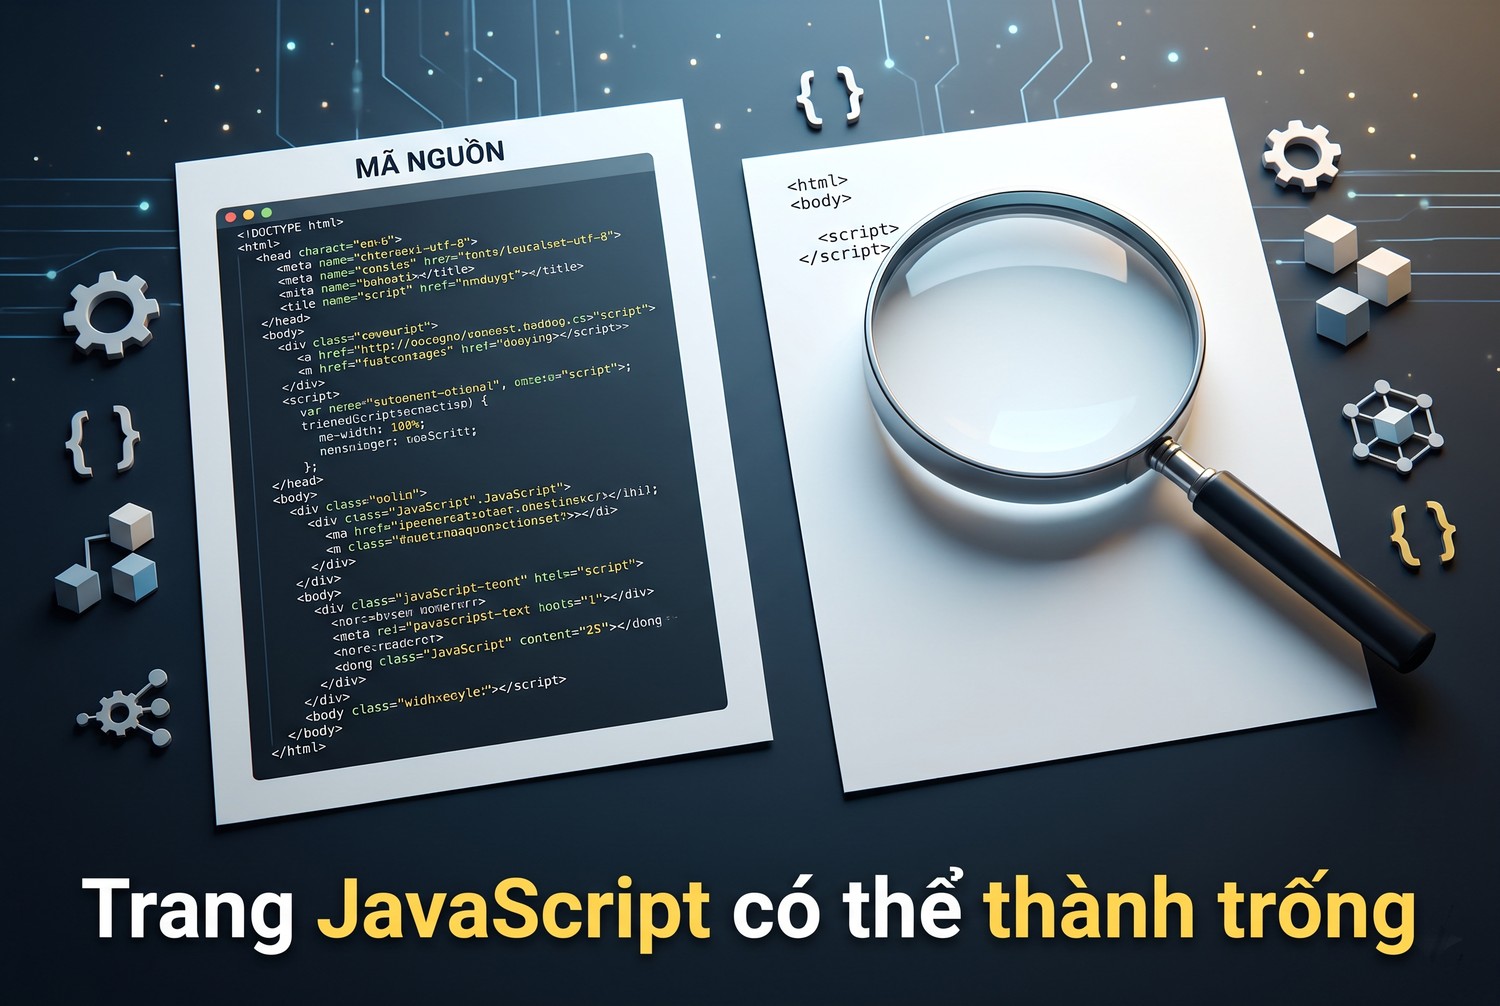
Trang JavaScript có thể thành trống
Đường httpx không chạy JavaScript
Khi không có Playwright, Aider chỉ nhận HTML máy chủ trả về. Với trang tài liệu dựng bằng framework phía trình duyệt, HTML ban đầu thường chỉ có một thẻ div rỗng và vài thẻ script. Sau khi làm sạch, gần như không còn gì có ích. Mô hình nhận một trang trống và có thể đoán mò.
Dấu hiệu nhận ra: /web chạy thành công, không lỗi, nhưng /tokens cho thấy trang chỉ tốn rất ít token, hoặc mô hình trả lời như chưa đọc tài liệu. Bài BeautifulSoup không lấy được dữ liệu JavaScript giải thích vì sao HTML thô thiếu nội dung.
Đường Playwright và proxy
Khi cài aider-chat kèm Playwright và Chromium, Aider tải trang bằng trình duyệt thật. Trong mã, Aider khởi chạy Chromium bằng p.chromium.launch() không truyền tùy chọn proxy, rồi tạo context chỉ với tùy chọn bỏ qua lỗi HTTPS khi người dùng tắt kiểm chứng chỉ. Trang được chờ tới khi yên mạng, tối đa 5 giây, quá hạn thì lấy nội dung đang có.
Vì không truyền proxy, đường Playwright không tự dùng HTTP_PROXY như đường httpx. Chromium có thể theo cài đặt proxy của hệ điều hành hoặc không, tùy nền tảng và cách Playwright khởi chạy. Mình chưa cài Playwright để kiểm đường này. Nếu cần proxy cho đường Playwright, kiểm bằng proxy có nhật ký trước, hoặc tắt Playwright bằng tùy chọn --disable-playwright để Aider dùng httpx theo biến môi trường.
Chọn đường nào
Với trang tài liệu tĩnh như phần lớn trang tài liệu thư viện, đường httpx đủ dùng, nhẹ, và theo proxy qua biến môi trường rõ ràng. Với trang cần JavaScript, đường Playwright lấy được nội dung nhưng việc đi qua proxy cần kiểm riêng. Bài proxy Playwright nói cách Playwright nhận proxy khi tự viết mã.
Một cách khác cho trang JavaScript là tự dựng trang bằng công cụ có hỗ trợ proxy rõ ràng, lưu ra markdown, rồi thêm tệp đó bằng /read-only. Cách này cho anh em kiểm soát được nội dung trước khi gửi tới mô hình. Bài Crawl4AI proxy là một hướng như vậy.
Quy trình chỉ đọc khi Aider đọc nội dung web
Từng bước trong phiên chat
Quy trình dưới đây giữ /web ở mức chỉ đọc: đưa tài liệu vào làm tham khảo, không để mô hình tự đi tiếp sang trang khác. Mỗi bước có lý do riêng.
- Mở Aider trong repo lab với biến proxy đã đặt trước khi chạy, vì biến môi trường được đọc khi tiến trình khởi động.
- Gõ /web kèm một URL được phép, ví dụ trang tài liệu chính thức của thư viện cần dùng.
- Gõ /tokens để xem trang vừa thêm tốn bao nhiêu token. Trang quá nhỏ có thể là trang trống do JavaScript.
- Hỏi mô hình một câu cụ thể dựa trên trang, ví dụ sửa hàm theo API mới trong tài liệu.
- Kiểm diff trước khi chấp nhận, vì nội dung trang có thể đã cũ hoặc sai.
- Dùng /drop hoặc /clear khi không cần trang nữa để giải phóng ngữ cảnh.
Thứ tự này giúp mỗi lần đưa trang vào đều có kiểm chứng. Không gõ /web hàng loạt chỉ vì nghĩ thêm tài liệu thì mô hình hiểu tốt hơn.
Tự nhận URL trong tin nhắn
Trang cấu hình của Aider có tùy chọn --detect-urls, mặc định bật, cho phép Aider nhận ra URL trong tin nhắn và hỏi có muốn thêm vào chat không. Tiện, nhưng cũng dễ làm một URL dán vô tình bị tải và gửi tới mô hình. Trong môi trường làm việc với dữ liệu nhạy cảm, tắt bằng --no-detect-urls và chỉ dùng /web có chủ đích.
Điều kiện dừng nên rõ ràng: một câu hỏi, tối đa vài trang tài liệu, rồi đóng phiên hoặc xóa ngữ cảnh. Không để phiên chat dài với hàng chục trang tích tụ, vừa tốn token vừa làm mô hình lẫn giữa các phiên bản tài liệu.
Kiểm chứng chỉ
Aider có tùy chọn --verify-ssl, mặc định bật. Mã scrape.py truyền giá trị này vào httpx và vào context của Playwright. Sau proxy kiểm tra TLS của công ty, nếu Python không tin CA nội bộ, /web sẽ lỗi chứng chỉ.
Đừng chữa bằng --no-verify-ssl. Cách đúng là cho Python tin CA nội bộ, ví dụ đặt SSL_CERT_FILE trỏ tới bó chứng chỉ có CA của công ty. Tắt kiểm chứng chỉ làm nội dung tài liệu có thể bị thay đổi trên đường đi mà không ai biết, rồi được đưa thẳng vào ngữ cảnh sửa mã.
Aider đọc nội dung web và mạng của mô hình
Request tới mô hình đi đường riêng
Lệnh /web chỉ là một phần lưu lượng của Aider. Phần lớn lưu lượng là request tới nhà cung cấp mô hình, đi qua thư viện LiteLLM và các SDK bên dưới. Những request đó cũng thường đọc biến proxy trong môi trường, nhưng là một đường khác với Scraper.
Vì vậy có thể xảy ra trường hợp /web chạy được mà gọi mô hình lỗi, hoặc ngược lại. Ví dụ NO_PROXY chứa tên miền của cổng mô hình nội bộ, còn tài liệu bên ngoài đi qua proxy. Khi gỡ lỗi, tách hai đường ra kiểm riêng.
Proxy không đổi điều khoản và hạn mức
Proxy chỉ đổi đường mạng của máy anh em. Nó không đổi hạn mức của khóa API, không đổi điều khoản của nhà cung cấp mô hình và không cấp quyền đọc một trang mà anh em không có quyền. Đừng dùng /web với proxy để lấy nội dung trang đã chặn truy cập tự động.
Với trang tài liệu công khai, proxy chủ yếu hữu ích khi mạng công ty chỉ ra ngoài qua proxy. Trường hợp thứ hai là cần IP ra cố định để vào tài liệu nội bộ của đối tác có danh sách IP cho phép.
Gỡ lỗi khi Aider đọc nội dung web
Bảng tra theo thông báo
Bảng dưới gom các thông báo Aider in ra trong lab và hướng xử lý.
Thông báo |
Nghĩa |
Xử lý |
|---|---|---|
getaddrinfo failed |
Request đi thẳng hoặc chuỗi proxy hỏng |
Kiểm biến theo giao thức URL, mã hóa mật khẩu |
407 Proxy Authentication Required |
Proxy từ chối tài khoản |
Tên, mật khẩu, IP cho phép |
timed out |
Quá 5 giây mặc định |
Proxy chậm hoặc trang nặng, tải ngoài rồi /read-only |
Client error 403, 429 |
Website từ chối |
Không cố vượt, chọn nguồn khác |
Client error 404 |
Sai URL |
Kiểm đường dẫn |
Thành công nhưng trang gần như trống |
Trang dựng bằng JavaScript |
Playwright hoặc tự dựng trang |
Lỗi chứng chỉ |
Proxy kiểm tra TLS, Python chưa tin CA |
SSL_CERT_FILE, không tắt kiểm chứng chỉ |
Hầu hết lỗi nằm ở ba chỗ: biến proxy chưa đúng giao thức, mật khẩu chưa mã hóa, và trang cần JavaScript. Kiểm ba chỗ này trước khi nghĩ tới chuyện đổi proxy.
Che bí mật khi báo lỗi
Thông báo lỗi của httpx có thể chứa URL đích nhưng thường không chứa URL proxy. Tuy vậy, lịch sử lệnh của shell và tệp .env của Aider có thể chứa URL proxy kèm mật khẩu. Aider có tùy chọn --env-file để nạp biến từ tệp, nhớ đưa tệp đó vào .gitignore.
Khi chia sẻ lỗi với đồng nghiệp, chỉ dán dòng HTTP error occurred và URL đích. Không dán toàn bộ môi trường hay lệnh khởi chạy có chuỗi proxy.
Chọn proxy cho Aider đọc nội dung web
Proxy tĩnh cho tài liệu có danh sách IP
Với tài liệu nội bộ của đối tác chỉ cho một số IP truy cập, proxy tĩnh là lựa chọn phù hợp, vì IP ra không đổi giữa các lần chạy. Với tài liệu công khai, proxy công ty có sẵn thường là đủ.
ProxyVN có proxy dân cư tĩnh, datacenter và proxy xoay, hỗ trợ HTTP và SOCKS5, cấp tài khoản user và mật khẩu. Nếu cần IP cố định cho máy lập trình dùng Aider, anh em có thể mua proxy tốc độ cao tại trang chủ ProxyVN rồi chạy lại các ca trong bảng ở trên.
Tiêu chí đưa vào dùng thật
Trước khi dặn cả nhóm dùng /web qua proxy, kiểm bốn điều. Một là cả HTTP_PROXY và HTTPS_PROXY đã đặt, mật khẩu đã mã hóa. Hai là NO_PROXY có tên miền nội bộ. Ba là trang tài liệu chính hiển thị đủ nội dung qua đường httpx, hoặc đã kiểm đường Playwright. Bốn là quy tắc về trang nào được phép đưa vào đã ghi thành văn bản.
Câu hỏi thường gặp về Aider đọc nội dung web
Mô hình có tự lên mạng đọc trang không. Không. Tiến trình Aider trên máy tải trang rồi gửi nội dung cho mô hình.
Có cần đặt proxy riêng cho /web không. Không có tùy chọn riêng. Đường httpx đọc HTTP_PROXY, HTTPS_PROXY, ALL_PROXY, NO_PROXY từ môi trường.
Vì sao đặt HTTPS_PROXY mà trang http vẫn đi thẳng. httpx chọn biến theo giao thức URL. Đặt cả HTTP_PROXY.
Trang tải được nhưng mô hình nói không thấy nội dung. Có thể trang dựng bằng JavaScript và Aider đang đi đường httpx. Kiểm bằng /tokens.
Có chỉnh được timeout của /web không. Mình không thấy tùy chọn riêng. --timeout là cho request tới mô hình.
Có nên tắt --verify-ssl không. Không. Cho Python tin CA nội bộ thay vì tắt kiểm chứng chỉ.
Lỗi trang có bị gửi tới mô hình không. Trong lab, mọi ca lỗi đều trả rỗng, không có nội dung lỗi vào ngữ cảnh.
Checklist Aider đọc nội dung web
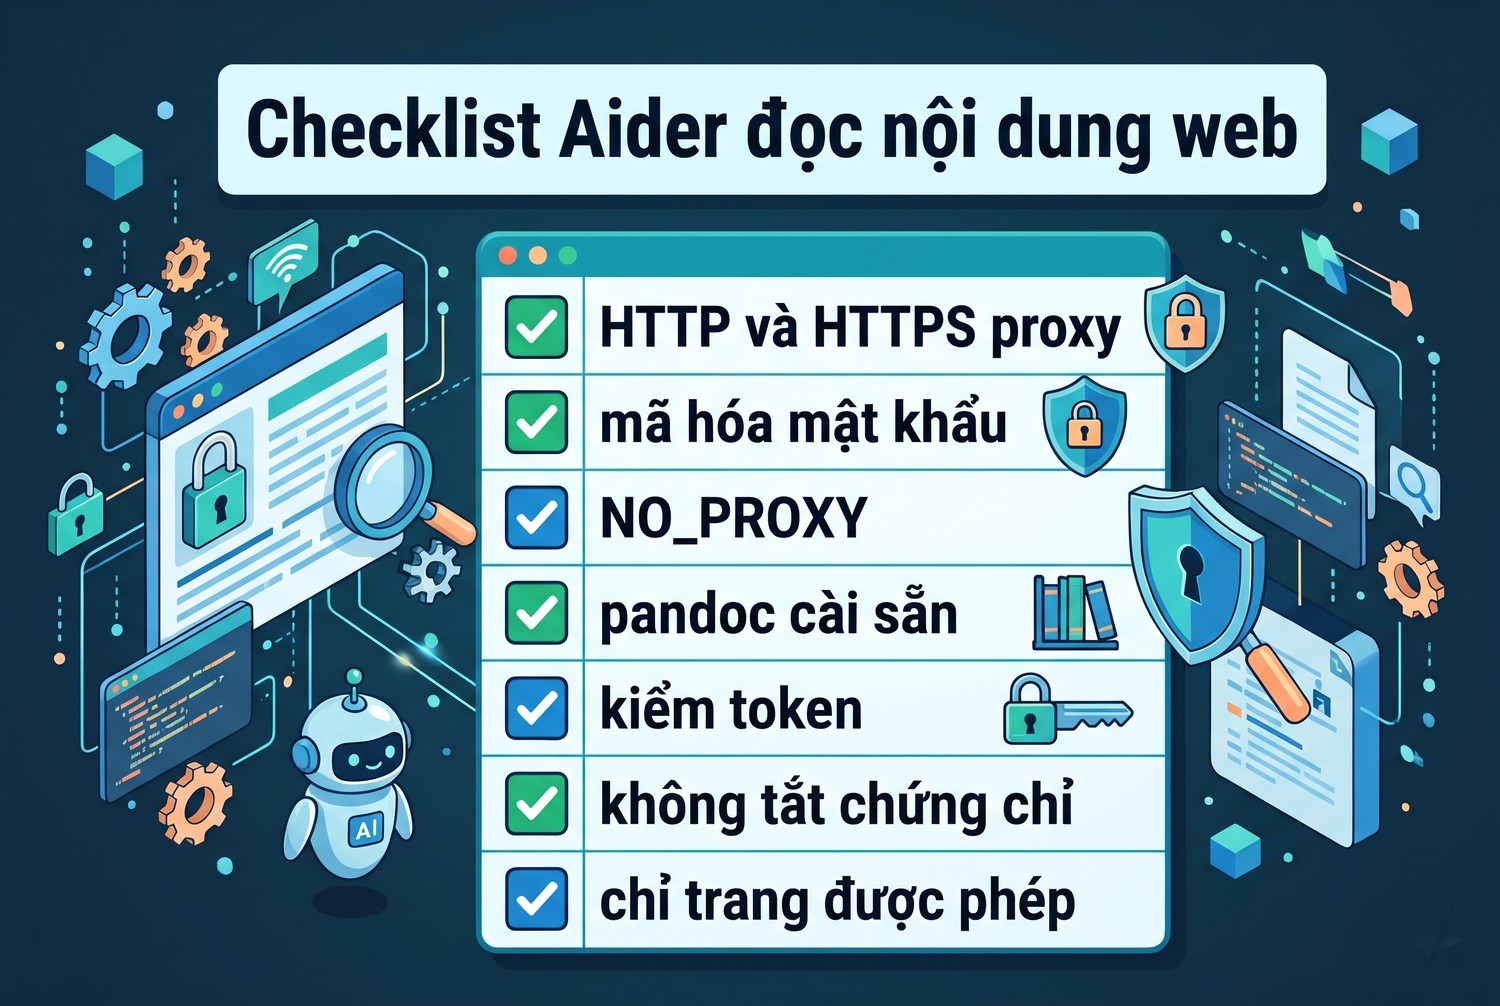
Checklist Aider đọc nội dung web
Trước khi dùng /web qua proxy
- Đặt cả HTTP_PROXY và HTTPS_PROXY trước khi mở Aider.
- Mã hóa phần trăm mật khẩu trong URL proxy.
- NO_PROXY có tên miền nội bộ.
- Cài pandoc sẵn để Aider không tải lúc chạy.
- Kiểm /tokens sau mỗi /web.
- Biết đang đi đường httpx hay Playwright.
- Không tắt kiểm chứng chỉ.
- Chỉ đưa trang được phép, cân nhắc --no-detect-urls.
Giới hạn của lab
Lab gọi trực tiếp lớp Scraper của aider-chat 0.86.2 qua đường httpx, không chạy giao diện chat và không gọi mô hình thật. Chưa cài Playwright để kiểm đường trình duyệt qua proxy, chưa thử proxy kiểm tra TLS và chưa thử gateway thương mại. Bước pandoc bị tắt trong lab.
Aider đọc nội dung web và những điều cần nhớ
Aider đọc nội dung web bằng /web, do tiến trình trên máy tải trang qua httpx hoặc Playwright. Đường httpx theo HTTP_PROXY, HTTPS_PROXY theo giao thức URL, không chạy JavaScript, timeout khoảng 5 giây, lỗi không vào ngữ cảnh. Cần proxy ổn định khi Aider đọc nội dung web, liên hệ Proxy.vn - Nhà cung cấp dịch vụ proxy chất lượng hàng đầu Việt Nam.


